인공지능 개발을 위한 데이터
데이터 종류
-
말뭉치 류(Corpus)
- 실제 텍스트 기반의 데이터
- 대화문, 기사, 댓글 등
-
사전/데이터베이스 류
- 텍스트 분석 시 참조로 활용되는 자원
- 온톨로지, 워드넷, 시소러스, 지식그래프 등
- 특정 단어에 대한 설명, 혹은 단어 간의 연관성을 정래히 놓은 데이터
벤치마크의 등장
-
언어 모델 평가를 위해 등장
- 일반적으로 Kaggle 등의 대회를 할 때의 데이터 등을 벤치마크 데이터셋이라고 한다. 이러한 데이터셋은 AI 개발자들 사이의 경쟁을 불러일으킬 뿐더러 실제로 모델이 잘 구성되어 있는지 확인하기 위한 역할도 수행한다. 즉, 벤치마크 데이터셋의 등장으로 실제 모델의 정확성 평가가 가능해졌으며, 이는 AI의 발전으로 이루어진 것이다.
- 벤치마크 데이터셋이란 "정제된 학습 데이터"라고 생각하면 편할 것이다.
-
대표적인 BenchMark 데이터셋
- GLUE : 자연어 이해
- Super GLUE : 고난도 자연어 이해
- KILT : 지식 기반 자연어 이해
- GEM : 자연어 생성
-
벤치마크의 구성
- 과제(Task)
- 평가 데이터(Test)
- 검증(Data/Validation) 데이터
- 훈련(Train) 데이터
- 평가 지표
- 베이스 라인
- Metric
- Human Evaluation 값과 리더보드를 통해 다른 유저들의 점수들을 나타내 주는 경우가 많다.
- 과제(Task)
데이터 용어
데이터 관련 용어
-
텍스트(Text)
- 문장이 모여서 이루어진 한 덩어리의 글
-
Corpus(말뭉치, Plural Corpora)
- 특정 기준으로 한 덩어리로 볼 수 있는 말의 뭉치
- (ex) 한 저작자의 글, 특정 분야의 글 등
- Text Archive : 텍스트를 모아 놓고 단순히 저장만 한 것
Corpus : 특정 기준에 맞춰 선별된 데이터들을 분류한 이후 저장해 둔 것
-
Data
- 컴퓨터로 처리할 수 있는 형태로 된 정보
-
주석(Tag, Label, Anntation)
- 원래 텍스트를 대표하거나 대체할 수 있는 용어로써 쌍을 이루는 것
- Task에 따라 만드는 주석의 형태가 다름
- (ex) 감정 분석 : 긍정, 부정으로 Labeling, QA 문제 : 질문에 대한 답변 문장(단어)로 Labeling
- Tagging : 분할된 형태소에 Tag를 붙임
- Segmentation : 형태소 단위로 분할
-
왜 형태소에 Labeling을 붙이는 과정을 "형태소 분석기"라고 할까?
사실, Labeling을 붙이는 과정이므로 형태소 주석기라고 말하는 것이 더 적절할 수 있다.
하지만, 형태소에 주석을 다는 것은 결국 언어 사이의 관계를 분석한다고 생각하여 형태소 분석기라고 명명했다.
영어에서 또한 Pos Tagger로 명시한다.
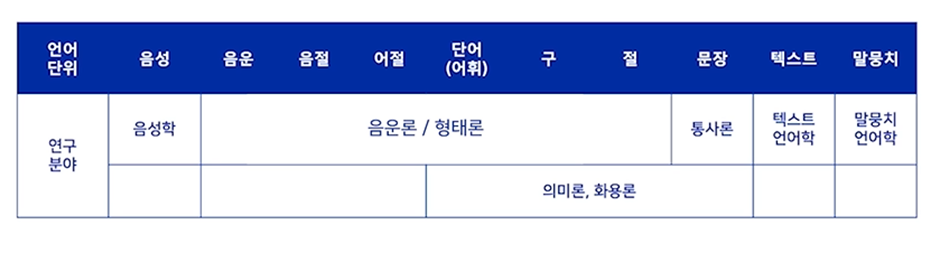
언어학의 연구 분야
이 부분은 중요한 부분은 아니므로, 언어 단위에 따라 연구 분야의 이름이 다르다 정도로만 알고 있으면 될 것 같다.
텍스트 데이터의 기본 단위
-
영어 : 단어 기반
-
한국어 : 어절 기반
한국어는 9품사로 분석된다(명사, 수사, 대명사, 동사, 형용사, 관형사, 부사, 조사, 감탄사)
여기서 한국어의 특이한 점은 "조사"이다. 조사는 체언(명사, 수사, 대명사)와 붙어서 사용되기 때문에 영어와 달리 띄어쓰기 = 단어의 구분을 의미하지는 않는다.
I am sleeping이라는 영어 문장은 띄어쓰기 단위로 단어를 구별해도 큰 관계가 없지만, "나는 자고 있다"라는 문장에서 "자고"라는 것이 1 문장이 아닌 "자다" + "-고"의 결합어이기 때문에, 한국어가 분석하는데 더 어려워지며 띄어쓰기 단위로 분석할 수 없게 되는 것이다
- 품사 : 단어를 문법적 성질의 특성에 따라 몇 갈래로 묶어 놓은 것
- 기준 : 의미(뜻, meaning), 기능(function), 형식(form)
Type VS Token
-
Token : 언어를 다루는 가장 작은 기본 단위
- 이 부분은 AI 개발자가 정하는 것
- 단어(Word), 형태소(Morpheme), 서브워드(Subword)
- 서브 워드 : 단어를 쪼개서 결합어 등에 포함된 단어까지 Vocab에 넣어 처리하는 것
-
Type : 토큰의 대표 형태
- 즉, 문장을 토큰으로 쪼갰을 때 "토큰"에 대해 분류한 Label을 Type이라고 한다.
-
토큰화(Tokenization) > 표제어 추출(Lemmatization) / 품사 주석(POS tagging)
-
예시 : "이 사람은 내가 알던 사람이 아니다"
- 토큰화 : 이 / 사람 / 은 / 내 / 가 / 알 / 더 / ㄴ / 사람 / 이 / 아니 / 다
- 표제어 추출 : 이 / 사람 / 나 / 알다 / 아니다
- 토큰화 된 토큰의 사전적 어원을 찾는 과정
- '알-'이라는 토큰은 "알다"라는 동사에서 유도된 단어이므로, 표제어 추출 과정을 통해 "알다"로 바뀜
- 품사 주석 : 이(MM) / 사람(NNG+) / 은(JX)/ ...
- 즉, 토큰화 된 토큰에 대하여 Labeling을 붙여주는 것
- 이 과정을 POS Tagging이라고 함
- 토큰 수 : 12개, Type 수 : 10개
-
N-gram
- 연속된 N개의 단위
- N = 2 : Bi-gram
- N = 1 : Uni-gram
- 글자수 Bi-gram : 글자를 기준으로 2개 확인
- 형태소 Bi-gram : 형태소로 쪼갠 이후 형태소 기준 2개 확인
- 어절 Bi-gram : 띄어쓰기로 쪼갠 이후 띄어쓰기 기준 2개 확인
- 연속된 N개의 단위
-
표상(Representation)
- 자연어를 컴퓨터가 이해할 수 있는 기법으로 표시하는 것
- 사전 학습 모델(PLM), Word2Vec 등
- 즉, Token을 데이터가 이해할 수 있는 형태(주로 Vector)로 변경하여 표현하는 것
자연어처리 데이터의 형식
-
HTML
- BeautifulSoup 등을 통해 처리함
-
XML
- HTML, XML은 정해진 규격에 맞춰 작성되어 있음
-
JSON
- {값:쌍} 형식으로 표현한 데이터
- 인간이 읽기 편하게 되어 있는 데이터
- JSONL : JSON을 한 줄(Line)으로 만든 것
-
CSV, TSV
- CSV : 쉼표로 필드를 구분
- TSV : 탭(\t)로 필드를 구분
- 구분자(Dlimiter) 차이