데이터 구축 프로세스
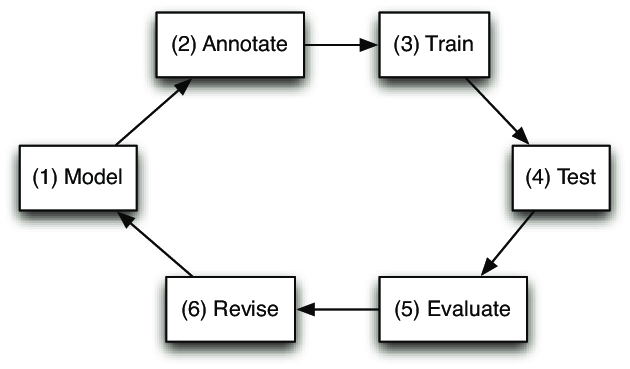
MATTER cycle
-
Model : 과제(Task) 정의
-
Annotate : 주석 다는 과정
-
Train : 데이터를 모델에 학습시켜 봄
-
Test : 학습된 모델에 데이터를 Test해봄
-
Evaluate : 데이터 검수. 데이터가 적절히 만들어졌는지 확인하는 과정
-
Revise : 데이터의 수정 부분을 파악하여 Annotate를 수정하거나 과제를 조금더 확실히 정의하는 과정
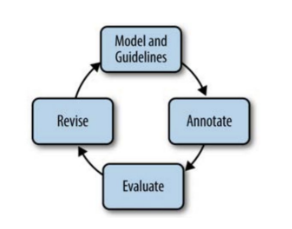
MAMA Portion
- MATTER Cyle 내부에서 일어나는 추가 과정
데이터 구축 프로세스
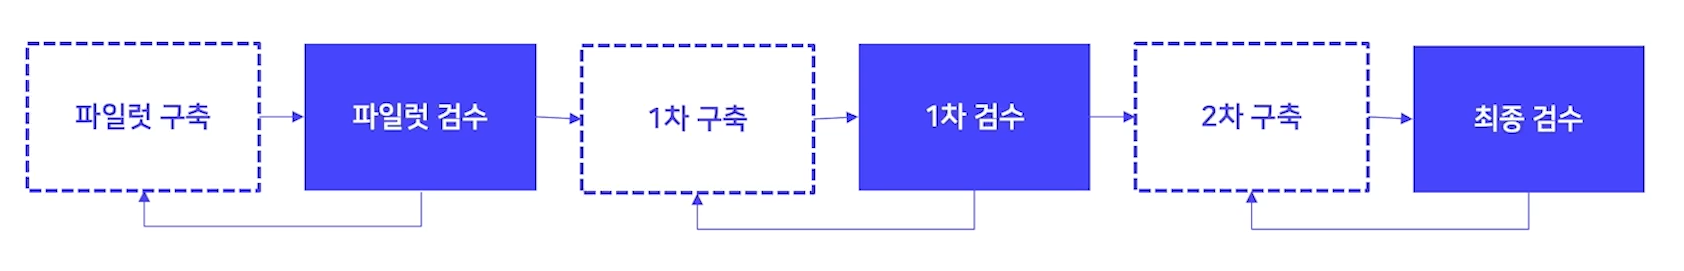
- 검수 과정에서 잘못된 것을 찾으면 이전 단계로 돌아가 재구축하는 과정이 핵심
데이터 주석
분류 레이블
-
문장 또는 텍스트에 대한 분류 레이블을 주석하는 유형
-
감성 분석, 주제 분류, 자연어 추론 등
-
구축 난이도는 낮은 편
범위 주석
-
텍스트의 일부를 선택하여 특정한 Label을 주석하는 유형
-
NER, 형태 분석 등
-
구축 난이도는 Task에 따라 천차만별
대상 간 관계 주석
-
대상 간 관계를 주석하는 유형
-
관계 추출, 개체명 연결, 구문 분석 등
-
두 단계에 걸쳐 구축 해야 하므로 구축 난이도가 높음
- Span에 대한 범위 주석을 수행한 이후, 대상과 대상 사이를 연결해서 새로운 Label을 거치는 2단계를 걸쳐야 함
- 검수시에도 2단계를 모두 확인해야하므로 어려운 난이도를 가짐
텍스트 생성
-
주어진 텍스트에 대한 텍스트 또한 발화를 생성하는 유형
-
번역, 대화, 요약 등
복합 유형
-
데이터 구축 방식을 복합적으로 활용하여 다양한 정보를 주석하는 유형
-
질의 응답, 슬롯필링 대화 등
데이터 검수
데이터 검수 수행 내용
-
가이드라인 정합성
- 주석 절차 및 내용이 가이드라인에 부합하는지 확인
-
데이터 형식
- Meta Data, Label, 텍스트 내용 등의 형식 일치 여부 확인
-
통계 정보
- Label Imbalance 확인
- 문장 길이 확인
- 특정 어휘의 활용 빈도수 확인
-
모델 성능 확인
- 모델 학습을 통해 결과값 확인
오류 원인 분석
-
구축방법 측면의 오류 원인
- 통제 미흡으로 인하여 다양한 오류 데이터가 생성되지는 않았는지 확인
-
가이드라인 측면의 오류 원인
-
데이터셋 측면의 오류 원인
- 데이터셋 설계의 부족
- 데이터 구축 중복
-
학습모델 측면의 오류 원인
- 학습 모델 선정의 오류
- 학습 모델에 적합하지 않도록 데이터가 정제됨
데이터 검수 유형
-
표본 추출
- 규모가 클 경우 실시
- 가이드라인을 기준으로 문제가 될만한 Label만 뽑아 표본 추출 검사하기도 함
-
전수 검사
- 규모가 작은 경우 실시
데이터 평가
- 작업자 간 일치도(IAA)
- 서로 다른 작업자들을 동일한 데이터에 대해 작업시켜 한 사람이 해당 작업물을 평가하는 것
- 종류 : Cohen's , Fleiss'
- 모델 평가
- 정확도(Accuracy), 정밀도(Precision), 재현율(Recall), F1-score등을 활용
- 모델을 통해 학습시킨 이후 평가하여 데이터를 평가함
데이터 구축 작업 설계 시 유의 사항
-
데이터 구축 기간을 넉넉하게 설정하기
-
검수에 충분한 시간을 확보
-
검수 내용을 어느 시점에 어떻게 반영할 것인가 하는 계획을 세움
- 품질 미달의 경우 보완책을 마련할 것
-
작업 난이도에 따라 참여 인력을 산정하여 모집 및 관리 계획을 세움
-
각 단계별 작업 주체 및 검수 유형을 지정해야 함
-
외부 인력 및 자원을 활용할 경우 기본 단가 산정 기준을 잘 세워야 함
IAA에 대한 추가 설명
Cohen's
- 2 관찰자의 측정 값에 대한 일치도 측정
-
- : 2명의 평가자 간 일치 확률
- : 2 평가자가 확률적으로 우연히 일치하도록 결과를 낼 확률
- A가 60%, B가 30% 확률로 C라고 예측했을 때, 는 0.6 * 0.3, 즉 0.18정도는 확률적으로 우연히 일치하게 예측값을 낼 수 있으므로 이 값을 빼줘 계산하는 것
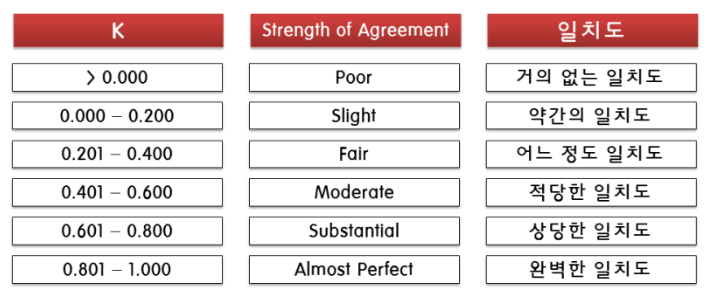
- K : Cohen's 카파 계수. 0과 1 사이의 값을 가짐
-
연산 사전 조건
- 명목척도 또는 서열 척도로 측정된 범주형 데이터
- 두 평가자에게 모두 관측된 데이터
- 두 평가자에 대해 대칭적인 교차표
- 두 평가자는 독립된 상태에서 데이터를 평가해야 함
Fleiss'
-
세 명 이상의 관찰자 측정 값에 대한 일치도 측정
-
Cohen's 와 단지 관찰자 인원에 차이가 있을 뿐 나머지는 동일
- Cohen's 의 일반화 된 식이라고 볼 수 있음
-
N명의 관찰자라고 정했을 때, 항상 대상이 되는 N 인원을 고정시킬 필요는 없음
- (ex) A ~ Z 평가자가 있다고 가정할 때, 3명의 관찰자 사이 평가를 계산하자. 이 때 1 ~ 10데이터가 존재한다고 가정하자.
1데이터에 대한 Fleiss' 계산을 할 때 A,B,C 인원을 골랐다. 이 때, 2 데이터에 대해 평가할 때 꼭 A,B,C 인원을 고르지 않아도 된다. 즉, D, E, F 인원을 골라 계수 계산식을 활용해도 문제가 없다.
- (ex) A ~ Z 평가자가 있다고 가정할 때, 3명의 관찰자 사이 평가를 계산하자. 이 때 1 ~ 10데이터가 존재한다고 가정하자.
-
- : N 명의 평가자 간 일치 확률
- : N명의 평가자가 확률적으로 우연히 일치하도록 결과를 낼 확률
- K : Fleiss's 카파 계수. 0과 1 사이의 값을 가짐
- N의 대상이 되는 인은 데이터마다 계속 변경될 수 있음