메타 하네스와 의도 컴파일러 — 핵심 사고 지도
1. 작업이 여기까지 온 흐름
출발점은 AI가 실제 작업을 안정적으로 수행하게 만드는 하네스였다.
고정된 하나의 하네스보다 작업에 따라 모델·도구·메모리·평가기를 조립할 수 있는 구조가 적합하다고 판단하면서 메타 하네스로 확장되었다.
그러나 메타 하네스가 무엇을 조립해야 하는지 결정하려면 더 앞단에서
사용자가 실제로 무엇을 원하는가?
를 명시적으로 표현할 필요가 생겼다.
AI 실행 구조
    ↓
Harness
    ↓
작업별 동적 구성
    ↓
Meta Harness
    ↓
무엇을 구성해야 하는가?
    ↓
Intent Representation
    ↓
Intent Compiler
즉 메타 하네스와 의도 컴파일러는 별개의 아이디어라기보다 하나의 실행 문제를 서로 다른 경계에서 해결하는 구조다.
2. 핵심 개념을 추출하면
현재까지 등장한 개념은 역할에 따라 다음 여섯 집합으로 압축할 수 있다.
인간 의도를 해석하기 위한 정보
- Natural Language
- Context
- World Model
- User Model
- Terminology
의미를 명시적으로 표현하는 구조
- Intent
- Semantic Model
- Intent IR
- Uncertainty
실행 방법을 결정하는 구조
- Validation
- Planning
- Composition
실제 작업을 수행하는 구조
- Composer
- Work Controller
- Execution Fabric
시스템 전체를 제어하는 구조
- Governance
실행 결과를 다시 판단에 사용하는 구조
- Result
- Evaluation
- Feedback
- Quality Loop
각각을 따로 이해하는 것보다 이들이 어떤 관계를 가지는가가 중요하다.
3. 전체 개념 그래프
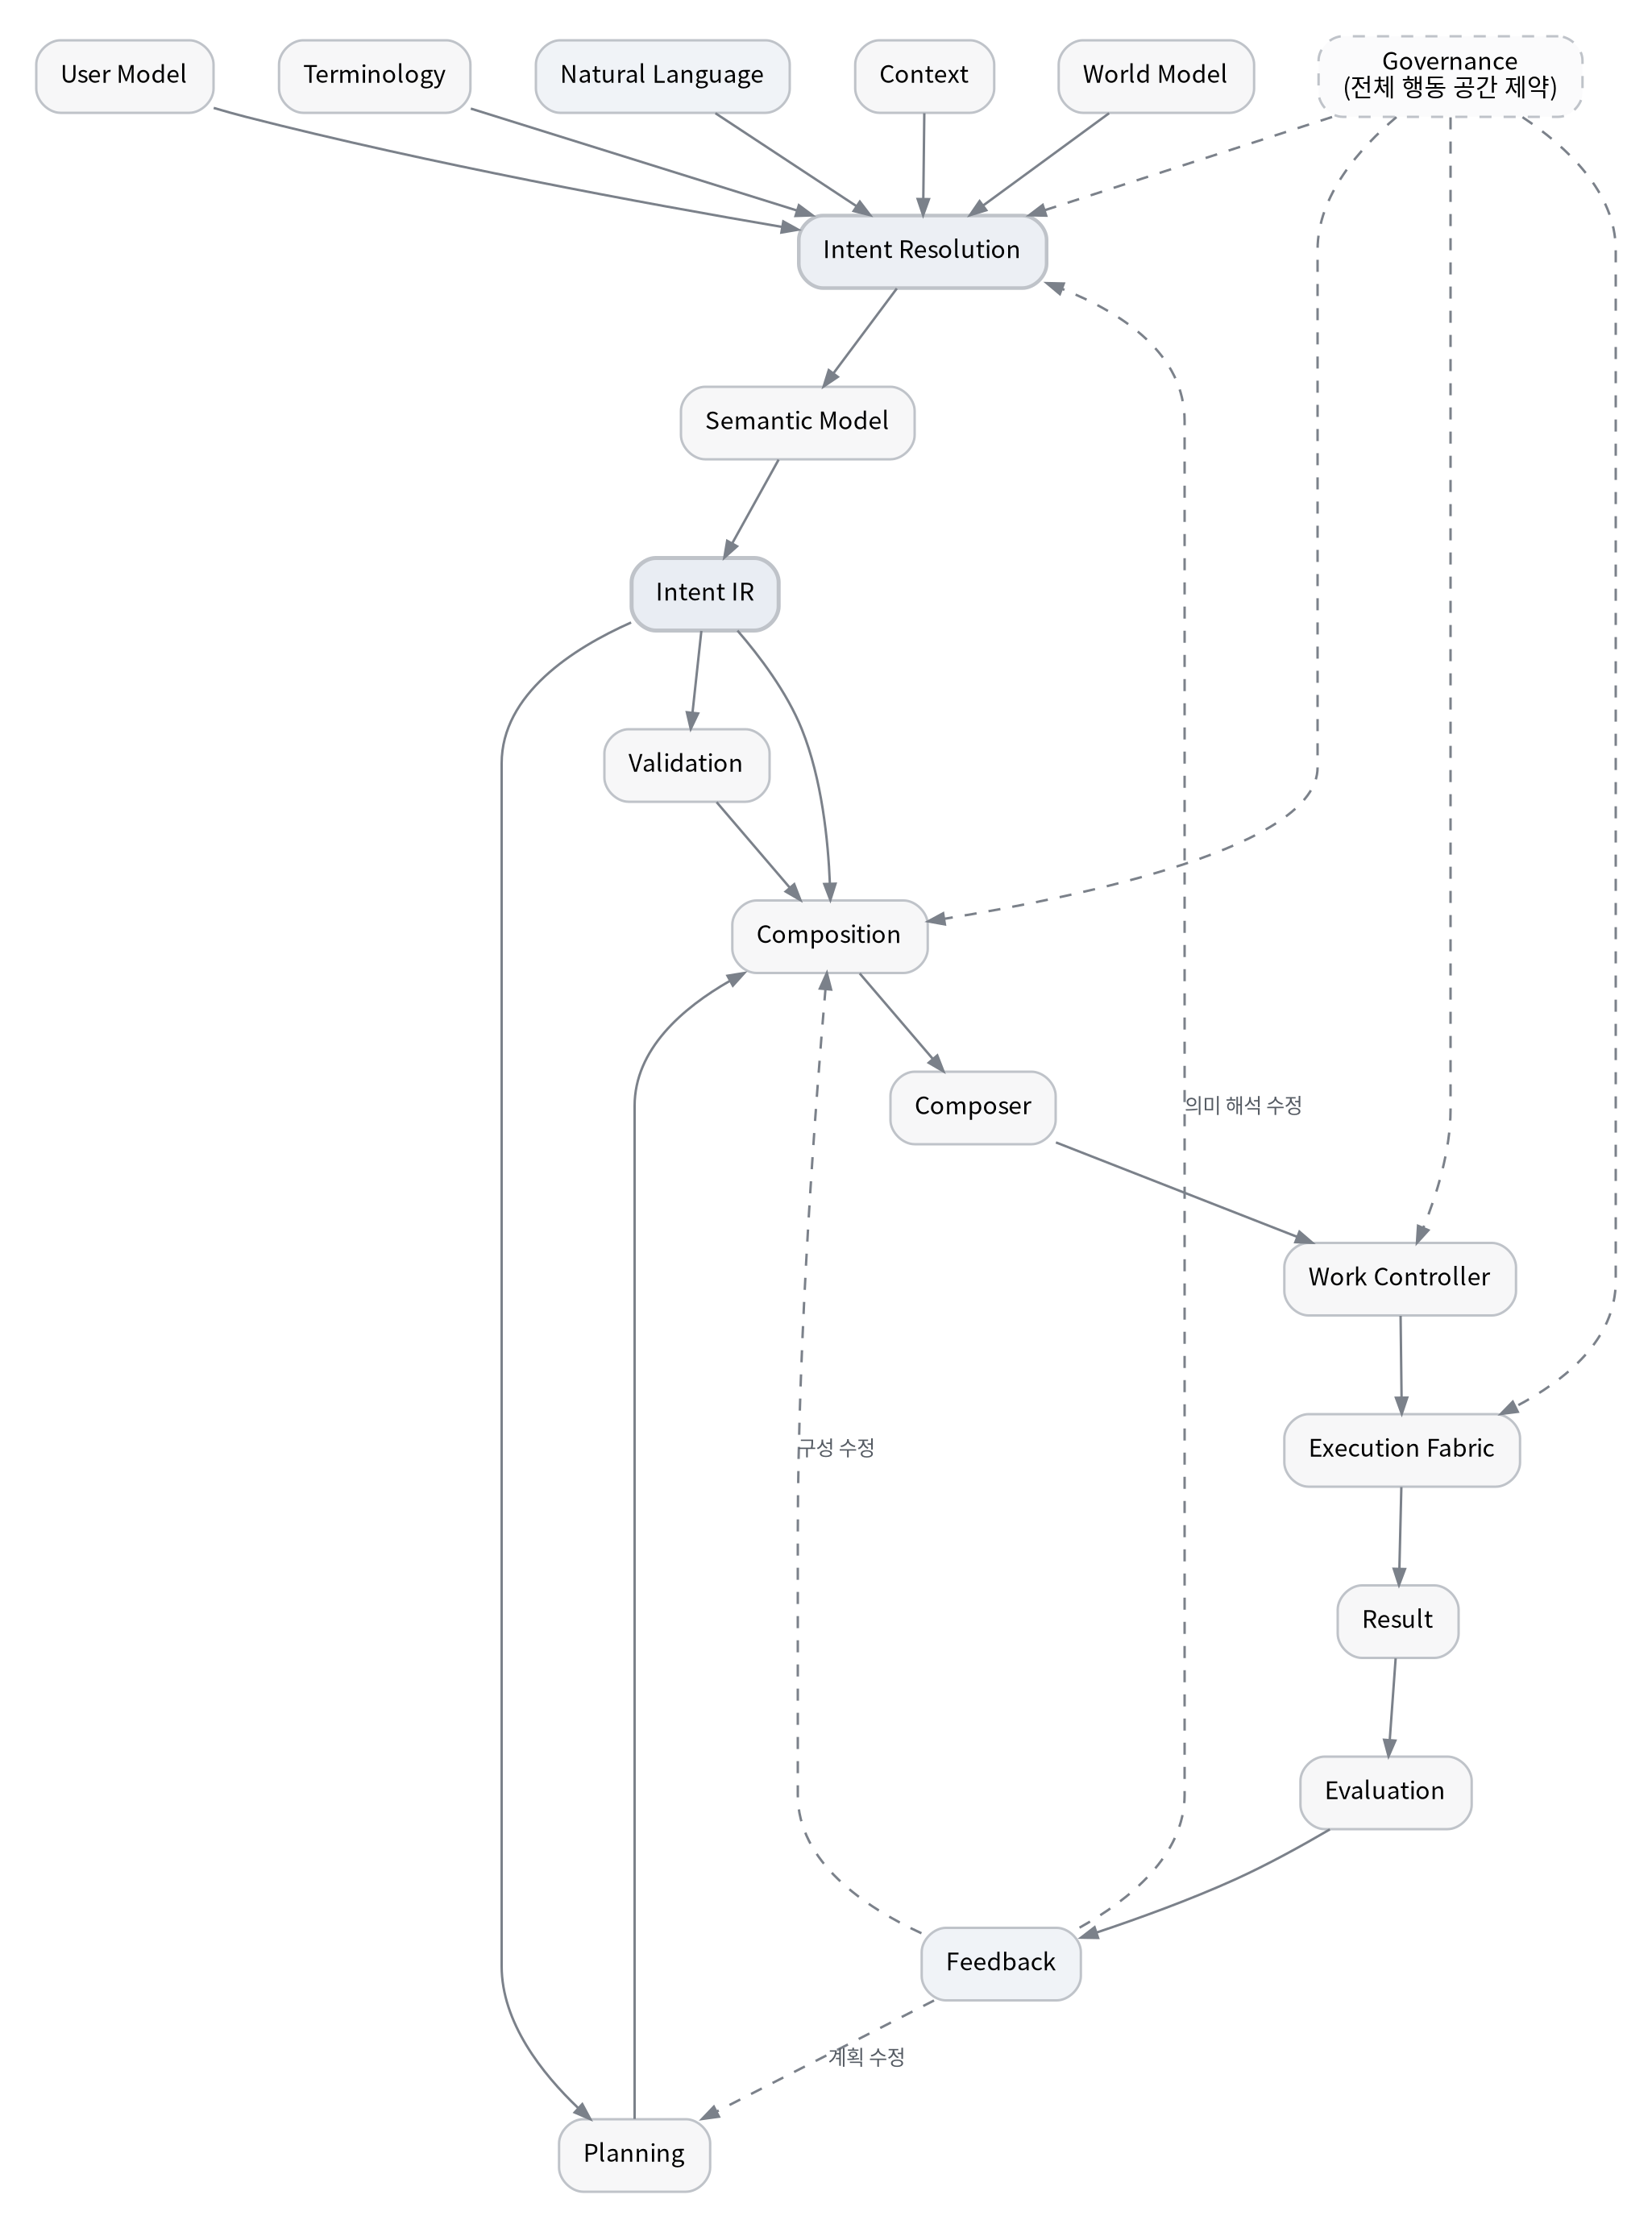
이 그래프에서 가장 중요한 것은 크게 세 가지 흐름이다.
의미 형성
Natural Language + Context
        ↓
Intent

실행 구조 형성
Intent IR
        ↓
Plan / Composition
        ↓
Meta Harness

자기 수정
Execution
        ↓
Evaluation
        ↓
Feedback
        ↺
4. 가장 중요한 경계: Intent IR
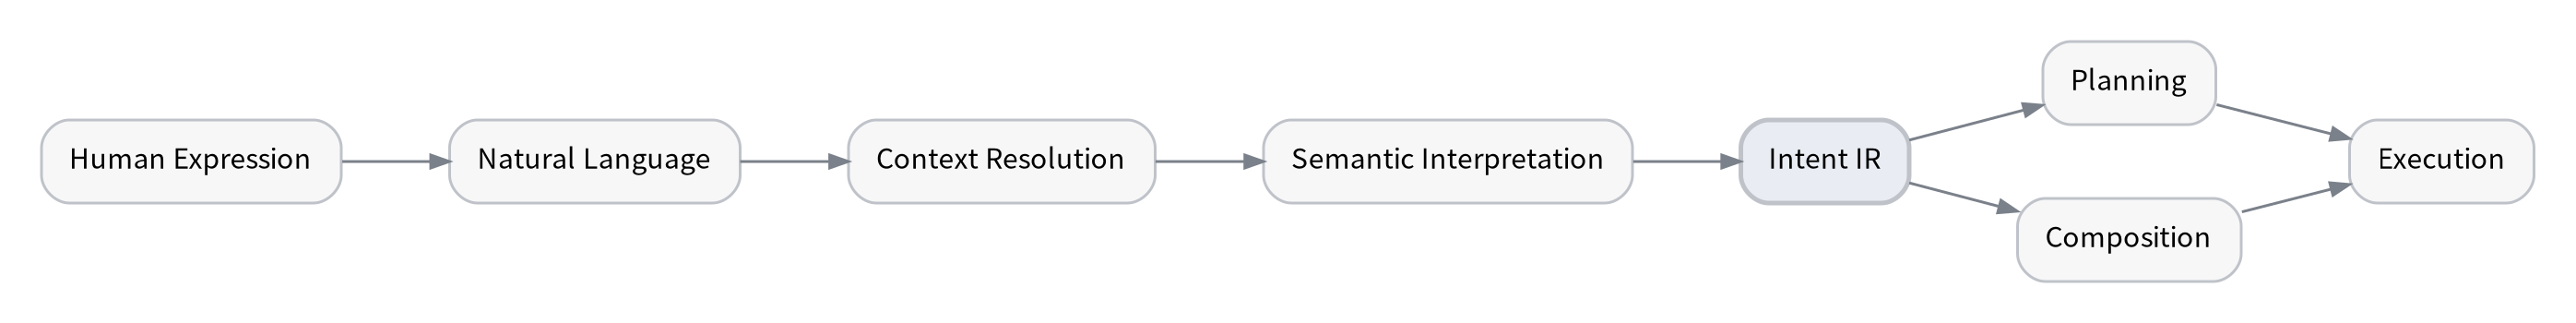
Intent IR의 의미는 단순히 자연어를 JSON으로 바꾸는 것이 아니다.
핵심은
인간의 표현 방식과 실행 시스템 사이에 안정적인 의미 계약을 만드는 것
이다.
이 경계가 안정되면 위쪽에서는 자연어·음성·UI 등 입력 방식이 달라질 수 있고, 아래쪽에서는 LLM·Agent Framework·Tool·Runtime이 달라질 수 있다.
다양한 인간 표현
        ↓
     Intent IR
        ↓
다양한 실행 시스템
따라서 의도 컴파일러에서 가장 먼저 안정시켜야 할 대상은 컴파일 과정 자체보다 무엇을 Intent IR에 표현할 것인가다.
5. Intent는 문장 안에만 존재하지 않는다
일반적인 컴파일러에서는 입력 언어의 구조와 의미 규칙이 이미 상당 부분 정해져 있다.
자연어 의도 해석은 다르다.
"다음 진행해"라는 표현만으로는 실제 행동을 결정할 수 없다.
의미는 오히려 다음 관계에서 생긴다.
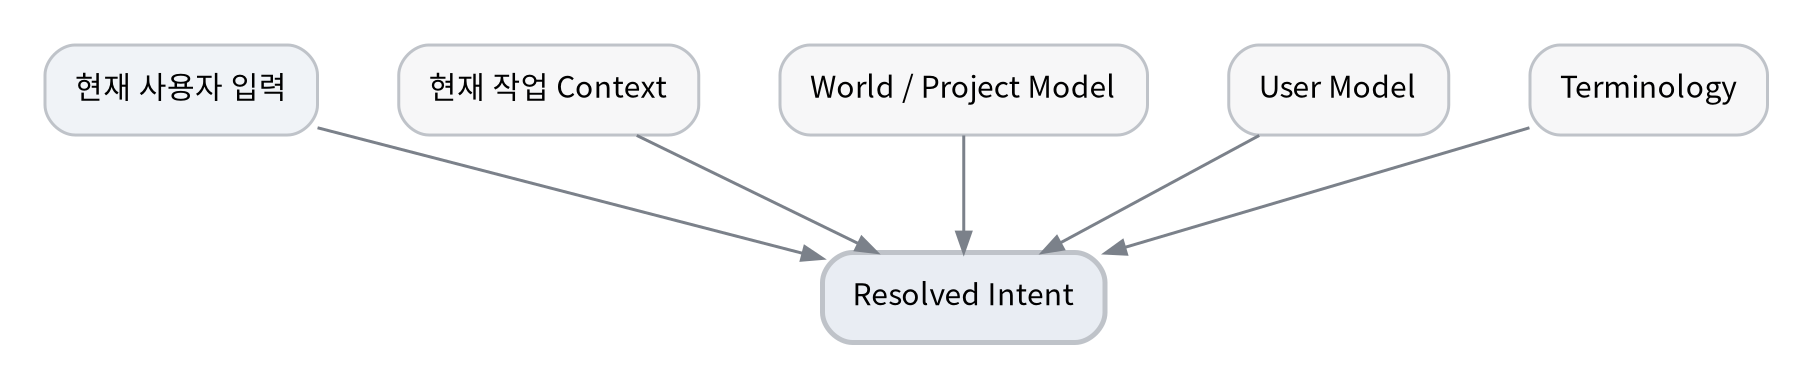
따라서 의도 해석을
Natural Language → Parsing → Intent로만 이해하면 부족하다.
더 정확한 모델은
Intent =
입력
+ 현재 상태
+ 세계에 대한 모델
+ 사용자에 대한 모델
+ 용어의 의미
이다.
이 때문에 Context, World Model, Personalization, Terminology는 부가적인 편의 기능이 아니라 의미 분석의 일부가 된다.
6. Intent Language는 발견하는 것에 가깝다
Intent Language를 먼저 만들고 인간의 의도를 그 틀에 맞추는 방식은 위험하다.
예를 들어 처음부터
GOAL
CONSTRAINT
RESOURCE
...
를 정해 버리면 실제 작업에 존재하는 의미를 언어에 억지로 맞추게 될 수 있다.
현재 작업에서는 반대 방향이 더 적합하다.
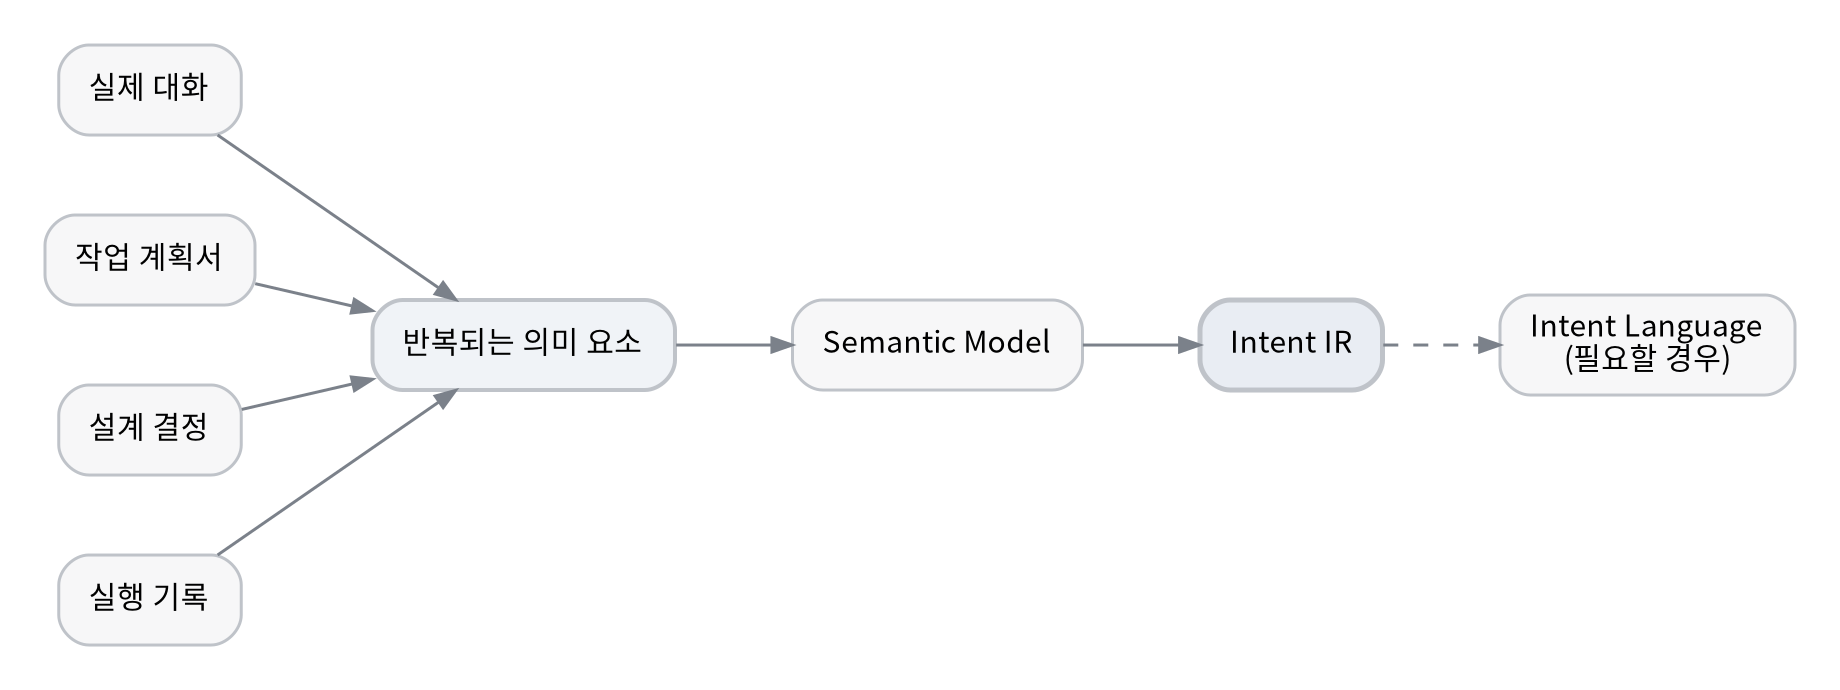
즉,
Syntax → Meaning
이 아니라
Observed Meaning → Semantic Model → Representation
순서다.
기존의 메타 하네스 계획서와 실제 대화 기록은 따라서 단순 기록물이 아니라 Intent Model을 추출하기 위한 데이터가 된다.
7. 현재까지 드러난 Intent의 의미 축
지금까지의 작업에서 반복되는 요소들을 추출하면 대략 다음 관계가 보인다.
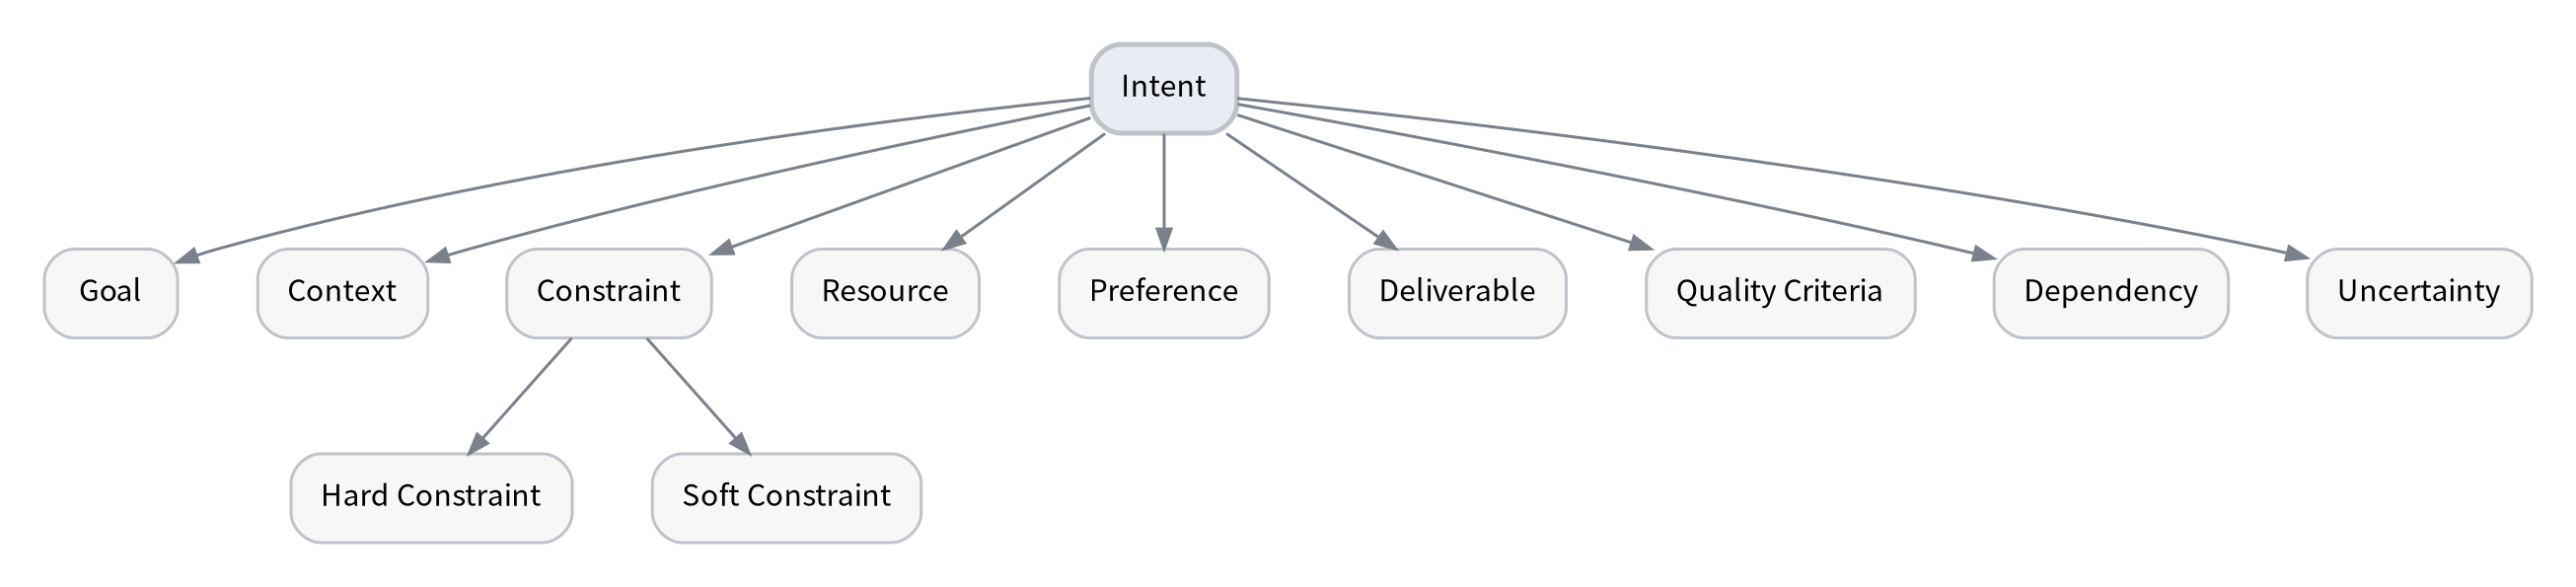
이것은 최종 Schema가 아니다.
오히려 실제 작업을 분석하면서 계속 검증해야 할 현재의 가설적 Ontology에 가깝다.
중요한 질문은
어떤 필드가 있어야 하는가?
보다
실제 작업을 설명할 때 어떤 의미 관계가 반복해서 필요한가?
이다.
8. Intent · Plan · Execution의 분리
앞으로 특히 중요한 경계다.
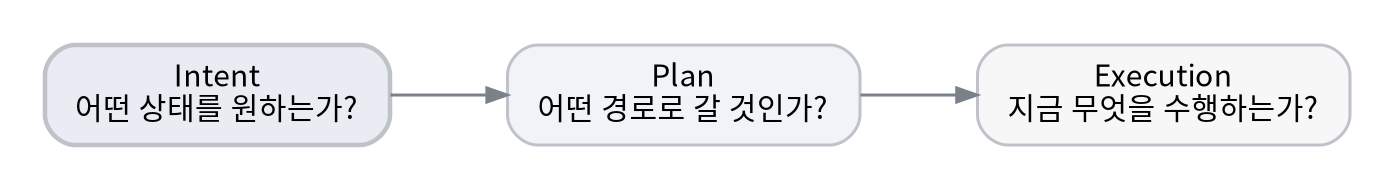
예를 들어
Intent
메타 하네스 구현 계획의 완전성을 검증한다.

Plan
요구사항 추출
→ 구조 대응
→ 누락 탐색
→ 수정안 생성

Execution
문서 읽기
→ 항목 비교
→ 결과 작성
이 셋을 나누면 실패도 분해할 수 있다.
의도를 잘못 이해했는가?
        ↓
계획이 잘못되었는가?
        ↓
실행 과정에서 실패했는가?
이 구분은 이후 Evaluation과 Feedback의 방향을 결정하는 데도 중요하다.
9. Meta Harness 내부의 책임 경계
메타 하네스에서는 세 가지 질문을 분리하는 것이 핵심이다.

Composer
작업을 수행하기 위해 필요한 능력을 선택하고 조합한다.
- Model
- Agent
- Tool
- Memory
- Evaluator
- Workflow
Work Controller
실행 중인 작업의 상태와 진행을 관리한다.
- 현재 단계
- 완료 상태
- dependency
- retry
- checkpoint
- 다음 행동
Execution Fabric
실제 계산과 외부 행동을 수행한다.
- LLM 호출
- Tool 실행
- API
- Shell
- Sandbox
- Remote Runtime
따라서
Composition ≠ Orchestration ≠ Execution이다.
이 경계가 분명해야 각각을 독립적으로 교체하고 개선할 수 있다.
10. Governance와 Quality는 다른 방향으로 작동한다
둘 다 시스템 전체에 영향을 주지만 같은 종류의 기능은 아니다.
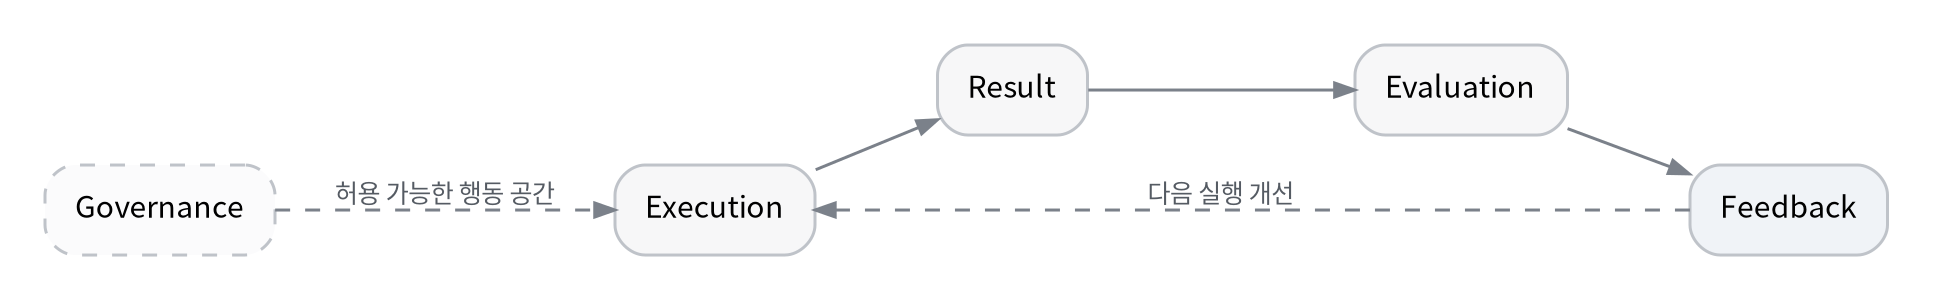
Governance의 질문은
이 행동을 수행해도 되는가?
이다.
Quality의 질문은
수행한 결과가 얼마나 좋은가?
이다.
따라서
Governance
= 가능한 행동 공간을 제한

Quality
= 실제 행동의 결과를 평가
한다.
Governance는 cross-cutting constraint에 가깝고, Quality는 feedback loop에 가깝다.
11. Feedback은 어디로 돌아가야 하는가
Evaluation 결과를 단순히 다음 실행의 Prompt에 추가하는 것만으로는 부족하다.
실패의 원인에 따라 수정 지점이 다르기 때문이다.
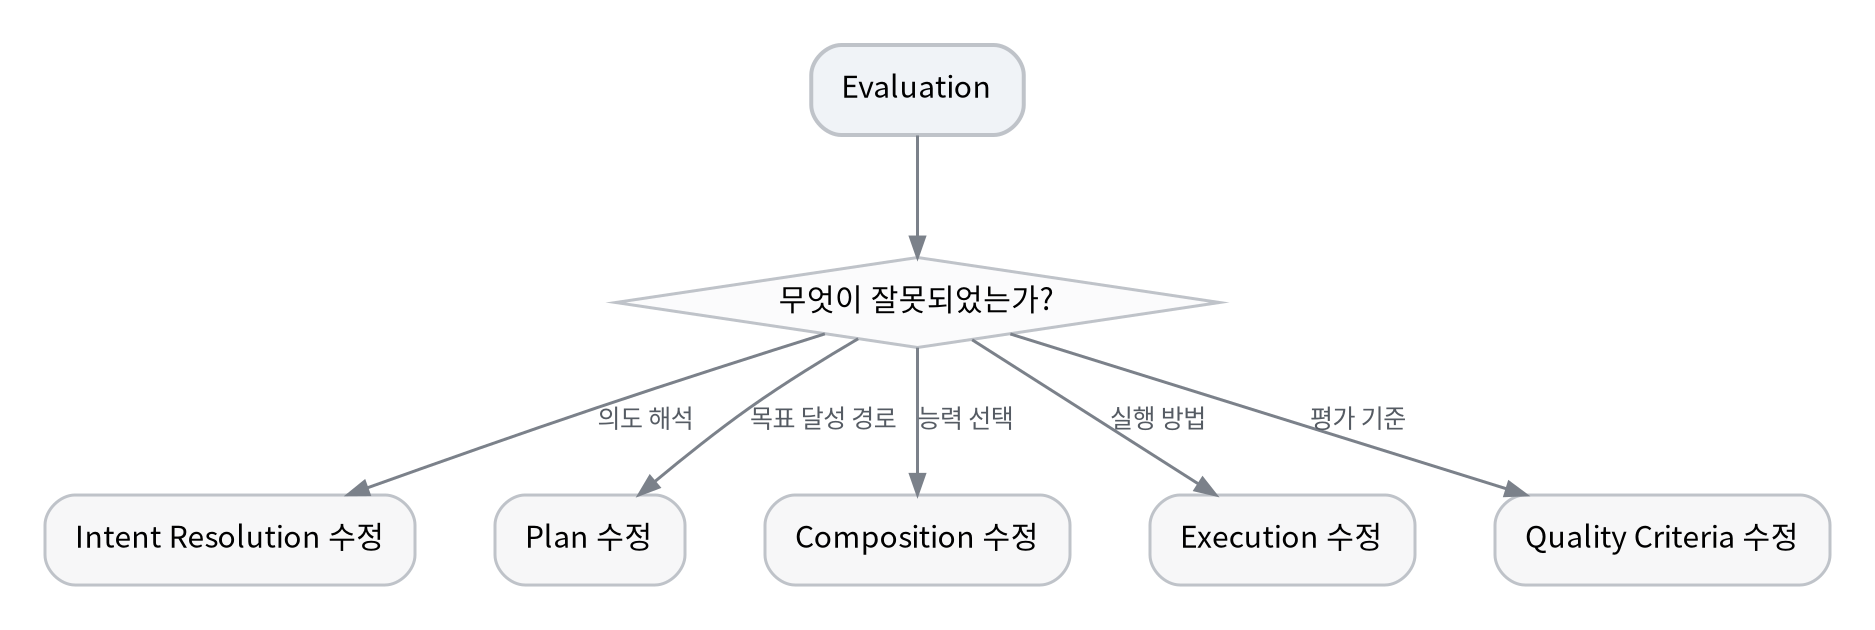
따라서 자기개선의 핵심은 단순한 Feedback 저장이 아니라
Feedback이 어느 의사결정 계층을 수정해야 하는지 식별하는 것
이다.
12. 현재까지 얻은 핵심 통찰
1. 메타 하네스의 본질은 모듈의 수보다 경계다.
Interpretation
Planning
Composition
Control
Execution
Evaluation
이 서로 섞이지 않아야 각 계층을 독립적으로 발전시킬 수 있다.
2. Meta Harness 앞에는 의미의 안정적인 경계가 필요하다.
Human Intent
    ↓
Intent IR
    ↓
Executable System
3. Intent Compiler의 핵심 산출물은 Intent IR이다.
중요한 것은 Compiler라는 이름이 아니라
실행 계층에 어떤 의미 정보를 넘길 것인가
이다.
4. Intent Language는 발명하기보다 실제 작업에서 추출해야 한다.
실제 사례
→ 반복되는 의미
→ Semantic Model
→ Intent IR
5. Context·World Model·User Model·Terminology는 의미론의 일부다.
의도는 문장 자체보다 문장과 상태의 관계에서 결정된다.
6. Intent는 정적인 단일 객체보다 Graph에 가까울 가능성이 높다.
복잡한 작업에는
Intent
 ├─ Sub-intent
 ├─ Dependency
 ├─ Constraint
 ├─ Assumption
 └─ Uncertainty
가 함께 존재하기 때문이다.
7. Feedback 역시 하나의 목적지만 가지지 않는다.
Evaluation
 ├→ Intent 수정
 ├→ Plan 수정
 ├→ Composition 수정
 └→ Execution 수정
처럼 실패 원인에 따라 환류 지점이 달라져야 한다.
13. 기존 개념을 현재 설계와 연결하면
새로운 개념을 배우기 위한 목록이 아니라, 현재 가지고 있는 추상적 개념을 더 정확하게 표현하기 위해 빌려 쓸 수 있는 대응 관계다.
Compiler IR
→ 인간 표현과 실행 표현을 분리하는 안정적인 경계

Compiler Pass
→ 하나의 거대한 추론 대신 단계별 의미 변환

Semantic Analysis
→ 문장 구조가 아니라 실제 의미와 유효성을 판단하는 계층

Symbol Table
→ Terminology와 참조 대상을 안정적으로 연결하는 사고 모델

Ontology
→ Intent를 구성하는 개념과 관계를 정의하는 모델

Planning
→ 원하는 상태와 그 상태에 도달하는 방법을 분리

State Machine
→ Work Controller의 실행 상태 표현

Policy Engine
→ Governance를 실제 실행 로직과 분리

Observability
→ 실행 기록을 다음 판단에 사용할 수 있는 구조화된 데이터로 변환
핵심은 이 개념들을 그대로 가져오는 것이 아니다.
현재 설계에서 이미 존재하는 추상적 문제를 어떤 기존 개념이 가장 잘 설명하는가
를 기준으로 이용하는 것이다.
14. 앞으로 설계에서 계속 던질 질문
의미의 위치
이 정보는 Intent 자체인가?
Context에서 참조해야 하는가?
World Model의 상태인가?
User Model의 특성인가?
책임의 위치
이 판단은
Intent Resolution?
Validation?
Planner?
Composer?
Runtime?
중 어디에서 해야 하는가?
표현의 수준
Intent IR은
사용자가 원하는 것을 표현해야 하는가,
실행 시스템이 필요한 것을 표현해야 하는가,
둘 사이의 안정적인 최소 계약이어야 하는가?
불확실성
해석이 확정되지 않았을 때
시스템은 하나를 선택해야 하는가,
복수 후보를 유지해야 하는가?
변화
작업 중 의도가 바뀌면
기존 Intent를 mutate하는가,
새로운 Intent state를 만드는가?
평가
성공은 최종 Result만 평가하면 되는가,
원래 Intent와 결과 사이의 차이를 평가해야 하는가?
자기개선
실패가 발생했을 때
어느 계층의 판단을 수정해야 하는가?
15. 전체 구조의 압축
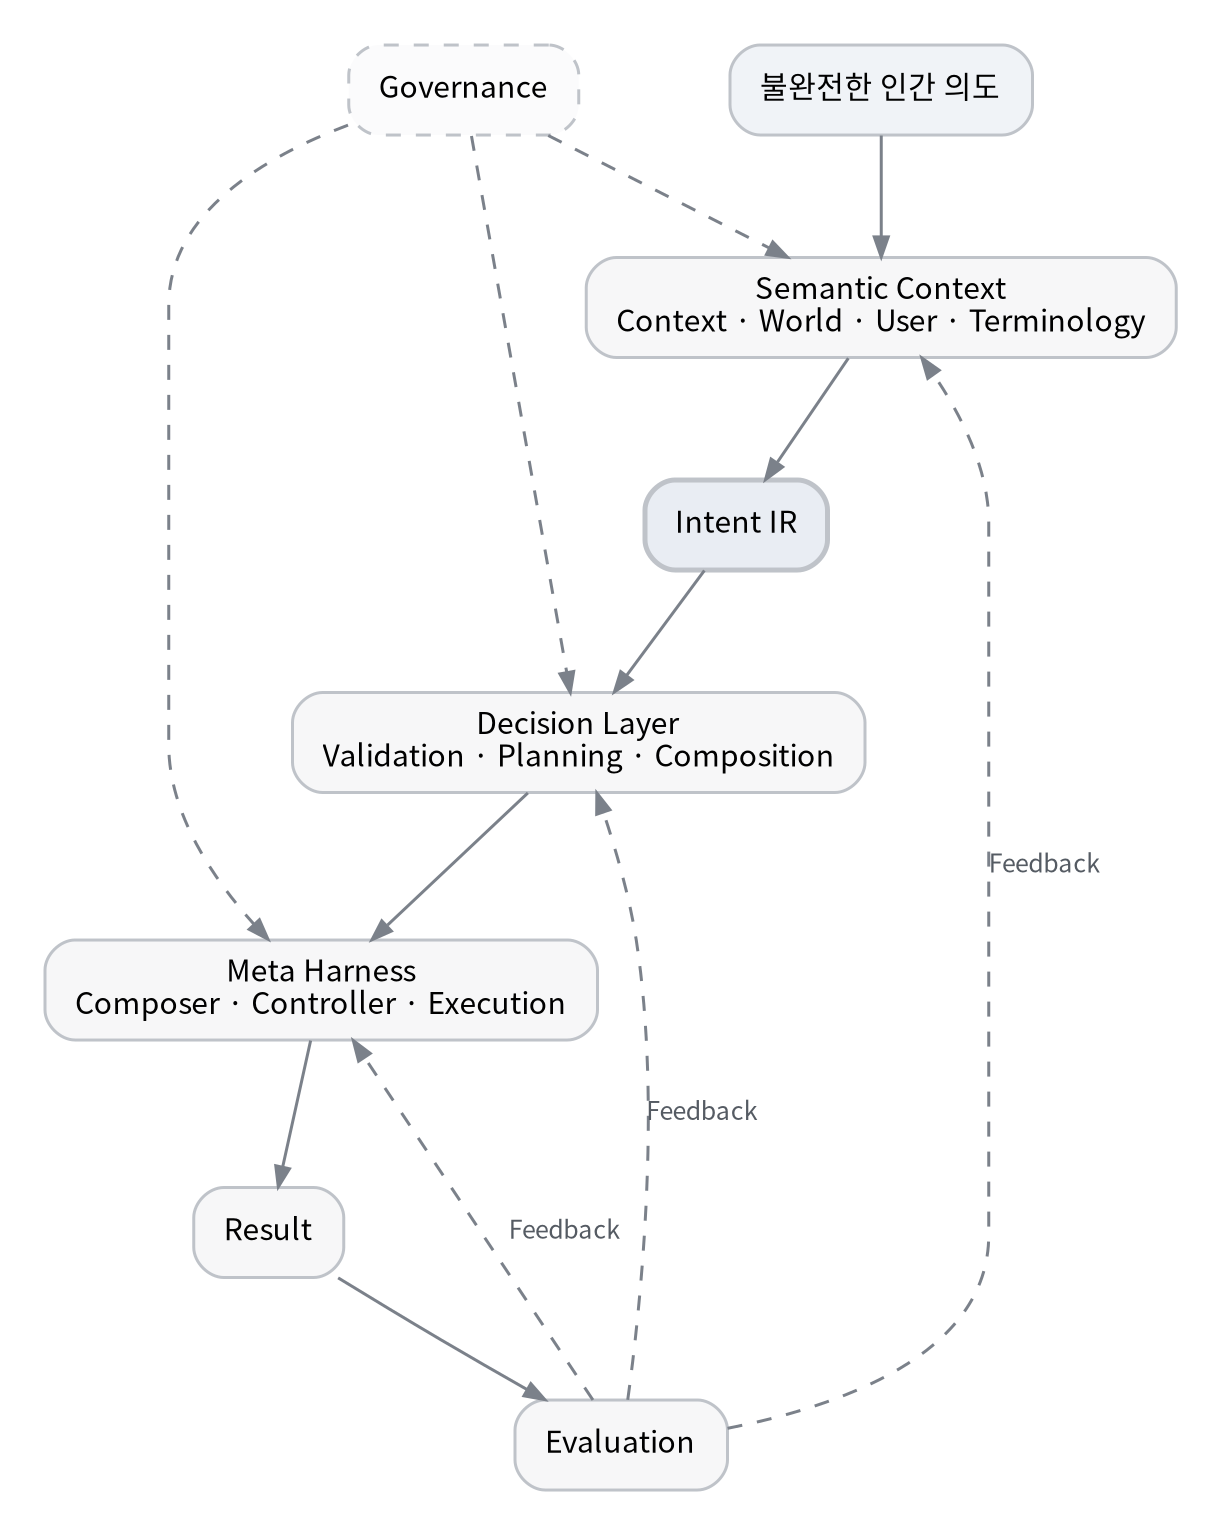
현재 작업을 가장 짧게 표현하면 다음과 같다.
불완전한 인간 의도를 명시적인 의미 구조로 만들고, 그 의미에서 실행 구조를 동적으로 생성하며, 실행 결과를 다시 적절한 판단 계층으로 환류시키는 시스템을 설계하고 있다.
따라서 앞으로 중요한 것은 새로운 기능을 계속 추가하는 것이 아니라,
각 개념의 경계를 명확히 하고, 노드 사이에 어떤 정보가 흐르는지 정의하며, 실제 작업 사례를 통해 그 그래프가 충분한지 검증하는 것
이다.
