데이터와 정보의 차이를 아시나욘
쇼핑몰이 정신 없이 바빠 고객들의 구매 내역 관심 리스트 등 여러 데이터를 얻게 되었다 치자, 이제 이 수 많은 기록(데이터)을 그냥 놔둬서 될까요?
ㄴㄴ 어떤 물건이 인기가 많은지 누가 많이 구매를 했는지 알기 위해서는 이 데이터를 정보화하는 과정이 필요합니다.
1단계 - 데이터 (개별적인 값)
db 테이블에 들어가기 전 이런 데이터가 있을 것
- user01
- 티셔츠
- 25,000
- 2025-05-30
이렇게 조각조각 봐서는 누군지, 티셔츠를 산 건지 반품한 건지 등.. 의미가 유의미하게 연결되지 않으므로 좋은 판단을 할 수가 없게 됩니다.
1.5단계 - 구조화된 데이터(유의미한 내용)
db 테이블에서 우리는 이런식으로 본 적이 있을텐데
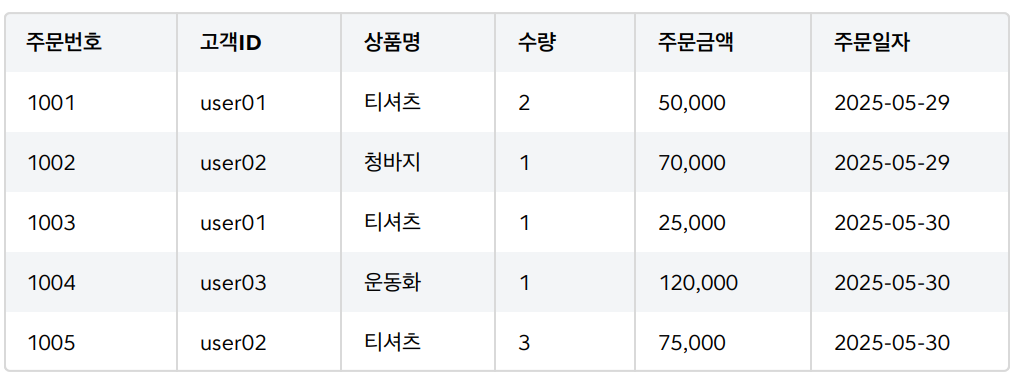
1단게와 다르게 파편화된 값들이 명시적인 의미를 가지게 된 것을 알 수 있습니다.
그러나 아직 이 의미가 의사결정에 도움이 되는지는? 모르겠지 않나요?
2단계 - 정보(결과물)
위에 구조화된 데이터를 어떠한 질문이나 목적을 가지고 분석하여 가공!해낸 유의미!한 결과물이라고 보실 수 있겠습니다.
예를들면~~
상사가 5월 30일에 가장 많이 팔린 상품과 그 수량을 물었을 때
우리는 1.5단계를 아래와 같이 가공해야하는데
1. 필터링 : 주문일자가 '2025-05-30' 데이터 추출
- 주문 1003, 1004, 1005가 해당
2. 그룹화 및 집계 : 위 데이터를 '상품명'으로 묶고, '수량'을 합산
- 티셔츠 : 1개(1003) + 3개(1005) = 총 4개
- 운동화 : 총 1개(1004)