파트2부터는 본격적인 생성 모델링 방식에 대해 배운다.
그럼 오늘은 파트 2(ch.3~ch.8)의 시작인 3장 VAE에 대해 배워보도록 하자!
3장의 구성은 아래와 같다.
3.1 소개
3.2 오토인코더
3.3 VAE(변이형 오토인코더)
3.4 잠재 공간 탐색하기
목차를 보면 알 수 있듯이 오늘은 VAE에 대해 살펴보기 전 오토인코더에 관해 자세히 배우고 이 개념을 VAE에 녹여보도록 하겠다.
3.1 소개
소개에서는 우리가 스타일리스트인 브라이언에게 옷장 속 해당 옷의 위치를 알려주기만 하면 브라이언이 위치를 바탕으로 새로운 옷을 만든다는 가정을 한다. 이렇게 하면 브라이언에게 빈 곳의 위치를 알려주기만 하면 완전히 새로운 옷을 만들 수 있게 된다.
3.2 오토인코더
인코더(Encoder): 입력 데이터를 받아 잠재 공간의 낮은 차원으로 압축
디코더(Decoder): 압축된 잠재 공간의 데이터를 다시 원래의 데이터 공간으로 복원
임베딩(embedding):인코더가 디코더가 정확하게 재구성할 수 있도록 가능한 많은 정보를 내포시키는 과정
오토인코더(Autoencoder)는 입력 데이터를 효과적으로 압축(인코딩)하고 다시 복원(디코딩)하기 위해 설계된 인공 신경망입니다. 기본적으로 오토인코더는 비지도 학습 방식으로, 입력 데이터의 효율적인 표현(잠재 공간)을 학습하는 데 사용됩니다.
이러한 설명을 통해 알 수 있듯이 오토인코더의 목적은 출력이 원본 아이템에 가까워지도록 하는 것이다.
즉, 잠재공간(latent space)의 모든 포인트를 디코딩해 새로운 데이터를 생성하는 것이 목적이다!
그럼 본격적으로 실습을 시작하겠다. 실습은 패션 MNIST 데이터셋으로 진행된다.
3.2.1 데이터 로드 + 전처리
# 데이터를 로드합니다.
(x_train, y_train), (x_test, y_test) = datasets.fashion_mnist.load_data()

# 데이터 전처리
def preprocess(imgs):

    imgs = imgs.astype("float32") / 255.0 #기존 출력인 0~255 -> 0~1 로 바꿔줌
    imgs = np.pad(imgs, ((0, 0), (2, 2), (2, 2)), constant_values=0.0) ## 이미지에 패딩을 추가해 32x32로 만들어줌.
    imgs = np.expand_dims(imgs, -1) #이미지를 1차원으로 만들어줌.
    return imgs


x_train = preprocess(x_train)
x_test = preprocess(x_test)
3.2.2 오토인코더 구조

- 인코더: 이미지 같은 고차원 입력 데이터를 저차원 임베딩 벡터로 압축
- 디코더: 임베딩 벡터를 원본 도메인으로 압축 해제
위 그림을 통해 설명하자면,
입력이미지가 잠재 임베딩 벡터 z로 인코딩 -> 원본 픽셀 공간으로 디코딩 하는 과정을 거친다.
자 그렇다면 임베딩이란 무엇일까?
임베딩(z)는 원본 이미지를 저차원 잠재 공간으로 압축하는 것이고,
이 잠재 공간에서 포인트를 선택해 디코더에 통과시키면 새로운 이미지를 생성한다.
여기서 잠재공간(latent space)와 잠재 임베딩 벡터(latent embedding vector)의 차이점이 궁금해서 찾아보았다.
- 잠재 공간은 데이터가 표현되는 추상적인 공간 ->전체적인 차원 축소의 결과
- 잠재 임베딩 벡터는 잠재 공간 안에서 개별 데이터 포인트가 위치하는 구체적인 위치나 벡터 -> 특정 데이터 포인트의 위치나 상태를 설명
3.2.3 인코더
자! 그럼 인코더 코드를 살펴보자.
encoder_input = layers.Input(
    shape=(IMAGE_SIZE, IMAGE_SIZE, CHANNELS), name="encoder_input"
)
x = layers.Conv2D(32, (3, 3), strides=2, activation="relu", padding="same")(
    encoder_input
)
x = layers.Conv2D(64, (3, 3), strides=2, activation="relu", padding="same")(x)
x = layers.Conv2D(128, (3, 3), strides=2, activation="relu", padding="same")(x)
shape_before_flattening = K.int_shape(x)[1:]  # 디코더에 필요합니다!

x = layers.Flatten()(x)
encoder_output = layers.Dense(EMBEDDING_DIM, name="encoder_output")(x)

encoder = models.Model(encoder_input, encoder_output)
encoder.summary()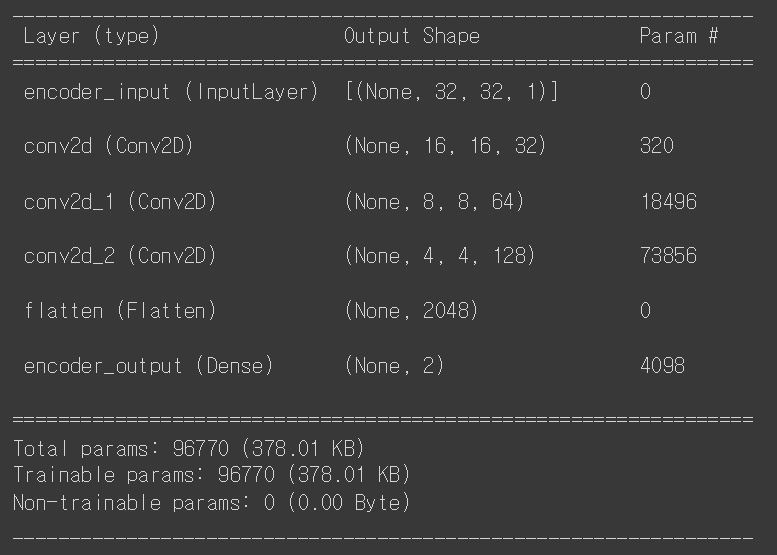
이 출력은 위에서부터 순서대로 input층과 Con2D(합성곱층) 3개, 합성곱 출력을 1차원 벡터로 펼치는 층, 벡터를 2D임베딩에 해당하는 dense층에 연결하는 층이다.
3.2.4 디코더
decoder_input = layers.Input(shape=(EMBEDDING_DIM,), name="decoder_input")
x = layers.Dense(np.prod(shape_before_flattening))(decoder_input) #입력을 Dense층에 연결.
x = layers.Reshape(shape_before_flattening)(x)
x = layers.Conv2DTranspose(
    128, (3, 3), strides=2, activation="relu", padding="same"
)(x)
x = layers.Conv2DTranspose(
    64, (3, 3), strides=2, activation="relu", padding="same"
)(x)
x = layers.Conv2DTranspose(
    32, (3, 3), strides=2, activation="relu", padding="same"
)(x)
decoder_output = layers.Conv2D(
    CHANNELS,
    (3, 3),
    strides=1,
    activation="sigmoid",
    padding="same",
    name="decoder_output",
)(x)

decoder = models.Model(decoder_input, decoder_output)
decoder.summary()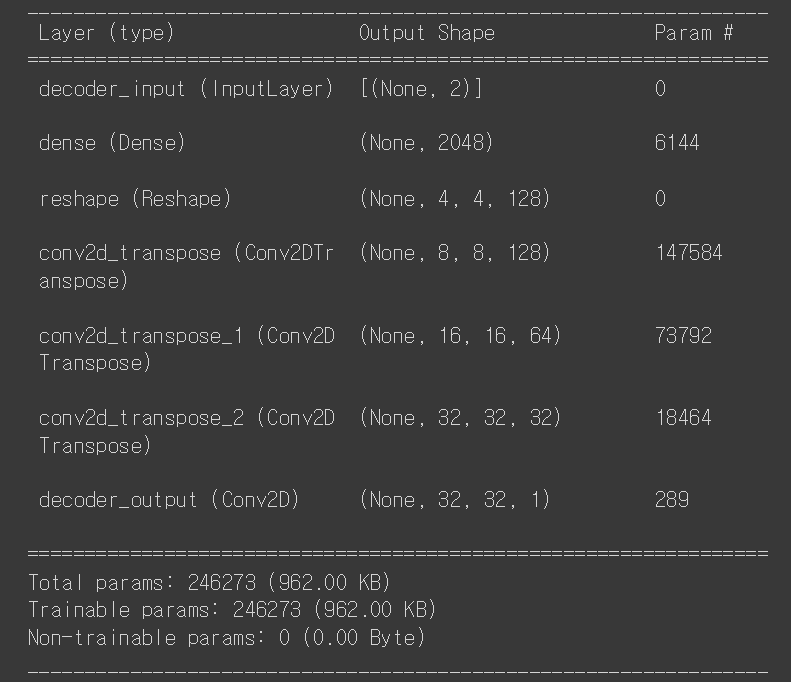
디코더 코드에서는 생소한 reshape층과 conv2d_transpose층만 다루도록 하겠다.
-
reshape: dense층에 연결된 입력이 conv2d_transpose층에 입력으로 쓰일 수 있도록 reshape층으로 벡터의 크기를 바꿈(=크기가 2차원인 dense층에서 conv2d_transpose에 맞는 벡터 크기로 바꿈)
-
conv2d_transpose: "전치 합성곱 층"으로, conv2D에서 strides를 이용해 이미지 크기를 줄였던 것과 반대로 strides를 통해 크기를 증가시키는 것이다. 궁극적인 목표는 32x32x1로 만드는 것!
ex)3x3x1 ----'strides=2'----> 6x6x1
3.2.5 인코더와 디코더 연결
# 오토인코더
autoencoder = models.Model(
    encoder_input, decoder(encoder_output)
)
autoencoder.summary()

# 오토인코더 컴파일
autoencoder.compile(optimizer="adam", loss="binary_crossentropy")

#오토인코더 훈련
autoencoder.fit(
    x_train,
    x_train,
    epochs=5,
    batch_size=100,
    shuffle=True,
    validation_data=(x_test, x_test),
    callbacks=[model_checkpoint_callback, tensorboard_callback],
)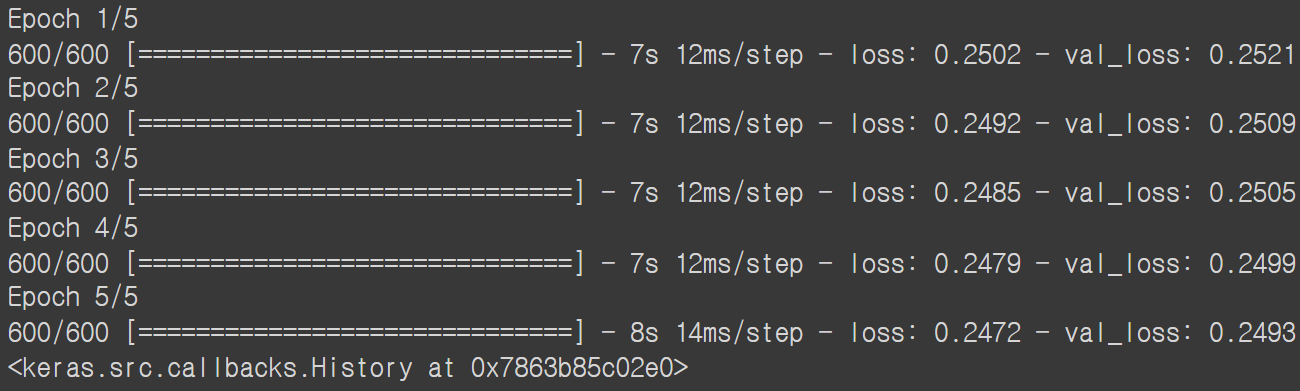
손실이 꽤 낮은 편이라는 것을 알 수 있다 :)
3.2.6 이미지 재구성
다음으로 인코딩을 거쳐 디코딩 된 결과를 보자!
predictions = autoencoder.predict(example_images)

print("실제 의류 아이템")
display(example_images)
print("재구성 이미지")
display(predictions)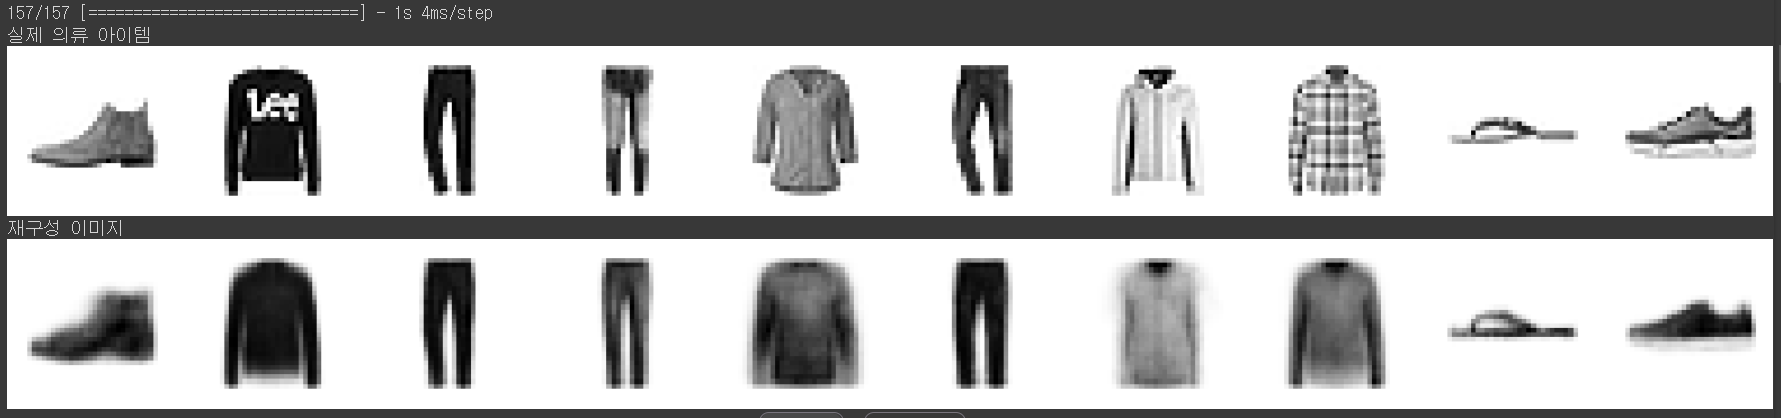
디코딩 된 결과가 원본 이미지에 비해 흐릿하고, 로고도 잡아내지 못한 것을 알 수 있다.
그 이유는..! 2D로 임베딩하면서 정보가 손실됐기 때문이다ㅠㅅㅠ
3.2.7 잠재 공간 시각화
# 샘플 이미지를 인코딩합니다.(임베딩 생성)
embeddings = encoder.predict(example_images)

# 몇 개의 임베딩을 출력합니다.
print(embeddings[:10])

# 레이블(의류 종류)에 따라 임베딩에 색을 입힙니다.
example_labels = y_test[:5000]

figsize = 8
plt.figure(figsize=(figsize, figsize)) #그래프 크기 설정
plt.scatter( #임베딩들을 2D 공간에 점으로 표현
    embeddings[:, 0],   #임베딩 벡터의 첫 번째 차원을 x축 좌표로 사용
    embeddings[:, 1],	#임베딩 벡터의 두 번째 차원을 y축 좌표로 사용
    cmap="rainbow",		#점들에 색상을 입히는 컬러맵을 무지개색으로 설정.
    c=example_labels,   #각 점의 색상을 example_labels 배열의 값에 따라 다르게 표시하도록 지정합니다. 이 배열에는 각 이미지가 어떤 카테고리(의류 종류)에 속하는지 나타내는 레이블이 들어 있습니다.
    alpha=0.8,		#점들의 투명도
    s=3,		#점들의 크기
)
plt.colorbar()	#컬러바 추가해 레이블 별 색상 보여줌
plt.show()	#그래프 화면에 표시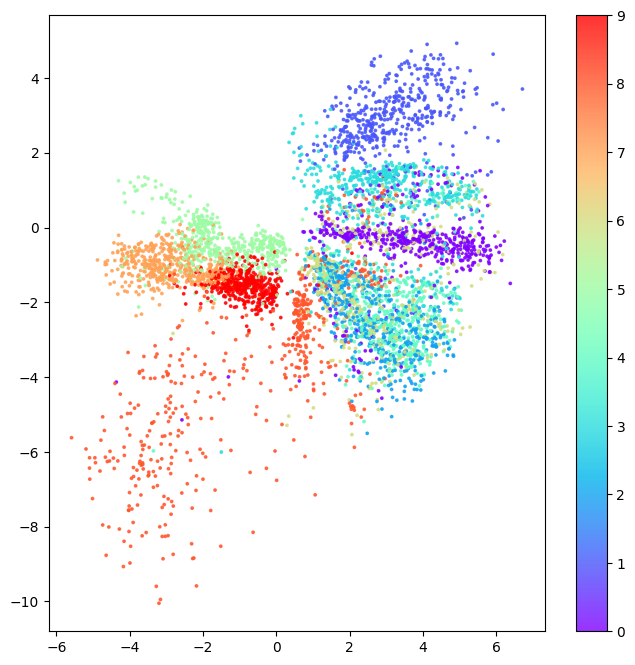
각 코드별 주석을 보며 그래프를 보면 혼자서도 해석할 수 있다.
3.2.8 디코딩을 통한 이미지 생성
# 기존의 임베딩 범위 구하기
mins, maxs = np.min(embeddings, axis=0), np.max(embeddings, axis=0)

# 잠재 공간에서 포인트를 샘플링합니다.
grid_width, grid_height = (6, 3)
sample = np.random.uniform(
    mins, maxs, size=(grid_width * grid_height, EMBEDDING_DIM)
)

# 샘플링된 포인트를 디코딩합니다.
reconstructions = decoder.predict(sample)

# 그래프로 그립니다.
figsize = 8
plt.figure(figsize=(figsize, figsize))

# ... 원본 임베딩 ...
plt.scatter(embeddings[:, 0], embeddings[:, 1], c="black", alpha=0.5, s=2)

# ... 잠재 공간에서 새로 생성된 포인트
plt.scatter(sample[:, 0], sample[:, 1], c="#00B0F0", alpha=1, s=40)
plt.show()

# 디코딩된 이미지 그리드 추가
fig = plt.figure(figsize=(figsize, grid_height * 2))
fig.subplots_adjust(hspace=0.4, wspace=0.4) ##서브플롯 간의 간격을 조정. hspace는 수평 간격, wspace는 수직 간격을 설정.

for i in range(grid_width * grid_height):
    ax = fig.add_subplot(grid_height, grid_width, i + 1) #그리드의 각 위치에 서브플롯을 추가
    ax.axis("off")  #서브플롯의 축을 숨김.
    ax.text( #각 이미지 아래에 텍스트 추가.
        0.5,
        -0.35,
        str(np.round(sample[i, :], 1)),
        fontsize=10,
        ha="center",
        transform=ax.transAxes,
    )
    ax.imshow(reconstructions[i, :, :], cmap="Greys")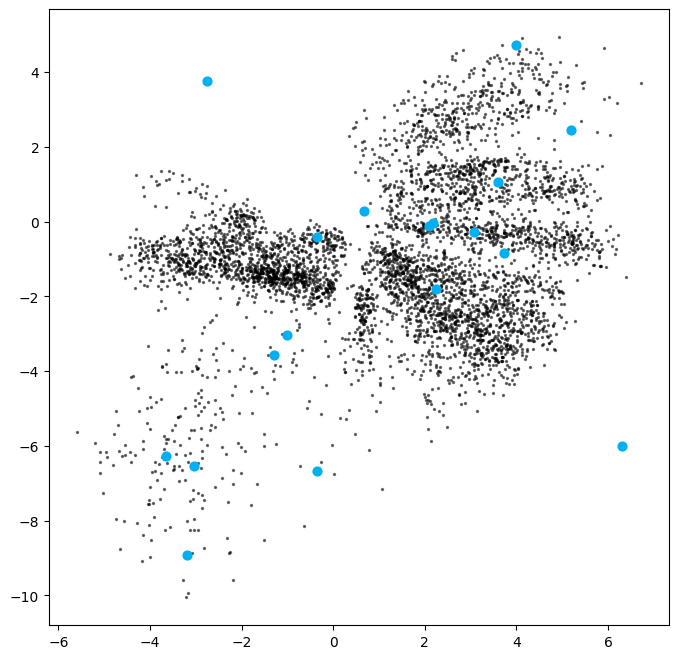
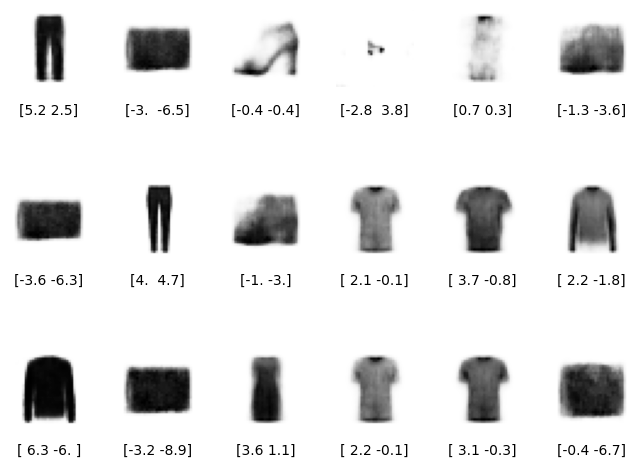
이 결과에서 일부 포인트의 이미지가 무척 선명하다는 점을 알 수 있다.
왜일까?
답은 잠재공간 내 포인트 분포와 관련있다.
잠재 공간 내 벡터가 많이 분포하는 곳에서는 포인트를 샘플링하는 것이 쉽지만 벡터가 적은 곳에서는 샘플링이 어렵기 때문이다.
3.3 VAE
드디어! VAE로 넘어왔다. 앞서 배웠던 오토인코더의 개념을 상기시키면서 VAE에 대해 배워보자.
3.3.1 인코더
오토인코더와 VAE는 잠재 공간 내 매핑 방식에 차이가 있다.
- 오토인코더: 각 이미지가 잠재 공간의 한 포인트에 직접 매핑
- VAE: 이미지가 잠재 공간에 있는 포인트 줒변의 다변량 정규 분포(multivariate normal distribution)에 매핑
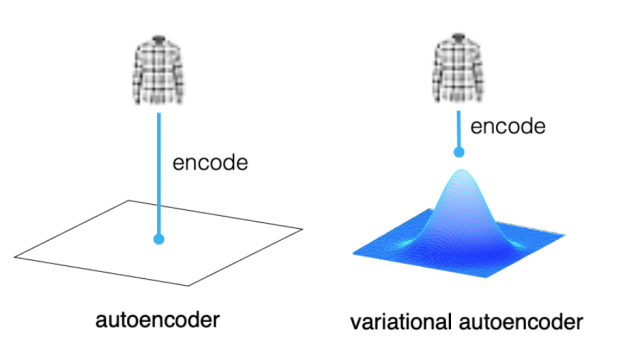
[출처: https://vitalflux.com/autoencoder-vs-variational-autoencoder-vae-difference/]
- 정규 분포(normal distribution or gaussian distribution):
평균과 분산으로 정의되는 확률 분포- 표준 정규 분포(standard normal distribution):
평균이 0이고 분산이 1인 정규 분포- 다변량 표준 정규 분포(multivariate standard normal distribution):
N(0,I)는 평균 벡터가 0이고 공분산 행렬이 단위 벡터인 다변량 분포
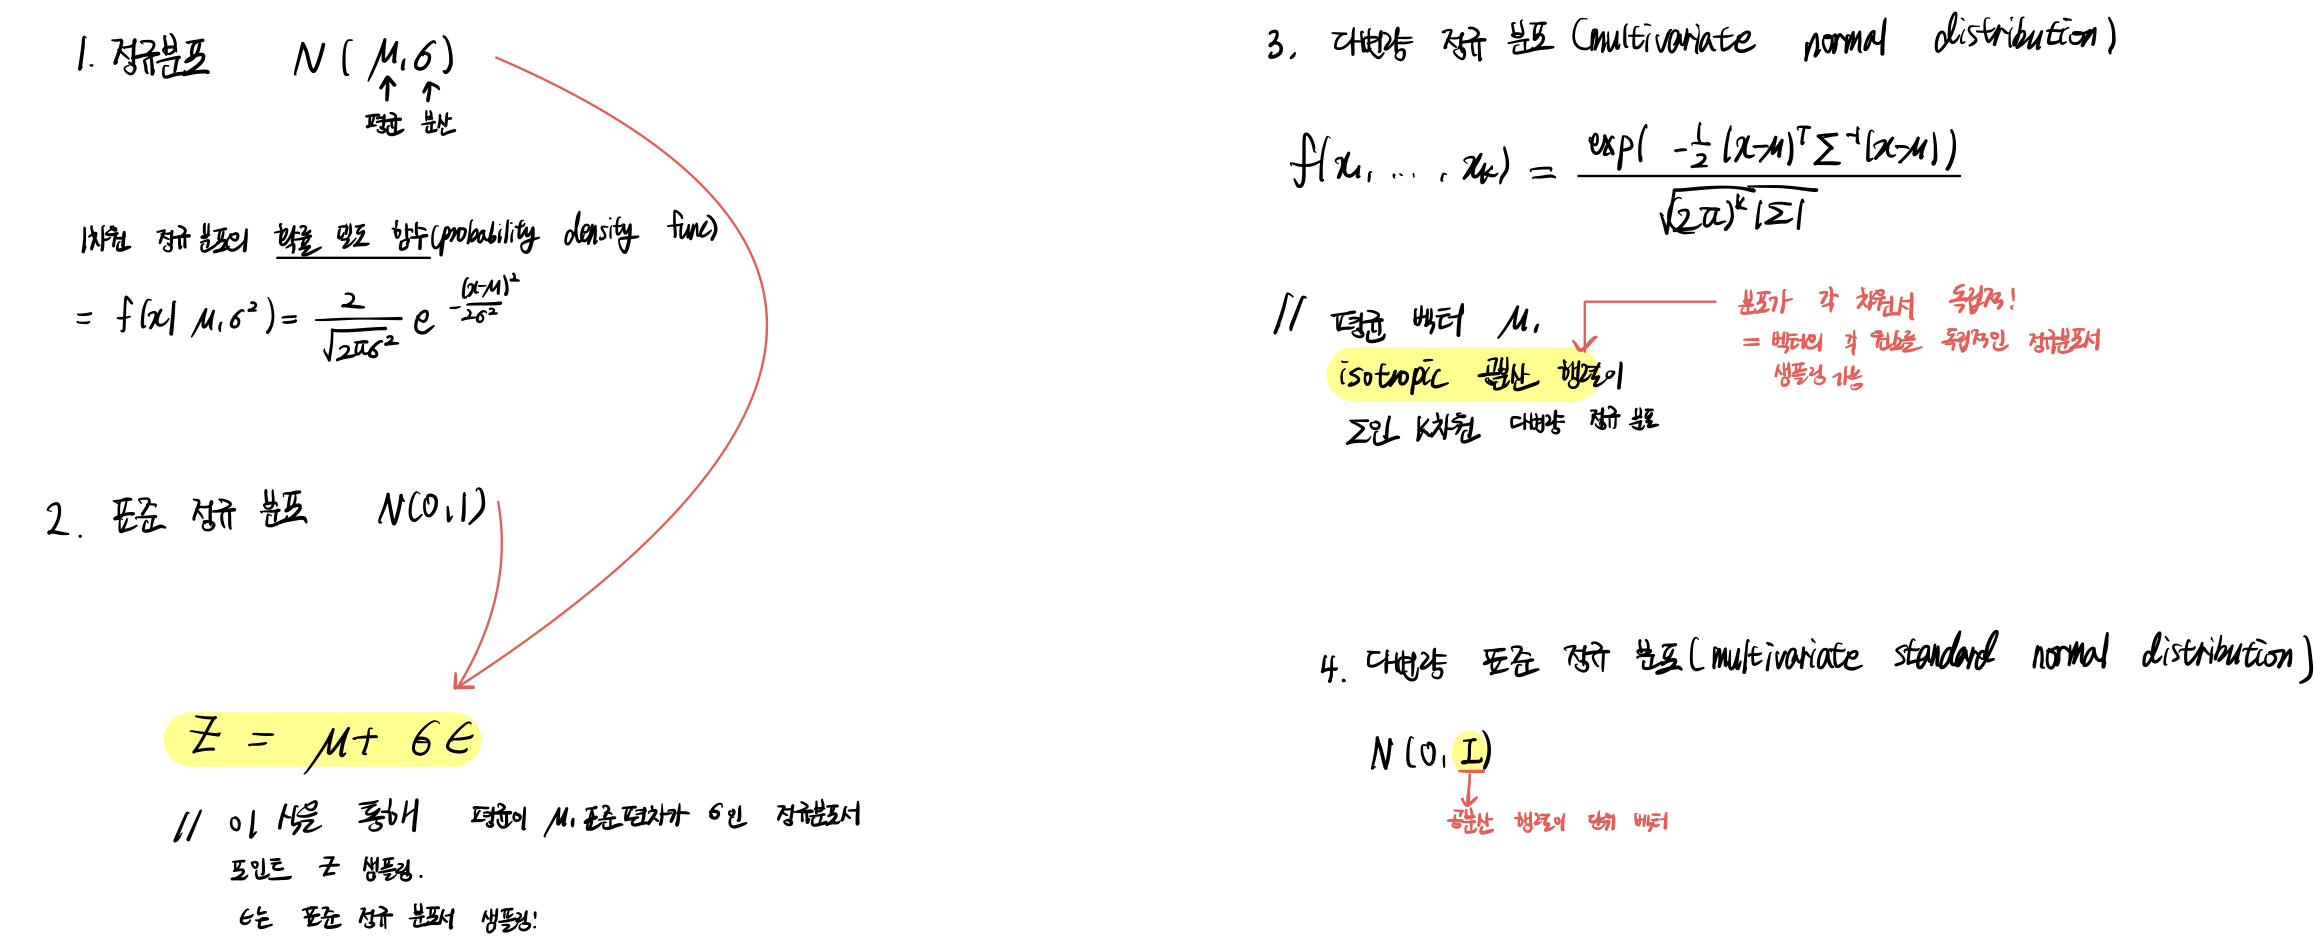
위 사진에서 z에 관한 식을 통해 포인트 z를 샘플링할 수 있으며
이는 입력 이미지가 latent space의 다변량 정규 분포를 정의하는 μ와 σ로 인코딩된다는 의미다.
이를 그림으로 나타내면 아래와 같다.
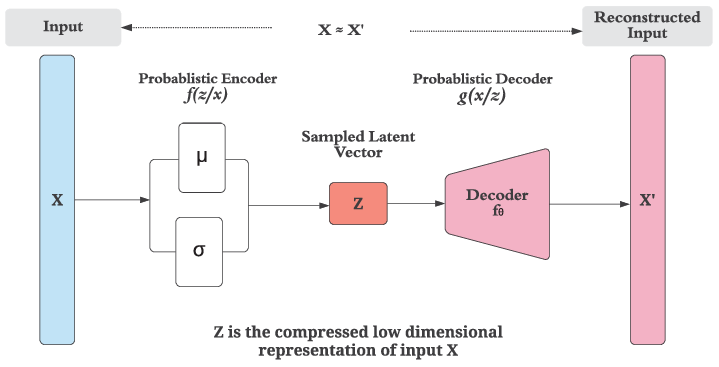
*ε은 다변량 표준 정규 분포서 샘플링!
샘플링에 대한 개념을 설명했으니 코드를 살펴보자.
#샘플링
class Sampling(layers.Layer):
    def call(self, inputs):
        z_mean, z_log_var = inputs
        batch = tf.shape(z_mean)[0]
        dim = tf.shape(z_mean)[1]
        epsilon = K.random_normal(shape=(batch, dim))
        return z_mean + tf.exp(0.5 * z_log_var) * epsilon


# 인코더
encoder_input = layers.Input(
    shape=(IMAGE_SIZE, IMAGE_SIZE, 1), name="encoder_input"
)
x = layers.Conv2D(32, (3, 3), strides=2, activation="relu", padding="same")(
    encoder_input
)
x = layers.Conv2D(64, (3, 3), strides=2, activation="relu", padding="same")(x)
x = layers.Conv2D(128, (3, 3), strides=2, activation="relu", padding="same")(x)
shape_before_flattening = K.int_shape(x)[1:]  # 디코더에 필요합니다!

x = layers.Flatten()(x)
z_mean = layers.Dense(EMBEDDING_DIM, name="z_mean")(x)
z_log_var = layers.Dense(EMBEDDING_DIM, name="z_log_var")(x)
z = Sampling()([z_mean, z_log_var])

encoder = models.Model(encoder_input, [z_mean, z_log_var, z], name="encoder") #입력 이미지를 받고, z_mean, z_log_var와 이런 파라미터로 정의된 정규분포에서 샘플링된 포인트 z를 출력.
encoder.summary()
3.3.2 손실 함수
VAE는 기존에 오토인코더에서 사용하던 손실 함수에 추가적으로 KL-divergence를 사용한다.
KL-divergence는 한 확률분포가 다른 분포와 얼마나 다른지 측정하는 도구이다.
- VAE에서는 평균이 z_mean, 분산이 z_log_var인 정규 분포가 표준 정규 분포와 얼마나 다른지 측정!
코드로 나타내면 아래와 같다.
kl_loss= -0.5 * sum(1+z_log_var - z_mean ^ 2 - exp(z_log_var))그렇다면 KL-divergence를 사용하는 게 왜 좋을까?
1. latent space에서 포인트를 선택할 때 사용할 수 있는 표준 정규 분포를 가지게 됨
2. 이 항이 모든 인코딩된 분포를 표준 정규 분포에 가깝도록 강제한다.
->결론적으로 포인터들의 분포가 표준 정규 분포를 따르게 되므로 디코딩 시 보다 선명한 결과물을 산출할 것임을 예측할 수 있다!
3.3.4 VAE 분석
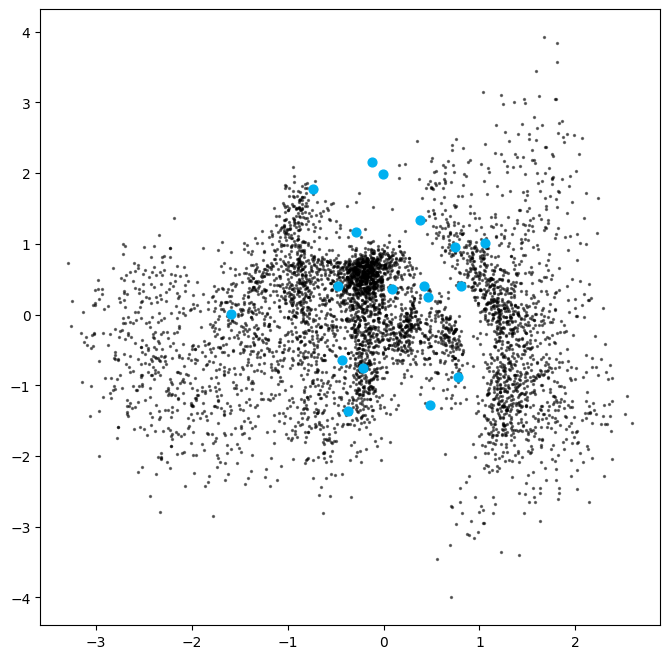
- 검은색 점: 인코딩된 각 이미지 z_mean 값 나타냄
- 파란색 점: latent space에서 샘플링된 일부 포인트 나타냄.
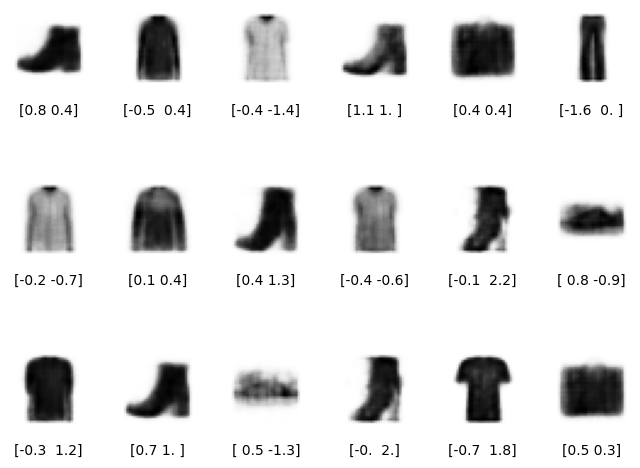
- 디코딩된 이미지
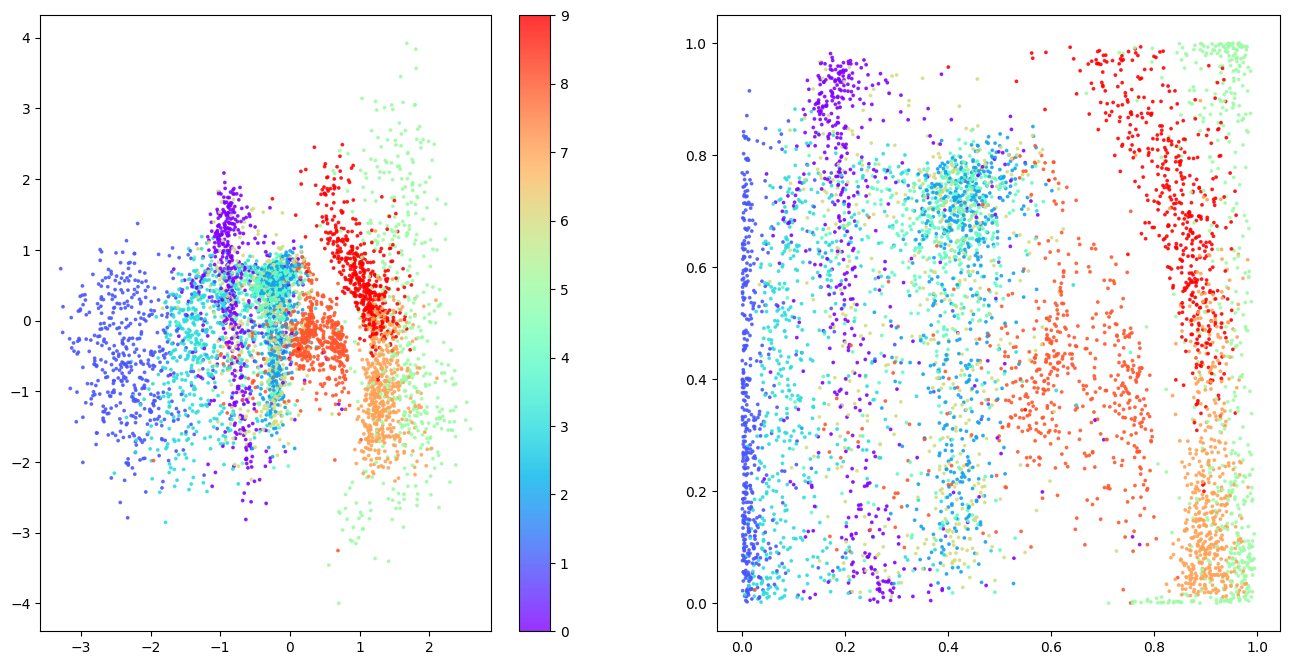
-
왼쪽: 잠재 공간의 포인트로 의류 종류 나타내기
-
오른쪽: 잠재 공간을 p-값으로 변환 <- 레이블별로 고르게 분포한다는 것을 알 수 있다.
cf)p-값: 어떤 사건이 우연히 발생할 확률(확률과 통계에 나오는 개념이다)3.4 에서는 CelebA데이터셋을 통해 잠재 공간을 탐색하는 부분이 나온다.
이 부분은 지금까지 배웠던 VAE를 응용하는 단계라 실습이 더 중요한 것 같다고 판단해 넘어가겠다..!
마지막으로 오늘 배웠던 오토인코더, VAE의 개념을 마무리해보자.
- 오토인코더는 입력 데이터를 효과적으로 압축(인코딩)하고 다시 복원(디코딩)하기 위해 설계된 인공 신경망이다.
- VAE는 multivariate normal distribution을 이용해 입력 데이터의 확률적 표현을 학습하는 생성적 신경망 모델이다.
- 이미지가 하나의 포인트로 매핑되는 게(오토인코더) 아니라 잠재 공간의 다변량 정규 분포를 의미하는 μ와 σ 벡터로 인코딩된다는 점(VAE)이둘의 차이점!
그럼 다음 4장에서 배울 GAN을 기약하며, 안녕! :)