고객 문의에 답을 쓰는 담당자들이 같은 문장을 매번 다시 타이핑하고 있었다. "자주 쓰는 문구를 골라 넣는 기능"을 만들기로 했다.
기능 자체는 간단하다. 문구 테이블 하나, 관리 화면 하나, 에디터에 삽입 버튼 하나. 진짜 문제는 그 문구를 무엇으로 채울 것인가였다.
기획에서 받은 초기 문구는 없었다. 대신 운영 DB 에 지난 답변이 10,953건 쌓여 있었다. 거기서 뽑기로 했다.
첫 번째 함정 — 전체 기간 빈도는 역사를 보여준다
단순하게 시작했다. 문장 단위로 쪼개고, 빈도순으로 정렬했다.
1위가 나왔다. "안녕하세요 ○○팀입니다" — 577건, 전체의 44%. 압도적이었다.
그런데 이 DB 는 2021년부터 쌓여 있다. 혹시나 해서 연도별로 나눠봤다.
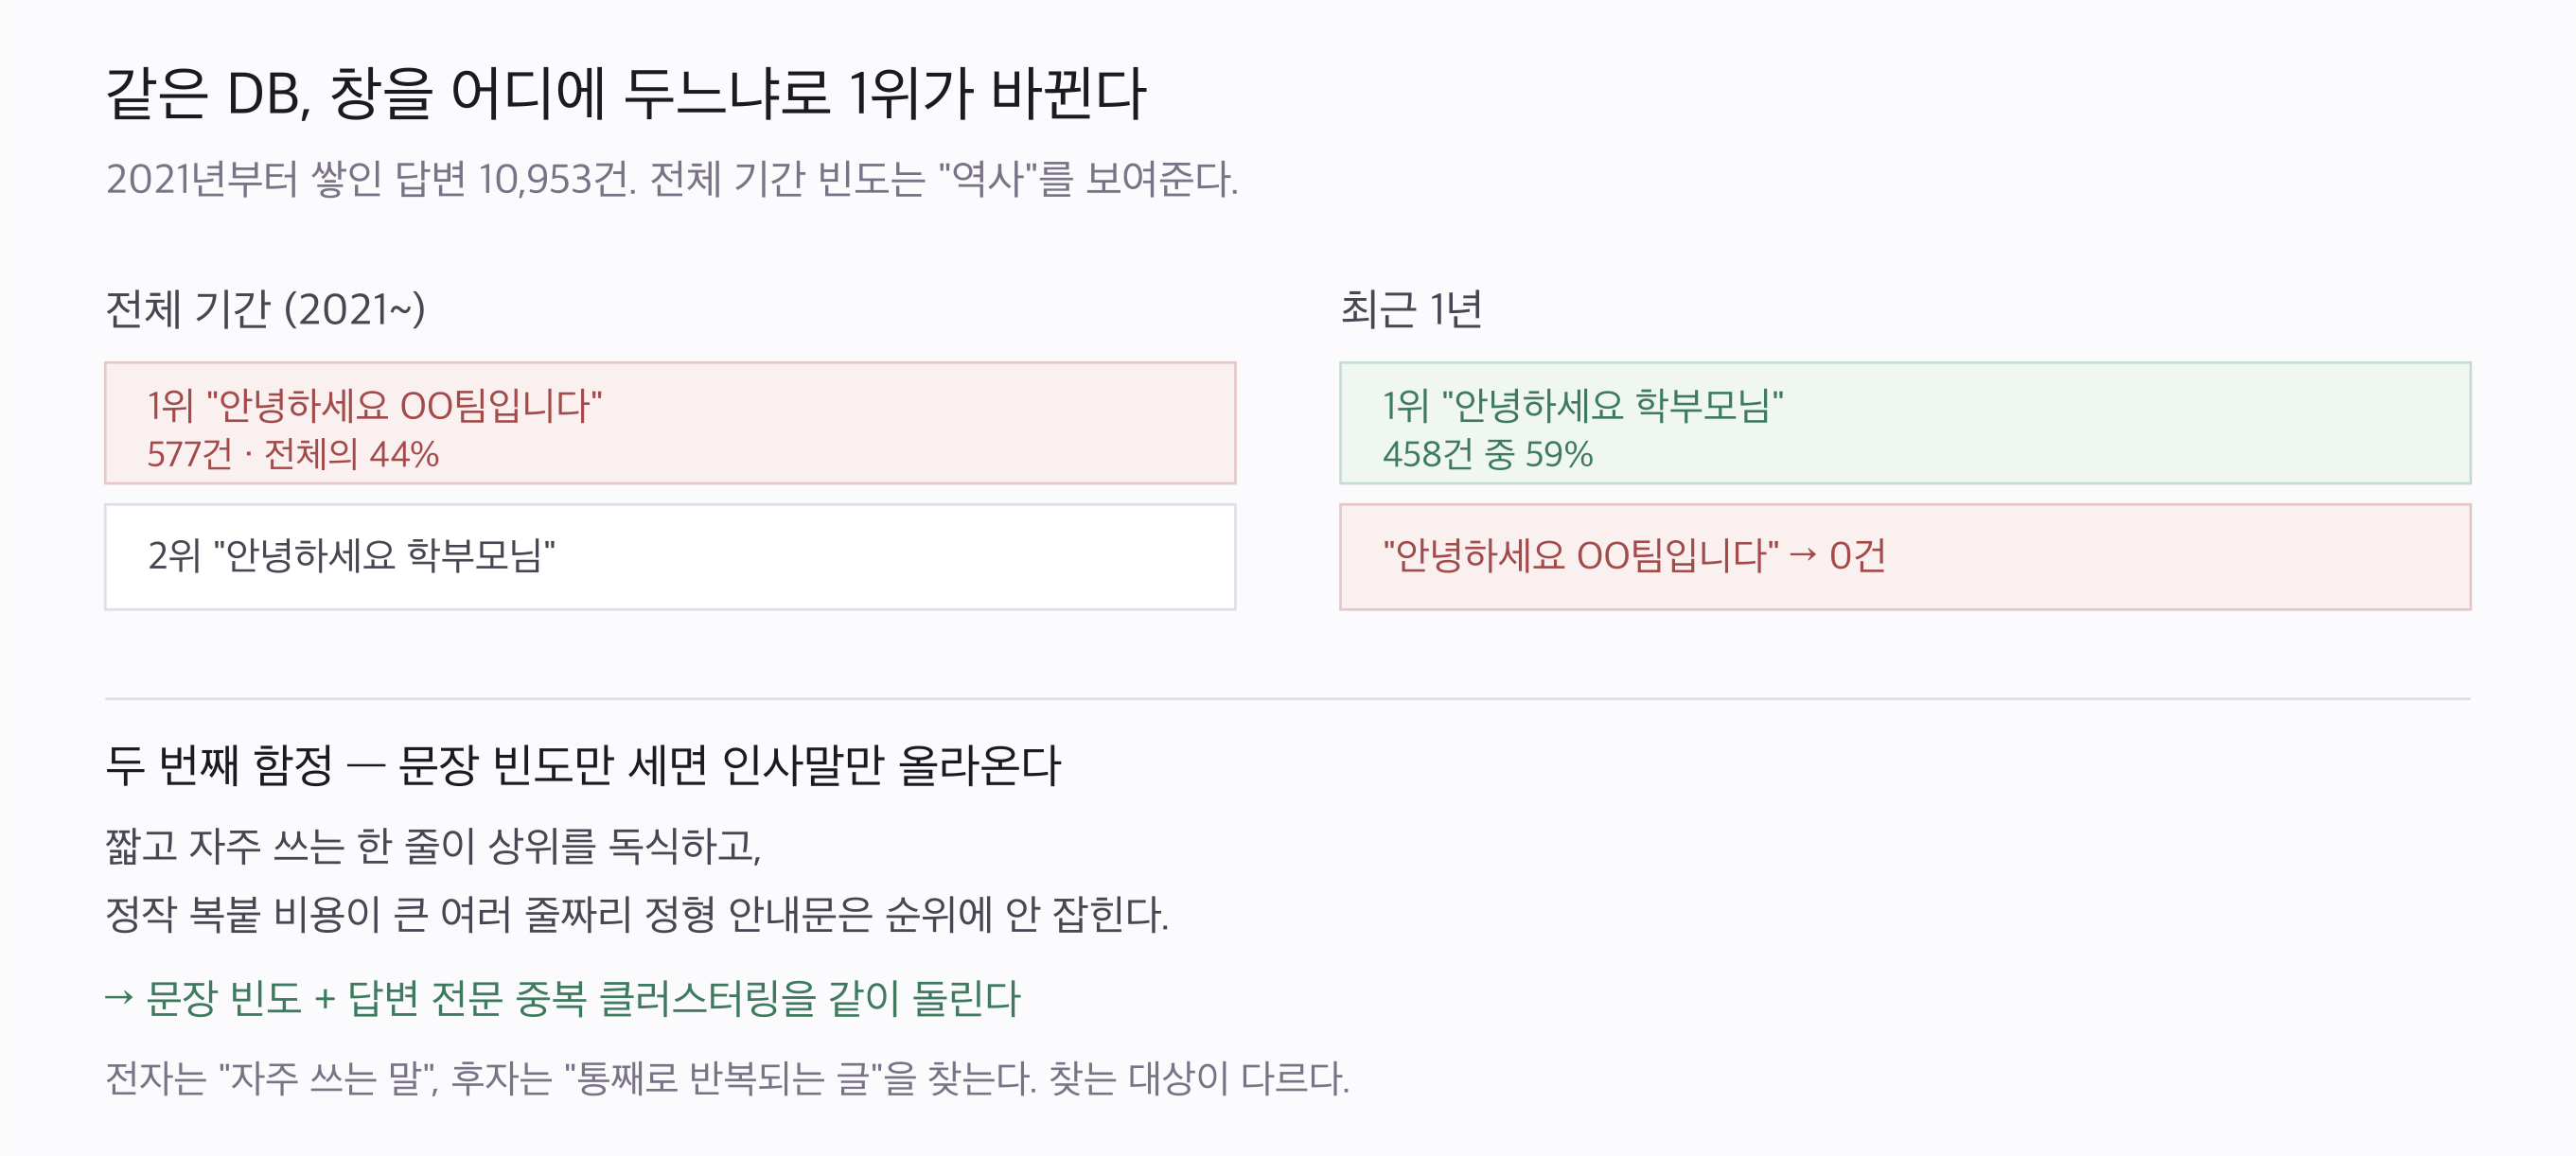
2026년에는 0건이었다.
조직 이름이 바뀌었거나 인사말 톤이 바뀌었거나, 아무튼 지금은 아무도 안 쓰는 문장이었다. 그걸 "가장 자주 쓰는 문구 1위"로 상용구에 넣을 뻔했다. 담당자가 그 버튼을 누르면 몇 년 전 조직 이름이 고객에게 나간다.
최근 1년으로 창을 좁히니 1위는 "안녕하세요 학부모님"(458건 중 59%)이었다. 그래서 모든 후보를 최근 1년 기준으로 재검증하고 28종으로 확정했다.
오래 쌓인 테이블에서
GROUP BY ... ORDER BY COUNT(*) DESC를 돌리면, 나오는 건 "지금 많이 쓰는 것"이 아니라 "오래 많이 쓰였던 것" 이다. 누적 빈도는 과거에 가중치를 준다.
두 번째 함정 — 문장 빈도는 인사말만 잡는다
최근 1년으로 좁히고 나서도 결과가 이상했다. 상위권이 전부 한 줄짜리 인사·맺음말이었다.
안녕하세요 학부모님
감사합니다
좋은 하루 되세요
확인 후 회신드리겠습니다
틀린 결과는 아니다. 실제로 자주 쓰니까. 그런데 상용구 기능이 아끼려던 비용은 이게 아니었다. 인사말은 짧아서 타이핑이 안 힘들다. 진짜 힘든 건 환불 절차 안내, 모집 일정 안내처럼 여러 줄짜리 정형 안내문이다.
이게 왜 안 잡히냐면, 긴 안내문은 매번 조금씩 다르게 쓰여서 문장 단위로 쪼개면 각각 빈도 1~2회로 흩어지기 때문이다.
그래서 두 번째 분석을 같이 돌렸다. 답변 전문(全文) 중복 클러스터링 — 답변 하나를 통째로 보고 서로 비슷한 것끼리 묶었다. 그랬더니 "통째로 반복되는 글" 묶음이 올라왔다.
두 방법은 찾는 대상이 다르다.
| 찾는 것 | 놓치는 것 | |
|---|---|---|
| 문장 빈도 | 자주 쓰는 말 | 변형이 섞인 긴 안내문 |
| 전문 클러스터링 | 통째로 반복되는 글 | 여러 글에 흩어진 공통 한 줄 |
둘 다 돌려야 전체가 보인다. 한쪽만 보고 "데이터로 뽑았다"고 하면 그 방법이 보는 것만 뽑힌 것이다.
안 넣은 것에도 이유가 있다
28종을 고르고 나니, 후보에서 떨어진 것들이 수십 개 남았다. 그냥 버릴 수도 있었는데 왜 뺐는지를 전부 SQL 주석에 적었다.
-- 제외: 3년 이상 미사용 (최근 사용 2022-11)
--   "오픈 예정 안내" / "재검토 안내" / "취소 처리 확인"
-- 제외: 사례 1건 — 상용구로 둘 근거 부족
--   "담당 부서 전달" / "오류 조치 완료"
-- 제외: 절차·연락처가 바뀌면 고객에게 직접 피해가 가는데 현재 값을 보장할 수 없음
--   "증명서 신청 폼" / "배송비 환불 계좌" / "교재 출고" / "결과 확인 경로"
세 번째 분류가 중요하다. 자주 쓰이지만 안 넣기로 한 것들이다. 계좌번호나 신청 링크가 들어간 안내문은, 그게 바뀌었을 때 상용구가 틀린 정보를 빠르게 퍼뜨리는 장치가 된다. 매번 직접 쓰면 쓰는 사람이 한 번은 확인한다.
내용을 고를 때도 같은 기준을 적용했다. 과정 소개와 모집 안내는 공식 안내 페이지에서 확인되는 사실만 남겼다. 2021년 답변에만 있고 현재 공식 페이지에서 확인 안 되는 수치(대상 연령 같은 것)는 문장에서 빼고 안내 링크로 넘겼다.
상용구는 "빠르게 쓰기"가 아니라 "빠르게 퍼뜨리기" 다. 틀린 걸 넣으면 틀린 게 빨라진다.
스키마에서 한 가지 결정
문구마다 "어느 화면에서 쓸 수 있나"를 지정해야 했다. 배열(여러 화면)로 할지 단일 값으로 할지.
단일 값으로 했다. 이유는 화면마다 답변을 받는 사람이 다르기 때문이다 — 학부모, 내부 통화 기록, 재택 강사. 받는 사람이 다르면 문구가 완전히 갈리고, 실제로 겹치는 게 하나도 없었다.
기술적인 이유도 있었다. JSON 배열로 두면 JSON_CONTAINS 조회에 인덱스가 안 걸린다. 그 비용을 치를 만한 사례가 아직 없었다. 생기면 그때 바꾸면 된다.
본문을 HTML 로 저장한 것도 같은 식이다. 관리 화면과 답변 입력창이 같은 에디터를 쓴다. 평문으로 담으면 넣을 때마다 줄바꿈을 변환해야 하고, 양쪽 변환이 어긋나면 문단이 깨진다.
남은 세 가지
① 집계 창(window)이 결론을 바꾼다. 오래된 테이블에서 "가장 많이"를 물으면 과거가 답한다. 지금을 알고 싶으면 지금의 창으로 물어야 한다. 그리고 그 창을 어디에 뒀는지를 결과와 함께 적어야 한다.
② 한 가지 방법으로 뽑은 건 그 방법이 보는 것만 보여준다. 문장 빈도와 전문 클러스터링은 각각 다른 걸 놓친다. "데이터 기반"이라는 말은 어떤 렌즈로 봤는지까지 말해야 의미가 있다.
③ 안 넣은 것의 이유를 남기는 게 넣은 것보다 오래 쓸모 있다. 6개월 뒤 누군가 "왜 이 문구는 없지?"라고 물을 때, 주석에 답이 있으면 같은 조사를 다시 안 한다. 이건 기능이 아니라 다음 사람에게 남기는 메모다.
운영 데이터에서 뭔가를 뽑을 때
- 이 테이블은 언제부터 쌓였나? 전체 기간 집계가 지금을 대표하나?
- 상위 결과가 전부 짧은 것들이라면, 단위를 잘못 쪼갠 것은 아닌가?
- 두 번째 방법으로 돌리면 다른 게 나오나? 나온다면 둘 다 필요한 것이다
- 뽑은 것 중에 시간이 지나면 틀려질 값(연락처·링크·금액)이 섞여 있나?
- 떨어뜨린 후보의 이유가 어딘가에 남아 있나?
다음 글은 코드 쪽으로 돌아간다. 다른 회사 시스템에서 넘겨받은 프론트엔드에 이름이 같은데 실패할 때 서로 다르게 동작하는 함수가 두 개 있던 이야기.
