"커리큘럼 페이지가 검색에 잘 안 나와요."
마케팅 쪽에서 온 말이었다. 보통 이런 요청은 "순위를 올려 달라"는 뜻이고, 그럼 메타 태그를 다듬거나 콘텐츠를 보강하는 일이 된다.
그런데 확인해보니 순위 문제가 아니었다. 그 페이지의 내용이 색인돼 있지 않았다.
JS 를 끄고 열어보면 안다
가장 빠른 확인 방법이다. 브라우저에서 JavaScript 를 끄고 페이지를 연다.
커리큘럼 페이지에는 아무것도 없었다. 스켈레톤 몇 개와 로딩 스피너. 그게 끝이었다.
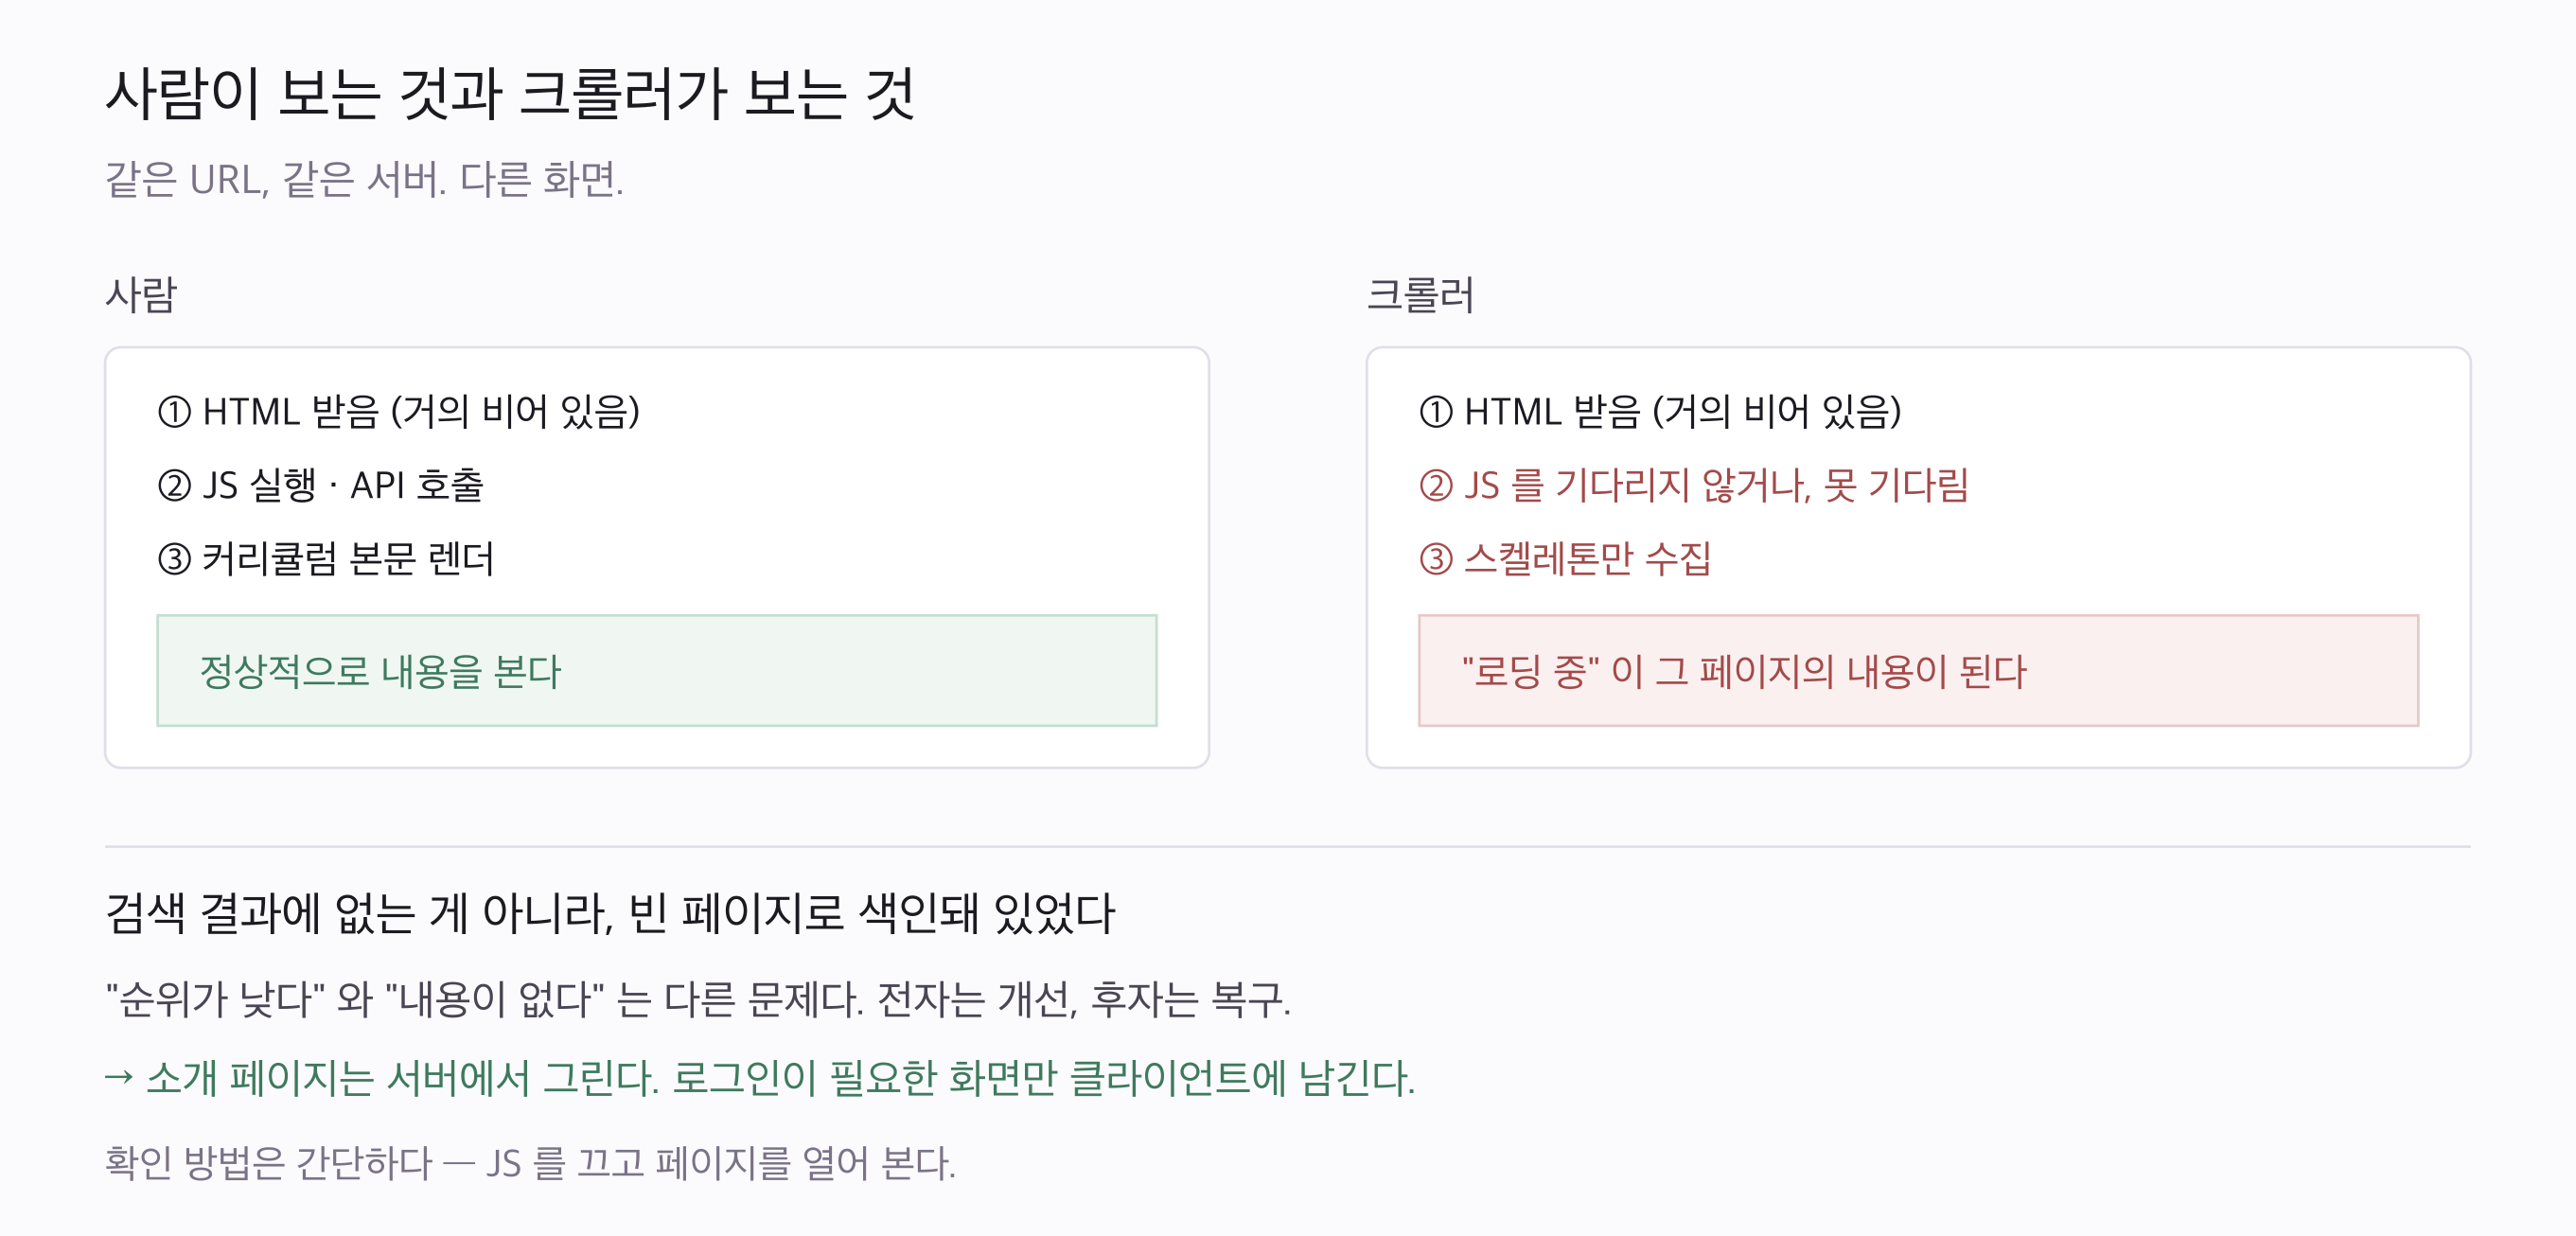
클라이언트에서 API 를 불러 내용을 채우는 구조였고, 사람에게는 잘 동작했다. 0.3초쯤 뒤면 전부 보이니까. 크롤러에게는 아니었다.
검색엔진이 JS 를 아예 못 돌리는 건 아니다. 다만 모든 페이지를 기다려주지는 않는다. 렌더링 예산은 유한하고, 사이트 규모와 신뢰도에 따라 배분된다. 신규 사이트의 소개 페이지는 그 줄의 뒤쪽이다.
결과적으로 "로딩 중"이 그 페이지의 내용으로 색인돼 있었다. 순위가 낮은 게 아니라 내용이 없었다.
"순위가 낮다"와 "내용이 없다"는 다른 문제다. 전자는 개선이고 후자는 복구다. 메타 태그를 아무리 다듬어도 본문이 없으면 소용없다.
고친 것
서버에서 그린다 — 전부는 아니고
커리큘럼, FAQ, 커뮤니티 상세를 서버 렌더링으로 옮겼다. 전부 옮기지는 않았다. 기준은 하나였다.
검색에서 들어올 수 있는 페이지인가.
마이페이지, 결제 흐름, 관리 화면은 그대로 뒀다. 로그인이 필요하고, 검색 결과에 뜨면 안 되고, 서버에서 그릴 이유가 없다. 오히려 로그인 체크 때문에 서버 렌더링이 더 복잡해진다.
SEO 작업에서 "전부 SSR 로"는 틀린 목표다. 색인되어야 할 페이지만 서버에서 그린다.
구조화 데이터 8종 · 31개 화면
검색 결과에 풍부한 형태로 뜨려면 페이지가 무엇에 관한 것인지를 기계가 읽을 수 있어야 한다. 교육기관, 강좌, FAQ, 게시글, 이동 경로 등 8종을 JSON-LD 로 넣었다.
여기서 조심한 건 화면에 없는 걸 구조화 데이터에 넣지 않는 것이다. 평점이나 리뷰 수 같은 걸 넣고 싶은 유혹이 있는데, 화면에 그 정보가 없으면 정책 위반이고 수동 조치 대상이다. 보이는 것만 적었다.
지루하지만 효과 큰 것들
| 전 | 후 | |
|---|---|---|
| 이미지 대체 텍스트 누락 | 33건 | 0건 |
| 잘못 쓰인 제목 태그 | 53개 | 17개 |
제목 태그는 "글자를 크게 하려고 h2 를 쓴" 것들이었다. 문서 구조와 시각적 크기가 다른 축인데 섞여 있었다. 크기는 CSS 로, 계층은 태그로 분리했다.
대체 텍스트는 SEO 항목으로 시작했지만 접근성 작업이다. 화면낭독기 사용자에게 이미지 33개가 "이미지"라고만 읽히고 있었다. SEO 를 명분으로 접근성 부채를 갚은 셈이고, 이런 건 같이 묶어서 파는 게 통과가 빠르다.
AI 크롤러는 어디까지 허용할까
2026년에 robots.txt 를 다시 쓰면서 새로 생긴 질문이다. 예전에는 "검색엔진 허용 / 나쁜 봇 차단" 둘뿐이었는데, 지금은 AI 봇이 두 종류다.
| 종류 | 하는 일 | 우리에게 | 판단 |
|---|---|---|---|
| 답변·검색용 | 사용자 질문에 답하며 출처로 인용 | 트래픽과 인지도로 돌아옴 | 허용 6종 |
| 학습 데이터 수집용 | 모델 학습에 사용 | 돌아오는 것 없음 | 차단 8종 |
기준은 하나로 정리했다. 우리 콘텐츠를 가져가면서 사용자를 우리에게 돌려보내는가.
답변 엔진은 "퍼플아카데미 커리큘럼이 어떻게 되나요"에 답하면서 링크를 단다. 검색엔진과 역할이 같다. 학습용 수집은 콘텐츠만 가져가고 돌아오는 게 없다.
이게 유일한 정답은 아니다. 브랜드 노출이 목적이면 학습용도 열 수 있고, 유료 콘텐츠가 있으면 답변 엔진도 막는 게 맞다. 중요한 건 봇 이름 목록이 아니라 기준을 먼저 정하는 것이다. 기준이 있으면 새 봇이 나와도 판단할 수 있다. 목록만 있으면 매번 검색해야 한다.
그래서 robots.txt 에 주석으로 기준을 적어뒀다. 다음에 고치는 사람이 왜 이렇게 갈렸는지 알 수 있게.
같은 설계를 두 번째 사이트에 넣을 때 — 스위치로
얼마 뒤 다른 브랜드 사이트를 이관하면서 같은 SEO 설정을 넣게 됐다. 그런데 문제가 있었다.
그 사이트는 아직 구 서비스가 운영 중이었다. 새 사이트를 지금 색인시키면 같은 내용이 두 주소에서 잡힌다. 그렇다고 컷오버 당일에 SEO 코드를 처음부터 짜는 것도 위험하다.
그래서 전부 넣되, 꺼 둔 채로 넣었다.
NEXT_PUBLIC_SEO_INDEXABLE=false # 컷오버 때 true 로| 스위치 OFF (지금) | 스위치 ON (컷오버) | |
|---|---|---|
robots.txt | Disallow: / 전체 차단 | 공개 경로 허용 + AI 봇 정책 |
| 페이지 메타 | noindex, nofollow | index, follow |
| 사이트맵 | 서빙 (robots 가 막음) | 서빙 |
| 구조화 데이터 · OG | 들어감 | 들어감 |
구조화 데이터와 메타데이터는 스위치와 무관하게 항상 들어간다. 색인이 막혀 있어도 카카오톡·슬랙 링크 미리보기는 동작해야 하니까.
컷오버 체크리스트에 이 한 줄을 추가했다. 당일에 할 일이 "환경변수 한 줄 + 이미지 재빌드"로 줄었다.
새 기능을 끈 채로 미리 넣는 것은 생각보다 자주 쓸 수 있는 패턴이다. 위험한 날에 할 일을 줄이는 게 핵심이다.
요약하면
SEO 요청을 받으면 세 가지를 순서대로 본다.
- JS 를 끄고 열어본다. 내용이 없으면 그게 1순위다. 나머지는 그다음이다
- 색인되어야 할 페이지만 서버 렌더링으로 옮긴다. 전부 옮기는 건 목표가 아니다
- 대체 텍스트·제목 계층처럼 지루한 것들을 센다. 숫자로 세면 끝이 보이고, 접근성도 같이 갚아진다
그리고 AI 크롤러는 봇 목록이 아니라 기준을 정해두면 다음에 안 헤맨다.
다음 글은 보안 쪽이다. 브라우저에서 토큰을 지우는 작업을 하면서, 호출부 248곳을 하나도 안 건드리고 전송 경로만 바꾼 이야기.
