1.Kafka란?
Kafka는 '대규모 실시간 데이터 스트리밍'을 처리하는 데 사용되는 '분산 이벤트 스트리밍 플랫폼'이다.
이렇게 단어들을 나열해 놓으면 이해하기 힘들 수 있으니 하나하나 짚어보자
우선 '대규모 실시간 데이터 스트리밍'이란 실시간으로 발생하는 큰 양의 데이터를 지속적이고 빠르게 처리하는 것을 의미한다.
예를 들면,
- SNS에서의 실시간 사용자 활동 기록
- 온라인 쇼핑몰의 주문 결제 이벤트
- IoT 센서에서 발생하는 대량의 데이터 수집
과 같은 순차적으로 끊이없이 생성되는 데이터를 최소한의 지연만으로 대규모의 데이터를 실시간으로 처리하고 여러 시스템으로 데이터를 효율적으로 전달하는데 특화되었다는 뜻이다.
그리고 '분산 이벤트 스트리밍 플랫폼'에서
'분산 이벤트'는 여러 시스템(서버, 애플리케이션 등)이 참여하여 생성, 전달, 처리하는 이벤트를 의미한다.
그리고 '이벤트 스트리밍'은 대량의 이벤트를 실시간으로 처리하는 방식을 의미한다.
즉, 이 두 단어를 연결시키면 여러 시스템에 분산되어 있는 대량의 이벤트들을 실시간으로 처리해주는 플랫폼
이게 Kafka의 역할이 되는 것이다.
그렇다면 Kafka는 어떤 방식으로 동작하길래 대규모의 분산 시스템에서 발생하는 이벤트들을 처리할 수 있는 것일까?
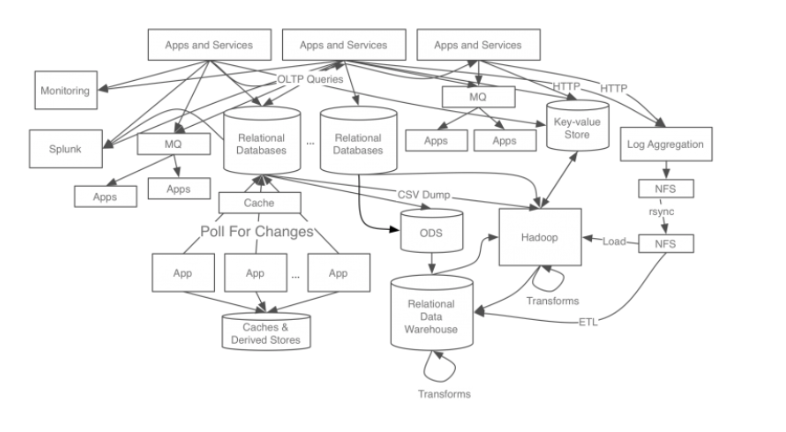
위 그림은 Kafka 개발 전 Kafka의 개발사인 링크드인의 데이터 처리 시스템이다.
연관된 각각의 애플리케이션과 DB가 직접적으로 연결된 End-to-End 방식의 시스템으로 요구사항이 점차 늘어남에 따라 데이터 시스템 복잡도가 높아져 그림과 같은 형태가 되었다.
이는 여러가지 문제점을 가져왔는데
- 애플리케이션과 DB 간의 높은 결합도
- 성능 병목
- 다수의 애플리케이션이 동시에 같은 DB에 접근하면 성능 저하가 발생
- DB의 부하가 커질수록 데이터 처리 속도가 느려짐.
- 데이터를 DB에 저장하고 다른 애플리케이션이 이를 조회하는 방식은 실시간 처리에 한계가 있음
- 복잡한 의존 관계
- 여러 애플리케이션이 같은 Db를 공유하면서, 누가 데이터를 쓰고 읽는지 관리가 어려움
- 데이터 충돌이나 동기화 문제 발생.
이러한 문제점들을 해결하기 위해 새로운 시스템의 개발에 대한 필요성이 높아졌고 모든 시스템으로 데이터 전송을 실시간으로 처리 가능하며 중앙 처리 방식으로 확장이 용이한 시스템을 개발하게 되는데 그것이 바로 Kafka다.
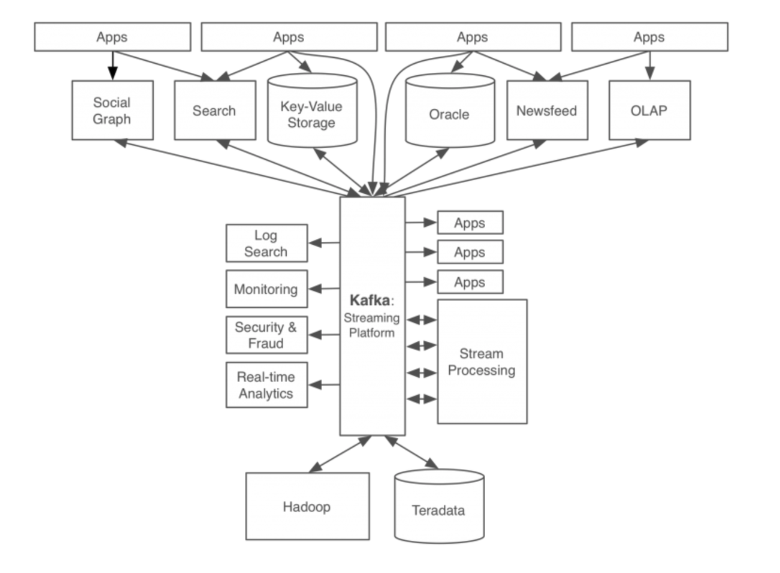
Kafka를 적용한 후 링크드인의 데이터 처리 시스템이다.
- 모든 이벤트/데이터의 흐름을 중앙에서 관리
- 새로운 서비스/시스템이 추가되더라도 Kafka에 연결하기만 하면 되므로 확장성과 신뢰성이 증가
- 개발자는 서비스 간 연결이 아닌 서비스들의 비즈니스 로직에만 리소스 투자
이렇게 Kafka는 개발 목적에서부터 대규모의 분산 시스템에서 이벤트를 효과적으로 처리하기 위해 개발되었는데
그렇다면 어떻게 이 분산 이벤트들을 실시간으로 관리하는 걸까?
그것은 바로 Kafka가 Pub/Sub 모델의 메시지 큐 형태로 동작하기 때문이다.
2. 메시지 큐(Message Queue, MQ)
2-1) 메시지 큐의 동작 원리
Kafka의 동작 원리를 이해하기 위해서는 먼저 메시지 큐에 대한 이해가 필요하다.
메시지 큐는 메시지 지향 미들웨어(MOM : Message Oriented Middleware)를 구현한 시스템으로 프로그램 간의 데이터를 교환할 때 사용되는 기술이다.
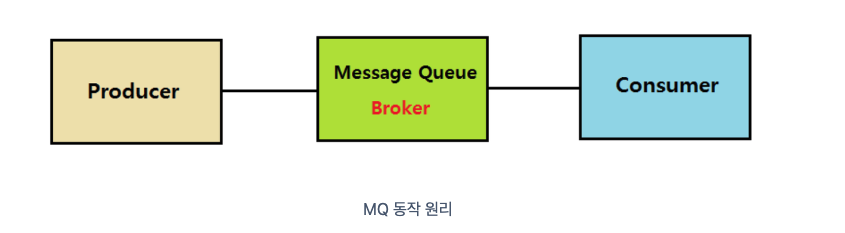
메시지 큐를 사용하면 producer(발행자)와 Consumer(수신자)가 서로를 직접 알지 못해도 데이터를 송수신 할 수 있는데
이는 발행자와 수신자 사이에 Broker(중개자) 역할을 하는 메시지 큐가 이를 중개하고 있기 때문이다.
메시지 큐는 발행자에게서 온 메시지를 Queue에 담아두었다가 수신자에게 제공하는 방식으로 동작하는데
이 덕에 End-to-End 방식에 비해 여러 장점들을 갖고 있다.
- 수신자의 서비스에서 장애가 발생하더라도 발행자에게서 받은 메시지는 이미 메시지 큐에 저장된 상태이기 때문에 수신자가 메시지를 받을 수 있는 상태가 되면 메시지 전달을 보장할 수 있다.
- 발행자와 수신자의 결합도를 낮추고 독립적인 구조를 만들어 주어 확장성을 높인다.
- 메시지 큐라는 중개자가 있기 때문에 발행자와 수신자가 서로의 요청과 응답을 기다릴 필요 없이 큐에 담고 이를 가져오는 비동기적인 통신을 할 수 있다.
2-2) 메시지 큐의 종류
메시지 큐는 크게 Point-to-Point와 Publish/Subscribe(Pub/Sub) 모델로 구분된다.
- Point-to-Point : 하나의 발행자의 메시지가 하나의 수신자에 의해 소비되는 방식으로 1:1 메시지 전송 방식
- Publicsh/Subscribe : 발행자가 특정 Topic에 메시지를 Publish하면, 해당 Topic을 Subscribe 중인 여러 수신자가 해당 메시지를 받는 방식
Kafka는 이 중 Pub/Sub 모델에 해당한다.
3. Kafka 용어 정리

Kafka는 앞서 설명했 듯 메시지 큐 기반의 아키텍처이기 때문에 프로듀서, 브로커, 컨슈머 등의 개념은 동일하게 사용하고 있으며 그 외에도 Pub/Sub 모델에서 사용되는 토픽이나 파티션에 대한 개념도 들어가 있기 때문에 용어를 하나하나 정리해보며 전체적인 이해도를 높여보고자 한다.
1. Producer
- 데이터를 Kafka에 보내는 클라이언트 애플리케이션.
- 데이터를 특정 토픽에 게시(Publish).
- 메시지 전송 시 Batch 처리가 가능하다.
- key값을 지정하여 특정 파티션으로만 전송이 가능하다.
- 전송 acks값을 설정하여 효율성을 높일 수 있다.
- ACKS=0 -> 매우 빠르게 전송. 파티션 리더가 받았는 지 알 수 없다.
- ACKS=1 -> 파티션 리더가 받았는지 확인. 기본값
- ACKS=ALL -> 파티션 리더 뿐만 아니라 팔로워까지 메시지를 받았는 지 확인
2. Consumer
- Kafka에서 데이터를 읽는 클라이언트 애플리케이션.
- 특정 토픽을 구독(Subscribe)하여 데이터를 처리.
- 여러 컨슈머가 협력하여 파티션의 데이터를 병렬 처리 가능.
- 컨슈머 그룹(Consumer Group): 동일한 그룹 ID를 사용하는 컨슈머들의 집합.
- 한 파티션의 데이터는 한 번만 소비되며, 병렬 처리가 가능.
- 각 컨슈머가 다른 파티션의 데이터를 읽도록 분배.
3. Topic
- Kafka에서 데이터를 카테고리별로 구분하는 논리적 단위.
- 프로듀서가 데이터를 게시하고, 컨슈머가 데이터를 읽는 대상.
- 한 개의 토픽은 한 개 이상의 파티션으로 구성된다.
4. Partition
- 토픽 데이터를 분할하여 저장하는 물리적 단위.
- Kafka는 각 토픽을 여러 파티션으로 나누어 클러스터 내의 서로 다른 브로커에 분산 저장하고 처리.
- 각 파티션은 고유한 데이터 순서를 가짐.
- 데이터는 오프셋으로 순차적으로 저장.
5. Offset
- 컨슈머에서 메세지를 어디까지 읽었는지 저장하는 값
- 컨슈머 그룹의 컨슈머들은 각각의 파티션에 자신이 가져간 메시지의 위치 정보(offset) 을 기록
- 컨슈머 장애 발생 후 다시 살아나도, 전에 마지막으로 읽었던 위치에서부터 다시 읽어들일 수 있다.
6. Broker
- 실행된 각각의 Kafka 서버를 의미한다.
- 각 브로커는 토픽의 파티션을 저장하고, 데이터를 프로듀서와 컨슈머 사이에서 송수신한다.
- 클러스터에 여러 브로커가 있을수록 더 많은 데이터를 저장하고 처리할 수 있다.
7. Kafka Cluster
- 브로커들의 모임으로 Kafka 확장성, 내구성, 고가용성을 위해 클러스터 구조를 사용한다.
8. Zookeeper
- Kafka 클러스터를 관리하기 위한 분산 코디네이터 시스템.
- 클러스터의 메타데이터를 관리하고, 브로커 간의 상태를 추적.
- Kafka 3.0 이후로는 Kafka Raft (KRaft)로 대체되었음.
왜 하나의 토픽을 여러개의 파티션으로 분산시킬까?
이렇게 하나의 토픽에 대하여 여러 파티션을 구성하는 가장 큰 이유는 분산 처리를 통한 성능 향상에 있다.
카프카는 하나의 토픽에 대해 여러 프로듀서가 발행할 수 있고, 여러 컨슈머가 구독할 수 있는 형태를 갖고 있다.
그렇기 때문에 토픽을 하나의 파티션으로 구성하면, 무수한 발행-구독 요청을 하나의 파티션이 처리해야 한다.
물론 카프카는 하나의 파티션만으로도 충분한 성능을 발휘할 수 있지만,
일반적으로 2개 이상의 파티션을 서로 다른 브로커에 병렬 구성하여 요청의 부하를 분산시켜 준다.
이에 따라 자연스럽게 해당 토픽에 관한 성능도 향상시킬 수 있습니다.
다만, 한번 늘린 파티션은 절대 줄일 수 없기 때문에 운영 중에 파티션을 늘려야 하는건 충분히 검토 후 실행되어야 한다.
이외에도 파티션의 가장 큰 특징은 하나의 파티션 내에서는 메시지 순서가 보장되는 것이다.
즉, 파티션은 메시지 순서 보장의 단위로써, 각 파티션의 메시지는 발행되는 순서대로 구독할 수 있다.
따라서 하나의 토픽이 여러 파티션으로 구성되는 경우,
하나의 파티션 내에서는 메세지 순서가 보장되지만, 파티션이 여러개일 경우에는 순서가 보장되지 않는다.
이는 파티션을 늘렸을 때 메시지가 Round-Robin 방식으로 저장되기 때문이다.
4. Kafka와 Rabbit MQ의 차이
이전 포스트 중 Spring Cloud Bus를 사용하기 위해 Rabbit MQ를 사용해본 경험이 있다.
그래서 Rabbit MQ와 Kafka는 어떤 차이점이 있고 어떤 경우에 사용할 수 있는지 알아보고자 한다.
1. kafka는 pub/sub 방식 / RabbitMQ는 메시지 브로커 방식
kafka의 pub/sub방식은 생산자 중심적인 설계로 구성. 생성자가 원하는 각 메시지를 게시할 수 있도록 하는 메시지 배포 패턴으로 진행
RabbitMQ의 메시지브로커방식은 브로커 중심적인 설계로 구성. 지정된 수신인에게 메시지를 확인, 라우팅, 저장 및 배달하는 역할을 수행하며 보장되는 메시지 전달에 초점
2. 전달된 메시지에 대한 휘발성
RabbitMQ는 queue에 저장되어 있던 메시지에 대해 Event Consumer가져가게 되면 queue에서 해당 메시지를 삭제한다.
하지만, kafka는 생성자로부터 메시지가 들어오면 해당 메시지를 topic으로 분류하고 이를 event streamer에 저장한다. 그 후, 수신인이 특정 topic에 대한 메시지를 가져가더라도 event streamer는 해당 topic을 계속 유지하기 때문에 특정 상황이 발생하더라도 재생이 가능하다.
3. 용도의 차이
kafka는 클러스터를 통해 병렬처리가 주요 차별점인 만큼 방대한 양의 데이터를 처리할 때, 장점이 부각된다.
RabbitMQ는 데이터 처리보단 Manage UI를 제공하는 만큼 관리적인 측면이나, 다양한 기능 구현을 위한 서비스를 구축할 때, 장점이 부각된다.
