개요
본 절에서는 선택도. 밀도, 카디널리티 용어 개념과 히스토그램이 필요한 이유를 다룬다.
옵티마이저는 데이터 딕셔너리에 저장된 통계 정보를 기반으로 실행계획을 수립한다. 이때 꼭 알아둬야 하는 개념은 선택도와 밀도, 카디널리티 개념이다.
나아가 옵티마이저는 NDV에 대해서 균일한 로우수를 가지고 있다고 가정한다. 예로 들어서 EMP 테이블에 DEPTNO 컬럼의 NDV = 3 (부서가 유니크하게 3개만 있는 상황) , 총 로우수 = 30인 상황이면 옵티마이저는 각각의 부서마다 데이터가 10개씩 있다고 판단한다.
하지만 아래와 같은 데이터의 비대칭이 있는 경우가 있다.
A 부서: 1명
B 부서: 9명
C 부서: 20명
이럴 때는 히스토그램의 통계자료를 새롭게 생성해주는 것이 유리하다.
1. 용어 개념: 선택도, 밀도, 카디널리티
1) 선택도: 일반적으로 1 / NDV 로 계산하지만, predicate(조건식)이 늘어나면 값이 달라진다
아래와 같이 deptno 의 NDV 가 3이고, gender 의 NDV 가 2인 경우에는 선택도 = 1/3 * 1/2 로 계산한다
select * from emp1
where deptno = 30 -- deptno NDV = 3
and gender = 'M'; -- gender NDV = 2
2) 밀도: 1 / NDV
3) 카디널리티: 총로우수 * 선택도 로 계산된다
아래의 케이스에서는 30 * 1/3 = 10 이 카디널리티가 되겠다
-- 총 로우수가 30 이라고 가정
select * from emp1
where deptno = 30; -- deptno NDV = 3

4) NDV 보는법

```sql
/*
옵티마이저 통계는 DBMS_STATS 패키지 또는 ANALYZE 명령문을 통해 수집 가능하며 수집된 통계 정보는
여러 DICTIONARY VIEW를 통해 내용을 확인할 수 있다.

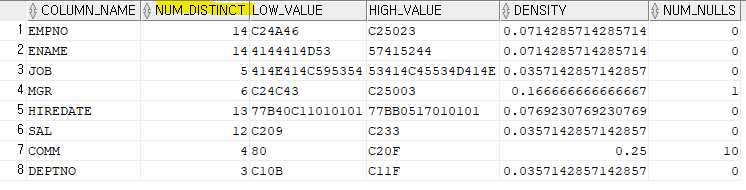
아래의 EMP 테이블의 SAL 컬럼의 고유값(NDV)는 12 이고, DEPTNO 컬럼의 고유값은 3이다
*/
SELECT COLUMN_NAME, NUM_DISTINCT, LOW_VALUE, HIGH_VALUE, DENSITY, NUM_NULLS
FROM USER_TAB_COLUMNS
WHERE TABLE_NAME = 'EMP'
ORDER BY COLUMN_ID
;
### 2. 히스토그램

아래와 같이 비대칭이 심한 테이블이 있다.

```sql
SELECT channel_id, COUNT(*)
FROM SALES
GROUP BY ROLLUP(channel_id)
;

-- 결과
channel_id COUNT(*)
2	       258025
3	       540328
4	       118416
9	       2074 * 비대칭이 심함
total      918843

-- 히스토그램 생성 x 시
BEGIN
DBMS_STATS.GATHER_TABLE_STATS(ownname => USER
                              , tabname => 'SALES'
                              , method_opt => 'for columns channel_id size 1' -- BUCKET 1개 = 히스토리 X
                              , no_invalidate => FALSE);
END;
/
channel_id = 9 일때 카디널리티가 2074임에도 불구하고, 히스토그램을 생성하지 않았을 때, 균등하게 분배한 918843 * 1/4 = 229711 개가 예상 실행 계획으로 잡히고 full table scan 을 선택했음을 알 수 있다.
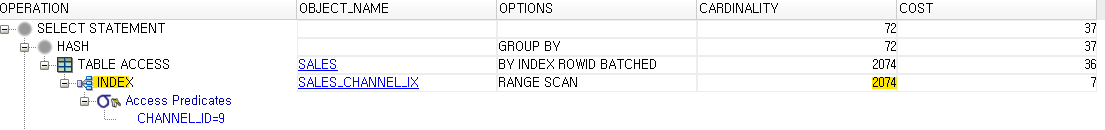
히스토그램을 4개로 다시 생성해보자
BEGIN
DBMS_STATS.GATHER_TABLE_STATS(ownname => USER
                            , tabname => 'SALES'
                            , method_opt => 'for columns channel_id size 4'
                            , no_invalidate => FALSE);
END;
/
카디널리티가 정상적으로 잡히고 옵티마이저가 index range scan 을 선택한 것을 볼 수 있다!