소주제
- 2주차 학습 개요와 기술 스택: 비선형 자료구조와 상태 공간 탐색(BFS/DFS)
- 내가 직면했던 현실과 한계: 단일 문제와 싸운 3일간의 집념과 머리를 쥐어짜는 고통
- 핵심 기술 개념과 코드 분석: 큐(Queue) 기반 BFS vs 스택/재귀 기반 DFS의 상태 공간 분할
- 원형 큐(Circular Queue)의 모듈러 인덱스 연산과 트리 순회 3방식
- 협업과 소통의 성찰: 비효율적 삽질과 가설 기반 문제 분해의 차이
- 실행 가능한 액션 플랜: 30분 타임박싱(Time-boxing)과 공유 회의 프로토콜
- 2주차 핵심 엔지니어링 Q&A 3선
1. 2주차 학습 개요와 기술 스택: 비선형 자료구조와 상태 공간 탐색(BFS/DFS)
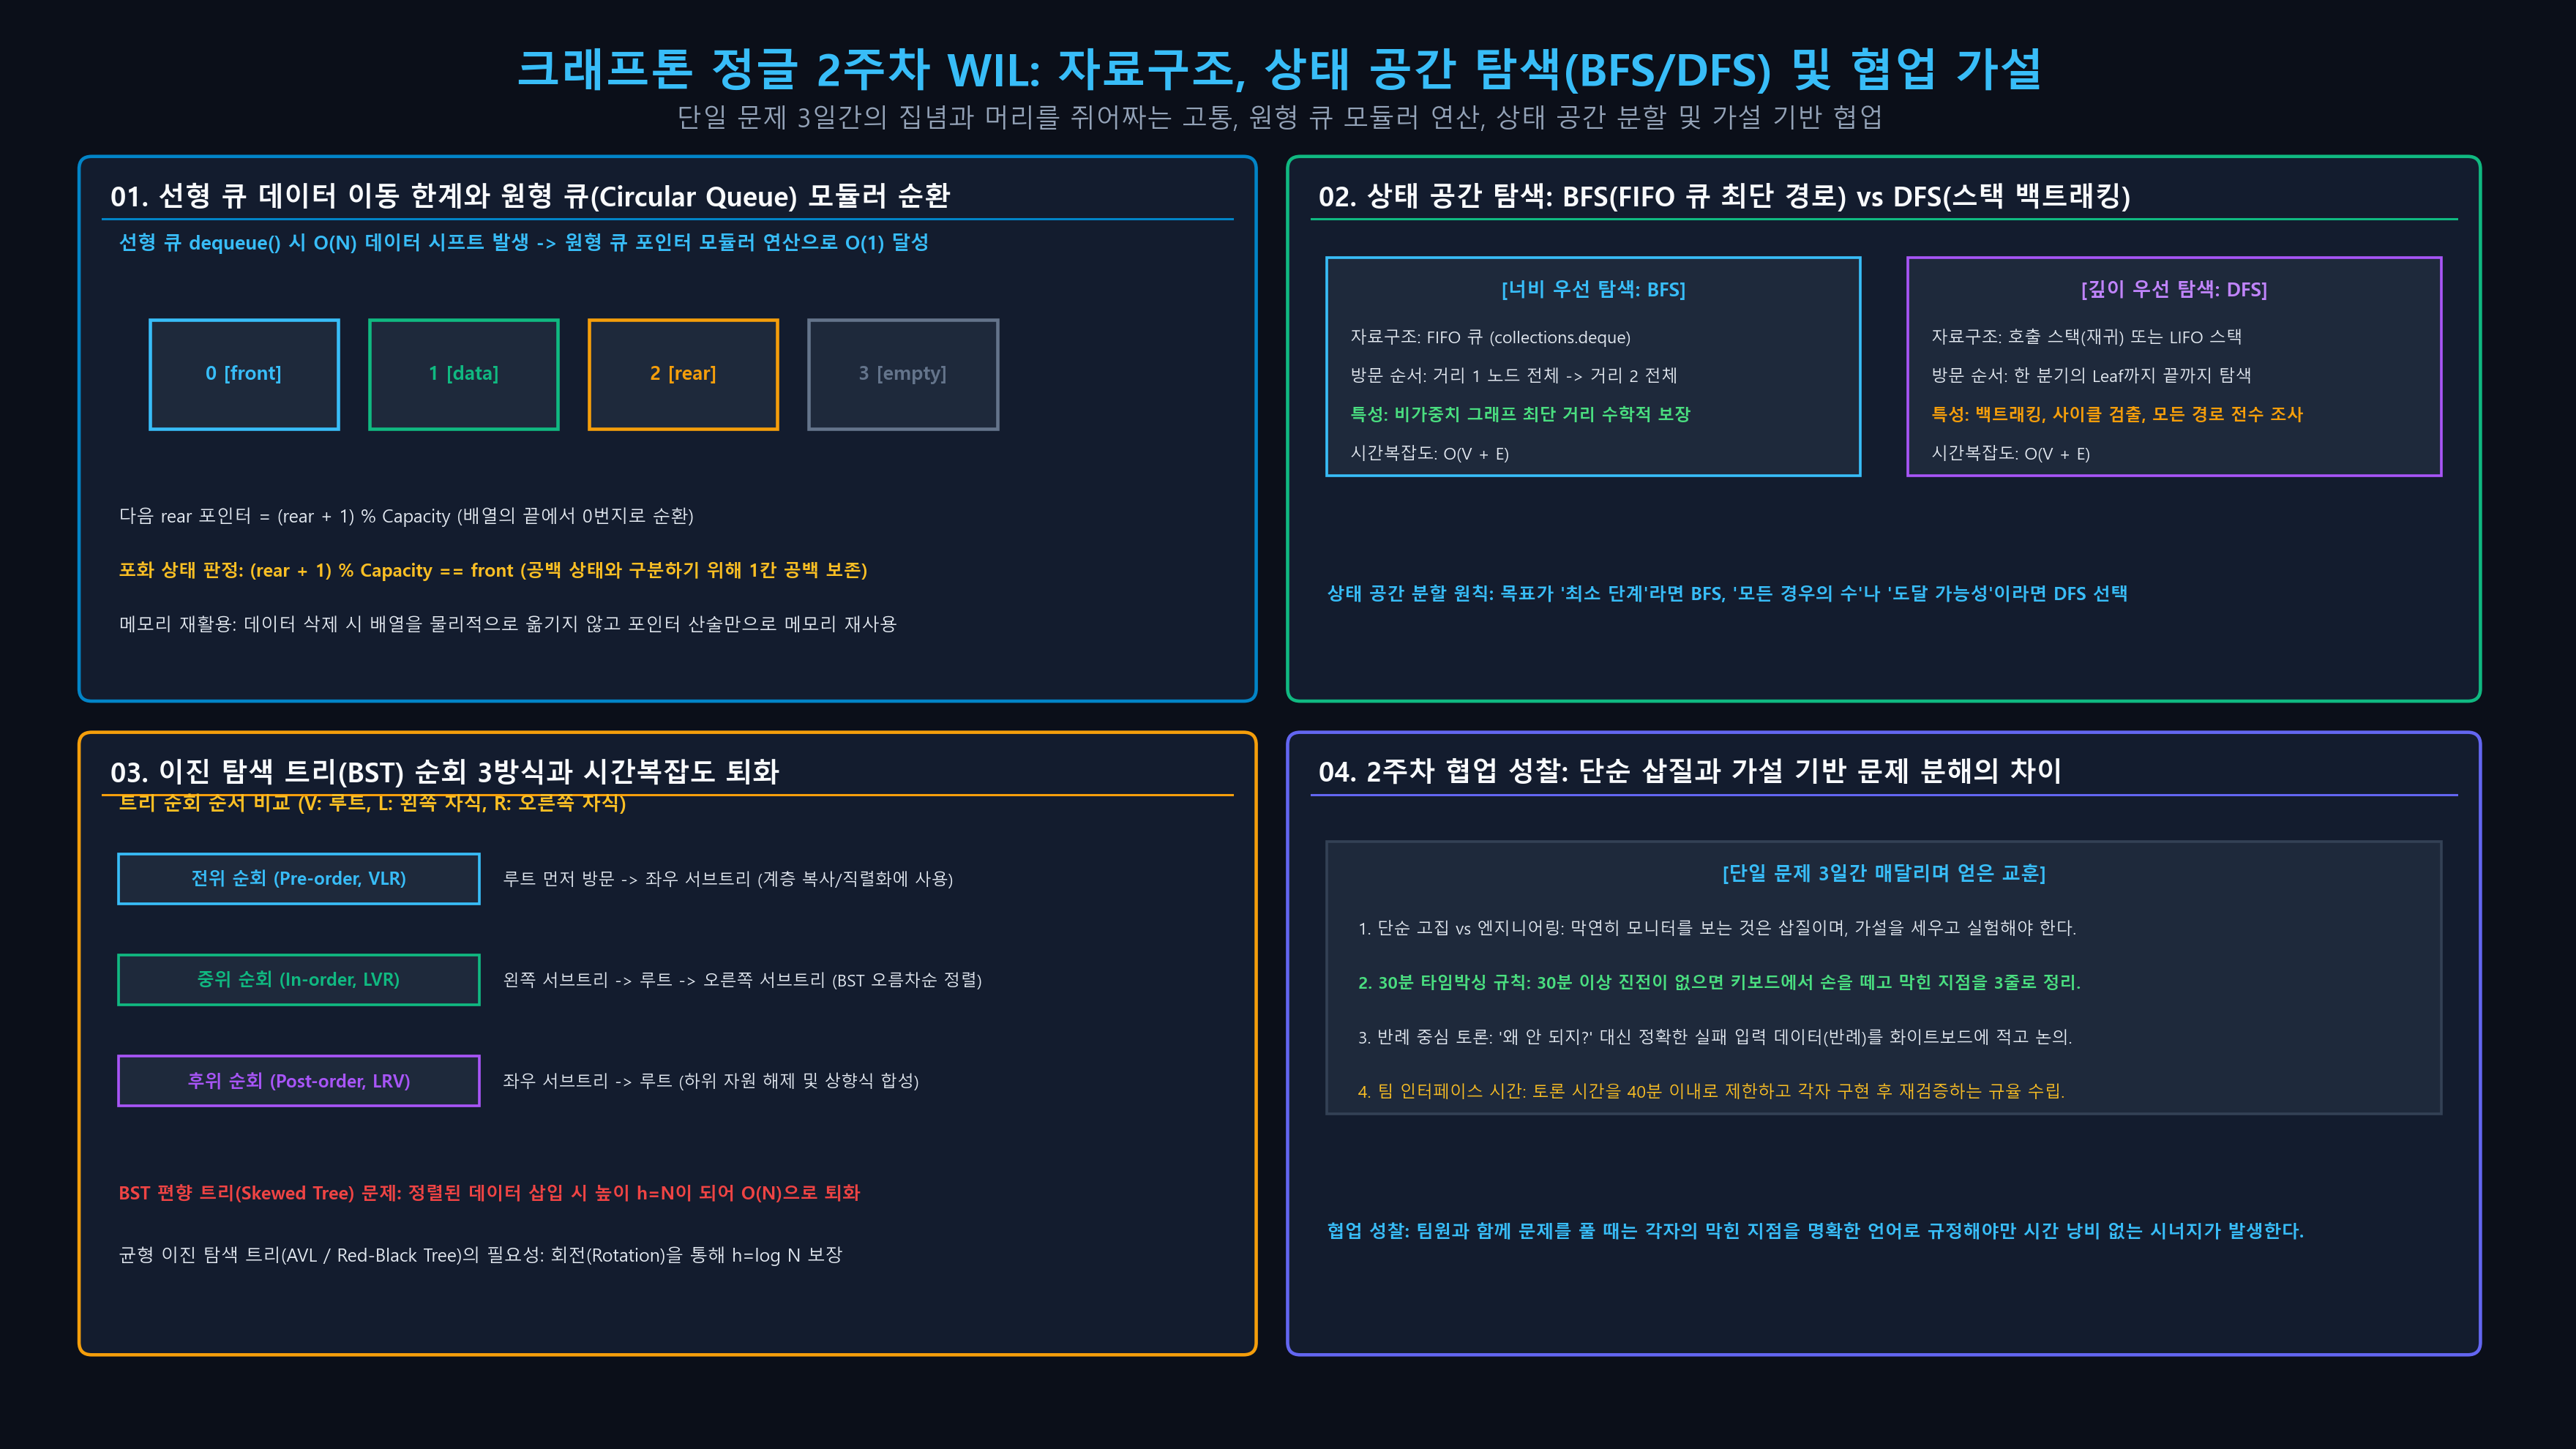
2주차는 스택(Stack), 큐(Queue), 트리(Tree), 이진 탐색 트리(BST)와 같은 선형 및 비선형 자료구조를 깊이 탐구하고, 이를 바탕으로 그래프와 상태 공간을 탐색하는 BFS(너비 우선 탐색) 및 DFS(깊이 우선 탐색)의 메커니즘을 훈련하는 주차였습니다. 단순한 1차원 데이터 배열을 넘어 분기하는 관계와 경로를 제어하는 법을 배웠습니다.
[자료구조 기반 상태 공간 탐색 분기 흐름]

탐색 시작 노드 (Root)
        │
        ├─ [너비 우선 탐색: BFS] ──► FIFO 큐(Queue) 활용
        │    └─ 현재 깊이의 모든 노드를 먼저 방문 (최단 경로 보장)
        │
        └─ [깊이 우선 탐색: DFS] ──► LIFO 스택(Stack) / 재귀 호출 활용
             └─ 특정 분기의 끝(Leaf)까지 파고든 후 백트래킹 (경로 탐색)
2. 내가 직면했던 현실과 한계: 단일 문제와 싸운 3일간의 집념과 머리를 쥐어짜는 고통
"이때는 거의 하나의 문제를 3일간 팠다, 첫 협업의 느낌이었지만 엄청 많이 가져가진 않았다, 머리를 짜내는 느낌이 처음 든 주차"
정답 접근법이 명확히 떠오르지 않는 고난도 알고리즘 문제 하나를 마주하고, 장장 3일 동안 그 한 문제에만 매달렸습니다. 태어나서 처음으로 뇌의 한계까지 생각을 쥐어짜는 듯한 지적 압박감을 경험했습니다. 자고 일어나는 순간에도 머릿속에 그래프 노드와 예외 케이스가 맴돌았습니다.
팀원들과 화이트보드 앞에 서서 처음으로 본격적인 협업 토론과 페어 프로그래밍을 시도했습니다. 하지만 당시에는 협업의 룰과 소통 방식이 다듬어지지 않았던 탓에, 장시간의 회의에 비해 실제로 도출된 엔지니어링 산출물이나 학습의 흡수율은 높지 못했습니다. 치열하게 부딪혔지만 문제 해결의 체계가 부족하여 소모적인 피로감이 컸던 한 주였습니다.
3. 핵심 기술 개념과 코드 분석: 큐(Queue) 기반 BFS vs 스택/재귀 기반 DFS의 상태 공간 분할
3.1 최단 경로 탐색에서의 BFS 알고리즘
너비 우선 탐색은 시작점에서 인접한 정점들을 거리 순서대로 방문하므로, 간선의 가중치가 동일한 비가중치 그래프에서 목표 노드에 도달하는 즉시 최단 거리를 확정할 수 있습니다.
from collections import deque

def bfs_shortest_path(graph, start, target):
    visited = {start: 0} # 노드: 거리
    queue = deque([start])

    while queue:
        curr = queue.popleft()
        if curr == target:
            return visited[curr]

        for neighbor in graph.get(curr, []):
            if neighbor not in visited:
                visited[neighbor] = visited[curr] + 1
                queue.append(neighbor)
return -1- FIFO 큐의 역할: 먼저 큐에 들어온 정점들이 먼저 처리되므로, 거리 인 모든 정점을 방문하기 전에는 거리 인 정점이 먼저 방문되지 않음을 엄밀히 보장합니다.
4. 원형 큐(Circular Queue)의 모듈러 인덱스 연산과 트리 순회 3방식
4.1 선형 큐의 데이터 이동 오버헤드와 원형 큐의 해결
선형 배열 큐에서 dequeue를 수행할 때마다 모든 데이터를 한 칸씩 앞으로 당기면 의 시간 복잡도가 소요됩니다. 원형 큐는 시작 인덱스(front)와 끝 인덱스(rear)를 모듈러(% capacity) 연산으로 회전시켜 모든 큐 연산을 로 유지합니다.
[원형 큐(Circular Queue)의 인덱스 모듈러 순환 구조]

배열 크기: 4 (Capacity = 4)
인덱스: [ 0 ]   [ 1 ]   [ 2 ]   [ 3 ]
        front           rear
다음 rear 위치 = (rear + 1) % 4
4.2 트리 노드 순회 3방식(전위, 중위, 후위)의 호출 스택 차이
- 전위 순회(Pre-order, VLR): 부모 노드를 먼저 방문한 후 좌우 서브트리를 탐색하여 트리의 복사본을 생성하거나 계층 구조를 직렬화할 때 사용.
- 중위 순회(In-order, LVR): 이진 탐색 트리(BST)에서 키 값을 오름차순으로 정렬된 순서로 출력할 때 사용.
- 후위 순회(Post-order, LRV): 하위 노드의 자원이나 메모리를 먼저 해제한 뒤 부모 노드를 삭제하는 상향식(Bottom-up) 트래버설에 사용.
5. 협업과 소통의 성찰: 비효율적 삽질과 가설 기반 문제 분해의 차이
한 문제에 3일간 매달리며 배운 가장 뼈아픈 교훈은, "단순히 오랜 시간을 앉아 있는 '삽질'과 명확한 가설을 세우고 실험하는 '엔지니어링'은 완전히 다르다"는 사실이었습니다.
당시 우리는 문제가 풀리지 않을 때 "왜 안 되지?"라는 막연한 물음표만 던진 채 화이트보드를 멍하니 바라보며 시간을 허비했습니다. 그러나 진정한 협업은 다음과 같은 단계로 진행되어야 했습니다.
1. "입력 데이터셋의 범위가 어디까지인가?"
2. "현재 알고리즘의 최악 시간복잡도는 왜 초과되는가?"
3. "이 알고리즘이 실패하는 최소 반례(Counter Example)는 무엇인가?"
문제를 세부 요소로 쪼개고 각자의 역할을 명확히 나누지 않은 상태에서의 토론은 오히려 피로도만 가중시킵니다. 팀원과 머리를 맞댈 때는 반드시 '정리된 가설'을 기반으로 대화해야 한다는 것을 깨달았습니다.
6. 실행 가능한 액션 플랜: 30분 타임박싱(Time-boxing)과 공유 회의 프로토콜
- 30분 타임박싱 규칙 도입: 혼자 고민해서 30분 동안 유의미한 코드 진전이나 가설이 세워지지 않으면 즉시 키보드에서 손을 떼고 막힌 지점을 3줄로 요약하기.
- 반례 중심 토론: 팀원에게 질문하거나 논의할 때 감정적인 막막함을 토로하는 대신, "현재 이 로직이 입력에서 을 반환해야 하는데 를 반환하고 있다"와 같이 정확한 반례 데이터를 제시하기.
- 토론 시간 상한제: 하나의 주제에 대한 전체 팀 토론은 최대 40분을 넘기지 않으며, 결론이 나지 않을 경우 각자 가설을 코드로 검증한 뒤 1시간 뒤 다시 모이기.
7. 2주차 핵심 엔지니어링 Q&A 3선
Q1. 비가중치 그래프에서 최단 거리를 구할 때 DFS가 아닌 BFS를 사용해야만 하는 수학적 이유는?
답변: BFS는 시작 노드로부터 거리가 인 모든 노드를 큐에 넣어 먼저 방문하고, 그 다음 거리가 인 노드들을 방문하는 레벨별(Level-order) 탐색을 보장합니다. 따라서 목표 노드를 처음 만나는 순간의 간선 수가 반드시 최단 거리임이 수학적으로 증명됩니다. 반면 DFS는 한 분기 방향으로 가능한 한 깊이 끝까지 파고들기 때문에, 목표 노드를 발견하더라도 그것이 최단 경로인지 알 수 없으며 전체 경로를 전수 조사하기 전까지는 최단 거리를 확정할 수 없습니다.
Q2. 원형 큐에서 포화(Full) 상태와 공백(Empty) 상태를 물리적으로 구분하기 위해 한 칸을 비워두는 이유는?
답변: 원형 큐에서 front == rear 조건은 큐가 완전히 비어 있을 때 성립합니다. 만약 배열의 모든 공간을 꽉 채우도록 허용하면, 큐가 완전히 찼을 때도 front == rear가 되어 공백 상태와 포화 상태를 인덱스만으로 구분할 수 없게 됩니다. 따라서 통상 1칸의 가용 공간을 의도적으로 비워두어 (rear + 1) % capacity == front일 때를 포화 상태로 정의함으로써 상태의 모호성을 물리적으로 해결합니다.
Q3. 이진 탐색 트리(BST)가 편향(Skewed) 트리로 전락할 때 시간복잡도가 악화되는 메커니즘은?
답변: 균형 잡힌 BST에서는 매 분기마다 탐색 대상이 절반으로 줄어들어 트리의 높이가 이 되며 시간복잡도 을 달성합니다. 하지만 이미 정렬된 데이터가 순차적으로 삽입되면 트리가 한쪽 방향으로만 신장하는 편향 트리(Skewed Tree)가 형성됩니다. 이 경우 트리의 높이가 노드 개수와 동일한 이 되어 연결 리스트와 동일한 구조로 전락하며, 모든 탐색과 삽입의 시간복잡도가 으로 퇴화합니다.