소주제
- 5주차 학습 개요와 기술 스택: Malloc Lab과 동적 메모리 할당기의 힙 메모리 모델
- 내가 직면했던 현실과 한계: 고통과 규율의 스터디, 그리고 코드 흐름을 따라가는 혹독한 훈련
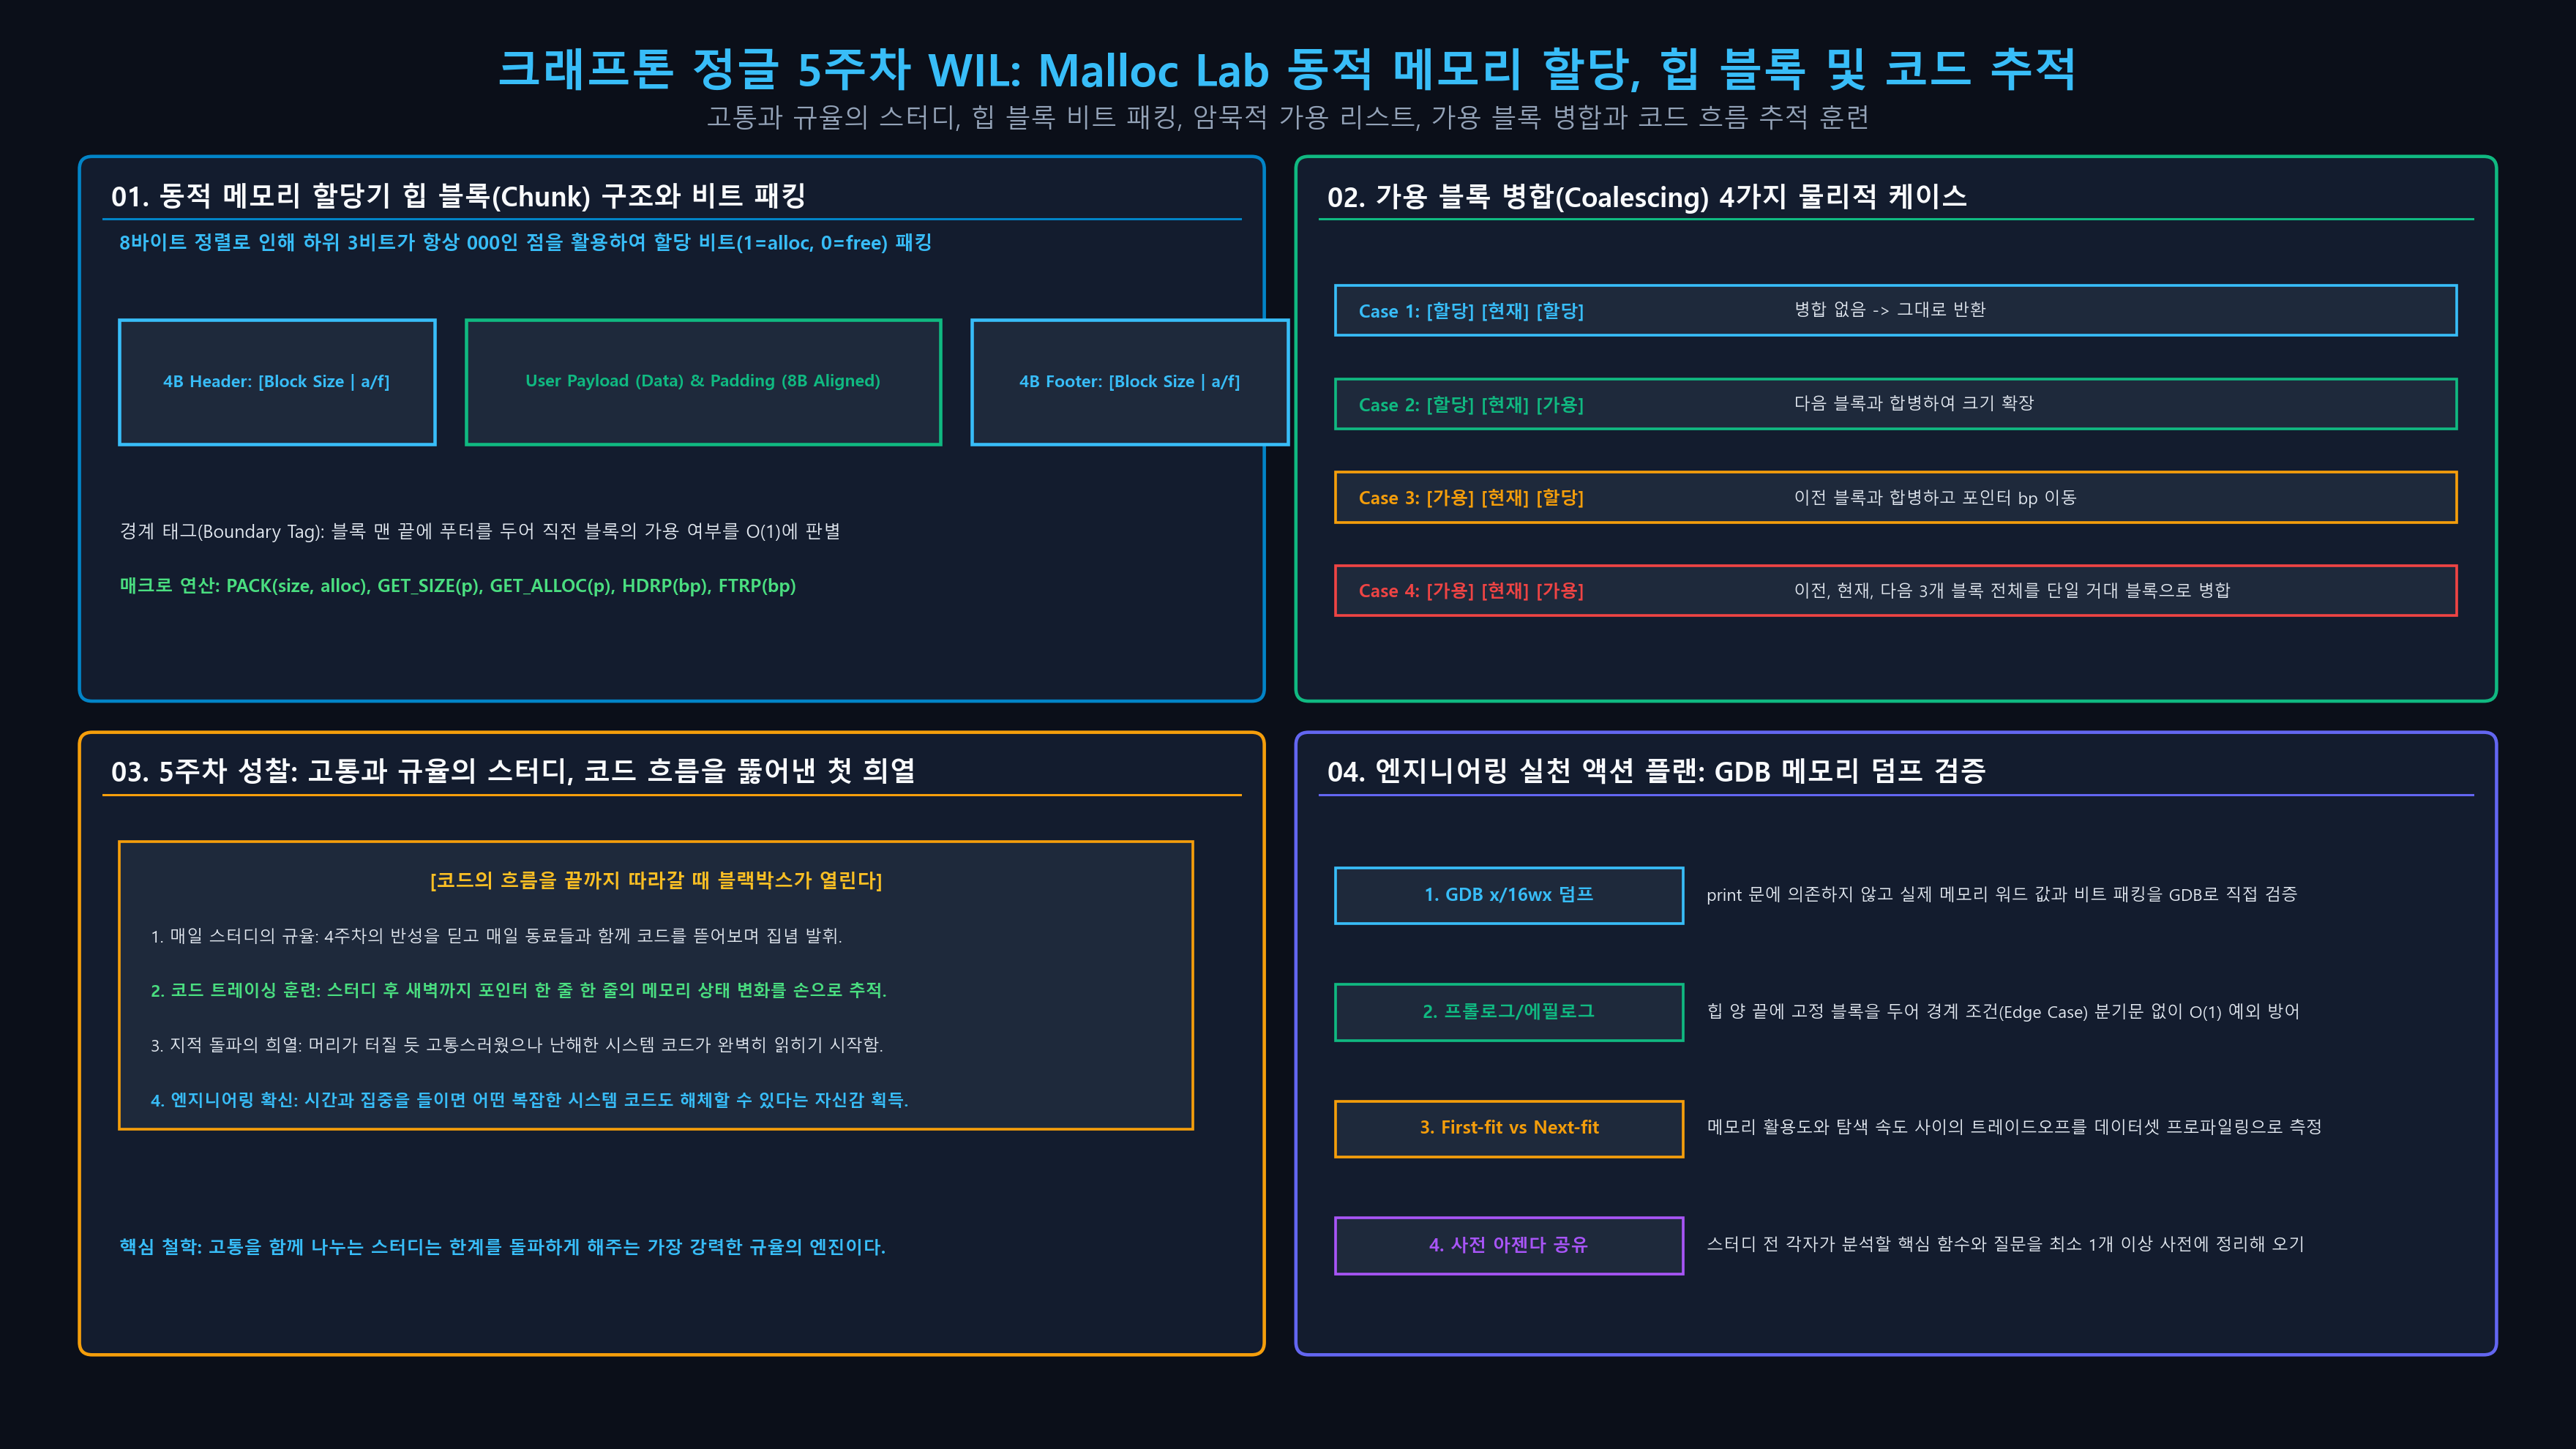
- 핵심 기술 개념과 코드 분석: 힙 청크 헤더/푸터 비트 패킹과 암묵적 가용 리스트(Implicit Free List)
- 가용 블록 병합(Coalescing 4가지 케이스)과 분할(Placement) 알고리즘
- 협업과 소통의 성찰: 고통을 함께 나누는 스터디와 코드 추적이 주는 확신
- 실행 가능한 액션 플랜: GDB 디버깅 기반 메모리 덤프 검증 프로토콜
- 5주차 핵심 엔지니어링 Q&A 3선
1. 5주차 학습 개요와 기술 스택: Malloc Lab과 동적 메모리 할당기의 힙 메모리 모델
5주차는 표준 C 라이브러리의 malloc(), free(), realloc() 함수를 커널의 sbrk() 시스템 콜 위에서 직접 C 언어로 구현하는 Malloc Lab(동적 메모리 할당기 구현) 프로젝트를 수행한 주차였습니다. 힙(Heap) 세그먼트의 연속된 바이트 메모리를 8바이트 정렬(Alignment) 규약에 맞추어 관리하고, 단편화(Fragmentation)를 억제하는 메모리 관리자(Memory Allocator)의 핵심 원리를 파헤쳤습니다.
[동적 메모리 할당기 힙 블록(Chunk) 구조]

+--------------------+------------------------------------------+--------------------+
| 4바이트 헤더(Header)| 실제 사용자 페이로드 (Payload Data)        | 4바이트 푸터(Footer)|
| [블록크기 | a/f]   | (malloc 요청 크기 이상, 8바이트 정렬 보장) | [블록크기 | a/f]   |
+--------------------+------------------------------------------+--------------------+
 ◄── 1바이트 주소 연산 (GET, PUT, HDRP, FTRP 매크로 기반 제어) ─────────────────────►
2. 내가 직면했던 현실과 한계: 고통과 규율의 스터디, 그리고 코드 흐름을 따라가는 혹독한 훈련
"너무도 고통스러웠던 첫 한주: 매일 스터디, 스터디 종류후에는 코드의 흐름을 따라가는 훈련을 한 한주, 힘들었지만 뜻깊었습니다."
4주차의 뼈아픈 반성을 딛고 완전히 새로운 태도로 임하기로 결심했습니다. 스스로를 한계 상황으로 밀어붙이며 매일 동료들과 함께 스터디를 열어 CS:APP 교재와 코드를 분석했습니다.
스터디가 끝난 후에도 자리를 뜨지 않고, 새벽 늦게까지 남아 C 언어의 난해한 매크로 함수(PACK, GET_ALLOC, HDRP, FTRP)와 포인터 주소 캐스팅 코드를 한 줄씩 뜯어보았습니다. "이 줄이 실행되면 힙 포인터가 몇 바이트 이동하는가?", "인접 블록의 헤더 비트는 어떻게 바뀌는가?"를 머릿속으로 시뮬레이션하고 화이트보드에 그리느라 뇌에 쥐가 나는 고통을 겪었습니다. 그러나 도망치지 않고 코드의 실행 흐름을 끝까지 추적했을 때 비로소 블랙박스가 열리는 경험을 했고, 정글 입소 이래 가장 힘들었지만 가장 뜻깊은 지적 돌파를 이뤄냈습니다.
3. 핵심 기술 개념과 코드 분석: 힙 청크 헤더/푸터 비트 패킹과 암묵적 가용 리스트(Implicit Free List)
3.1 비트 패킹(Bit Packing)을 통한 메타데이터 최소화
모든 블록의 크기는 8바이트의 배수로 정렬되므로, 블록 크기를 나타내는 32비트 정수에서 하위 3비트는 항상 000입니다. 할당기는 이 낭비되는 하위 1비트를 활용하여 현재 블록이 할당 상태인지(1) 가용 상태인지(0)를 기록하는 비트 패킹(Bit Packing) 기술을 적용합니다.
/* 크기와 할당 비트를 결합하여 헤더/푸터 값 생성 */
#define PACK(size, alloc) ((size) | (alloc))

/* 특정 주소 p에서 4바이트 크기 읽기 및 할당 여부 판별 */
#define GET(p)          (*(unsigned int *)(p))
#define GET_SIZE(p)     (GET(p) & ~0x7)
#define GET_ALLOC(p) (GET(p) & 0x1)- 경계 태그(Boundary Tag) 푸터의 역할: 블록의 맨 끝에 헤더와 동일한 푸터를 배치함으로써, 현재 블록의 포인터만으로 직전 블록의 푸터 주소(
p - 4)를 에 찾아가 직전 블록의 할당 여부와 크기를 즉시 파악할 수 있습니다.
4. 가용 블록 병합(Coalescing 4가지 케이스)과 분할(Placement) 알고리즘
메모리가 해제(free)될 때 인접한 가용 블록들을 합치지 않으면 수많은 작은 블록으로 파편화되어 대형 메모리 할당 요구를 만족시키지 못하는 외부 단편화(External Fragmentation)가 발생합니다.
[coalesce() 함수의 4가지 물리적 메모리 병합 케이스]

Case 1: [할당 블록] [현재 해제 블록] [할당 블록] ──► 병합 없음
Case 2: [할당 블록] [현재 해제 블록] [가용 블록] ──► 다음 블록과 병합
Case 3: [가용 블록] [현재 해제 블록] [할당 블록] ──► 이전 블록과 병합
Case 4: [가용 블록] [현재 해제 블록] [가용 블록] ──► 이전, 현재, 다음 3개 블록 전체 병합!
static void *coalesce(void *bp) {
size_t prev_alloc = GET_ALLOC(FTRP(PREV_BLKP(bp)));
size_t next_alloc = GET_ALLOC(HDRP(NEXT_BLKP(bp)));
size_t size = GET_SIZE(HDRP(bp));
if (prev_alloc && next_alloc) { /* Case 1 */
return bp;
} else if (prev_alloc && !next_alloc) { /* Case 2 */
size += GET_SIZE(HDRP(NEXT_BLKP(bp)));
PUT(HDRP(bp), PACK(size, 0));
PUT(FTRP(bp), PACK(size, 0));
} else if (!prev_alloc && next_alloc) { /* Case 3 */
size += GET_SIZE(HDRP(PREV_BLKP(bp)));
PUT(FTRP(bp), PACK(size, 0));
PUT(HDRP(PREV_BLKP(bp)), PACK(size, 0));
bp = PREV_BLKP(bp);
} else { /* Case 4 */
size += GET_SIZE(HDRP(PREV_BLKP(bp))) + GET_SIZE(FTRP(NEXT_BLKP(bp)));
PUT(HDRP(PREV_BLKP(bp)), PACK(size, 0));
PUT(FTRP(NEXT_BLKP(bp)), PACK(size, 0));
bp = PREV_BLKP(bp);
}
return bp;
}5. 협업과 소통의 성찰: 고통을 함께 나누는 스터디와 코드 추적이 주는 확신
매일 열었던 스터디는 단순한 지식 공유 자리가 아니라, 서로의 나태함을 다잡고 한계를 돌파하게 해주는 '규율의 장치'였습니다. 혼자 공부했다면 포기했을 난해한 매크로 연산과 포인터 수식들을, 동료들과 칠판에 적고 반례를 찾아가며 끝까지 추적했기에 무너지지 않을 수 있었습니다.
"코드를 눈으로 대충 훑는 것"과 "메모리 주소와 비트 하나까지 손으로 따라가며 이해하는 것" 사이의 건널 수 없는 깊이를 체감했습니다. 코드의 흐름을 집요하게 따라가는 훈련을 통해, 어떤 복잡한 시스템 코드도 시간과 집중을 들이면 반드시 해체하고 이해할 수 있다는 엔지니어링적 확신을 얻었습니다.
6. 실행 가능한 액션 플랜: GDB 디버깅 기반 메모리 덤프 검증 프로토콜
- GDB x(Examine) 명령어 체화:
print문에 의존하지 않고 GDB 중단점을 설정한 뒤,x/16wx bp명령어로 힙 메모리의 실제 16진수 워드 값과 헤더 비트 패킹을 직접 검증하기. - 매크로 수식 전개 검증: 복잡한 포인터 매크로(
HDRP,FTRP)가 예상한 정확한 바이트 주소를 반환하는지 종이에 전개 수식을 쓰고 검산하는 습관 들이기. - 스터디 아젠다 사전 배포: 스터디 모임 전에 각자가 분석할 함수와 핵심 질문을 최소 1개 이상 사전에 정리해 와서 회의 밀도 극대화하기.
7. 5주차 핵심 엔지니어링 Q&A 3선
Q1. Malloc Lab에서 8바이트 주소 정렬(Alignment) 규약을 반드시 지켜야 하는 컴퓨터 아키텍처적 이유는?
답변: 현대 CPU(x86-64)의 메모리 버스는 통상 8바이트(64비트) 단위로 데이터를 한 번에 전송하도록 설계되어 있습니다. 데이터가 8바이트 경계에 맞추어져 있지 않고 경계에 걸쳐 배치되면(Misaligned), 8바이트 데이터를 읽기 위해 메모리 접근 버스 사이클을 2회 수행해야 하므로 성능이 급격히 저하됩니다. 또한 SSE/AVX와 같은 벡터 연산 명령어는 정렬되지 않은 메모리에 접근할 경우 CPU 하드웨어 수준에서 일반 보호 예외(#GP)를 터뜨려 프로세스를 강제 종료시킵니다.
Q2. First-fit 탐색 정책과 Next-fit 탐색 정책의 메모리 활용도 및 성능 트레이드오프는?
답변: First-fit은 힙의 처음부터 가용 블록을 탐색하므로 탐색 시작부에 작은 가용 조각들이 누적되어 힙 크기가 커질수록 탐색 지연 시간이 선형적으로 증가하지만, 대형 가용 블록이 힙의 뒷부분에 보존되어 메모리 활용도(Memory Utilization)가 높습니다. 반면 Next-fit은 직전에 할당했던 위치부터 탐색을 재개하므로 평균 탐색 속도는 빠르지만, 힙 전체를 균일하게 파편화시켜 대형 블록 확보가 어려워져 전체 메모리 활용도는 First-fit보다 떨어집니다.
Q3. 동적 메모리 할당기에서 프롤로그(Prologue)와 에필로그(Epilogue) 블록을 힙 양 끝에 두는 물리적 이유는?
답변: 힙의 시작점과 끝점에 각각 크기 8바이트의 프롤로그 할당 블록과 크기 0의 에필로그 헤더(할당 표시)를 영구적으로 배치함으로써, coalesce() 함수가 힙의 경계선(첫 블록 또는 마지막 블록)에서 인접 블록을 탐색할 때 힙 메모리 범위를 벗어나는 포인터 역참조 예외를 검사하는 특수 if 조건문 없이도 항상 "인접 블록이 이미 할당되어 있다"고 자연스럽게 판단하도록 만들어 경계 조건(Edge Case) 버그를 로 완벽히 방어합니다.