📅 Date : 2026.09.24
🏷️ Tags : #Python #AI #MachineLearning
🎯 이번 주 논문 소개
머신러닝을 쿼리 최적화에 적용하려는 기존 시도들은 과도한 학습 비용, 워크로드·데이터·스키마 변화에 적응하지 못하는 문제, 나쁜 tail 성능 때문에 실질적인 이득을 가져다주지 못했다. 이에 따라 해당 논문은 이런 문제를 해결하기 위해 Bao (Bandit optimizer) 를 제안한다.
Bao는 옵티마이저를 처음부터 새로 학습하지 않고, 기존 쿼리 옵티마이저에 쿼리별 최적화 힌트를 주는 방식으로 기존 옵티마이저에 이미 담긴 지식을 그대로 활용한다. Tree Convolutional Neural Network(TCNN)와 강화학습 알고리즘인 Thompson sampling 을 결합해서, 스스로 실수로부터 배우고 적응한다. 실험에서는 Bao가 오래 걸리는 쿼리가 섞인 여러 워크로드에서 tail latency를 포함한 end-to-end 실행 성능을 빠르게 개선하고, 클라우드 환경에서는 상용 시스템보다 비용은 낮추고 성능은 높일 수 있음을 보여준다.
📌 Contents
- 선행 연구
- 서론
- 주요 방법론
- 실험 결과
- 결론 및 한계점
- 인사이트 도출
1️⃣ 선행 연구
1. 학습 기반 카디널리티·비용 추정
- 쿼리 최적화의 핵심인 카디널리티 추정과 비용 모델링은 수십 년간 연구됐지만 여전히 어려운 문제이고, 여기에 ML을 적용한 연구가 많이 나왔다.
- 초기 사례인 LEO는 비슷한 쿼리를 반복 실행한 결과로 히스토그램 추정치를 보정했다. 이후 딥러닝 기반 지도학습, query-driven 방식, Monte Carlo 적분 기반 비지도 방식, containment rate를 이용한 CRN 등이 나왔다.
- 그러나 해당 연구들은 정확도는 높였지만, 그게 더 좋은 plan으로 이어진다는 근거는 보여주지 못했다는 문제를 제기한다. 더 나아가 평균 성능 개선을 보인 연구도 결국 tail latency는 평가하지 않았다는 한계를 지닌다.
2. 강화학습 기반 옵티마이저
- 강화학습으로 충분히 학습하면 PostgreSQL 기준 비용이 더 낮은 plan을 찾을 수 있다는 연구가 나왔고, 강화학습의 내부 상태가 카디널리티와 강하게 연관된다는 분석도 있었다.
- Neo는 심층 강화학습을 쿼리 latency에 직접 적용해서, 24시간 학습 후 상용 시스템과 경쟁할 수준에 도달했다.
- 하지만 이 기법들은 모두 스키마·데이터·워크로드 변화를 처리하지 못했고, tail 성능 개선도 보여주지 못했다. Adaptive query processing에 강화학습을 쓴 연구는 PostgreSQL 같은 기존 시스템에는 적용할 수 없다는 한계를 지닌다.
3. Thompson sampling
2️⃣ 서론
✨ 기존 학습 기반 옵티마이저가 "실용적이지 않은" 5가지 이유
기존 ML 기반 기법들이 인상적인 결과를 보여주긴 했지만, 저자들은 아직 실용적이지 않다고 주장한다.
- Long training time (긴 학습 시간)
- 쿼리 성능에 긍정적인 영향을 주기까지 과도하게 많은 학습 데이터가 필요하다.
- 지도학습 기반 카디널리티 추정기는 정확한 카디널리티를 수집해야 하는데, 이는 매우 비싼 작업이다.
- 강화학습 기법은 전통적 옵티마이저를 넘어서려면 수천 개의 쿼리를 처리해야 하고, 데이터 수집과 학습까지 포함하면 결국 거의 며칠이 걸리게 된다.
- Inability to adjust to data and workload changes (변화에 적응 불가)
- 지도학습 카디널리티 추정기는 데이터가 바뀌면 재학습해야 하고, 그렇지 않으면 stale해진다.
- 여러 강화학습 기법은 워크로드와 스키마가 고정되어 있다고 가정하고, 바뀌면 완전히 재학습해야 한다.
- Tail catastrophe (tail 성능 붕괴)
- 학습 기반 기법은 평균적으로는 전통적 옵티마이저보다 나을 수 있지만, tail에서는 100배에 가까운 성능 저하 같은 치명적인 실패가 자주 일어난다.
- Black-box decisions (블랙박스 의사결정)
- 딥러닝 기반 접근은 쿼리 최적화를 더 이해하기 어렵게 만들고, DBA가 학습된 컴포넌트의 plan 결정에 개입하거나 이해할 방법이 없다.
- Integration cost (통합 비용)
- 기존 학습 옵티마이저는 모두 연구용 프로토타입이라 실제 DBMS와의 통합이 거의 없고, 표준 SQL 기능 전체를 지원하는 것도 없다.
✨ 옵티마이저를 "대체"하지 말고 "조종"해야 한다
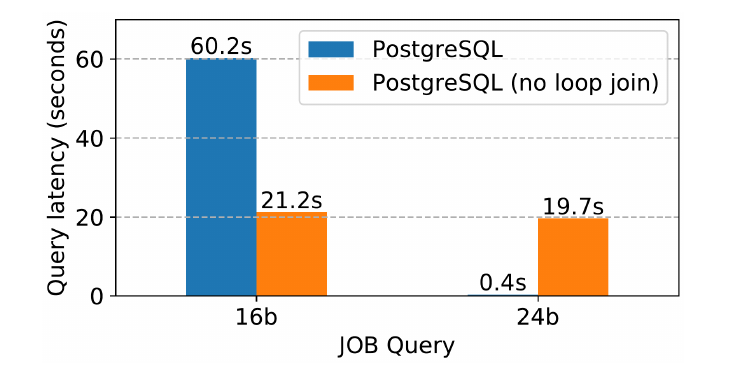
*Figure 1: PostgreSQL에서 loop join을 끄면 특정 쿼리 성능이 좋아질 수도(16b), 나빠질 수도(24b) 있음을 확인할 수 있다.
- Bao의 핵심은 옵티마이저를 처음부터 학습하지 않는 것이다. 기존 옵티마이저(예: PostgreSQL)를 그대로 쓰면서, 쿼리마다 어떤 기능을 켜고 끌지를 학습한다.
- 예를 들어 JOB의 16b 쿼리에서 PostgreSQL은 일부 조인의 카디널리티를 과소추정해서 loop join을 잘못 고르는데, loop join을 끄면 3배 빨라진다(60.2s → 21.2s). 그렇다고 loop join을 항상 끄면 안 된다. 24b 쿼리에서는 loop join을 끄면 약 50배 느려진다(0.4s → 19.7s).
- 결국 "쿼리마다 최적의 힌트가 다르다" 는 것이 Bao의 출발점이다.
✨ Query hint set과 Contextual Multi-Armed Bandit
- Bao는 들어온 쿼리를 옵티마이저가 써야 할 실행 전략에 매핑하는 방법을 학습해서 옵티마이저를 "교정"한다. 이 교정, 즉 활성화할 전략들의 부분집합을 query hint set이라고 부른다.
- hint set은 옵티마이저의 탐색 공간을 제한하고 조종하는 역할을 한다.
- 유한한 개수의 hint set을 contextual multi-armed bandit의 arm으로 보고, 쿼리가 오면 hint set 선택 → 실행 → 보상 관찰을 반복하면서 모델을 개선한다.
- 이 문제 설정 덕분에 sample efficient한 Thompson sampling을 쓸 수 있다. 또 기존 옵티마이저의 카디널리티 추정치를 그대로 활용하므로 새 데이터나 스키마 변화에도 기존 옵티마이저만큼 적응한다.
✨ Bao의 장점 6가지
| # | 장점 | 설명 |
|---|---|---|
| 1 | Short training time | 며칠씩 걸리는 다른 딥러닝 기법과 달리 약 1시간 학습으로 전통적 옵티마이저를 넘어선다. |
| 2 | Robustness | 옵티마이저의 비용·카디널리티 추정치를 활용하므로 스키마·데이터·워크로드 변화에도 성능이 유지된다. |
| 3 | Better tail latency | 30분~몇 시간 학습만으로 tail 성능을 개선한다. |
| 4 | Interpretability & debugging | 표준 도구(EXPLAIN)로 결정을 확인할 수 있고, 쿼리 단위로 켜고 끌 수 있다. |
| 5 | Low integration cost | 대부분의 DBMS가 이미 필요한 힌트·훅을 제공해서 코드 수정이 거의 필요 없다. 또한 기존 DB가 지원하는 모든 SQL 기능을 지원한다. |
| 6 | Extensibility | 재학습 없이 새 힌트를 추가할 수 있다. 캐시 상태 같은 정보를 feature에 추가하면 cache-aware 최적화도 가능하다. |
✨ 단점
- 최적화 시간 증가: 쿼리마다 옵티마이저를 여러 번 돌려야 한다. 오래 걸리는 쿼리에서는 문제가 안 되지만, 아주 짧은 쿼리가 많은 애플리케이션에서는 문제가 될 수 있다. 그래서 Bao는 tail-dominated 워크로드(예: 전체 처리 시간의 80%를 20%의 쿼리가 차지)에 가장 적합하다.
- 제한된 action space: 소수의 힌트만 쓰기 때문에 항상 최적의 plan을 찾지는 못한다. 그래도 실험에서는 전통적 옵티마이저를 크게 앞섰고, Neo 같은 "제약 없는" 학습 옵티마이저보다 훨씬 빠르게 학습·적응할 수 있다.
3️⃣ 주요 방법론
✨ 3-1. System Model
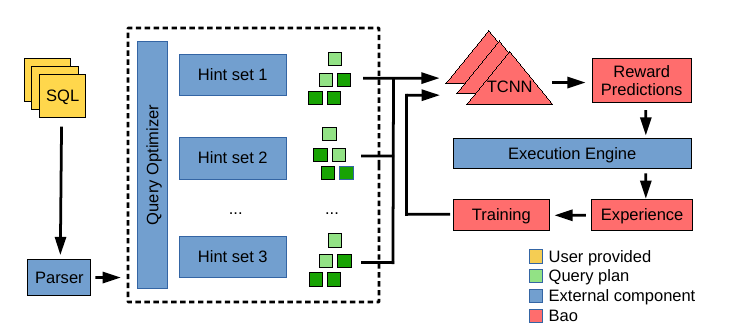
Figure 2: Bao 시스템 모델
Bao는 tree convolution 모델(쿼리 plan 트리의 중요한 패턴을 인식하는 신경망 연산자)과 Thompson sampling(contextual multi-armed bandit 해결 기법)을 결합한다. 전체 흐름은 다음과 같다.
- n개의 query plan 생성
- 사용자가 쿼리를 제출하면, 기존 옵티마이저가 hint set마다 하나씩, 총 n개의 plan을 만든다.
- Bao는 boolean flag 형태의 힌트(예: loop join 끄기, 인덱스 강제 사용)만 다룬다. hint set은 미리 정해두어야 하고, 빈 hint set(=원래 옵티마이저 그대로) 도 포함할 수 있다.
- 각 plan의 실행 시간 추정
- 각 plan을 vector tree(각 노드가 feature vector인 트리)로 바꾼 뒤, value model(TCNN) 에 넣어 plan의 품질(예: 실행 시간)을 예측한다.
- n개 plan의 생성과 평가는 병렬로 할 수 있어 최적화 시간을 줄인다.
- 실행할 plan 선택
- 예측이 가장 좋은 plan만 고르면, 모델이 틀려도 다른 전략을 시도하지 않으므로 틀렸다는 걸 영영 알 수 없다.
- 그래서 exploration과 exploitation의 균형을 위해 Thompson sampling을 쓴다. 특정 쿼리를 오프라인에서 탐색해 두고 실행 시에는 최선의 plan만 고르도록 보장하는 설정도 가능하다(4장).
- 실행 & 피드백 루프
- 선택된 plan을 실행하고, (plan, 관찰된 성능) 쌍을 experience에 추가한다. 이 experience로 주기적으로 모델을 재학습하는 피드백 루프가 만들어진다.
가정과 한계
- 모든 힌트가 의미적으로 동일한(semantically equivalent) plan을 만든다고 가정한다.
- 힌트는 항상 쿼리 plan 전체에 적용된다. 예를 들어 A–B 사이에서만 nested loop join을 막고 C–D 사이에서는 허용하는 식의 부분 적용은 할 수 없다.
- hint set 개수를 n, 쿼리의 릴레이션 개수를 k라고 하면:
- hint set 하나만 고르는 경우 → action space O(n)
- 부분 최적화까지 하는 경우 → O(n × 2^k) (완전 연결 쿼리 그래프 기준)
- action space 크기는 강화학습 수렴 시간을 좌우하는 중요한 요인이라서, 빠른 수렴을 위해 작은 action space를 택했다.
✨ 3-2. 문제 정식화: Regret 최소화
- hint set 계열 F에 속한 각 hint set 를, 쿼리 q를 plan tree t로 매핑하는 하나의 옵티마이저 함수처럼 본다.
- plan tree는 크기가 임의일 수 있지만, 연산자 종류는 미리 알려진 유한 집합이라고 가정한다.
- 사용자가 정의한 성능 지표 P(예: 실행 시간, 디스크 I/O 횟수)로 plan의 품질을 잰다.
- Bao의 hint set 선택 함수를 라고 하면, 쿼리 q에 대한 regret은 다음과 같다.
Contextual Multi-Armed Bandit (CMAB)
| CMAB 요소 | Bao에서의 의미 |
|---|---|
| Arm | hint set |
| Context | 각 hint set으로 옵티마이저가 만든 query plan들의 집합 |
| Payout (reward) | 선택한 plan을 실행해서 얻은 성능 |
- 에이전트는 무작위로만 고르면 안 되고(성능 개선에 도움이 안 됨), 처음 괜찮았던 plan만 계속 고집해서도 안 된다(개선 여지를 놓침). → exploration–exploitation 균형이 필요하다.
Thompson Sampling
- 과거 관찰(experience)을 쌓아 예측 모델 를 만들고, 이 모델로 예측 성능이 가장 좋은 hint set을 고른다.
- 선택된 plan을 실행해서 얻은 를 experience E에 추가하고, 그때마다 모델을 갱신한다.
- 일반적인 학습은 가장 그럴듯한 파라미터, 즉 를 찾지만, Thompson sampling은 에서 파라미터를 샘플링한다.
- 탐색을 최대화하려면 θ를 완전히 무작위로 고르고, 활용을 최대화하려면 최빈 θ를 고르면 된다. 분포에서 샘플링하는 것은 이 둘 사이의 균형이다.
- 엄밀히 말하면 hint set 선택은 순수한 bandit 문제가 아니다. 선택한 plan이 다음 쿼리의 캐시 상태에 영향을 주기 때문이다(예: index scan plan은 인덱스를 캐시에 올림). 하지만 OLAP 환경에서는 쿼리가 많은 데이터를 읽어서 단일 plan이 캐시에 주는 영향이 짧고, 이런 상황에서도 Thompson sampling이 적합하다는 실험적 근거가 많다.
✨ 3-3. 예측 모델
(1) Query plan tree 벡터화
Binarization (이진화)
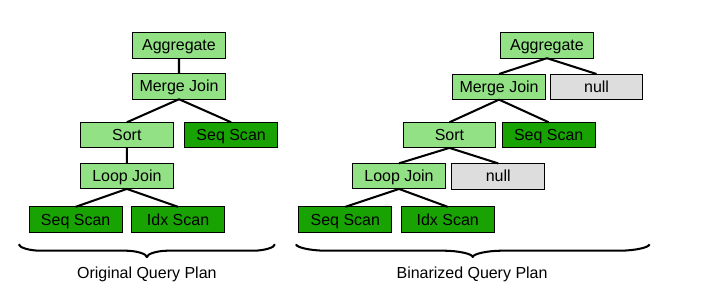
Figure 3: 쿼리 plan 트리의 이진화
- 집계, 정렬처럼 자식이 하나인 연산이 있는데, 모든 노드가 자식 0개 또는 2개인 이진 트리여야 tree convolution이 훨씬 단순해진다.
- 자식이 하나인 노드에는 오른쪽 자식으로 "null" 노드(회색) 를 넣는다.
- 자식이 셋 이상인 노드(예: multi-union)는 이진 연산의 left-deep 트리로 쪼갠다.
Vectorization (벡터화)
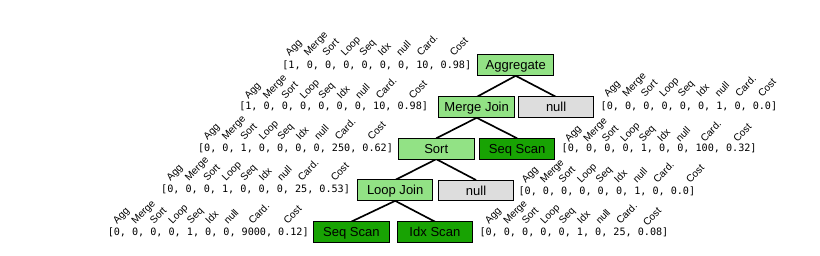
Figure 4: 벡터화된 query plan 트리(vector tree)
각 노드는 다음 정보를 담은 벡터로 바뀐다.
- 연산자의 one-hot 인코딩 (Agg, Merge, Sort, Loop, Seq, Idx, null)
- 예: 벡터의 두 번째 위치는 merge join인지를 나타낸다.
- 단순하지만 트리 구조의 특성을 담는다. 예를 들어 자식이 sort가 아닌 merge join은 여러 연산자가 정렬 순서를 활용하고 있다는 신호일 수 있다.
- 카디널리티·비용 정보 (그림의 "Card", "Cost")
- 거의 모든 옵티마이저가 이 정보를 쓰므로 가져오기 쉽다.
- 큰 릴레이션 위의 loop join, 반복되는 정렬처럼 문제가 될 만한 연산자를 표현하는 데 도움이 된다.
- 논문에서는 값 두 개(카디널리티 1개, 비용 1개)만 썼지만, 여러 추정기의 값이나 학습된 비용 모델의 예측값도 추가할 수 있다.
- (선택) 캐시 정보
- 새 쿼리가 올 때 buffer pool에서 캐시 상태를 가져온다. 실험에서는 각 scan 노드에 대상 파일이 캐시된 비율을 추가했다.
장점
- 스키마에 무관(schema-agnostic): 기존 연구는 테이블·컬럼을 벡터에 직접 넣었지만, Bao는 이를 빼서 스키마가 바뀌어도 처음부터 다시 시작할 필요가 없다.
- 데이터 변화 반영이 깔끔함: 데이터에 묶인 복잡한 임베딩 대신 카디널리티 추정치와 비용 모델로만 데이터를 표현한다. 데이터가 바뀔 때 카디널리티 추정치를 유지하는 방법은 이미 대부분의 DBMS에 구현되어 있다.
(2) Tree Convolutional Neural Network
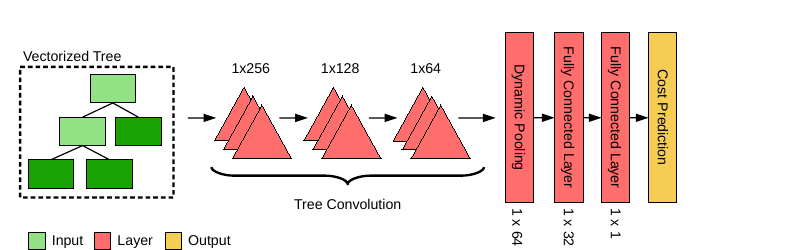
Figure 5: Bao 예측 모델 구조
- 전문가는 plan을 볼 때 패턴 매칭으로 좋고 나쁨을 판단한다.
- 중간 sort 없는 merge join 파이프라인 → 성능이 좋을 수 있음
- hash join 위의 merge join → 불필요한 sort/hash가 생길 수 있음
- 매우 큰 릴레이션에 hash table을 만드는 hash join → spill 발생 가능
- 이런 패턴 하나만으로 판단할 수는 없지만, 학습 관점에서 유용한 feature다. tree convolution은 이런 패턴을 데이터에서 자동으로 학습한다.
- 이미지 convolution처럼 트리 모양의 filter를 plan 트리 위로 sliding해서 같은 크기의 트리를 출력한다. 층을 쌓을수록 긴 merge join 체인, bushy한 hash 연산자 트리처럼 더 복잡한 패턴을 인식한다.
- 네트워크 구조 자체가 문제에 맞춰져 있다는 점에서 쿼리 최적화에 유용한 inductive bias를 가진다.
구조
Vectorized Tree
  → Tree Conv (1×256) → Tree Conv (1×128) → Tree Conv (1×64)
  → Dynamic Pooling (1×64)             # 트리를 벡터 하나로 평탄화
  → Fully Connected (1×32)
  → Fully Connected (1×1)
  → Cost Prediction
(ReLU 활성화, Layer Normalization 사용 — 그림에는 생략)
(3) Thompson sampling과의 결합
- Thompson sampling은 에서 θ를 샘플링해야 하는데, 대부분의 ML 기법은 를 찾도록 설계되어 있다.
- 신경망에서 이런 샘플링을 하는 방법은 복잡한 Bayesian NN부터 간단한 방법까지 다양하다. Bao는 가장 단순하면서 실제로 잘 작동하는 bootstrap 방식을 쓴다.
- → experience E에서 복원추출로 |E|개를 샘플링해 평소처럼 신경망을 학습하면 원하는 샘플링 성질을 얻을 수 있다.
✨ 3-4. Training loop
- 기본 흐름은 고전적인 Thompson sampling과 같다: 쿼리 수신 → hint set별 plan 생성 → 현재 모델로 plan 선택 → 실행 → experience에 추가 → 주기적으로 파라미터 재샘플링(재학습).
- 하지만 고전적 Thompson sampling처럼 쿼리마다 θ를 다시 샘플링하는 것은 비현실적이다.
- θ 샘플링 = 신경망 학습이라 시간이 오래 걸린다.
- |E|가 무한히 커지면 학습 시간도 무한히 늘어난다(epoch 시간이 학습 데이터 수에 비례).
- 그래서 두 가지 기법을 쓴다.
- n번째 쿼리마다만 재학습 → 학습 오버헤드가 1/n로 줄어든다.
- 가장 최근 k개의 experience만 저장 (sliding window)
- n과 k로 모델 품질과 학습 오버헤드 사이의 trade-off를 조절한다(6.2절에서 평가).
- 새로운 최적화: GPU 탈부착
- 클라우드에서는 GPU를 VM에 초 단위 과금으로 붙였다 뗄 수 있다.
- 학습은 주로 GPU를, 쿼리 처리는 CPU·디스크·RAM을 쓰므로 둘을 겹쳐서 진행할 수 있다.
- 재학습이 필요할 때 GPU를 잠시 붙여 학습하고, 끝나면 새 파라미터로 교체한 뒤 GPU를 뗀다. 전용 GPU 머신을 쓰거나 다른 머신으로 학습을 넘길 수도 있다.
✨ 3-5. PostgreSQL 통합
- PostgreSQL hooks 시스템(함수 포인터로 기능을 확장하는 방식)을 사용해서 재컴파일 없이 기존 인스턴스에 설치할 수 있다. 프로토타입은 공개되어 있다.
① Per-query activation (쿼리 단위 활성화)
SET enable_bao TO [on/off]세션 변수 하나로 켜고 끈다.- 필요한 이유:
- 짧은 쿼리에서는 Bao의 추가 최적화 시간(보통 약 200ms)이 쿼리 실행 시간보다 길 수 있다.
- DBA가 이미 힌트를 넣었거나 plan을 수동 튜닝한 쿼리는 Bao를 꺼서 그 노력을 지킬 수 있다.
- Bao가 꺼져 있어도 실행된 plan과 실행 시간을 experience에 추가해 학습은 계속할 수 있다(off-policy RL). 논문에서는 평가하지 않았지만, DBA의 수동 최적화 작업으로부터 배우는 방향으로 이어질 수 있다고 본다.
② Active mode vs. Advisor mode
| 모드 | 동작 |
|---|---|
| Active | 지금까지 설명한 대로 hint set을 자동 선택하고 성능으로부터 학습한다 |
| Advisor | hint set을 고르지 않고(모든 쿼리는 PostgreSQL planner가 최적화) 실행 성능만 관찰해서 모델을 학습한다 |
- Advisor 모드에서
EXPLAIN을 실행하면 다음 세 가지가 추가로 출력된다: (1) 생성된 plan의 예상 성능, (2) active 모드였다면 추천했을 hint set, (3) 그 hint set의 예상 개선폭.- 예시:
Bao prediction: 61722.655 ms,Bao recommended hint: SET enable_nestloop TO off; (estimated 43124.023ms improvement)
- 예시:
- 사람이 참여하는(human-in-the-loop) 방식으로 오래 걸리는 쿼리를 예측하고 고칠 수 있다.
③ Triggered exploration (쿼리 regression 방지)
- Bao는 새 plan을 적극적으로 탐색하므로 regression이 더 불규칙할 수 있다.
- DBA가 쿼리를 performance critical로 표시하면, Bao는 그 쿼리를 주기적으로 모든 hint set으로 실행해서 결과를 experience에 넣고 critical로 표시한다.
- 재학습할 때 새 모델이 critical experience의 가장 빠른 hint set을 제대로 고르지 못하면, 그 experience의 가중치를 높여 올바르게 고를 때까지 재학습한다.
- 👉 표시된 쿼리에 대해서는 regression이 생기는 plan을 절대 고르지 않도록 보장한다.
4️⃣ 실험 결과
핵심 질문: "워크로드·데이터·스키마 변화가 있는 실제 DB 워크로드에서 Bao가 실질적으로 도움이 되는가?" → 쿼리 성능뿐 아니라 클라우드에서 Bao 학습 오버헤드를 포함한 실제 비용($) 까지 측정했다.
✨ 실험 설정
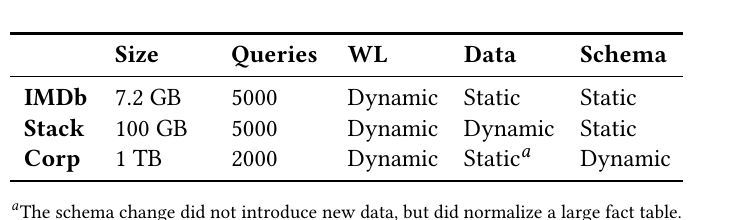
Table 1: 평가 데이터셋 크기, 쿼리 수, 워크로드(WL)·데이터·스키마의 정적/동적 여부
| 데이터셋 | 설명 |
|---|---|
| IMDb (7.2GB, 5000 쿼리) | Join Order Benchmark(JOB)를 확장했다. 원래 113개 쿼리에 수천 개를 추가했고, 주기적으로 새 템플릿을 넣어 워크로드를 변화시켰다 |
| Stack (100GB, 5000 쿼리) | 새로 만든 공개 데이터셋이다. StackExchange 10년치 질문·답변 1,800만 건 이상을 담고 있고, 한 달치씩 로드해 데이터 drift를 모사했다 |
| Corp (1TB, 2000 쿼리) | 익명 기업이 제공한 한 달간의 대시보드 워크로드다. 1000번째 쿼리 이후 큰 fact 테이블을 정규화해서 스키마 변화를 모사했다(데이터는 그대로) |
- Time series split: Bao는 항상 처음 보는 다음 쿼리 로 평가하고, 그 전 쿼리 데이터로만 학습한다. 결정 후에는 그 결정의 보상만 experience에 추가한다. 같은 쿼리의 다른 결정으로부터는 절대 배우지 않으므로 기존 평가 방식보다 보수적이다.
- 모델/학습: tree conv 3층 + dynamic pooling + linear 2층, ReLU, LayerNorm. Adam, batch size 16, 최대 100 epoch 또는 수렴(10 epoch 동안 학습 loss 감소 1% 미만)까지 학습한다.
- 환경: (C1) Google Cloud N1-4 VM + Tesla T4 GPU, (C2) 4코어·15GB RAM VM(Intel Xeon Gold 6230 서버, Tesla T4). 비용·시간에는 최적화 + 모델 학습(GPU 포함) + 실행이 모두 들어가고, 비용은 Google 청구 기준이다.
- 비교 대상: PostgreSQL, 상용 DB(ComSys). 둘 다 원래 옵티마이저에 힌트를 주는 방식으로 Bao를 통합했다.
- Hint set: 조인 연산자 {hash, merge, loop}와 스캔 연산자 {sequential, index, index only}의 부분집합으로 48개를 썼다. k = 2000, n = 100.
- 워크로드 특성: PostgreSQL 기준 median latency는 짧지만(280ms / 310ms / 520ms), 95th percentile은 21s / 28s / 3분으로 매우 치우쳐 있다. 세 워크로드 모두 실행 시간의 80%를 약 20%의 쿼리(18% / 23% / 21%)가 차지한다(Pareto 분포). → tail을 조금만 개선해도 전체 워크로드 성능이 크게 좋아질 수 있다.
✨ Is Bao practical?
warm cache 상황을 가정하고, 각 leaf 노드 벡터에 캐시 정보를 추가했다.
(1) 클라우드 비용과 성능
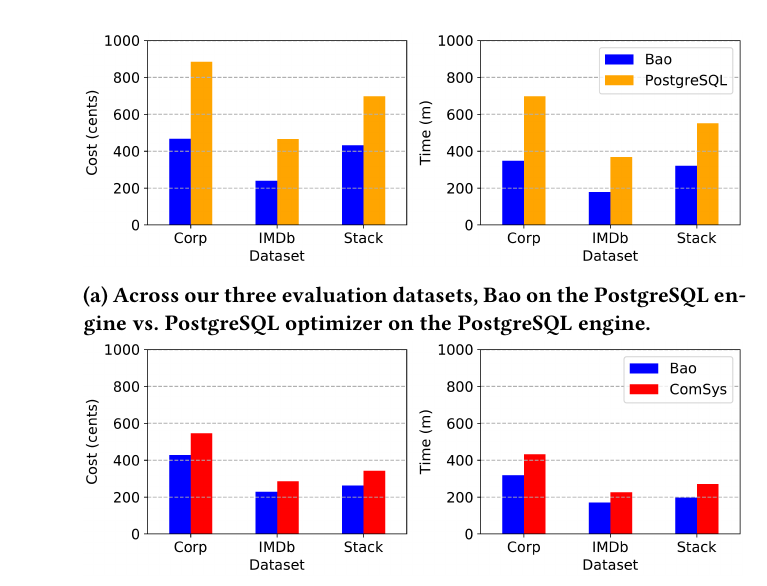
Figure 7: N1-16 Google Cloud VM에서 세 워크로드에 대한 Bao와 기존 옵티마이저의 비용(왼쪽)과 워크로드 latency(오른쪽). (a) PostgreSQL 엔진, (b) ComSys 엔진
- vs PostgreSQL: 데이터셋 전반에서 비용과 latency 모두 약 50% 개선됐다. 여기에는 학습 비용과 GPU 부착 비용까지 포함되어 있고, 모든 데이터셋에 워크로드·데이터·스키마 변화가 들어 있다.
- vs ComSys: 개선폭은 작지만 약 20% 개선됐다. ComSys 옵티마이저가 훨씬 강한 baseline이라는 뜻이다(상용 라이선스 비용은 미포함).
- 저자들은 수십 년간 개발된 상용 옵티마이저를 DB 코드 수정 없이 20% 개선한 것을 매우 고무적인 결과로 본다.
(2) 하드웨어 종류에 따른 결과
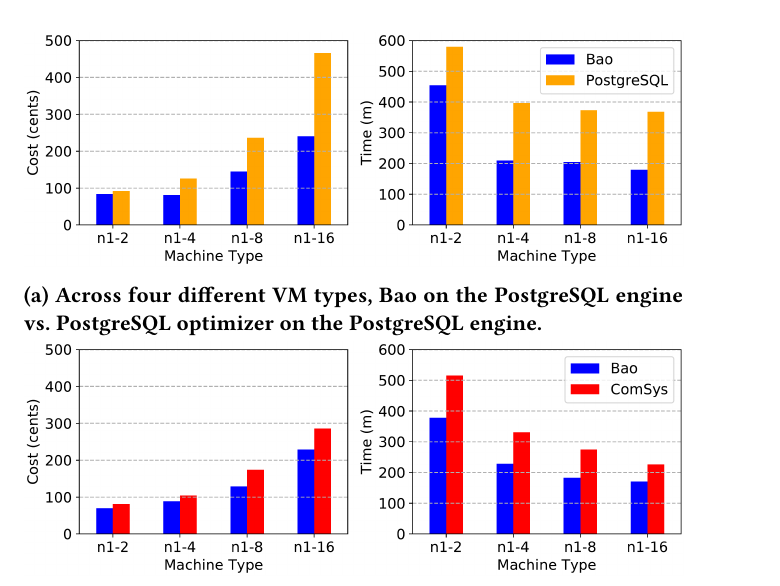
Figure 8: IMDb 워크로드에서 VM 크기 4가지(N1-2 ~ N1-16)에 따른 비용(왼쪽)과 latency(오른쪽)
- PostgreSQL: VM이 클수록(N1-16 vs N1-8) 차이가 커진다. → Bao가 PostgreSQL보다 하드웨어 변화에 더 잘 맞춰 튜닝됨을 시사한다(PostgreSQL도 하드웨어마다 재튜닝했다). Bao는 arm들을 병렬로 실행하므로 큰 머신에서 더 이득을 본다.
- ComSys: VM이 커져도 Bao의 이득이 커지지 않는다. → 상용 시스템이 하드웨어에 더 잘 적응하거나 기본값이 큰 머신에 맞춰져 있을 가능성이 있다. (N1-2는 ComSys 최소 요구사항은 충족하지만 권장 사양에는 못 미친다.)
(3) Tail latency 분석
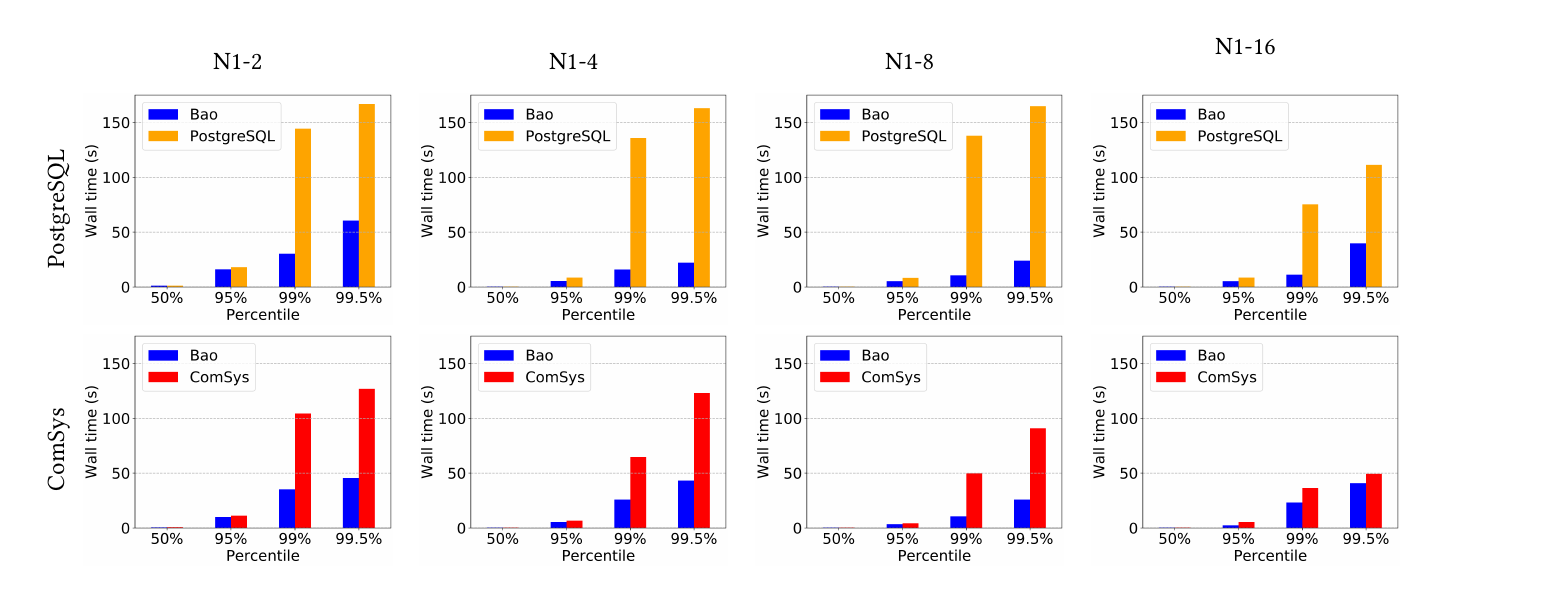
Figure 9: IMDb 워크로드의 percentile latency. 열은 VM 종류(작은 것 → 큰 것), 윗줄은 PostgreSQL, 아랫줄은 상용 시스템과 비교
- 모든 VM에서 Bao는 PostgreSQL 대비 tail latency를 크게 줄인다.
- 예: N1-8에서 99% latency가 130초 → 20초 미만
- 상용 시스템과 비교해도 항상 tail latency를 줄이지만, 자원이 부족한 작은 VM에서만 그 차이가 크다.
- 전체 성능 향상(Fig. 7)의 주된 원인은 tail latency 개선(Fig. 9)이다. 반면 median 쿼리는 거의 개선되지 않는다(< 5%).
- 최악의 경우 실험: 옵티마이저가 이미 거의 최적인 경우를 보기 위해 가장 빠른 20% 쿼리만 실행했더니, Bao 4.5분 vs PostgreSQL 4.2분으로 18초 regression이 생겼다(Bao의 오버헤드 때문).
(4) 학습 시간과 수렴
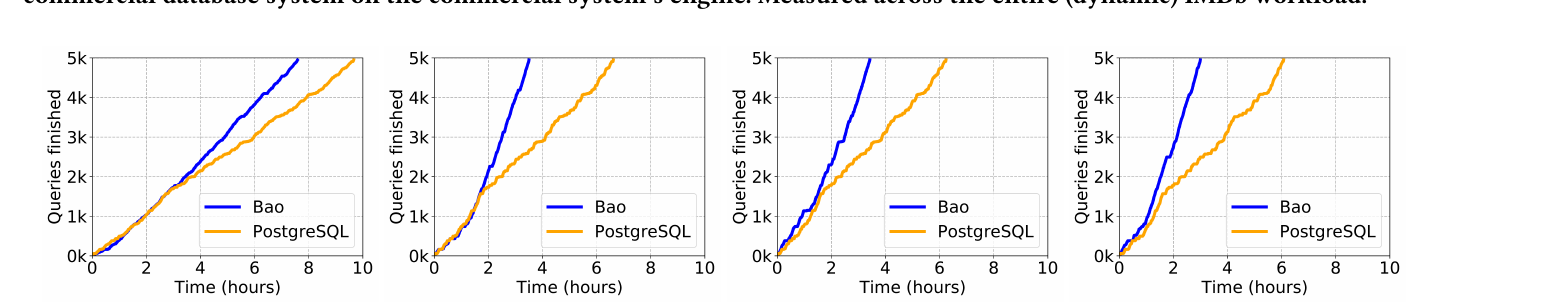
Figure 10: 시간에 따른 IMDb 처리 쿼리 수 (Bao vs PostgreSQL, VM: N1-2 / N1-4 / N1-8 / N1-16)
- 모든 VM에서 처음 약 2시간은 PostgreSQL과 비슷하다가 그 이후 앞서기 시작한다. Stack, Corp도 비슷하고, 상용 시스템 대비로는 약 3시간이 걸린다.
- IMDb 워크로드는 동적인데도, 초기 이후 Bao의 곡선은 직선을 유지한다. → 워크로드 변화가 성능에 큰 영향을 주지 않았다.
(5) 쿼리 regression 분석
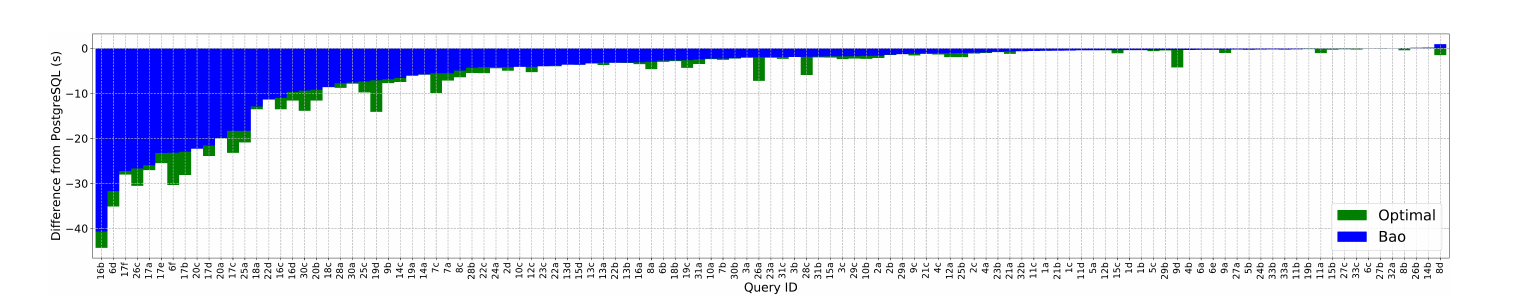
Figure 11: JOB 쿼리에서 Bao가 고른 plan과 PostgreSQL plan의 latency 차이 (낮을수록 좋음, 파랑: Bao, 초록: 이론적 최적)
- JOB 쿼리를 뺀 나머지 IMDb 워크로드로 학습한 뒤, 모델 업데이트 없이 JOB 쿼리를 실행했다(처음 보는 쿼리, predicate 겹침 없음).
- 113개 중 regression은 3개뿐이고, 모두 3초 미만이다.
- 10개 쿼리는 20초 이상 개선됐다.
- 다만 Bao(파랑)가 항상 최적 hint set(초록)을 고르지는 않는다.
(6) 쿼리 최적화 시간
- 최대 최적화 시간은 PostgreSQL 140ms, 상용 165ms, Bao 230ms다. 현재 프로토타입은 추론 코드가 Python이라 최적화 여지가 많다.
- 230ms는 arm들을 병렬로 planning해서 나온 값이다. 순차 planning이 필요하면 arm 수를 줄일 수 있다.
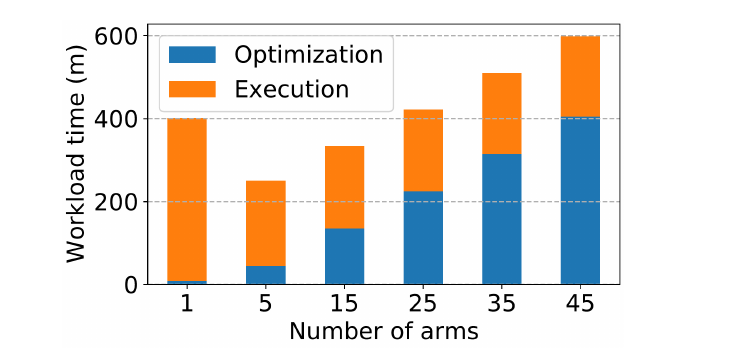
Figure 12: arm 수에 따른 최적화 시간과 실행 시간 (IMDb, N1-4, PostgreSQL, 순차 planning 가정). arm 1개 = PostgreSQL 옵티마이저
- arm이 늘면 최적화 시간(파랑)은 늘고 실행 시간(주황)은 줄어드는 trade-off가 있다.
- 5개 arm(6.3절에서 고른 것)만으로도 순차 planning에서 전체 워크로드 시간이 크게 줄어든다.
- 좋은 arm 부분집합을 미리 찾지 못하는데 순차 planning이 필요하면, arm 수를 적게 유지해야 하므로 확장성이 제한된다.
(7) 동시 실행 시 오버헤드
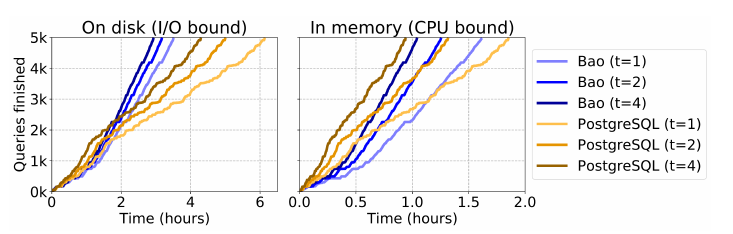
Figure 13: 동시성 수준 t에 따른 쿼리 완료 수 (IMDb, N1-4, PostgreSQL). 왼쪽: 데이터가 디스크(I/O bound), 오른쪽: 메모리(CPU bound)
- I/O bound (왼쪽): 쿼리 1개씩 실행하는 Bao가 4개를 동시에 실행하는 PostgreSQL보다 빨리 끝난다. 전체 CPU 부하가 60%를 넘지 않아 최적화에 쓸 CPU가 충분했기 때문이다.
- CPU bound (오른쪽): DB 전체를 메모리에 캐시하면 t=4에서 CPU 부하가 100%에 도달하고 context switching이 심해져, Bao의 최적화 연산 비용이 이득보다 커진다.
- 👉 I/O bound 워크로드에서는 오버헤드가 크지 않지만, CPU bound 환경에서는 주의해야 한다.
(8) 기존 학습 옵티마이저(Neo, DQ)와 비교
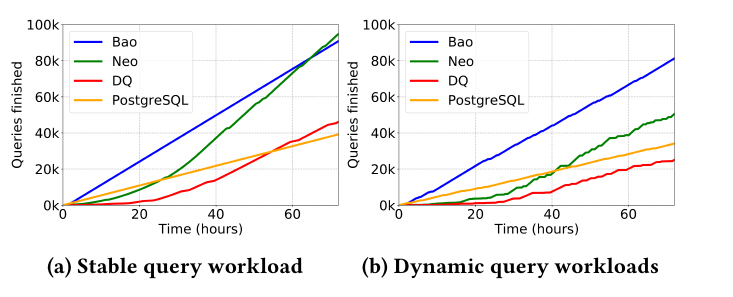
Figure 14: 시간에 따른 완료 쿼리 수. (a) 안정적 워크로드, (b) 동적 워크로드 (20회 평균, N1-16, 72시간 cutoff)
- Neo: Bao처럼 tree convolution을 쓰지만 hint set을 고르지 않고 실행 plan 전체를 직접 만든다.
- DQ: deep Q-learning + 직접 설계한 feature + fully-connected NN(FCNN)을 쓴다.
- 안정적 워크로드 (a): Neo는 24시간 후에 PostgreSQL을, 65시간 후에 Bao를 넘어선다. Neo는 어떤 쿼리에든 논리적으로 올바른 plan이면 무엇이든 쓸 수 있어 자유도가 훨씬 높지만, 그만큼 수렴이 느리다. 200시간 학습 후에는 Neo가 Bao보다 15% 더 좋은 성능을 냈다. DQ는 Neo와 자유도가 비슷하지만 PostgreSQL을 넘는 데 더 오래 걸리는데, FCNN의 inductive bias가 쿼리 최적화에 맞지 않기 때문일 수 있다.
- 동적 워크로드 (b): Neo와 DQ 모두 변하는 워크로드에 강건한 정책을 배우지 못해 수렴이 크게 늦어지고, 72시간 안에 Bao를 넘지 못했다.
✨ What hints make the biggest difference?
- 하나의 hint set으로 충분할까? 각 hint set을 IMDb 전체에 적용해 봤을 때 가장 좋은 것은 loop join 끄기였지만, 그래도 PostgreSQL 옵티마이저보다 훨씬 나빴다(Fig. 15a의 "Best hint set"). → 쿼리마다 다른 힌트가 필요하다.
- 어떤 hint set이 가장 중요할까? 48개 중 상위 5개가 PostgreSQL 대비 개선의 93% 를 차지한다.
| 순위 | Hint set | 개선 기여도 |
|---|---|---|
| 1 | nested loop join 끄기 | 35% |
| 2 | index scan & merge join 끄기 | 22% |
| 3 | nested loop join & merge join & index scan 끄기 | 16% |
| 4 | hash join 끄기 | 10% |
| 5 | merge join 끄기 | 10% |
- nested loop join 끄기 → 카디널리티 추정기가 조인 크기를 과소추정할 때 도움이 된다.
- hash join 끄기 → 조인 크기를 과대추정할 때 도움이 된다.
- hint set이 plan을 어떻게 바꿀까? (IMDb, PostgreSQL)
- 연산자 선택이 달라진 쿼리: 4271/5000 (나머지 729개는 PostgreSQL과 같은 plan)
- 접근 경로(인덱스)가 달라진 쿼리: 3792/5000
- 조인 순서가 달라진 쿼리: 2110/5000, 개선폭 상위 500개 중에서는 472개
- → 조인 순서가 연산자 구현보다 성능에 더 큰 영향을 준다는 기존 연구의 예상과 맞는 결과다.
✨ Bao's machine learning model
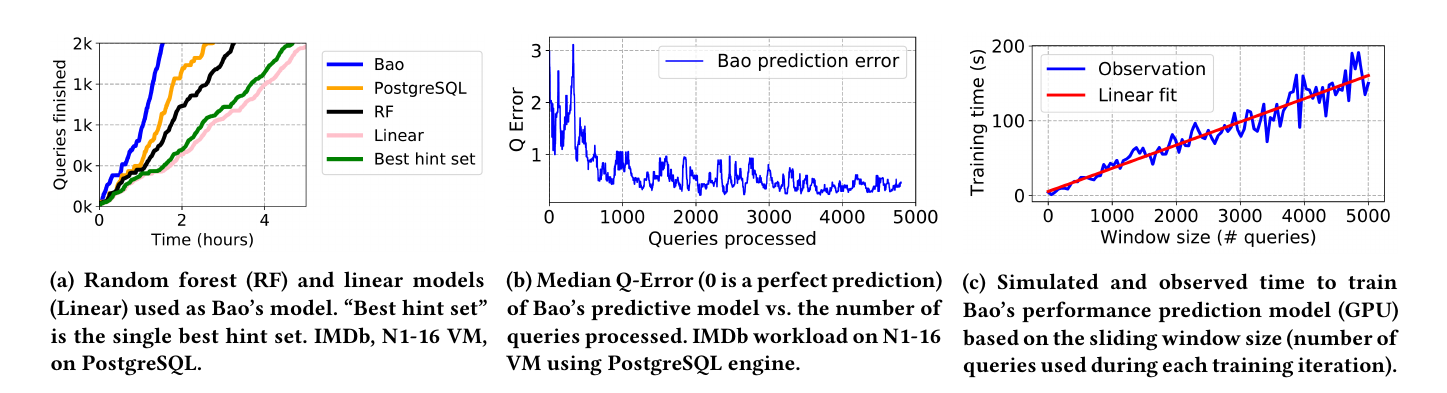
Figure 15: Bao 예측 모델 평가. (a) RF·선형 모델과 비교, (b) Median Q-Error, (c) window 크기에 따른 학습 시간
- 신경망이 꼭 필요할까? (a): value network를 Random Forest(grid search로 튜닝)와 Linear regression으로 바꿔 IMDb 처음 2000개 쿼리를 실행해 보니(C2, cold cache) 성능이 크게 떨어졌다. → tree convolution 모델이 필요하다.
- 모델은 얼마나 정확할까? (b): 처음에는 정확도가 낮아 Q-error가 최대 3까지 올라가지만, 부정확한 상태에서도 치명적인 plan은 고르지 않는다(Fig. 10d 참고). 쿼리를 처리할수록 오차가 줄어든다.
- GPU 시간은 얼마나 필요할까? (c): window 크기 k가 커질수록 학습 시간이 거의 선형으로 늘지만 모델은 좋아진다. 관찰 시간은 클라우드 환경과 Adam의 확률적 특성 때문에 편차가 크다. k = 5000(최댓값)이어도 약 3분이면 학습이 끝난다. k = 2000이 잘 작동했지만, 실제로는 필요와 예산에 맞게 조정해야 한다(전용 GPU가 있으면 window를 제한할 이유가 없을 수도 있다).
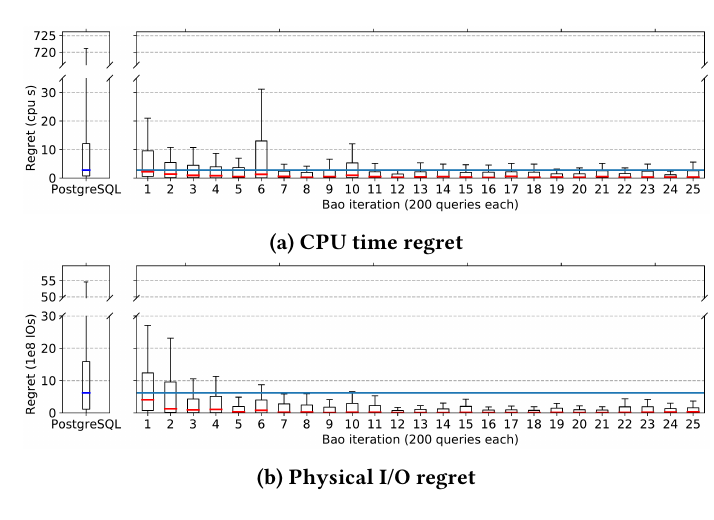
Figure 16: Regret(최적 hint set과 선택한 hint set의 차이), 반복당 쿼리 50개로 25회 학습. (a) CPU 시간 regret, (b) 물리적 I/O regret. 파란 선은 PostgreSQL의 median regret, whisker는 98 percentile
- 시간에 따른 regret과 tail: 최적 hint set은 cold cache에서 모든 plan을 다 실행해서 구했다. 두 지표 모두에서 Bao는 학습 후 첫 반복부터 PostgreSQL보다 나은 tail regret을 보인다(빠른 수렴). 6번째 반복의 outlier도 PostgreSQL보다 훨씬 낮다.
- 최적화 목표 커스터마이즈: CPU 시간을 줄이도록 학습하면 CPU regret이, 디스크 I/O를 줄이도록 학습하면 I/O regret이 낮아진다. → 복잡한 multi-tenant 자원 관리가 필요한 클라우드 제공자에게 유용할 수 있다.
5️⃣ 결론 및 한계점
✨ 결론
- Bao는 강화학습으로 기존 쿼리 옵티마이저를 조종(steer) 하는 bandit 옵티마이저다.
- 약 1시간 학습으로 오픈소스와 상용 옵티마이저의 성능을 따라잡을 수 있다.
- 워크로드·데이터·스키마가 변하는 상황에서도 median latency와 tail latency를 모두 줄일 수 있음을 보였다.
- 정리하면, Bao는 기존 학습 옵티마이저의 5가지 문제에 다음과 같이 답한다.
| 기존 문제 | Bao의 해결 방식 |
|---|---|
| 긴 학습 시간 | 기존 옵티마이저 위에서 작은 action space(hint set)만 학습 → 약 1~3시간 안에 수렴 |
| 변화 적응 불가 | 스키마 무관한 벡터화 + 옵티마이저의 카디널리티·비용 추정치 활용 |
| Tail catastrophe | Thompson sampling 기반 탐색 + TCNN → tail latency 대폭 감소, regression은 작음 |
| 블랙박스 | EXPLAIN으로 확인, advisor mode, 쿼리 단위 on/off |
| 통합 비용 | PostgreSQL hooks로 재컴파일 없이 설치, 기존 DB의 모든 SQL 기능 지원 |
✨ 한계점 및 후속 연구
한계점
- 최적화 시간 증가: 쿼리마다 옵티마이저를 hint set 수만큼 돌려야 한다(최대 230ms, 보통 약 200ms 추가). 짧은 쿼리가 많은 워크로드에는 불리하다.
- median 쿼리 개선이 거의 없음: 이득은 대부분 tail에서 나온다(median 개선 < 5%). 옵티마이저가 이미 거의 최적인 빠른 쿼리 20%만 실행하면 오히려 18초 regression이 생긴다.
- 제한된 action space:
- 힌트를 plan 전체에만 적용할 수 있고, 부분 plan에는 적용할 수 없다.
- 그래서 항상 최적 plan을 찾지는 못한다. 안정적 워크로드에서 오래 학습하면(200시간) Neo가 Bao보다 15% 더 좋다.
- Bao가 항상 최적 hint set을 고르지도 않는다(Fig. 11).
- CPU bound 환경: CPU가 포화되면 병렬 planning 오버헤드가 이득보다 커진다.
- 병렬성 의존: 230ms는 arm을 병렬로 planning해서 나온 값이고, 순차 planning이 필요하면 arm 수를 줄여야 해서 확장성이 제한된다.
- 순수 bandit 가정과의 차이: 선택한 plan이 다음 쿼리의 캐시 상태에 영향을 주므로 context가 완전히 독립적이지 않다.
- 의미적 동등성 가정: 모든 힌트가 의미적으로 동일한 plan을 만든다고 가정한다.
후속 연구 방향
- 클라우드 시스템 통합: 디스크·RAM·CPU가 부족한 multi-tenant 환경에서 Bao가 자원 활용도를 높일 수 있는지 검증한다.
- Bao 예측 모델을 전통적 옵티마이저의 비용 모델로 활용해서, 전통적 최적화 기법도 ML의 이점을 누리게 한다.
- off-policy 강화학습: Bao가 꺼져 있을 때 실행된 쿼리, 즉 DBA의 수동 최적화 작업으로부터 학습한다.
- hint set과 그 영향에 대해 더 자세히 분석한다.
6️⃣ 인사이트 도출
💡 "처음부터 다시 배우지 말고, 이미 있는 전문가를 조종하라"
- Bao의 가장 큰 교훈은 기존 시스템을 대체하는 대신, 그 위에서 작은 조종 신호만 학습한다는 설계다.
- Neo·DQ처럼 plan 전체를 직접 만들면 자유도는 높지만 수렴에 수십 시간이 걸리고 변화에 약하다. Bao는 action space를 O(n)으로 좁혀서 최종 성능 상한을 조금 포기하는 대신 학습 속도·안정성·적응성을 얻었다.
- 👉 도메인 지식이 담긴 규칙 기반 시스템이나 휴리스틱이 이미 있는 문제라면, 그것을 "arm 생성기"로 쓰고 ML은 선택만 담당하게 하는 구조를 먼저 고려해 볼 수 있다.
💡 평균보다 tail을 보라
- Bao의 이득은 대부분 tail에서 나왔고, median은 거의 그대로였다. 하지만 워크로드가 Pareto 분포(20% 쿼리가 80% 시간)를 따르기 때문에 전체 비용은 약 50% 줄었다.
-> 모델을 평가할 때 평균 지표만 보지 말고 분포의 꼬리(95/99/99.5 percentile)와 실패 사례의 크기를 함께 봐야 한다. 이 논문은 "평균은 좋지만 가끔 100배 느려지는" 모델이 실제로는 쓰이기 어렵다는 점을 문제 정의의 중심에 두었다.
💡 Supervised learning이 아니라 Bandit으로 푼 이유
- 예측이 가장 좋은 plan만 고르면 모델이 틀렸는지 영영 알 수 없다는 지적이 핵심이다. 추천·광고·자동 튜닝처럼 모델의 선택이 다음 학습 데이터를 결정하는 문제에서는 exploration을 설계에 넣어야 한다.
- Bao는 이를 복잡한 Bayesian NN이 아니라 bootstrap으로 학습 데이터를 다시 뽑아 학습하는 단순한 방법으로 구현했다.
💡 입력 표현이 일반화를 결정한다
- 테이블·컬럼 정보를 feature에서 일부러 빼고 연산자 종류, 카디널리티, 비용, 캐시 비율만 남긴 덕분에 스키마가 바뀌어도 모델을 그대로 쓸 수 있었다.
-> 환경 변화에 강한 모델이 필요하다면, 변하는 요소(ID, 이름 등)는 빼고 변하지 않는 구조적·통계적 특성으로 표현하는 것이 좋다. 또 트리 구조 데이터에는 tree convolution처럼 구조에 맞는 inductive bias를 주는 것이 RF·선형 모델보다 확실히 나았다(Fig. 15a).
💡 "실용성"은 모델 밖에서 완성된다
- Bao는 모델 성능뿐 아니라 쿼리 단위 on/off, advisor mode, triggered exploration, 재컴파일 없는 설치, GPU 탈부착 학습, 클라우드 비용($)으로 평가처럼 운영 관점의 장치를 함께 설계했다.
-> ML을 실제 시스템에 넣으려면 사람이 결정을 확인하고, 끄고, 중요한 케이스는 보장받을 수 있는 장치가 모델만큼 중요하다. 평가 지표도 정확도 대신 학습 오버헤드까지 포함한 end-to-end 비용으로 잡은 점을 참고할 만하다.
좋은 논문이네요! 잘 읽었습니다