[Python] 평균 파이썬 실습 코드 내용 정리 2
단순 재방문 주기 평균 및 중앙값
revisit_freq_mean = df.days_since_prior_order.mean()
revisit_freq_median = df.days_since_prior_order.median()

print(f"단순 재방문 주기 평균: {revisit_freq_mean:.2f}일")
print(f"단순 재방문 주기 중앙값: {revisit_freq_median:.2f}일")
단순 재방문 주기 평균: 11.10일
단순 재방문 주기 중앙값: 8.00일
- days_since_prior_order 컬럼의 단순 평균/중앙값만 낸 값
재방문 주기 분포 그래프
df_revisit_freq = df.days_since_prior_order.fillna(-1).value_counts(normalize=True).sort_index()

df_revisit_freq.plot()
plt.title("Revisit Frequency")
plt.ylabel("Ratio")
plt.xlabel("Days")
plt.show()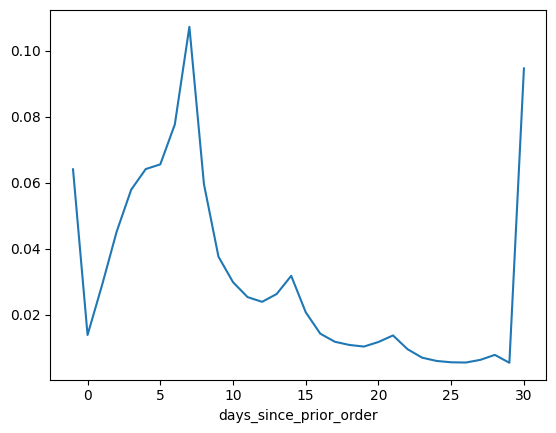
df.days_since_prior_order.fillna(-1):
days_since_prior_order 열에서 결측값(NaN)을 -1로 대체함.fillna(-1)는 결측값을 -1로 채우는 매소드.value_counts(normalize=True):
days_since_prior_order 열의 각 값에 대해 빈도 계산.
normalize=True는 상대적인 빈도를 계산하는 옵션이며, 각 값의 비율을 반환함.sort_index():
결과를 인덱스(주문 간격 값)을 기준으로 정렬
-> 어떤 주문 간격 값이 많이 등장하는지 상대적으로 비교
- 30일째에서 그래프가 크게 상승한 이유
- 30일 이상의 재방문일자를 다 30일로 퉁친 경우 (<= 유력)
- 30일째에 재방문하면 큰 혜택을 주는 등의 이벤트가 있을 가능성
유저별 재방문 주기
revisit_freq_by_user = df.groupby("user_id").days_since_prior_order.mean()

revisit_freq_by_user_mean = revisit_freq_by_user.mean()
revisit_freq_by_user_median = revisit_freq_by_user.median()

print(f"단순 재방문 주기 평균: {revisit_freq_by_user_mean:.2f}일")
print(f"단순 재방문 주기 중앙값: {revisit_freq_by_user_median:.2f}일")
단순 재방문 주기 평균: 15.47일 ( +4.37 상승)
단순 재방문 주기 중앙값: 14.69일 (+ 6.69 상승)
유저별 재방문 비율 그래프
revisit_freq_by_user.hist(bins=30, color='skyblue')
plt.title("Revisit Frequency by User")
plt.ylabel("Ratio")
plt.xlabel("Days")
plt.show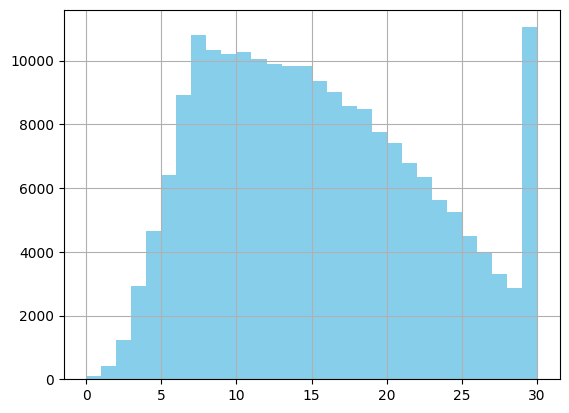
revisit_freq_mean = df.days_since_prior_order.mean():
전체 데이터프레임에서 days_since_prior_order 열의 평균을 계산revisit_freq_by_user = df.groupby("user_id").days_since_prior_order.mean():
user_id 열을 기준으로 그룹화한 후, 각 사용자별로 days_since_prior_order 열의 평균을 계산
-> 첫 번째는 전체 데이터에 대한 평균
-> 두 번째는 각 사용자에 대한 평균
유저별 재방문 주기 재계산 (이상치 제거)
## 유저별 재방문 주기 (30일 제거)

revisit_freq_by_user_remove_30 = (
    df
    [df.days_since_prior_order != 30]
    .groupby("user_id")
    .days_since_prior_order
    .mean()
)

revisit_freq_by_user_mean = revisit_freq_by_user_remove_30.mean()
revisit_freq_by_user_median = revisit_freq_by_user_remove_30.median()

print(f"단순 재방문 주기 평균: {revisit_freq_by_user_mean:.2f}일")
print(f"단순 재방문 주기 중앙값: {revisit_freq_by_user_median:.2f}일")
단순 재방문 주기 평균: 11.63일 ( - 3.84 감소)
단순 재방문 주기 중앙값: 10.89일 ( - 3.8 감소)
가중치 교정
df_revisit_unique = df[['user_id', 'order_id', 'days_since_prior_order']].drop_duplicates()

df_revisit_unique.groupby('user_id').days_since_prior_order.sum().hist(bins=30, color='skyblue')
plt.show()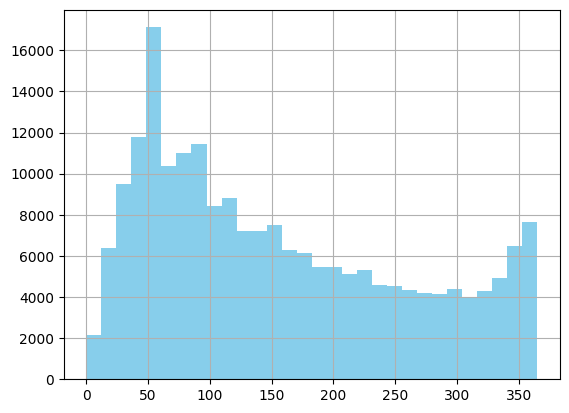
df_revisit_unique.groupby('user_id').days_since_prior_order.sum():
user_id를 기준으로 그룹화하고, 각 사용자별로 'days_since_prior_order' 열의 값을 합산한다..hist(bins=30, color='skyblue'):
계산된 사용자별 주문 간격의 합에 대한 히스토그램을 생성. bins=30은 막대개수를 설정 (30개로 설정됨)
유저별 재방문 주기 재계산
## 유저별 재방문 주기 재계산

revisit_freq_by_user = (
    df_revisit_unique
    .groupby("user_id")
    .days_since_prior_order
    .mean()
)

revisit_freq_by_user_mean = revisit_freq_by_user.mean()
revisit_freq_by_user_median = revisit_freq_by_user.median()

print(f"단순 재방문 주기 평균: {revisit_freq_by_user_mean:.2f}일")
print(f"단순 재방문 주기 중앙값: {revisit_freq_by_user_median:.2f}일")
단순 재방문 주기 평균: 15.21일
단순 재방문 주기 중앙값: 14.50일
-> 중복이 제거된 데이터를 사용해서 다시 사용자별 주문 간격 평균 계산
| 중복제거 전 | 중복제거 후 |
|---|---|
| 평균 : 15.47일 | 평균 : 15.21일 |
| 중앙값 : 14.69일 | 중앙값 : 14.50일 |
데이터 애널리스트가 되고 싶은