[논문리뷰] An Image is Worth 16 x 16 Words : Transformer for Image Recognition at Scale

혼자 정리해본 transformer 관련 계보(?)CV 분야에 참여하고 있는 만큼, Transformer에 이어 ViT(Vision Transformer) 논문을 정리해보려고 한다.
앞서 정리한 Transformer가 NLP 분야의 기계번역에 방대한 영향을 끼친 논문이라면, Vision Transformer는 CV분야의 Image Classification에 이용된다.
구조
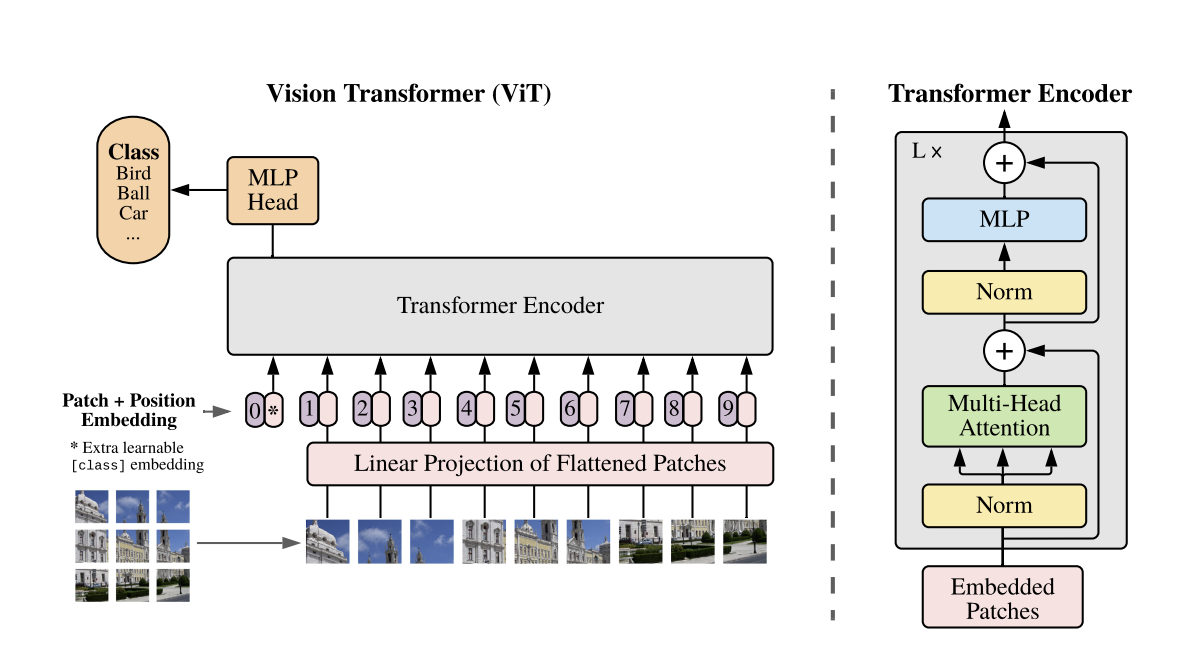
과정
1. 이미지를 패치화
input image를 9개의 패치로 나누어준다.
input image 사이즈가 48*48 → 패치 사이즈 16*16
2. Transformer Encoder
순서대로 각 패치를 임베딩하여 Transformer Encoder에 넣어준다.
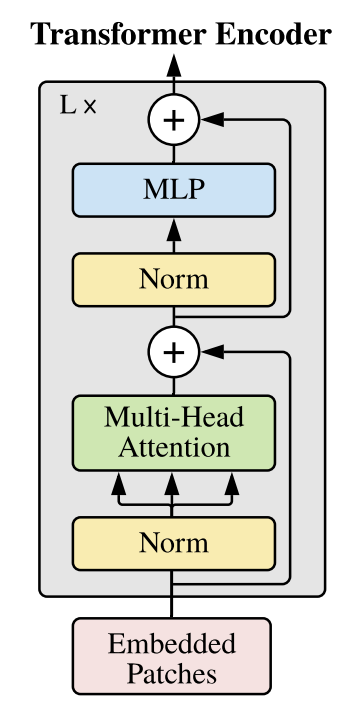
Transformer Encoder는 MSA와 MLP의 두 개 block으로 구성되어 있다. 각 block의 앞에는 Layer Norm(LN)을 적용하고, 각 block의 뒤에는 residual connection을 사용한다.
이 때 순서가 중요하므로 position embedding을 넣어주어 위치값을 보존한다.
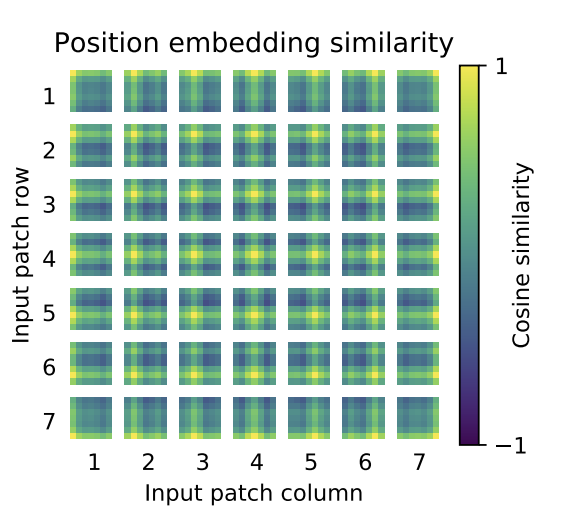
활성화된 부분일수록 밝다.
각 패치를 LN한 뒤 모두 concat한다.
이 vector 사이즈는 각 vector dimension*9 이다.
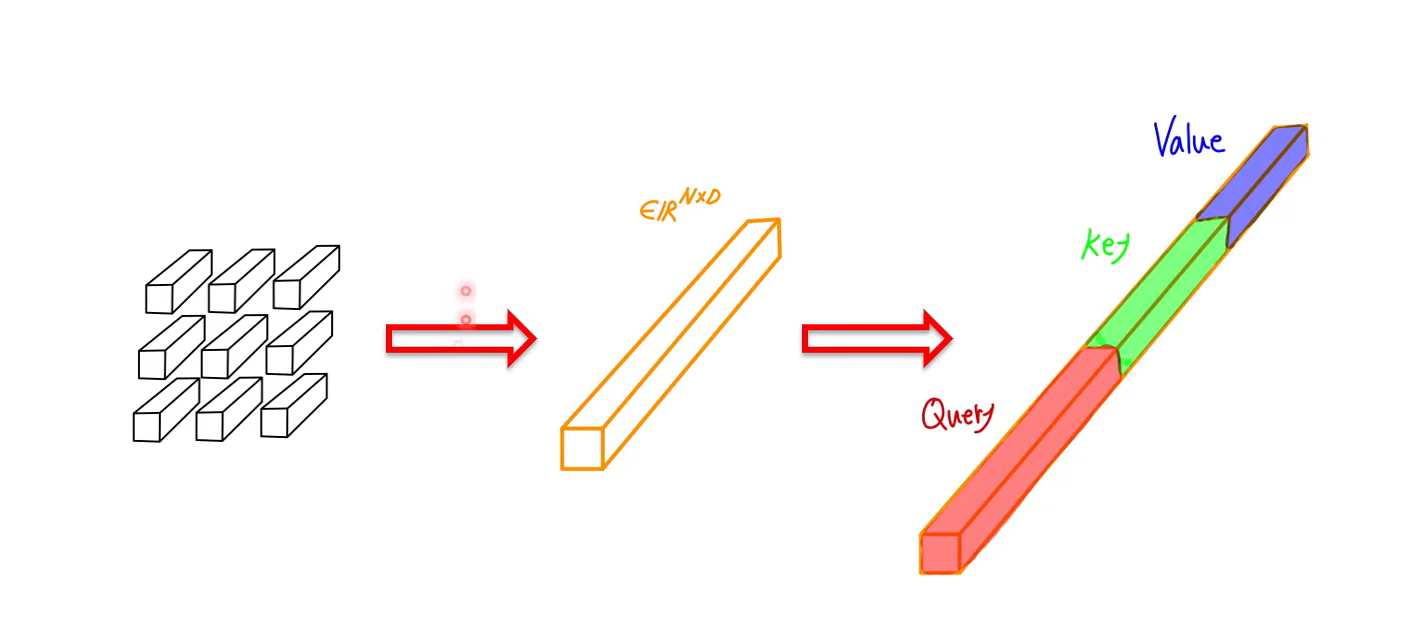
사진: https://www.youtube.com/watch?v=91Qipj5NMnk2-1. Multi head Self Attention (MSA)
Self Attention을 위해 해당 vector에 weight를 곱하여 Query, Key, Value로 나누어주고, Multi Head 구조로 이를 반복한다.
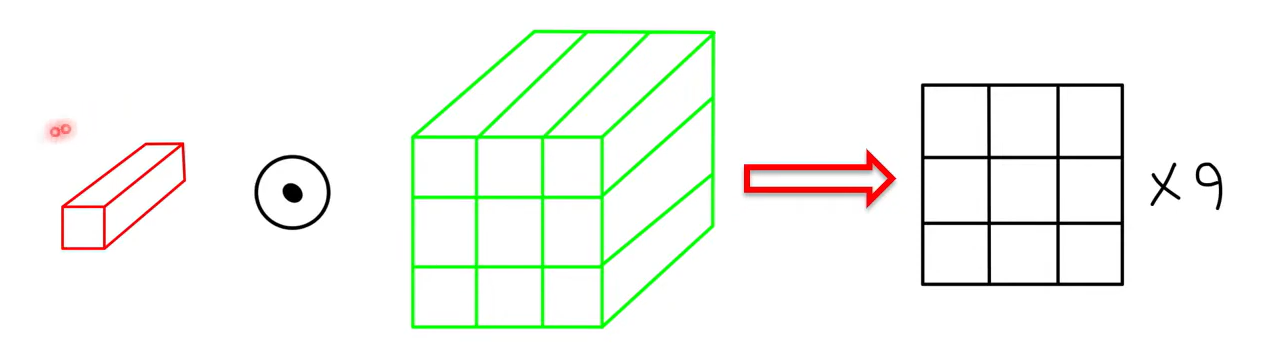
사진: https://www.youtube.com/watch?v=91Qipj5NMnk각 Query가 전체 Key vector에 각각 내적을 수행하고, 패치가 9개였으므로 총 9개의 output이 나온다. 이후 이 값에 softmax를 취해주고, 이 값은 attention score가 된다.
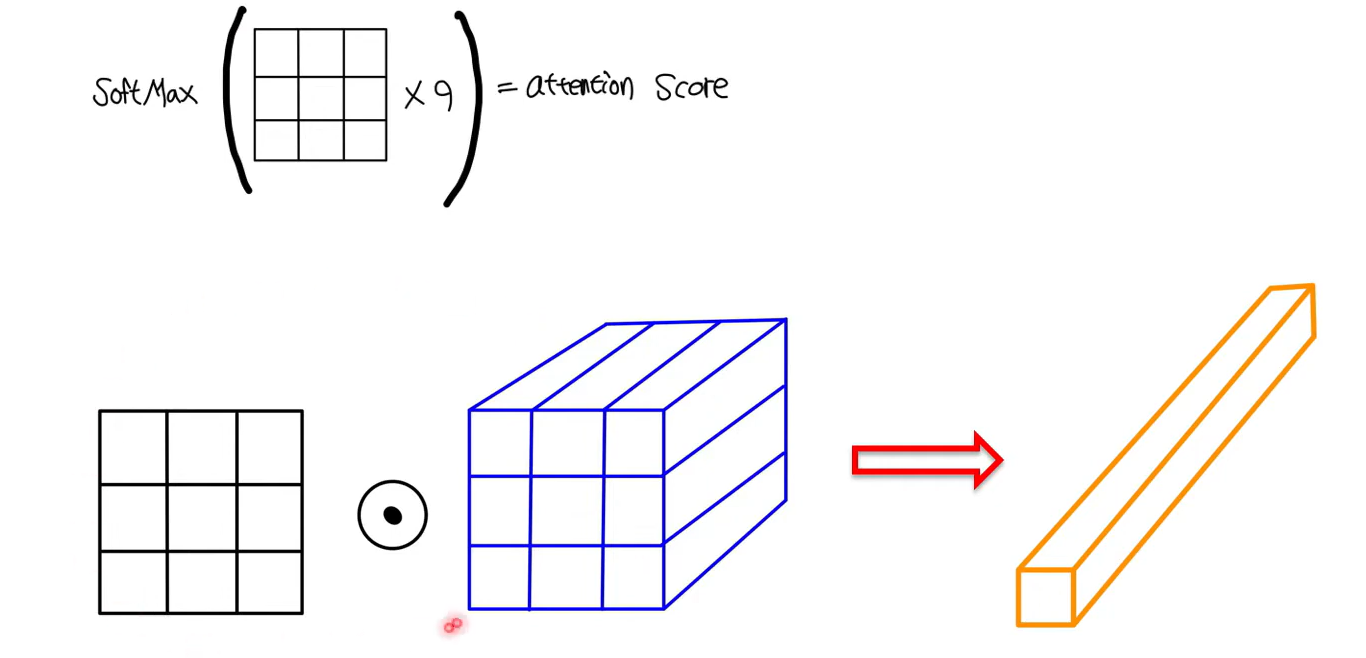
사진: https://www.youtube.com/watch?v=91Qipj5NMnk
이 값을 Value vector와 내적 연산을 하여 최종적으로 output vector가 나온다.
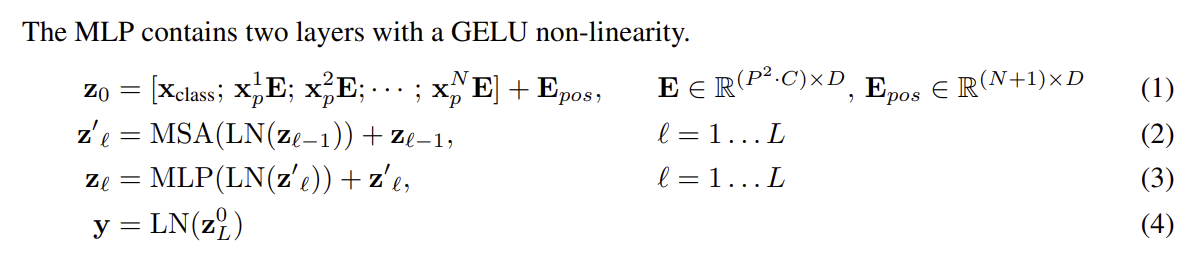
이후 Skip connection을 통해 Multi Head Attention에 원래 값을 더해 기존 값을 보존한다.
2-2. Multi Layer Perceptron(MLP)
위의 값을 다시 LN한 뒤 Multi Layer Perceptron(MLP), Skip connection을 통하여 최종 output을 출력한다. MLP는 2개의 layer를 가지며, GELU activation function을 사용한다.
성능
Baseline으로는 Big Transformer(BiT) 구조의 ResNet을 사용했다.
1. 각 데이터셋별 성능
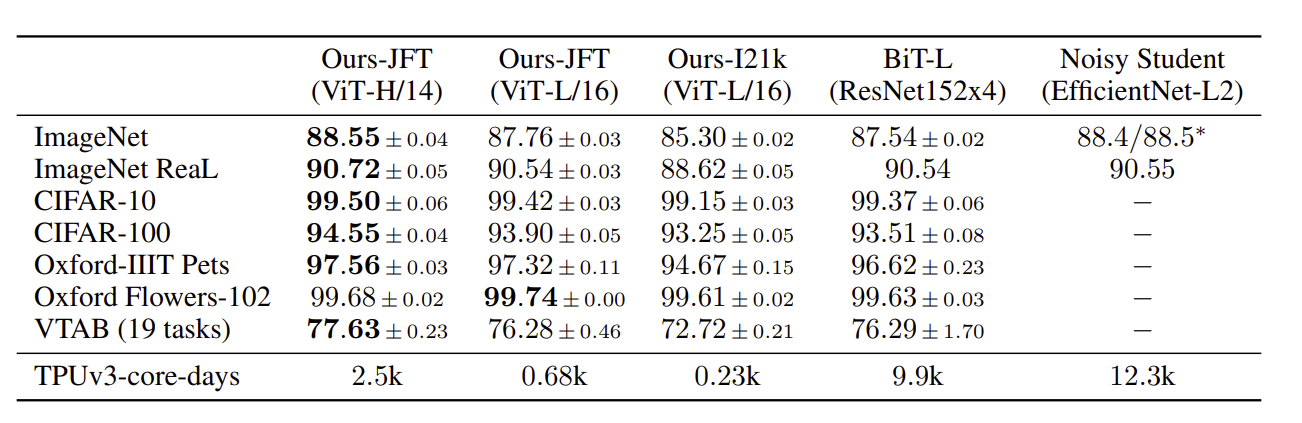
- JFT 데이터셋에서 pre-training한 ViT-L/16 모델이 모든 downstream task에 대하여 BiT-L보다 높은 성능을 도출했다.
- ViT-H/14 모델은 ViT-L/16 모델보다 향상된 성능을 도출했으며, BiT-L보다 학습 시간이 훨씬 짧다.
2. 한 데이터셋에서의 이미지 특성별 성능
Natural: Pets, CIFAR과 같은 task
Specialized: Medical, satellite imagery task
Structured: localization과 같이 기하학적 이해를 요구하는 task
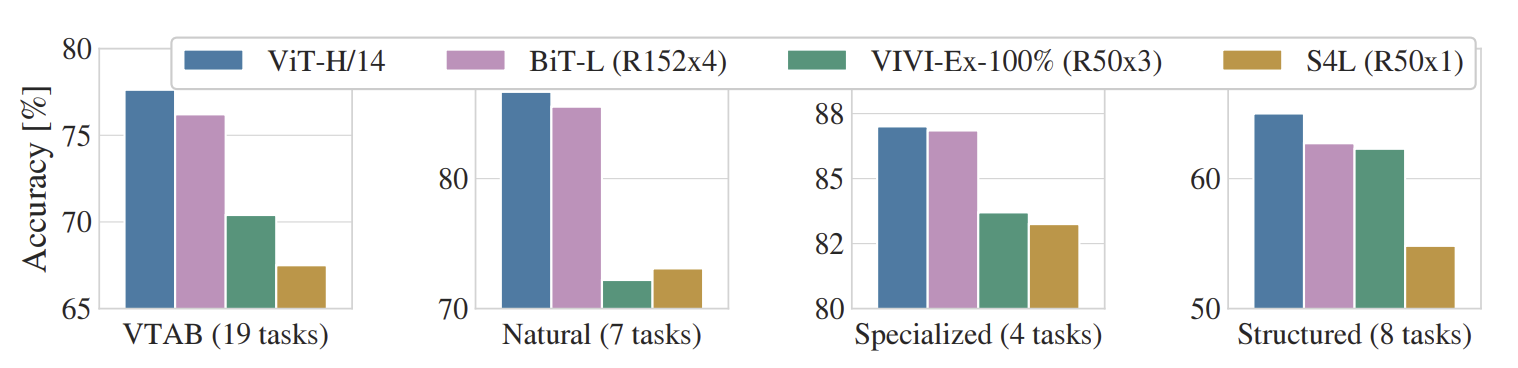
전체 데이터 뿐만 아니라 각 그룹에서도 ViT-H/14가 좋은 결과를 도출했다.
참고
https://www.youtube.com/watch?v=91Qipj5NMnk
https://www.youtube.com/watch?v=0kgDve_vC1o
덕분에 선행 학습 잘 했습니다...!👍