aws: [ERROR]: Waiter CommandExecuted failed: Max attempts exceeded. Previously accepted state: For expression "Status" we matched expected path: "InProgress”
문제
CI(Github Actions)에서 SSM으로 EC2 배포 중 위 에러로 인해 배포에 실패했습니다. 처음에는 문제 없었으나, 배포 횟수가 증가하면서 발생하는 것 같았습니다.
원인
디스크 용량 또는 메모리 부족
- 현재 문제가 되는 EC2 인스턴스의 유형은 t3.micro로 매우 작습니다(미니 프로젝트라서 이 유형 적용). t3.micro는 리소스가 매우 작아서(RAM 1GB), 배포를 반복하면 로그 및 캐시가 쌓이며 디스크 사용량이 증가하고, 도커 이미지 빌드 또는 컨테이너 재시작으로 램이 부족해져 Out of memory가 발생할 수 있습니다.
SSM 명령 자체 timeout/대기 설정이 짧음
- CI가 너무 빨리 실패로 판정해서 완료중인 작업이 실패로 끝나는것도 문제의 원인이 될 수 있습니다.
해결
t3.small로 인스턴스 유형을 업그레이드 할 수도 있지만, 프로젝트 규모가 매우 작고 t3.small로 업그레이드 시 비용이 거의 2배가 차이난다고해서 아래 1, 2번 방법을 시도했습니다.
스왑 메모리 추가 (해결 X)
free -m
     total used free shared buff/cache available
Mem:  909   509  94     2      438        400
Swap:  0     0    0
💡 스왑 메모리
프로그램은 기본적으로 RAM에서 실행되는데, RAM 공간이 부족해지면 자주 사용되지 않는 데이터를 물리 디스크의 Swap 메모리로 이동시켜 OOM을 방지할 수 있습니다.
인스턴스에 접속해서 free -h 명령어로 메모리 사용량을 확인해보니, 스왑 메모리를 전혀 사용하고 있지 않았습니다. docker build 같은 명령어 실행으로 배포 중 메모리가 급증할 시 OOM 또는 심한 지연이 발생할 수 있고, 이것이 문제의 원인일 가능성도 있기에 Swap 2GB를 추가했습니다.
## Generated by AI
# 1) 현재 스왑 확인
swapon --show
free -h

# 2) 2GB 스왑 파일 생성
sudo fallocate -l 2G /swapfile

# 3) 권한 설정 (필수)
sudo chmod 600 /swapfile

# 4) 스왑 영역으로 포맷
sudo mkswap /swapfile

# 5) 즉시 활성화
sudo swapon /swapfile

# 6) 재부팅 후에도 스왑 유지
# 이 명령어를 실행하지 않으면 현재 세션에서만 유효
echo '/swapfile none swap sw 0 0' | sudo tee -a /etc/fstab

# 7) 적용 확인
free -h
앞서 말했듯 스왑 메모리는 메모리 사용량 피크 시 OOM을 방지할 수 있다는 장점이 있지만, 디스크(HDD/SSD)는 RAM보다 데이터 읽기/쓰기 속도가 현저히 느리기 때문에 스왑이 빈번하게 발생하면 전체적인 시스템 성능과 응답 속도가 크게 떨어질 수 있는 단점도 존재합니다. 그리고 결론적으로는 이 방법만으로 해결되지 않았습니다.
기존 wait 코드를 폴링 코드로 대체 (해결)
💡 폴링 (Polling)
클라이언트에서 일정한 주기를 두고 서버에 요청을 보내 원하는 데이터나 상태 변화가 있는지 반복적으로 확인하는 통신 및 처리 방식입니다.
Success 응답이 올 때까지 ssm command 상태를 반복 조회하도록 코드를 수정했습니다. 이렇게 하니 10번째 시도에서 배포에 성공했습니다!
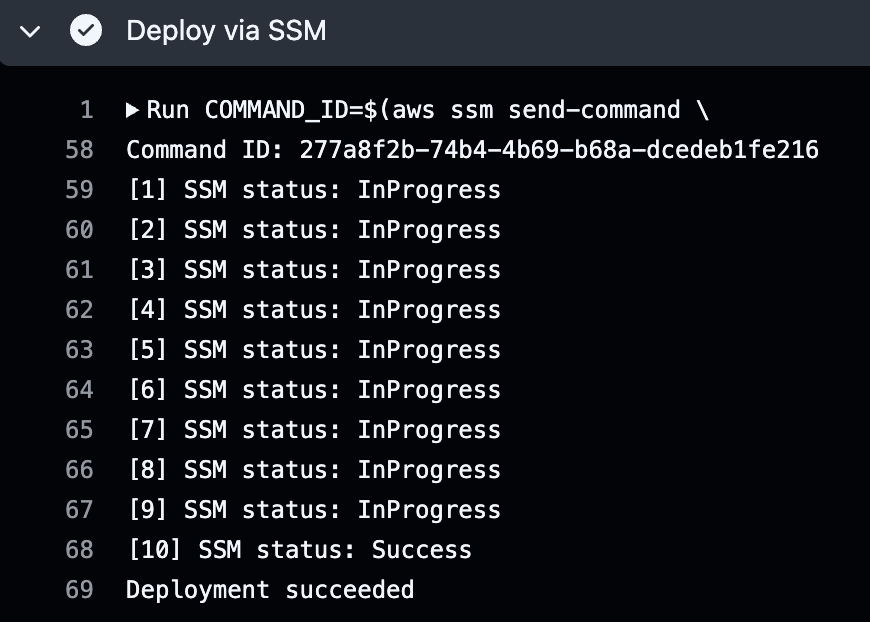
## Generated by AI
for i in {1..120}; do
	# get-command-invocation으로 command 상태를 10초마다 확인
  STATUS=$(aws ssm get-command-invocation \
    --command-id "$COMMAND_ID" \
    --instance-id "${{ secrets.EC2_INSTANCE_ID }}" \
    --query 'Status' \
    --output text)

  echo "[$i] SSM status: $STATUS"

  if [ "$STATUS" = "Success" ]; then
    echo "Deployment succeeded"
    exit 0
  fi

  if [ "$STATUS" = "Failed" ] || [ "$STATUS" = "Cancelled" ] || [ "$STATUS" = "TimedOut" ]; then
    aws ssm get-command-invocation \
      --command-id "$COMMAND_ID" \
      --instance-id "${{ secrets.EC2_INSTANCE_ID }}" \
      --output json
    exit 1
  fi

  sleep 10
done

echo "SSM command still InProgress after timeout"
aws ssm get-command-invocation \
  --command-id "$COMMAND_ID" \
  --instance-id "${{ secrets.EC2_INSTANCE_ID }}" \
  --output json
exit 1
결론
이 문제는 폴링 방식으로 해결할 수 있었습니다. 하지만 작은 서비스임에도 불구하고, 배포 시 시간이 좀 소요되는 것 같고(2분 정도..? 물론 그렇게 오랜 시간은 아닌 것 같기도 합니다 ㅎㅎ), 배포가 반복되면 동일한 문제가 또 발생할 수 있다는 생각이 들었습니다. 지금 당장은 배포가 잦지 않기 때문에 괜찮지만, 추후 서비스가 커지면 그때는 인스턴스를 업그레이드 해야할 것 같습니다.
참고