지난번에 공부했던 퍼셉트론(Perceptron)을 파이썬으로 구현해보고자 한다.
우선, 퍼셉트론은 아래와 같은 구조로 이루어져 있다.
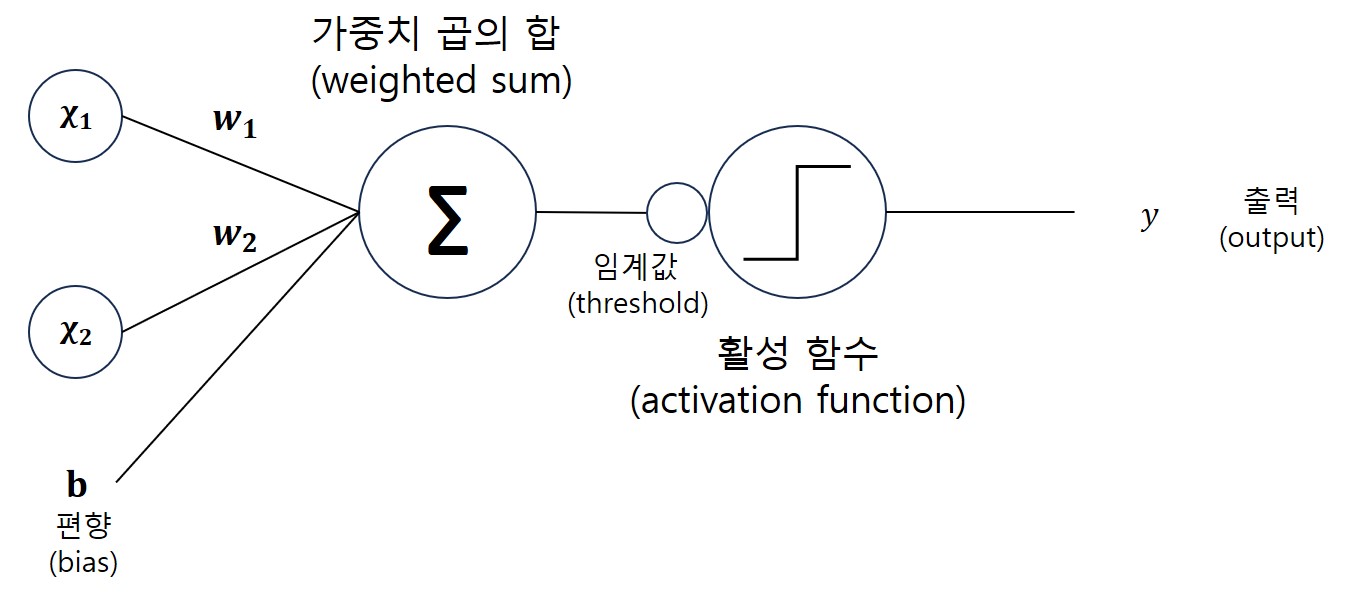
학습 데이터셋으로는 AND 게이트를 사용하였다.
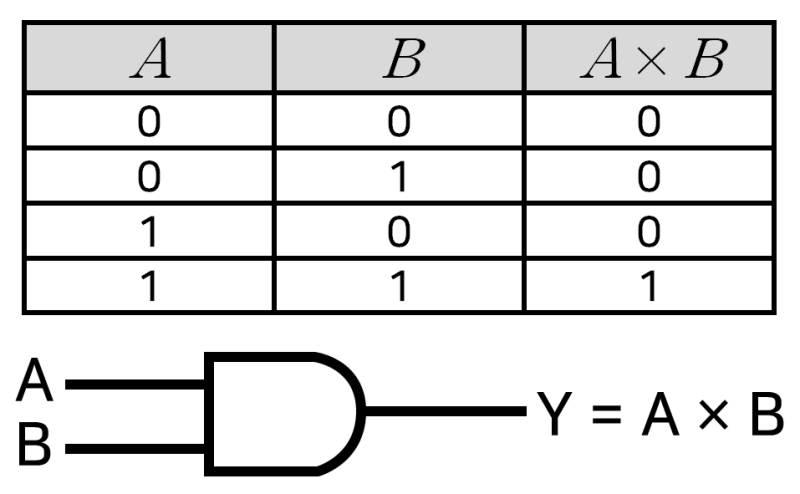
위 사진은 AND 게이트를 나타낸 표와 회로 그림이다.
AND 게이트를 학습 데이터로, 퍼셉트론을 파이썬으로 구현하면 아래 코드와 같다.
전체 코드
class Perceptron:
  # 초기값 설정
  def __init__(self, input_data_dim=2, eta=0.1, epoch=100): #input_data_dim = 데이터의 차원을 결정.
      self.weight = np.zeros(input_data_dim) #가중치를 입력된 데이터의 차원에 맞게 0으로 설정
      self.bias = 0                      # 편향
      self.eta = eta                     # 학습률
      self.epoch = epoch                 # 반복 횟수

  # 활성 함수(계단 함수) 구현
  def step_function(self, x, threshold=0):
      self.threshold = threshold                           # 임계값
      return 1 if x > self.threshold else 0

  # 예측값
  def predict(self, X):
      z = np.dot(X, self.weight) + self.bias
      y_predict = self.step_function(z)
      return y_predict

  def fit(self, X, y):
      for epoch in range(self.epoch):
          for i in range(len(X)):
              # 예측값 계산
              z = np.dot(X[i], self.weight) + self.bias
              y_predict = self.step_function(z)

              # 오차 계산
              error = y[i] - y_predict

              # 가중치, 편향 업데이트
              self.weight += self.eta * error * X[i]
              self.bias += self.eta * error

  # 최적의 가중치, 편향 출력
  def print_optimized_weight_bias(self):
      print(f'최적의 가중치: {self.weight}')
      print(f'최적의 편향: {self.bias}')


# AND 게이트 데이터 셋
X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]]) # 입력 데이터
y = np.array([0, 0, 0, 1])                   # 출력 데이터(AND 게이트의 결과)

# 퍼셉트론 모델 생성 및 학습
perceptron = Perceptron()
perceptron.fit(X, y)

# 최적의 가중치, 편향 출력
perceptron.print_optimized_weight_bias()

# AND 게이트 결과 예측 및 출력
print('AND 게이트 결과: ')
for sample in X:
  print(f'입력: {sample} -> 출력: {perceptron.predict(sample)}')
출력 결과
최적의 가중치: [0.2 0.1]
최적의 편향: -0.2
AND 게이트 결과:
입력: [0 0] -> 출력: 0
입력: [0 1] -> 출력: 0
입력: [1 0] -> 출력: 0
입력: [1 1] -> 출력: 1
이제 위 코드에서 각 함수 별로 뜯어보기로 하자.
코드 뜯어보기
1. 초기화(초기값 설정)
def __init__(self, input_data_dim=2, eta=0.1, epoch=100): #input_data_dim = 데이터의 차원을 결정.
      self.weight = np.zeros(input_data_dim) #가중치를 입력된 데이터의 차원에 맞게 0으로 설정
      self.bias = 0                      # 편향
      self.eta = eta                     # 학습률
      self.epoch = epoch                 # 반복 횟수
__init__ 생성자 함수로 생성한 객체를 초기화하고 기본값을 설정.
input_data_dim: 입력 데이터의 차원(특성의 개수)을 설정. AND 게이트에서는 2(, )self.weight: 입력 데이터의 각 특성에 대한 가중치를 0으로 초기화.self.bias: 편향 값. 초기값은 0self.eta: 학습률. 학습 시 가중치와 편향 업데이트 크기를 결정.self.epoch: 전체 학습 데이터셋에 대해 반복 학습할 횟수.
2. 활성 함수(계단 함수)
# 활성 함수(계단 함수) 구현
  def step_function(self, x, threshold=0):
      self.threshold = threshold                           # 임계값
      return 1 if x > self.threshold else 0
입력 값 x에 대해 threshold를 기준으로 이진 출력(0또는 1)을 반환하는 활성 함수로 계단 함수를 코드로 구현함.
- 퍼셉트론에서는 계단 함수(Step Function)로 동작.
threshold: 출력이 1로 바뀌는 경계값(기본값 0)으로 임계값이라고도 함.x > threshold인 경우1을 출력, 그렇지 않으면0을 출력.
3. 예측 함수
# 예측값
  def predict(self, X):
      z = np.dot(X, self.weight) + self.bias
      y_predict = self.step_function(z)
      return y_predict
주어진 입력 X에 대해 모델이 예측한 결과(0 또는 1)를 반환.
1. 선형 결합 계산(가중치 곱의 합):
z = np.dot(X, self.weight) + self.bias- 입력 데이터
X와 가중치 벡터 self.weight의 내적(dot product)에 편향self.bias를 더한 값. - 쉽게 말해, 가중치 곱의 합에 편향을 더한 것이라 보면 됨.
- 활성 함수 적용:
- 선형 결합 결과
z를step_function에 입력해 최종 예측값(y_predict)도출.
- 최종 예측값 반환.
return y_predict
4. 학습 함수
def fit(self, X, y):
      for epoch in range(self.epoch):
          for i in range(len(X)):
              # 예측값 계산
              z = np.dot(X[i], self.weight) + self.bias
              y_predict = self.step_function(z)

              # 오차 계산
              error = y[i] - y_predict

              # 가중치, 편향 업데이트
              self.weight += self.eta * error * X[i]
              self.bias += self.eta * error
퍼셉트론 모델을 학습시켜 가중치와 편향을 최적화함.
- 학습 과정:
epoch: 데이터셋 전체를 몇 번 반복할지 지정.z = np.dot(X[i], self.weight) + self.bias: 입력 샘플X[i]에 대해 선형 결합 계산 수행.y_predict: 예측값(계단 함수 결과).error: 실제값y[i]와 예측값y_predict의 차이. ->
- 가중치와 편향 업데이트:
self.weight += self.eta * error * X[i]: 학습률과 오차를 입력 데이터와 곱해 가중치 수정. ->self.bias += self.eta * error: 편향은 입력 데이터에 관계없이 오차와 학습률만으로 수정. ->
- 반복적으로 학습하여 최적의 가중치와 편향을 도출한다.
5. 최적의 가중치와 편향 출력
# 최적의 가중치, 편향 출력
  def print_optimized_weight_bias(self):
      print(f'최적의 가중치: {self.weight}')
      print(f'최적의 편향: {self.bias}')
학습이 완료된 후 최적화된 가중치(self.weight)와 편향(self.bias)을 출력.
AND 게이트 학습 및 예측 과정
# AND 게이트 데이터 셋
X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]]) # 입력 데이터
y = np.array([0, 0, 0, 1])                   # 출력 데이터(AND 게이트의 결과)

# 퍼셉트론 모델 생성 및 학습
perceptron = Perceptron()
perceptron.fit(X, y)

# 최적의 가중치, 편향 출력
perceptron.print_optimized_weight_bias()

# AND 게이트 결과 예측 및 출력
print('AND 게이트 결과: ')
for sample in X:
  print(f'입력: {sample} -> 출력: {perceptron.predict(sample)}')
-
모델 학습(
fit):- 입력 데이터(
X)와 출력 데이터(y)를 사용해 가중치와 편향을 반복적으로 업데이트. - 최종적으로 AND 게이트를 만족하는 가중치와 편향 학습.
- 입력 데이터(
-
결과 예측(
predict):- 학습된 모델로 각 입력 데이터에 대한 예측 결과 출력.
-
최적의 가중치와 편향:
- 학습 완료 후print_optimized_weight_bias로 가중치와 편향 확인.
이렇게 파이썬으로 단층 퍼셉트론을 구현해보았다. 위 코드를 통해 다양한 선형성 분류 문제를 해결할 수 있을 것이다.
단, XOR와 같이 비선형 문제는 풀 수 없다는 한계점이 있다.
이러한 한계를 극복하기 위해 나온 다층 퍼셉트론(Multi-Layer Perceptron)에 대해 다음 시간에 알아보도록 하자.