컴퓨터가 점점 빨라지며 상대적으로 I/O 시간은 점점 느려지고 있다.
따라서 빠른 속도의 CPU 를 효율적으로 사용하는 멀티스레딩은 필수적인 기술이다.
하지만 프로세스, 스레드들이 공유하는 메모리의 데이터는 동시성 문제라는 것을 해결해야 한다.
하드웨어에서의 동시성
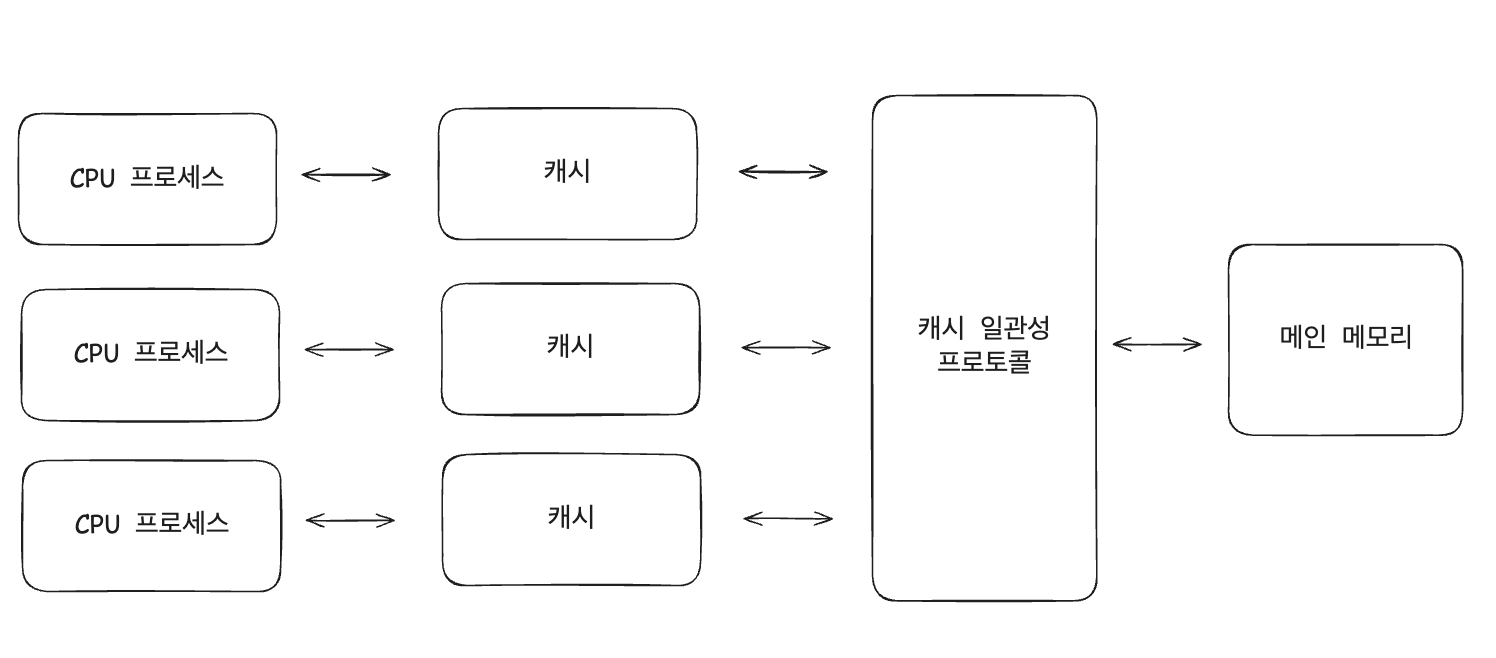
CPU 의 프로세스는 매우 빠르다. 그에 비해 메모리에 값을 저장하고 읽는 속도는 느리다.
이 CPU 와 메모리의 처리속도를 보완하기 위해서, 읽고 쓰는 중간에 캐시 레이어를 둔다.
그러면 위와 같은 그림의 구조가 되는데, 이를 공유 메모리 멀티 프로세스 시스템 이라 한다.
하지만 캐시 구조는 동시성 문제를 유발하기 때문에, 캐시들 사이의 값을 일치시키기 위해 캐시 일관성 프로토콜 을 사용한다. 이는 캐시 일관성 프로토콜은 여러 캐시에서 읽고 수정되는 값이 일관성 있도록 처리한다.
또한 캐시에는 store buffer 라는 놈이 존재하는데, CPU 는 결과가 같다면 버퍼에 저장된 명령어의 순서를 변경할 수 있다. 이는 일부 시나리오에서 동시성 문제를 발생시킬 수 있다.
자바 메모리 모델
메모리 모델은 특정 프로토콜을 통해 메모리나 캐시를 읽고 쓰는 절차
자바 메모리 모델의 목적은 자바 프로그램에서 변수에 접근하는 규칙을 정함으로써 여러 스레드가 메모리에 접근해도 동시성 문제가 발생하지 않도록 하는 것이다.
메인 메모리, 작업 메모리
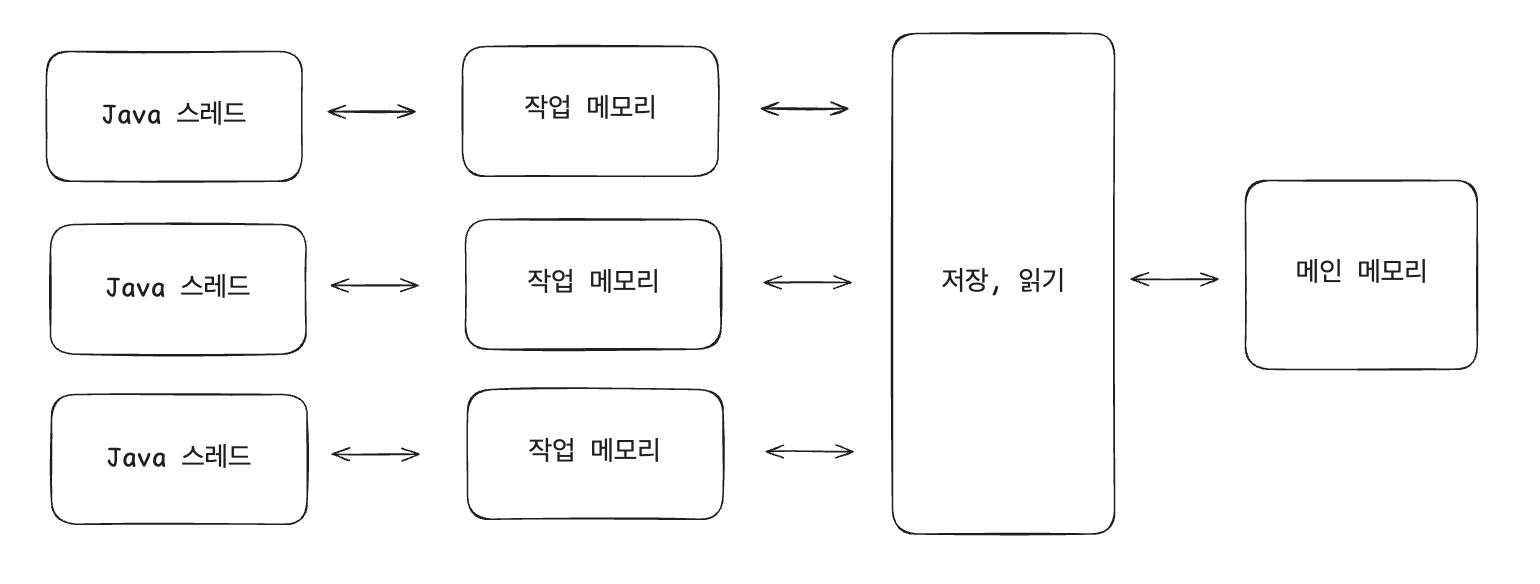
JVM 은 가상 머신으로 하드웨어와 비슷한 공유 메모리 멀티 프로세스 시스템을 가진다.
위 그림의 작업 메모리, 메인 메모리의 역할은 하드웨어와 비슷하다. 단, 이 메모리는 하드웨어처럼 물리 메모리를 나타내는게 아닌 JVM 개념 상의 메모리를 말한다.
실제로 구현 상 작업 메모리 저장소를 CPU 캐시나 레지스터로 구현하기도 한다. 자주 이용하고 빨라야하기 때문이다.
위 그림에서 작업 메모리와 메인 메모리 사이에 값을 주고 받는 프로토콜로 저장, 읽기 라고 나와있다. 이 부분이 Java Memory Model 이다. JVM 상에서 스레드, 작업 메모리, 메인 메모리간 변수를 읽고 쓰는 동작을 정의한다.
JVM 은 여러 하드웨어 플랫폼에서 동작해야하기 때문에 Java Memeory Model(JMM) 은 추상적으로 작성된 규칙이다. 이 덕분에 자바 프로그램은 어느 운영체제 및 메모리 모델에 상관없이 일관성 있게 메모리를 사용할 수 있다.
JMM 연산
메인 메모리와 작업 메모리 사이의 프로토콜, 즉 메인 메모리에서 작업 메모리로 값을 복사하고 작업 메모리의 값을 메인 메모리로 동기화하는 방법을 JVM 은 다음 8가지로 정의했다.
이 8가지 연산을 원자적 으로 제공해야 한다.
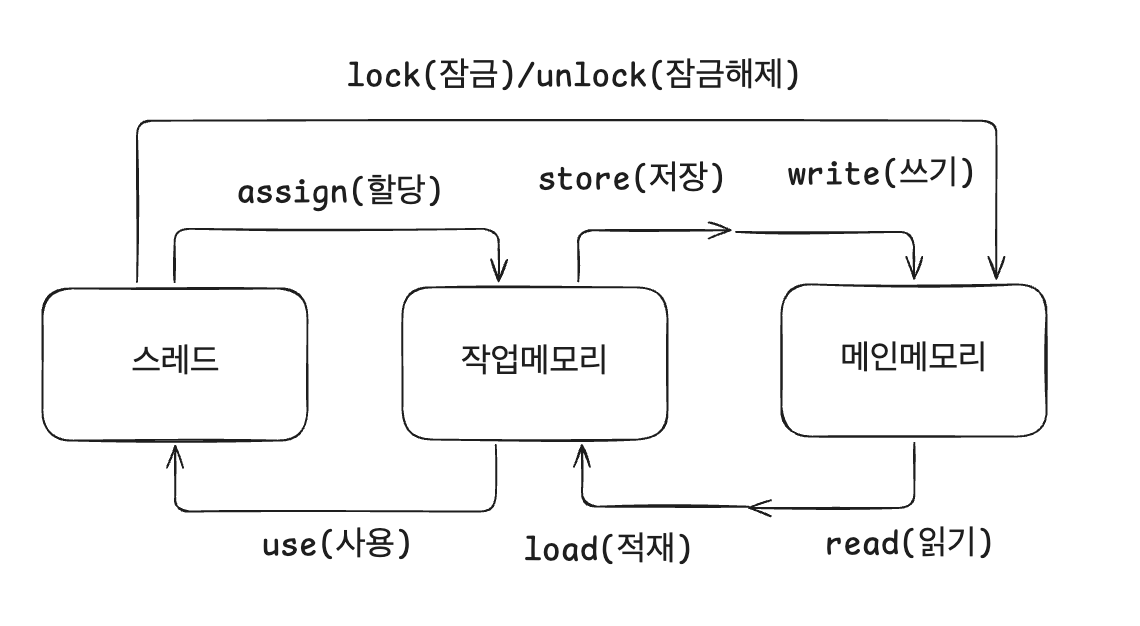
JMM 연산 규칙
위 8가지 연산을 실행할때에는 몇가지 규칙을 지켜야한다.
어떠한 프로그램의 동시성 안전을 체크하고 싶을 때 규칙들을 적용하면 확인이 가능하다.
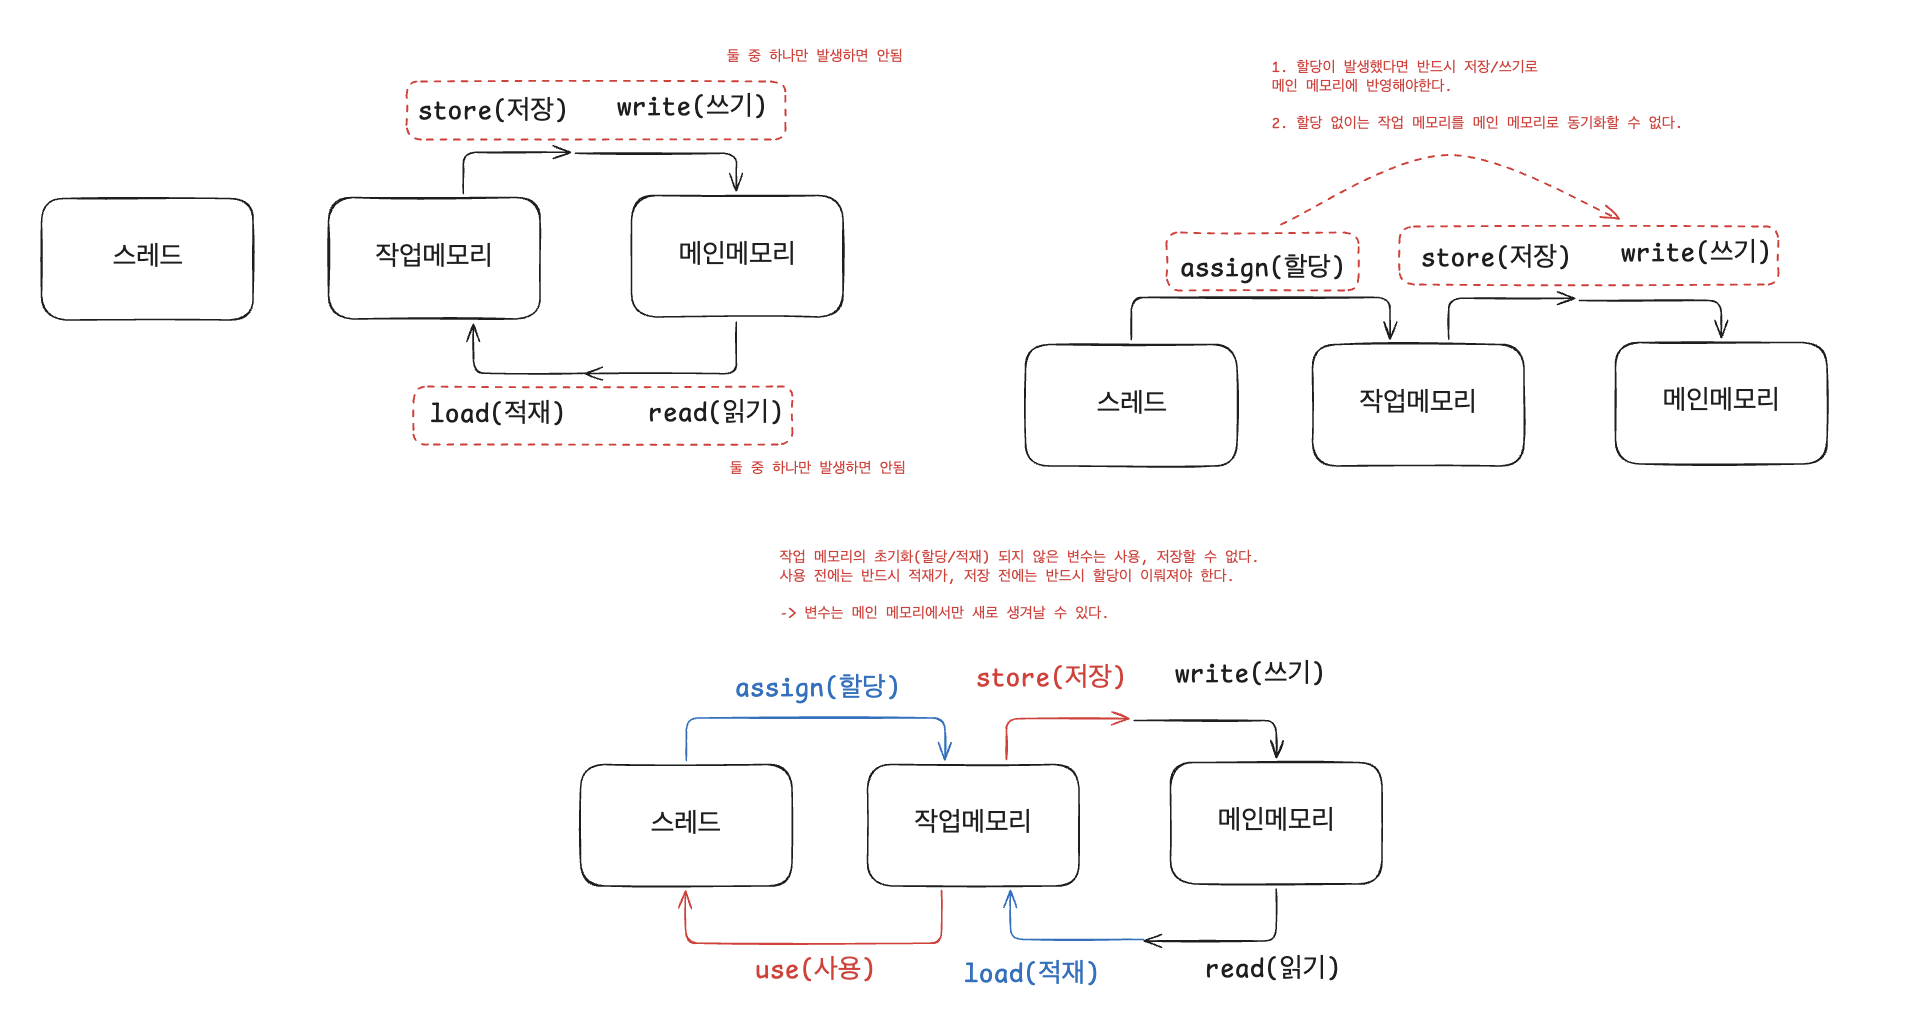
추가로 잠금 관련해서는,
- 변수는 한번에 한 스레드만 잠글 수 있다. 같은 스레드라면 n번 잠글 수 있으며, 잠금 해제를 위해 n번 해제해야 한다.
- 변수를 잠그면 작업 메모리의 변숫값은 지워진다. 변수를 사용할 때 적재 또는 할당을 다시 실행하여 작업 메모리에 값을 다시 초기화 해야 한다.
- 잠근 스레드만 잠금을 해제할 수 있다.
- 잠금을 해제하려면 작업 메모리 값을 메인 메모리에 동기화 해야 한다.(저장/쓰기)
volatile관련 규칙. (happens-before)- 작업 메모리에서 volatile 변수가 사용될 때 마다 다른 스레드에서의 변경 사항을 볼 수 있도록 메인 메모리로부터 값을 최신 값으로 고쳐야 한다.
- 작업 메모리에서 volatile 변수가 수정될 때 마다 메인 메모리로 즉시 동기화되어 다른 스레드가 변경 사항을 볼 수 있도록 보장해야 한다.
- 재정렬을 막아 프로그램에서 정의한 순서대로 실행해야 한다.
- long, double 은 64 비트 데이터타입으로, 32비트 시스템에서는 이 데이터 타입에 대한 모든 연산이 비원자적일 수 있기 때문에 보장해야 한다. 현재는 대부분의 CPU 레벨에서 이를 지원하므로 신경쓰지 않아도 된다.
Volatile
동시성에는 가시성과 원자성이라는 단위가 있다.
synchronized 키워드는 가시성과 원자성을 모두 만족시키지만 비용이 비싸다.
때로는 가시성만 필요할때가 있는데, 이 때 사용하는 것이 volatile 이다.
가시성
가시성은 공유 변수의 값을 한 스레드가 수정했다면 다른 스레드가 즉시 수정을 알 수 있느냐이다.
가시성이 깨질 수 있는 케이스는 두가지이며, 하드웨어와 가상머신 모두에서 발생할 수 있다.
공유 메모리 멀티 프로세스 시스템: 캐시, 작업 메모리에 저장한 값이 메인 메모리로 동기화 되기 전 다른 스레드/프로세스가 읽어간 경우 가시성이 깨질 수 있다.명령어 재정렬: JVM, CPU 는 결과가 같은 경우에 한해 최적화의 일환으로 명령어의 순서를 변경할 수 있다. 하지만 명령어 순서 변경에 의해 다른 스레드에서 값을 잘못 읽어가는 가시성 문제가 생길 수 있다.
JVM 가시성 문제
위처럼 가시성이 깨지는 경우 때문에, 일부 시스템은 캐시 또는 작업 메모리 개념을 사용하지 않거나 명령어 재정렬을 허용하지 않을 수 있다.
하지만 JVM 은 성능상의 이점을 위해 작업 메모리를 사용하고, JIT 의 명령어 재정렬을 허용한다.
즉, 특정 시나리오의 경우 가시성 문제가 발생할 수 있으며 Volatile 키워드를 일일히 붙여야 함을 택했다.
Java Volatile
volatile 은 위 가시성 문제를 해결하기 위한 방법이다.
volatile 은 두가지 기능이 있다.
- 모든 스레드에서 변수값을 투명하게 볼 수 있다. 이를 위해 캐시, 작업 메모리 값을 무효화해야 한다.
- 명령어 재정렬 최적화를 막는다. (happens-before 관계 성립)
가시성 문제는 가상머신(인터프리터, JIT), 하드웨어(CPU) 둘 다 발생할 수 있다고 했다.
JVM 은 여러 하드웨어의 추상화 가상 머신이다. 따라서, volatile 은 JVM 과 CPU 둘다의 가시성 만족 을 위한 구현이다.
즉, volatile 은 작업 메모리와 cpu 캐시 둘 다를 무효화 시키며, JIT 의 명령어 재정렬과 CPU 의 명령어 재정렬 둘 다를 막는다.
가상머신 레벨의 volatile
volatile 변수는 클래스 파일에서 필드 테이블에 ACC_VOLATILE 플래그 정보가 있다.
가상머신은 이 플래그가 켜져 있으면(volatile) 위 volatile 관련 규칙을 지켜야 한다.
모든 JVM 은 이 규칙을 지키도록 되어 있다.
하드웨어 레벨의 volatile
가상머신 레벨의 volatile 구현은 jvm 하나만 잘 구현되어 있으면 된다.
하지만 하드웨어는 다르다.
x86, amd, arm 등등 여러 CPU 는 각각 다른 가시성 구현을 가지고 있다.
따라서 JVM 은 volatile 변수 명령에 대한 네이티브 코드 생성시 CPU 에 따라 다르게 만들어야 한다.
따라서 volatile 이 실제로 cpu 레벨의 가시성 제어는 어떻게 되는지 알고싶다면, CPU 까지 알아야 한다.
JDK 동시성에 큰 기여를 한 Doung Lea 의 자료를 참고하면 좋다.
https://gee.cs.oswego.edu/dl/jmm/cookbook.html
매모리 재정렬을 막는 경계를 설정하는 명령을 barrier 라 한다.
베리어에는 LoadLoad, LoadStore, StoreLoad, StoreStore 네종류로 나눌 수 있으며 StoreLoad 베리어는 Store 명령과 Load 명령 사이에 들어가는 베리어 명령어로써 Store 명령어는 베리어를 넘어서 재정렬될 수 없다는 식이다.
X86
x86 CPU 는 CPU 단에서 대부분의 재정렬을 이미 막고 있다. (TSO, Total Store Order)
따라서 StoreLoad 재정렬만 막으면 된다.
다음 코드를 JIT 컴파일러는 어떤 네이티브로 해석하는지 보자
instance 변수를 volatile 로 하고 안하고를 비교해보겠다.
// double-checked-locking 코드. 대표적인 volatile 사용처
public class Singleton {
//    private static Singleton instance;
    private volatile static Singleton instance;

    public static Singleton getInstance() {
        if (instance == null) {
            synchronized (Singleton.class) {
                if (instance == null) {
                    instance = new Singleton();
                }
            }
        }
        return instance;
    }

    static void main(String[] args) {
        Singleton s = Singleton.getInstance();
        System.out.println(s);
    }
}
윈도우에서 hsdis 사용하여 테스트함.
  0x000001c53532bc1f:   movsbl 0x38(%r15),%edi
  0x000001c53532bc24:   cmp    $0x0,%edi
  0x000001c53532bc27:   jne    0x000001c53532bd82
  0x000001c53532bc2d:   mov    %rax,%r10
  0x000001c53532bc30:   shr    $0x3,%r10
  0x000001c53532bc34:   mov    %r10d,0x70(%rsi)
  0x000001c53532bc38:   mov    %rsi,%rdi
  0x000001c53532bc3b:   xor    %rax,%rdi
  0x000001c53532bc3e:   shr    $0x15,%rdi
  0x000001c53532bc42:   cmp    $0x0,%rdi
  0x000001c53532bc46:   jne    0x000001c53532bda1           ;*putstatic instance {reexecute=0 rethrow=0 return_oop=0}
                                                            ; - Singleton2::getInstance@24 (line 9)
위는 volatile 이 아닐때의 일부다.
  0x000001f7c9fb3f1f:   movsbl 0x38(%r15),%edi
  0x000001f7c9fb3f24:   cmp    $0x0,%edi
  0x000001f7c9fb3f27:   jne    0x000001f7c9fb4088
  0x000001f7c9fb3f2d:   mov    %rax,%r10
  0x000001f7c9fb3f30:   shr    $0x3,%r10
  0x000001f7c9fb3f34:   mov    %r10d,0x70(%rsi)
  0x000001f7c9fb3f38:   lock addl $0x0,-0x40(%rsp) // 추가됨
  0x000001f7c9fb3f3e:   mov    %rsi,%rdi
  0x000001f7c9fb3f41:   xor    %rax,%rdi
  0x000001f7c9fb3f44:   shr    $0x15,%rdi
  0x000001f7c9fb3f48:   cmp    $0x0,%rdi
  0x000001f7c9fb3f4c:   jne    0x000001f7c9fb40a7           ;*putstatic instance {reexecute=0 rethrow=0 return_oop=0}
                                                            ; - Singleton::getInstance@24 (line 9)
위는 volatile 일때의 일부다.
보다시피 volatile 일 때에는 lock addl $0x0,-0x40(%rsp) 네이티브 명령이 변수값 할당 후 추가된다.
lock 접두어는 IA32 메뉴얼상 캐시(정확하게는 store buffer)를 메인 메모리에 쓰는 기능을 하며 이 쓰기는 다른 프로세서가 자신의 캐시를 무효화하게 한다.
이 명령어가 끝나기 전에 캐시의 값을 메모리에 모두 쓰는 것을 보장하므로, 다른 스레드에서는 변수의 수정된 값을 투명하게 볼 수 있다. (과거 값을 보는게 불가능하다)
또한 의미상 lock 은 캐시에 들어있는 이전의 쓰기 연산을 모두 메모리에 반영 함으로서 관측 가능하게 한다는 의미이기 때문에, 이를 재정렬해버리면 다른 스레드에서의 관측 결과를 달라지게 할 수 있다. 따라서 lock 이 캐시의 명령을 모두 메모리에 동기화하는 것이 명령어 재정렬은 lock(베리어) 를 넘을 수 없다는 효과 또한 발생시키게 된다.
lock 명령 하나로 두마리 토끼를 잡을 수 있는 것이다.
뒤의 addl $0x0,-0x40(%rsp) 는 별 의미 없는 코드다. 필요한건 lock 뿐이다. 다만 lock 이 쓰기 연산에만 붙을 수 있는 접두어라 한다.
cpu 는 의미(sementic) 이 바뀌지 않는 내에서 재정렬할 수 있다.
arm
arm 에서 위 코드를 실행해보면 dmb(Data Memory Barrier) 가 추가됨을 알 수 있다.
  0x000000010e0caf3c:   cbnz	x0, 0x000000010e0cb164      ;*monitorenter {reexecute=0 rethrow=0 return_oop=0}
                                                            ; - Singleton::getInstance@10 (line 7)
  0x000000010e0caf40:   mov	x3, #0x8ea0                	// #36512
                                                            ;   {oop(a 'java/lang/Class'{0x000000043f818ea0} = 'Singleton')}
  0x000000010e0caf44:   movk	x3, #0x3f81, lsl #16
  0x000000010e0caf48:   movk	x3, #0x4, lsl #32
  0x000000010e0caf4c:   ldr	w3, [x3, #112]
  0x000000010e0caf50:   lsl	x3, x3, #3                  ;*getstatic instance {reexecute=0 rethrow=0 return_oop=0}
                                                            ; - Singleton::getInstance@11 (line 8)
위는 volatile 없을 때
  0x000000010ee8af44:   cbnz	x0, 0x000000010ee8b184      ;*monitorenter {reexecute=0 rethrow=0 return_oop=0}
                                                            ; - Singleton::getInstance@10 (line 7)
  0x000000010ee8af48:   mov	x3, #0x8ea0                	// #36512
                                                            ;   {oop(a 'java/lang/Class'{0x000000043f818ea0} = 'Singleton')}
  0x000000010ee8af4c:   movk	x3, #0x3f81, lsl #16
  0x000000010ee8af50:   movk	x3, #0x4, lsl #32
  0x000000010ee8af54:   dmb	ish
  0x000000010ee8af58:   ldr	w3, [x3, #112]
  0x000000010ee8af5c:   lsl	x3, x3, #3
  0x000000010ee8af60:   dmb	ishld                       ;*getstatic instance {reexecute=0 rethrow=0 return_oop=0}
                                                            ; - Singleton::getInstance@11 (line 8)
위는 volatile 있을 때
volatile 은 원자성을 만족시키지 않는다.
public volatile int count = 0;

public add() {
	count++;
}
위 add() 메서드는 volatile 변수를 증가시키는게 다이다.
하지만 이 메서드는 동시성 안전하지 않다.
volatile 은 원자성을 만족시키지 않기 때문이다.
count++ 는 실제로 하나의 명령어가 아니라 여러개의 바이트 코드, 더 여러개의 네이티브 코드로 쪼개진다.
cpu 는 이 여러개의 명령어를 원자적으로 실행하지 않으므로 동시성 문제가 발생할 수 있다.
따라서 volatile 은 사용처를 잘 보고 사용해야 한다.
volatile 을 언제 써야 하는가?
기본적으로 volatile 이 synchronized 보다 성능이 좋다.
volatile 은 아래 두 조건이 모두 만족해야 한다.
아닐때에는 synchronized 를 쓰도록 한다.
- write 할 값이 write 이전 값과 관계가 없다. (싱글 스레드 동작이 보장된다면 상관없음)
- 기존 값을 읽어서 기존 값 기반으로 바뀐 값을 write 하면 안된다는 이야기다. - 다른 상태 변수와 관련한 불변성 제약 조건에 관여하지 않는다.
두번째 조건은 다음 예와 같다.
원자적이지 않으므로 다른 변수와의 불변성 제약조건이 깨질 위험이 있다.volatile int lower; volatile int upper; // 메서드가 원자성이 없으므로 (5, 5) -> (10, 10) 으로 변경시 (10, 5) 시점에 읽으면 예외가 날 수 있다. void set(int l, int u) { lower = l; upper = u; } void check() { if (l > u) throw new Exception(); // 불변성 제약조건 }
대표적인 사용처는 flag 값으로 쓰일때가 있다.
volatile boolean shoutdown;

public void shutdouwn() {
	this.shoutdown = true;
}

public void doWork() {
	while(!shutdown) {
    	...
    }
}
synchronized
synchronyzied 는 동기화 블록을 만든다.
이 블록은 가시성, 원자성을 모두 만족한다.
- 원자성 : monitorenter, monitorexeit 바이트 코드 명령어로 확보됨
- 가시성 : JMM 규칙 중
변수의 잠금을 해제하기 전 변수의 값을 메인 메모리로 다시 동기화해야 함에 의해 확보됨
동시성의 3요소
- 가시성 : volatile, synchronized 둘 다 만족
- 원자성 : synchronized 만 만족
- 실행 순서 : volatile, synchronized 둘 다 만족
선 발생 원칙
먼저 작성된 프로그램의 코드는 무조건 뒤에 작성된 코드에서 볼 수 있을까?
먼저 실행된 코드의 결과는 무조건 뒤에 실행된 코드에서 볼 수 있을까?
아니다. 먼저 실행 되더라도 재정렬 및 캐시 구조때문에 그렇지 않다.
B 가 수행되기 전에 A 에서 수행한 결과를 B 에서 관찰할 수 있다면 A 는 B 보다 선발생 했다고 한다. 실행이 아닌 수행임을 주의하자. 먼저 실행되더라도 나중에 수행되어 볼 수 없을 수 있다는 이야기다.
자바는 volatile, synchronized 를 쓰지 않더라도 기본적으로 보장해주는 것들이 있다.
동시성 문제를 분석할 때에는 이를 참고해야 한다.
- 프로그램 순서 규칙 : 한 스레드 안에서는 제어 흐름(분기, 순환문 등등) 순서에 따라 앞의 연산이 뒤따르는 연산보다 선 발생한다. 코드 순서가 아니다.
- 모니터 락 규칙 : 같은 락에 대한 시간적으로 먼저인 잠금 해제는 잠금 보다 선 발생한다.
- 휘발성 변수 규칙 : volatile 시간적으로 먼저인 변수 쓰기는 같은 변수에 대한 읽기 연산보다 선 발생한다.
- 스레드 시작 규칙 : Thread.start() 는 해당 스레드의 어떤 작업보다 선 발생한다.
- 스레드 종료 규칙 : 스레드의 모든 작업은 스레드 종료보다 먼저 발생한다.
- 스레드 인터럽트 규칙 : Thread.interrupt() 호출은 인터럽트되는 스레드의 인터럽트 이벤트 발생 감지보다 선 발생한다.
- 종료자 규칙 : 객체 초기화(생성자)는 finalize() 시작보다 선 발생한다.
- 전이성 : A 보다 B 가 선 발생하고, B 보다 C 가 선 발생하면 A 보다 C 가 선 발생한다.
모니터 락 규칙
// Thread A
synchronized (lock) { x = 42; } // unlock
// Thread B
synchronized (lock) { System.out.println(x); }라면 B 의 출력은 반드시 42 이다.
이 보장이 없다면 이전 값을 출력할 수 있다. synchronized
를 보장하는 규칙이라할 수 있다.
무조건 시간상 먼저 발생하는 작업이 선 작업을 의미하지 않는다는 것이다.
그걸 만족하는건 위 케이스밖에 없다.
참고
https://gee.cs.oswego.edu/dl/jmm/cookbook.html
https://chriswhocodes.com/hsdis/
논문 A Volatile-by-Default JVM for Server Applications
https://www.cs.umd.edu/~pugh/java/memoryModel/jsr-133-faq.html
https://www.cs.umd.edu/users/pugh/java/memoryModel/
https://www.cs.umd.edu/~pugh/java/memoryModel/DoubleCheckedLocking.html
https://velog.io/@hmcck27/Double-Checked-Locking
논문 Specifying Multithreaded Java Semantics for
Program Verification