인덱스 설계와 실행 계획 분석
1. 피드 페이징 조회 (activity_records)
특정 취미의 활동 기록을 최신순으로 페이징 조회하는 API입니다.
SELECT ar1_0.activity_record_id, ar1_0.sticker
FROM activity_records ar1_0
WHERE ar1_0.user_hobby_id = ? AND ar1_0.user_id = ?
ORDER BY ar1_0.created_at DESC
LIMIT ?, ?
AS-IS
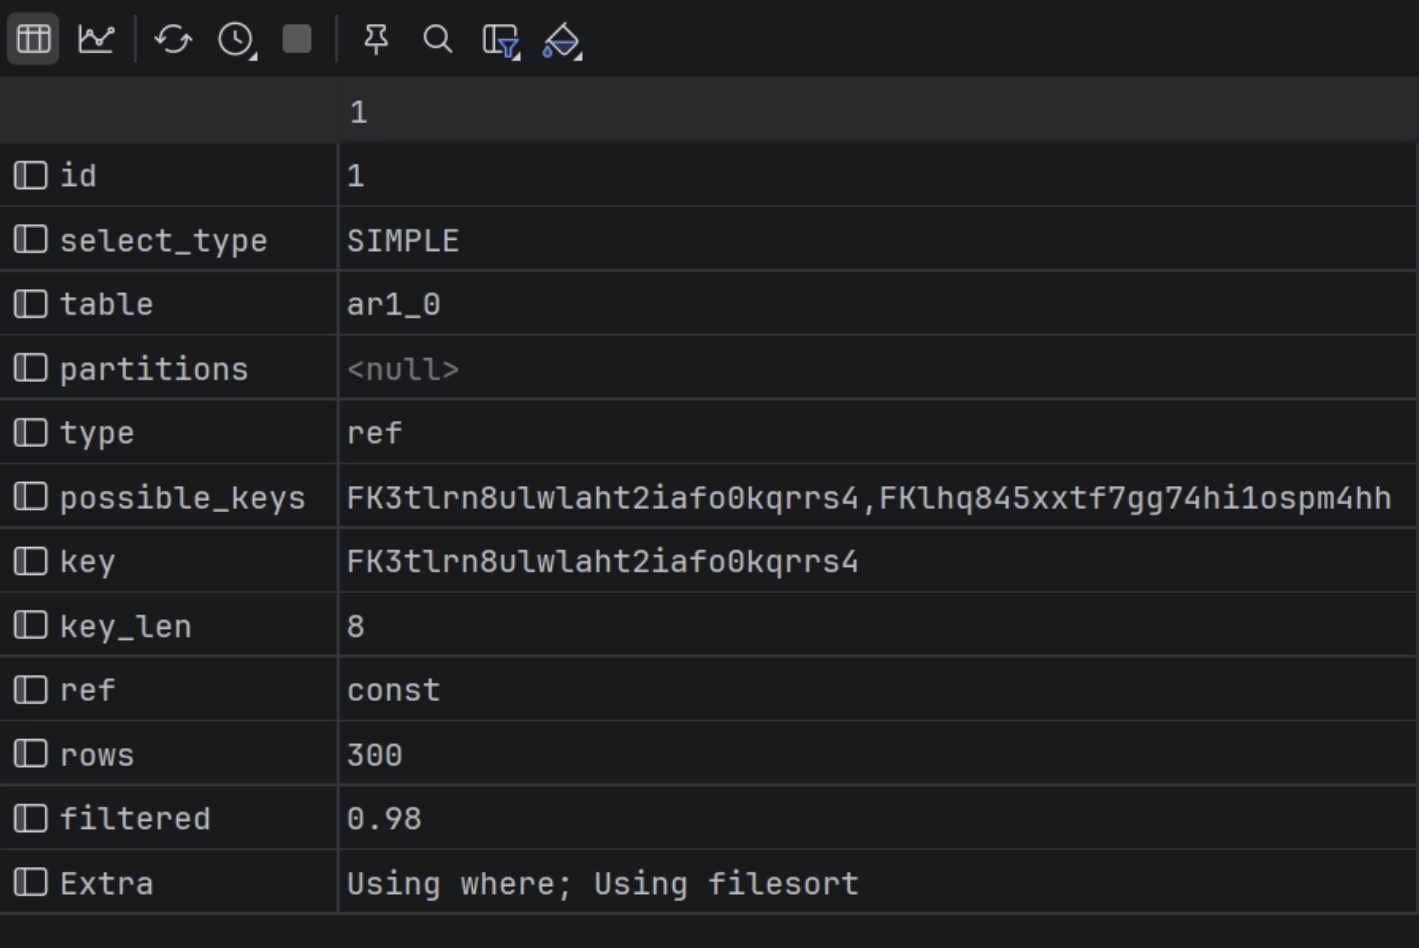
-> Limit: 10 row(s)  (cost=279 rows=10) (actual time=3.85..3.86 rows=10 loops=1)
    -> Sort: ar1_0.created_at DESC, limit input to 10 row(s) per chunk  (cost=279 rows=300) (actual time=3.85..3.85 rows=10 loops=1)
        -> Filter: (ar1_0.user_id = 'user_1')  (cost=279 rows=300) (actual time=1.38..3.69 rows=300 loops=1)
            -> Index lookup on ar1_0 using FK3tlrn8ulwlaht2iafo0kqrrs4 (user_hobby_id=1)  (cost=279 rows=300) (actual time=1.37..3.61 rows=300 loops=1)
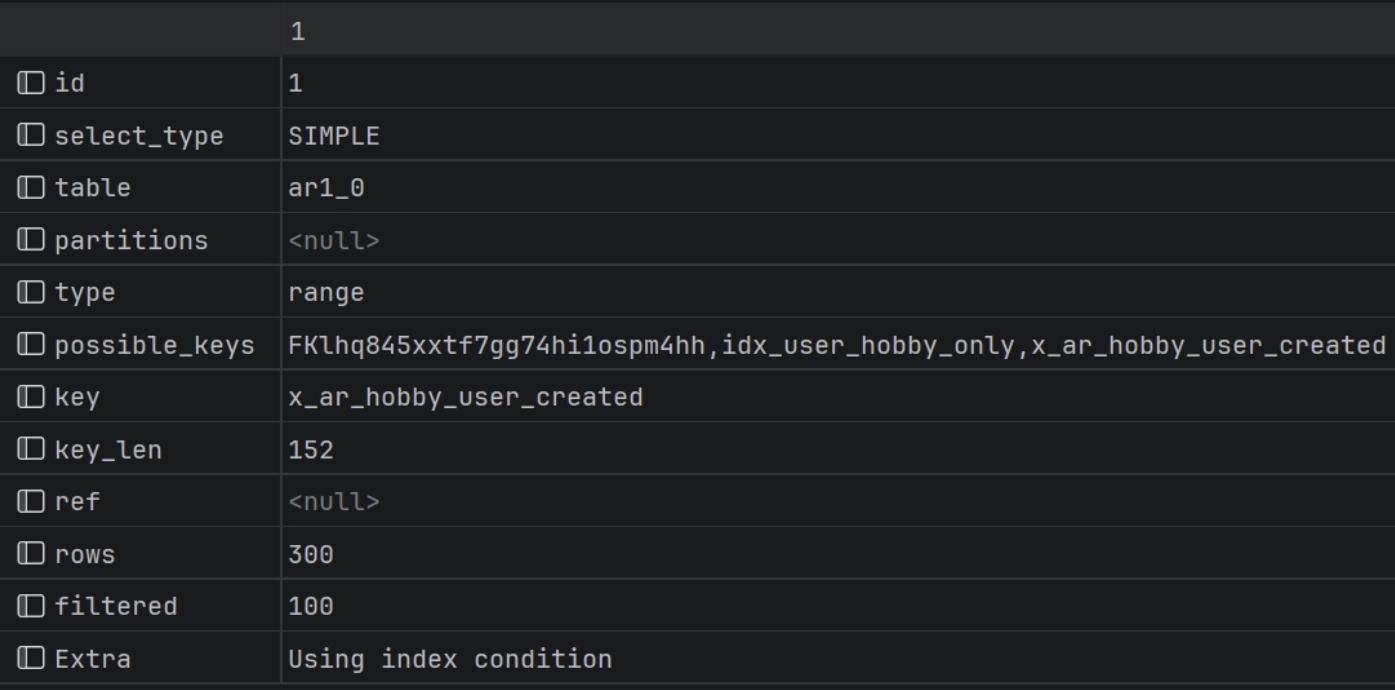
-> Limit: 10 row(s)  (cost=33649 rows=10) (actual time=0.152..0.156 rows=10 loops=1)
    -> Index range scan on ar1_0 using x_ar_hobby_user_created over (user_hobby_id = 1 AND user_id = 'user_1'), with index condition: ((ar1_0.user_id = 'user_1') and (ar1_0.user_hobby_id = 1))  (cost=33649 rows=300) (actual time=0.151..0.154 rows=10 loops=1)
실행 계획을 먼저 봤습니다. EXPLAIN을 돌려보니 possible_keys는 2개인데 실제 key는 하나(user_hobby_id 단일 인덱스)만 타고 있었고, Extra에 Using where; Using filesort가 붙어 있었습니다. rows는 300, filtered는 0.98(98%)로, 인덱스로 걸러진 후보 300건이 거의 그대로 다음 단계로 넘어간다는 뜻이었습니다.
EXPLAIN ANALYZE로 단계를 더 뜯어보니 흐름이 이랬습니다.
Index lookup—user_hobby_id=1조건만 인덱스로 타서 후보 300건을 가져옴 (약 2.2ms)Filter— 가져온 300건 중user_id='user_1'을 메모리에서 검사 → 300건 그대로 통과 (거의 안 걸러짐)Sort—created_at DESC정렬을 위해 300건 전체를 정렬한 뒤 상위 10건만 반환
병목은 명확했습니다. 인덱스가 user_hobby_id까지만 좁혀줄 뿐, user_id 조건과 정렬 조건은 전혀 커버하지 못하고 있었습니다. 특히 LIMIT 10이 있어도 정렬 대상 자체가 300건이라, 데이터가 커질수록 이 Sort 비용이 급격히 커질 구조였습니다.
해결은 조건 컬럼과 정렬 컬럼을 모두 포함한 복합 인덱스였습니다.
CREATE INDEX idx_ar_user_hobby_created
ON activity_records (user_hobby_id, user_id, created_at DESC);
적용 후 EXPLAIN에서 type=range, key가 복합 인덱스로, filtered=100으로 바뀌었고, Extra는 Using index condition(ICP)만 남았습니다. EXPLAIN ANALYZE로도 확인해보니 Index range scan이 user_hobby_id=1 AND user_id='user_1' 조건을 인덱스 단계에서 바로 처리했고, Sort 단계 자체가 사라졌습니다.
| 지표 | AS-IS | TO-BE |
|---|---|---|
| 실행 단계 | Index lookup → Filter → Sort | Index range scan (1단계) |
| 읽은 행 수 | 300건 | 10건 |
| 응답 시간 | 3.86ms | 0.156ms |
개선 이유는 세 가지였습니다.
- 조건 두 개(
user_hobby_id,user_id)가 인덱스 탐색 단계에서 한 번에 좁혀져 Filter가 사실상 필요 없어짐 - 인덱스 마지막 컬럼이
created_at DESC라, 인덱스를 읽는 순서가 곧 정렬 순서가 되어 Sort가 제거됨 - 정렬이 이미 끝난 상태라
LIMIT 10에 도달하는 즉시 탐색을 멈출 수 있어(early stop), 나머지 290건을 읽을 필요가 없어짐
결과적으로 3.86ms → 0.156ms, 약 24.7배 빨라졌습니다. 이 케이스로 확인한 건 "인덱스가 조건을 걸러줘도, 정렬까지 커버하지 못하면 filesort가 진짜 비용을 만든다"는 점이었습니다.
2. 홈 대시보드 조회 (user_hobbies)
사용자의 진행 중인 취미 목록을 최신순으로 보여주는 조회입니다.
SELECT user_hobby_id, hobby_name, hobby_time_minutes, execution_count,
       goal_days, cover_image_url, created_at, status
FROM user_hobbies
WHERE user_id = 'user_1' AND status = 'IN_PROGRESS'
ORDER BY created_at DESC;
AS-IS
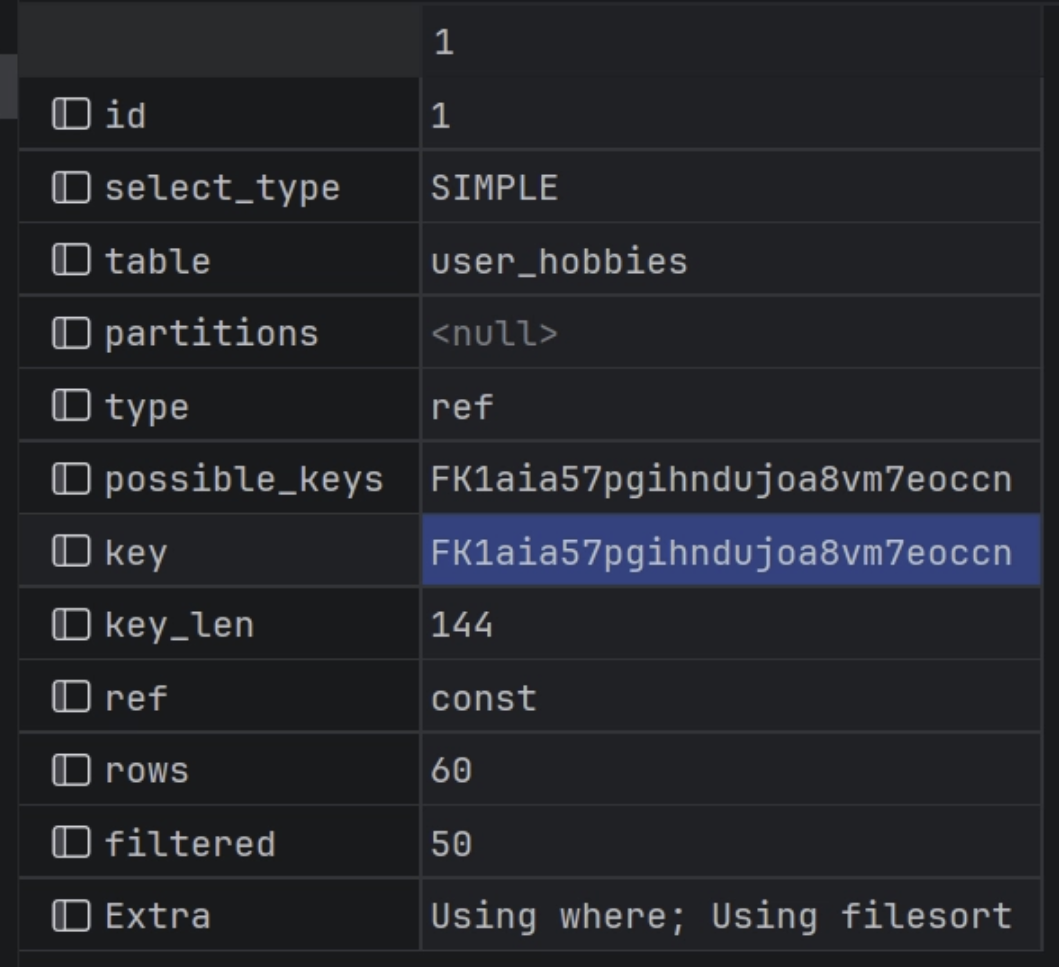
-> Sort: user_hobbies.created_at DESC  (cost=62.4 rows=60) (actual time=2.31..2.31 rows=4 loops=1)
    -> Filter: (user_hobbies.`status` = 'IN_PROGRESS')  (cost=62.4 rows=60) (actual time=1.91..2.25 rows=4 loops=1)
        -> Index lookup on user_hobbies using FK1aia57pgihndujoa8vm7eoccn (user_id='user_1')  (cost=62.4 rows=60) (actual time=1.03..2.23 rows=60 loops=1)
TO-BE
-> Index lookup on user_hobbies using idx_hobby_user_status_created (user_id='user_1', status='IN_PROGRESS')
(cost=4.37 rows=4) (actual time=2.11..2.12 rows=4 loops=1)
여기서도 먼저 실행 계획을 확인했습니다. key는 user_id 단일 외래키 인덱스였고, rows=60, filtered=50, Extra는 Using where; Using filesort였습니다. 그런데 EXPLAIN ANALYZE로 실제 반환 행을 보니 최종적으로는 4건뿐이었습니다. 즉 옵티마이저는 "60건 중 50%(30건) 정도는 통과하겠지" 예측했지만, 실제로는 4건만 조건을 만족하는 상황이었습니다.
원인을 짚어보니, 인덱스가 user_id만 걸러줄 뿐 status는 걸러주지 못하는 구조였습니다. 해당 유저의 ARCHIVED 등 다른 상태를 포함한 취미 60개를 전부 인덱스로 읽어온 뒤, status='IN_PROGRESS'는 메모리에서 하나씩 검사해 4건만 골라내고 있었습니다. 여기에 created_at DESC 정렬까지 별도로 수행하고 있었고요.
조건과 정렬 컬럼을 모두 포함하는 복합 인덱스로 다시 설계했습니다.
CREATE INDEX idx_hobby_user_status_created
ON user_hobbies (user_id, status, created_at DESC);
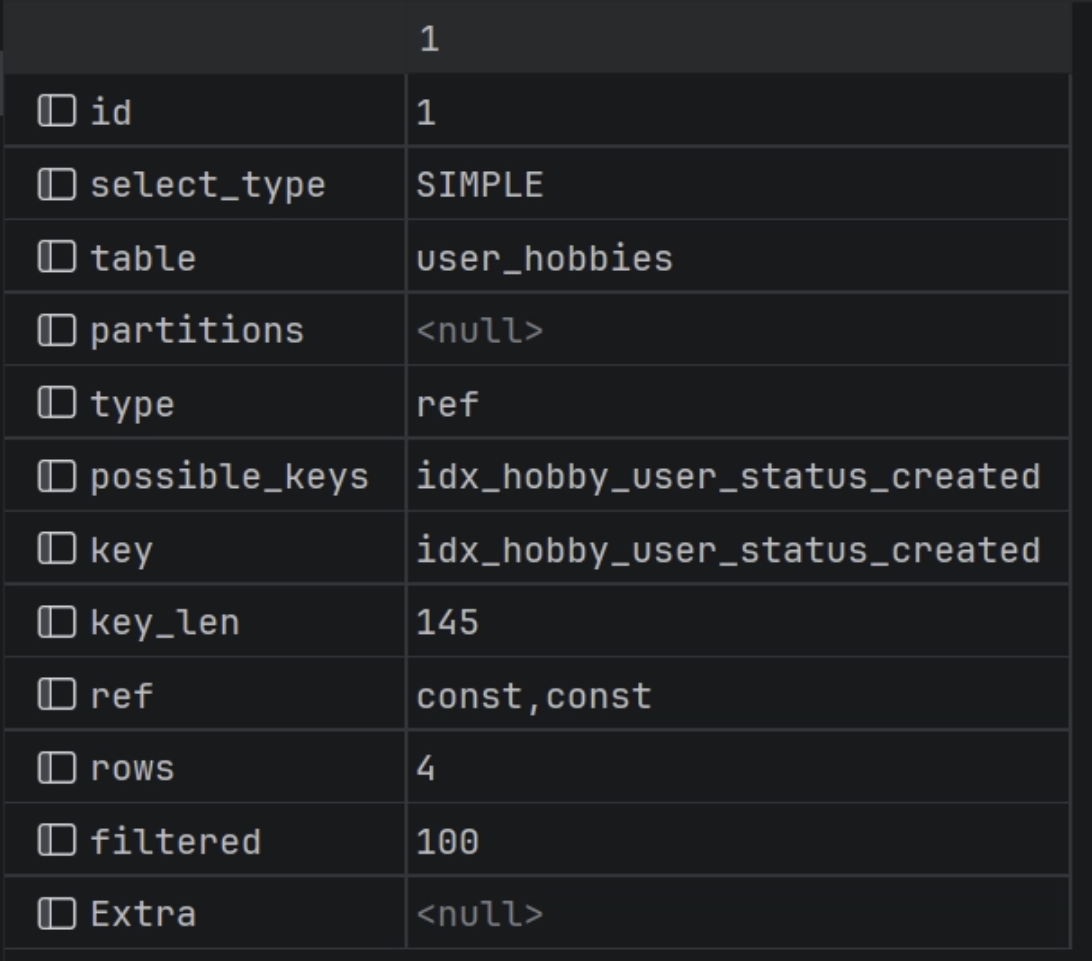
적용 후에는 key가 복합 인덱스로 바뀌고, rows=4, filtered=100, Extra는 비어 있는(별도 처리 없음) 상태가 됐습니다.
| 지표 | AS-IS | TO-BE |
|---|---|---|
| 검사한 행 수 | 60건 | 4건 |
| Filtered(정확도) | 50% | 100% |
| Extra | Using where; Using filesort | (없음) |
| 옵티마이저 비용 | 62.4 | 4.37 |
개선 포인트는 세 가지로 정리됩니다.
user_id와status를 인덱스 탐색 단계에서 동시에 조건으로 사용해, 필요 없는 56건을 애초에 읽지 않게 됨- 인덱스 마지막 컬럼이
created_at이라 정렬이 인덱스 순서에 이미 반영되어 있어 filesort가 제거됨 - filtered가 100%가 됐다는 건, 인덱스로 찾은 결과가 곧 최종 응답이라는 뜻 — 불필요하게 읽고 버리는 행이 없어짐
이 케이스에서는 "인덱스가 조건 하나만 커버하면, 나머지 조건은 다 읽어온 후에야 걸러진다"는 걸 실행 계획으로 직접 확인하고, 조건 전체를 인덱스에 태우는 방향으로 설계를 바꿨습니다.