한끼모아에는 사용자에게 식당을 추천해주는 기능이 있다. 본격적인 개발에 앞서 제안 발표를 준비하며 추천 알고리즘을 어떻게 구현할지 계획해야 했는데, 이에 대한 지식이 전무하다보니 아무리 고민해보아도 제대로 된 방향으로 계획을 세운 것인지 알 수 없었다. 따라서 같이 프로젝트를 하는 팀원과 함께 스터디를 기획하여 추천 알고리즘을 공부해보기로 했다.
💡 영화에 대한 사용자 평점 데이터를 기반으로 기본적인 추천 시스템을 구현해본다.
✅ Best-Seller 제품 추천
사용자 정보가 많지 않은 경우 사용하는 방식으로, 영화의 평점 평균을 구해 상위 n개를 가져온다.
#인기 제품 추천 방식
def recom_movie(n_items):
    movie_mean = ratings.groupby(['movie_id'])['rating'].mean()
    movie_sort = movie_mean.sort_values(ascending=False)[:n_items]
    recom_movies = movies.loc[movie_sort.index]
    recommendations = recom_movies['title']
    return recommendations

recom_movie(5)- movie_mean : 각 영화의 평점 평균을 구해서 영화별로 그룹핑
- movie_sort : 영화별로 평점 평균을 내림차순, n_items 개수만큼 그룹핑
- recom_movies : 상위 n_items의 정보를 movie_id를 기준으로 가져옴
RMSE(Root Mean Squared Error) 정확도 측정
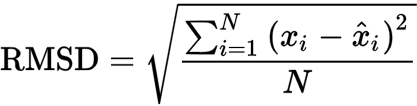
예측값과 실제값 사이의 오차를 구한다. 값이 작을수록 정확도가 높다.
# 100K의 영화 평점에 대해서 실제값과 best-seller 방식으로 구한 예측값의 RMSE 계산하는 코드
import numpy as np

def RMSE(y_true, y_pred) :
    return np.sqrt(np.mean((np.array(y_true) - np.array(y_pred)) ** 2))

# 정확도 계산
rmse = []
movie_mean = ratings.groupby(['movie_id'])['rating'].mean()

for user in set(ratings.index):
    y_true = ratings.loc[user]['rating']
    # best-seller 방식으로
    y_pred = movie_mean[ratings.loc[user]['movie_id']]
    accuracy = RMSE(y_true, y_pred)
    rmse.append(accuracy)

# RMSE 계산
print(np.mean(rmse))
→ 0.996007224010567
✅ 사용자 집단 추천
Feature, Label
- feature(입력값) : 예측하기 위한 단서 ex) 나이, 연봉, 학력
- label(정답값) : 예측하고 싶은 대상 ex) 구매 여부
- ex) 나이를 보고 이 사람이 이 물건 구매할지를 예측할 수 있음
Train, Test 데이터 분리
모델이 새로운 데이터에도 잘 동작하는지 확인하기 위해 데이터를 train/test로 나눈다.
# 데이터 train, test set 분리
from sklearn.model_selection import train_test_split
import numpy as np
x = ratings.copy()
y = ratings['user_id']

x_train,x_test,y_train,y_test = train_test_split(x,y,
                                                 test_size=0.25,
                                                 stratify=y)
- train set : 모델이 정답을 보면서 학습하는 데이터
- test set : 학습 후, 정답을 안 보여주고 예측하게 해보는 데이터
- stratify : 데이터 train/test로 나눌 때 특정 열의 비율을 그대로 유지하도록 도와주는 옵션
- y 변수가 stratify 기준값으로 사용된다.
- ex) user_id = 1 인 유저의 데이터가 20% 존재하면, train/test 데이터에도 동일한 비율로 나뉜다.
Best-Seller 모델 정의
영화에 대한 사용자 평점을 예측하는 best-seller 모델을 정의한다.
# best_seller 함수를 이용한 정확도 계산
train_mean = x_train.groupby(['movie_id'])['rating'].mean()
def best_seller(user_id,movie_id):
  try:
    rating = train_mean[movie_id]

  except:
    rating = 3.0
return rating- train_mean : train set으로 구한 영화별 평점 평균 데이터
- movie_id가 존재하면 해당 평점을 반환하고, 존재하지 않으면 기본값인 3.0을 반환한다.
사용자 정보에 대한 고려없이 모든 사용자에게 똑같은 예측값을 준다. 이후 사용자 정보를 고려한 모델들과 비교하는 기준선 역할로 자주 사용된다.
정확도(RMSE) 계산하는 함수 정의
# 정확도(RMSE)를 계산하는 함수
def RMSE(y_true,y_pred):
  return np.sqrt(np.mean((np.array(y_true) - np.array(y_pred))**2))

# 모델별 RMSE를 계산하는 함수
def score(model):
  id_pairs = zip(x_test['user_id'],x_test['movie_id'])
  y_pred = np.array([model(user,movie) for (user,movie) in id_pairs])
  y_true = np.array(x_test['rating'])
  return RMSE(y_true,y_pred)
→ 1.0245691123628893
train/test로 데이터를 구분했을 때 이전보다(0.996007224010567) 정확도가 더 낮아진걸 확인할 수 있다.
성별에 따라 영화 평점 예측
# 성별에 따른 예측값 계산
merged_ratings = pd.merge(x_train,users)

users = users.set_index('user_id')

g_mean = merged_ratings[['movie_id','sex','rating']].groupby(['movie_id','sex'])['rating'].mean()

rating_matrix = x_train.pivot(index='user_id',
                              columns='movie_id',
values='rating')- g_mean : movie_id, sex 값으로 구한 영화 평점 평균
- pivot() : 사용자-아이템 행렬 생성
user_id movie_1 movie_2 movie_3 1 4.0 NaN 3.5 2 NaN 2.5 4.0
성별 기준으로 영화 평점 예측하는 모델 정의
g_mean 값을 사용해 성별을 기준으로 영화 평점을 예측한다.
# Gender 기준 추천
def cf_gender(user_id,movie_id):
  if movie_id in rating_matrix.columns:
    gender = users.loc[user_id]['sex']
    if gender in g_mean[movie_id].index:
      gender_rating = g_mean[movie_id][gender]
    else:
      gender_rating = 3.0
  else:
    gender_rating = 3.0
  return gender_rating
score(cf_gender)
✅ Best-Seller vs cf_gender 모델 정확도 비교
| 모델 이름 | RMSE (Root Mean Squared Error) |
|---|---|
| Best-Seller | 1.0245691123628893 |
| cf_gender | 1.033147436361369 |
단순히 성별 기준 모델에서는 성별이 영화 평점 예측에 큰 영향을 주지 않는 것으로 나타났다. 하지만 성별이 다른 변수와 상호작용할 가능성도 크기 때문에 좀 더 정교한 분석이 필요하다.
참고 강의
Python을 이용한 개인화 추천시스템
다른 변수들로도 테스트해주세요 교수님