03. 확률과 확률분포 (이어서)
- 확률 변수
어떤 확률 실험이나 상황에서 발생할 수 있는 각각의 결과를 수치적 값으로 표현하는 변수
확률변수는 정의역(domain) = 표본공간, 치역(range) = 실수값예시) 동전 던지기
동전 3개 던지기 표본 공간- 표본 공간 = { 앞앞앞, 앞앞뒤, 앞뒤앞, 뒤앞앞, 앞뒤뒤, 뒤앞뒤, 뒤뒤앞, 뒤뒤뒤)
- 앞면이 나오는 개수가 Y인 경우, Y가 가질 수 있는 수치적 값은?
0개 : 뒤뒤뒤
1개 : 앞뒤뒤, 뒤앞뒤, 뒤뒤앞
2개 : 앞앞뒤, 앞뒤앞, 뒤앞앞
3개 : 앞앞앞
▶️표본 공간의 값들이 수치적으로 표현됨! Y가 확률변수
<핵심개념>
확률 변수는 표본 공간에 있는 모든 원소들을 수치적 값(실수)으로 만드는 함수이다.
확률 함수는 확률 변수로 만든 수치적 값을 넣으면 0~1사이의 확률이 나오게 만들어 주는 함수
결과들로 만든 수치는 1) 이산형 2) 연속형 두 가지!
- 확률 분포
확률 변수가 특정 값들을 가질 확률을 나타내는 함수 또는 규칙
즉, 확률이 만들어지는 '확률 함수'가 그리는 패턴이 확률 분포!
분포를 보면 수치, 데이터의 비교 및 판단이 가능하다!
(어떤 분포들이 있는지, 각각 분포들의 특징알아 두기!)
▶️ 이산 확률 분포 (확률 질량 함수)
- 확률 변수를 셀 수 있는 경우!
- 베르누이 분포 : 확률 변수가 0 또는 1만 갖는 분포
- 기하 분포 : 성공 확률이 p인 베르누이 시행에서 첫 성공이 있기까지 k번 실패할 확률 첫 성공이 일어나기 위해 필요한 횟수
- ⭐ 이항 분포 : n번의 베르누이 시행(성공(1) 또는 실패(0))에서 k번 성공할 확률의 분포, 확률 변수가 0~n을 갖는다. 이때 확률을 구해주는 함수가 그리는 패턴이 이항 분포이다.
- 다항 분포 : 이항 분포의 확장 개념. n번의 시행에서 각 시행이 3개 이상의 결과를 가질 수 있는 확률 분포
- ⭐ 포아송 분포 : 단위 시간/공간에서 특정 사건이 몇 번 발생하는지(발생 횟수)에 따른 확률 분포
▶️ 연속 확률 분포 (확률 밀도 함수) -> 셀 수 없음!
-
균일 분포(일양 분포, Uniform Distribition)
모든 확률 변수가 균일한 확률을 가지는 분포
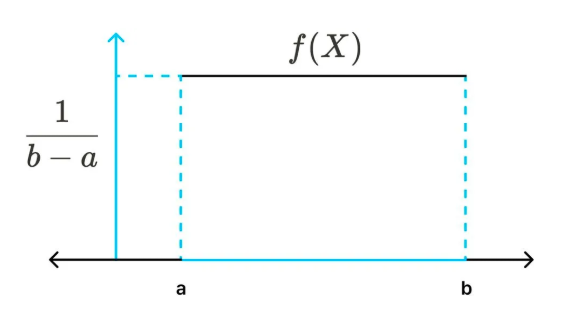
전체확률 1 = (b-a)*(1/(b-a)) -
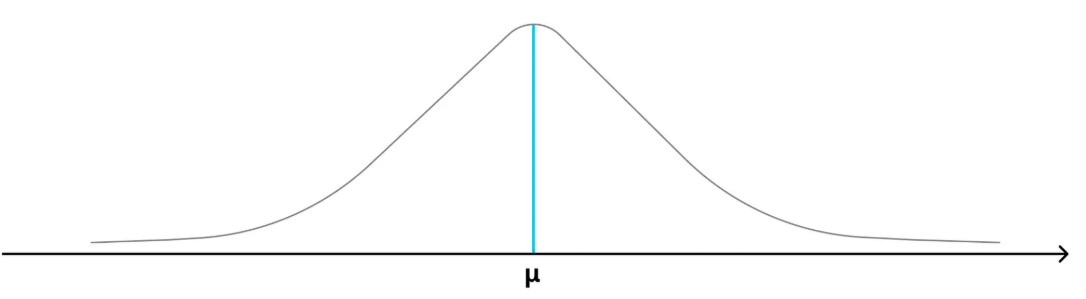
⭐ 정규 분포(Normal Distribution)
평균이 μ 이고, 표준편차가 σ 인 분포
정규 확률 변수는 수치의 범위가 무한대에서 무한대임
이러한 수치를 가능성을 보기 위해서 정규 확률 함수를 통해 확률로 바꿔야함.
-
표준 정규 분포 : 정규 분포끼리 비교하기 위해서 표준화한 분포로, 평균이 0, 분산이 1인 분포도
- t-분포 (t-Distribution)
표본으로부터 모집단의 평균에 대한 추정을 할 때 사용되는 분포
표준정규분포와 같이 평균이 0인 대칭적인 분포
정규분포와 유사 but, 적은 표본으로부터 얻은 통계량의 분포를 더 정확하게 나타낸다
두 집단의 평균이 동일한지 알고자 할 때, 검정통계량으로 활용됨
표본이 커져서 자유도가 증가하면 표준정규분포와 거의 같은 분포가 됨
자유도란?
표본자료들이 모집단에 대한 정보를 주는 독립적인 자료의 개수를 의미한다. 예를 들어 사탕 4개와 사람 4명이 있을 때 앞의 3명까지는 원하는 사탕을 선택할 수 있다. 하지만 마지막 사람은 선택권이 없기 때문에 남은 사탕을 가져갈 수밖에 없다. 따라서 자유도는 4명에서 하나 적은 3이 된다.
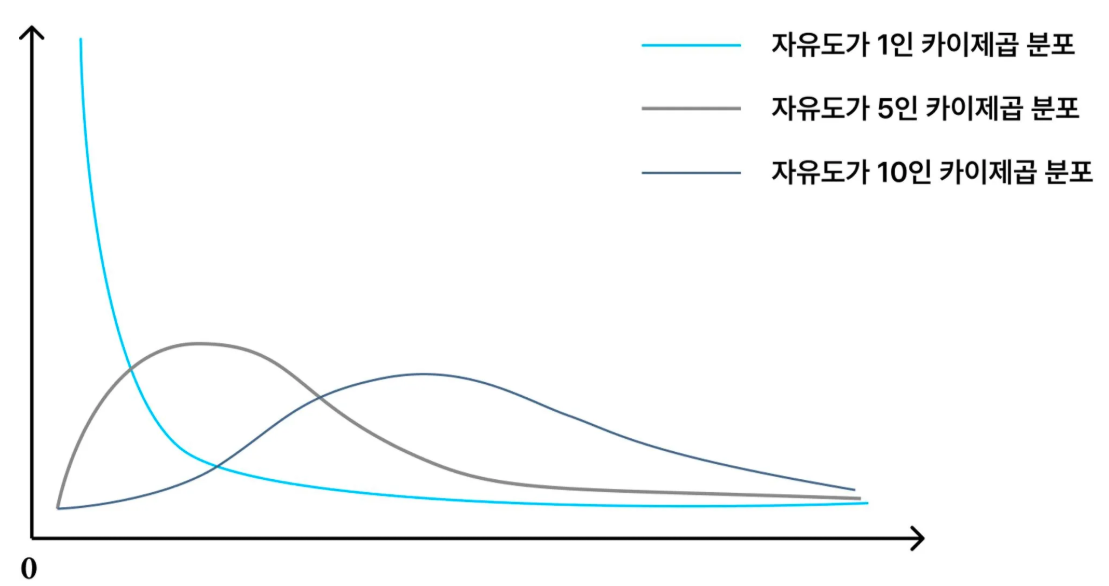
- 카이제곱 분포 (Chi-Square Distribution)
표준정규분포를 따르는 확률변수들의 제곱을 합한 분포
즉, 표준정규분포의 분산의 분포 > 카이제곱 분포
카이제곱 = 1인것이 이상적임
모평균과 모분산을 알려지지 않은 두 개 이상의 집단 간 동질성 검정 또는 모분산 검정을 위해 활용
- F 분포 (F-Distribution)
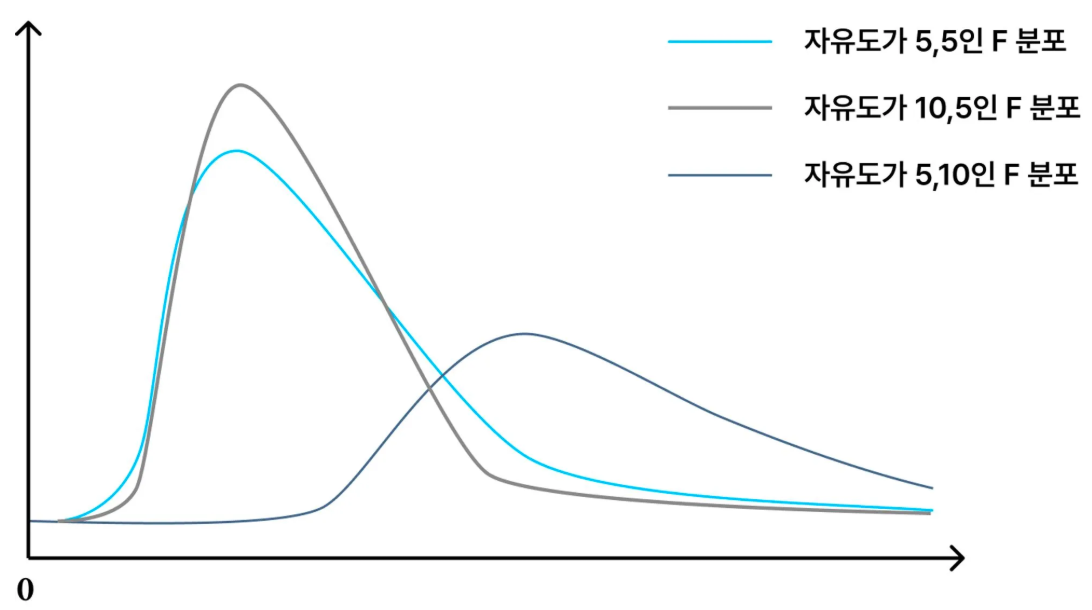
카이제곱분포들의 비율을 따르고 있는 분포
두 집단 간 분산의 동일성 검정에 사용되는 검정 통계량의 분포
확률변수는 항상 양의 값만을 갖고, 카이제곱 분포와 달리 자유도를 2개 가지고 있으며 자유도가 커질수록 정규분포에 가까워진다.
카이제곱과 마찬가지로 기준이 1인 것이 이상적임