01. 함수 기본 배우기
1) 함수란?
- 함수의 개념
함수는입력을 받아 원하는 처리를 한 후출력을 내보내는 일련의 작업을 수행하는 코드 블록
프로그램 내에서 특정한 기능을 수행하기 위해 코드를 논리적으로그룹화하여 재사용 가능한 형태로 정의
-함수의 정의와 호출 방법
def 함수이름(매개변수1, 매개변수2, ...):
    # 함수 내부에서 수행할 작업
return 결과값 # (선택적) 함수의 결과를 반환def를 통해 함수를 정의- 함수 이름 뒤에 소괄호 안에 매개변수(함수 안에서 사용되는 변수)
return을 통해 결과값을 반환
결과 = 함수이름(인수1, 인수2, ...)-
함수를 호출할 때에는 함수 이름을 적고, 소괄호 안에 인수(함수에 전달할 값)을 넣어 호출
-
간단한 예시
# 함수 정의
def greet(name):
    message = "Hello, " + name + "!"
    return message

# 함수 호출
greeting = greet("Alice")
print(greeting) # 출력: Hello, Alice!- 숫자 리스트에서 최대값을 찾는 함수
def find_max(numbers):
    max_num = numbers[0]
    for num in numbers:
        if num > max_num:
            max_num = num # 초기 max_num 보다 큰 수를 max_num으로 가져오고 계속 하나씩 비교하는 것
    return max_num

# 함수 호출
print(find_max([3, 7, 2, 9, 5])) # 출력: 9- 주어진 문자열에서 각 문자의 출현 빈도를 딕셔너리로 반환하는 함수
def char_frequency(string):
    freq_dict = {}
    for char in string:
        if char in freq_dict:
            freq_dict[char] += 1
        else:
            freq_dict[char] = 1
    return freq_dict

# 함수 호출
print(char_frequency("hello"))  # 출력: {'h': 1, 'e': 1, 'l': 2, 'o': 1}
02. 함수 심화 배우기
**1) 전역변수와 지역변수의 차이
-
전역변수 (Global Variables)
프로그램 전체에서 접근 가능한 변수, 어디서든 사용 가능
프로그램이 시작될 때 생성되어 종료될 때까지 메모리에 유지됨
여러 함수에서 공통적으로 사용되는 값을 저장할 때 유용
코드 가독성 떨어지고, 메모리 낭비, 디버깅이 어려운 단점이 있음
함수 내에서는 global 키워드를 사용하여 전역변수를 수정할 수 있다. -
지역변수 (Local Variables)
특정한 범위에서만 접근 가능한 변수로, 범위를 벗어나면 사용 불가
함수 내에서 정의된 변수는 해당 함수 내에서만 사용 가능한 지역변수
지역변수는 함수가 실행될 때 생성되고, 함수 종료 시 메모리에서 제거되므로 메모리 관리에 효율적임
2) 인수(argument)와 매개변수(parameter)의 차이
-
매개변수
함수를 정의할 때 함수가 받아들이는 값을 지정하는 변수
함수의 헤더 부분에서 매개변수가 정의되고 함수 내부에서 사용 -
인수 (전달 인자)
함수를 호출할 때 함수에 전달되는 실제 값으로, 함수 호출시마다 달라질 수 있음
3) 위치 인수(Positional Arguments)란?
- 위치 인수
함수 정의에서 매개변수의 위치에 따라 전달되는 인수로 인자의 값이 함수의 매개변수의 순서대로 맵핑되어 전달됨.
def greet(name, age):
    print("안녕하세요", name, "님! 나이는 ", age, "세입니다.")

# 위치 전달인자 사용
greet("철수", 30)  # 출력: 안녕하세요, 철수님! 나이는 30세입니다.
4) 키워드 인수(Keyword Arguments)란?
- 키워드 인수
함수를 호출할 때, 인수를 순서대로 전달하지 않고 특정 매개변수에 값을 직접 할당하여 전달하는 것
순서를 바꿔도, 매개변수를 지정했기 때문에 결과에는 영향이 없음
매개변수가 많은 경우에 직접 지정하는 경우가 좋을 수 있음
def greet(name, age):
    print("이름:", name)
    print("나이:", age)

# 키워드 인수를 사용하여 함수 호출
greet(name="Alice", age=30)
5) 기본값 (Default Values) 설정하기
함수의 매개변수에 기본값을 설정할 수 있으며, 매개변수에 인수가 전달되지 않았을 때 기본값이 사용된다.
def greet(name="Guest", age=25):
    print("이름:", name)
    print("나이:", age)

# 기본값이 설정된 함수 호출
greet()
6) 키워드 인수와 기본값을 함께 사용하기
def greet(name="Guest", age=25):	# 기본값이 설정
    print("이름:", name)
    print("나이:", age)

# 키워드 인수를 사용하여 함수 호출
greet(name="Alice", age=30)

# 일부 매개변수에만 키워드 인수 사용하여 호출
greet(name="Bob")
7) 가변 인수(Variable-length Arguments)
여러 개의 인수들을 받을 수 있는 함수를 만들기 위해 가변인수를 활용할 수 있다.
args 함수를 호출할 때 임의의 개수의 위치 인수를 전달
def sum_values(*args):
    total = 0
    for num in args:
        total += num
    return total

result = sum_values(1, 2, 3, 4, 5)
print("합계:", result)  # 출력: 합계: 15
*kwargs 함수를 호출할 때 임의의 개수의 키워드 인수를 전달
def print_info(**kwargs):
    for key, value in kwargs.items():
        print(f"{key}: {value}")

print_info(name="Alice", age=30, country="USA")
8) 함수가 데이터 분석에서 사용되는 예시
- 데이터 전처리 함수
데이터 정규화, 결측치 처리, 특성 스케일링 등의 함수를 사용하여 데이터를 전처리 할 수 있음
def stadardization(data):
    # 데이터 표준화 함수
    scaled_data = (data - data.mean()) / data.std()
    return scaled_data

def impute_missing_values(data):
    # 결측치 처리 함수
    filled_data = data.fillna(data.mean())
    return filled_data

def nomalization(data):
    # 데이터 정규화 함수
    scaled_data = (data - data.min()) / (data.max() - data.min())
    return scaled_data
정규화 (Normalzation)
다차원의 데이터를 일정한 범위로 변환하여 비교, 분석을 용이하게 하는 과정
주로 0과 1사이의 값으로 변환하거나, -1과 1 사이의 값으로 변환하는 방법을 사용
표준화 (Standardization)
데이터의 평균을 0, 표준편차를 1로 만드는 전처리 과정으로, 데이터 분포를 정규분포로 만들거나 스케일을 일치시키기 위해 사용
머신러닝 알고리즘에서 가정하는 가우시안 분포를 만족시키기 위해 사용한다
결측값 (Missing Values)
데이터에서 측정되지 않거나 없는 값을 말한다.
데이터 수집 및 처리 과정에서 발생될 수 있으며 결측값을 채우거나, 해당 데이터를 삭제하는 방식으로 처리한다.
- 데이터 시각화 함수
데이터를 시각화하여 데이터의 분포, 이상치, 상관관계 등을 확인할 수 있음
import matplotlib.pyplot as plt

def plot_histogram(data):
    # 히스토그램을 그리는 함수
    plt.hist(data, bins=20)
    plt.xlabel('Value')
    plt.ylabel('Frequency')
    plt.title('Histogram of Data')
    plt.show()

def plot_scatter(x, y):
    # 산점도를 그리는 함수
    plt.scatter(x, y)
    plt.xlabel('X')
    plt.ylabel('Y')
    plt.title('Scatter Plot')
    plt.show()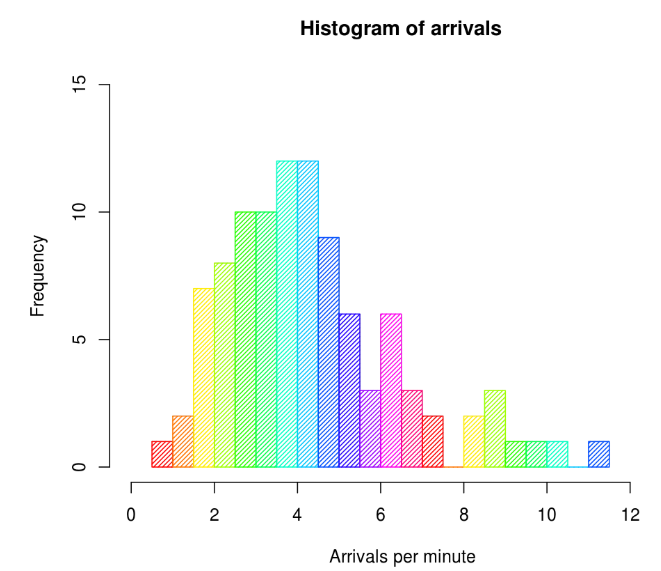
히스토그램은 데이터의 분포를 시각화하는 그래프로, 연속된 데이터의 빈도를 막대 그래프로 나타내어 데이터 분포 확인 가능
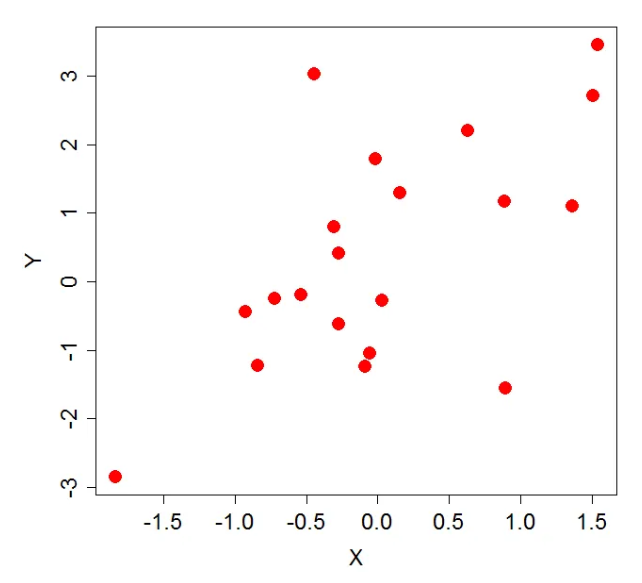
산점도는 두 변수 간의 관계를 시각화하는 그래프로, 각각의 데이터를 점으로 나타내어 상관 관계를 확인하고 이상치를 탐지하는 데에 사용
03.Quiz
1) 함수 퀴즈
1. 평균 계산기 - 주어진 데이터셋의 평균을 계산하는 함수를 작성하고 함수의 결과를 출력해 보세요!
# 데이터는 이것을 사용하세요
data = [2, 4, 6, 8, 10]

data = [2, 4, 6, 8, 10]
def average(data):
  sum_num = 0
  for i in data:
    sum_num += i

  return sum_num / len(data)

print(average(data))