01. Python 데이터 결합
1) merge ⭐⭐⭐
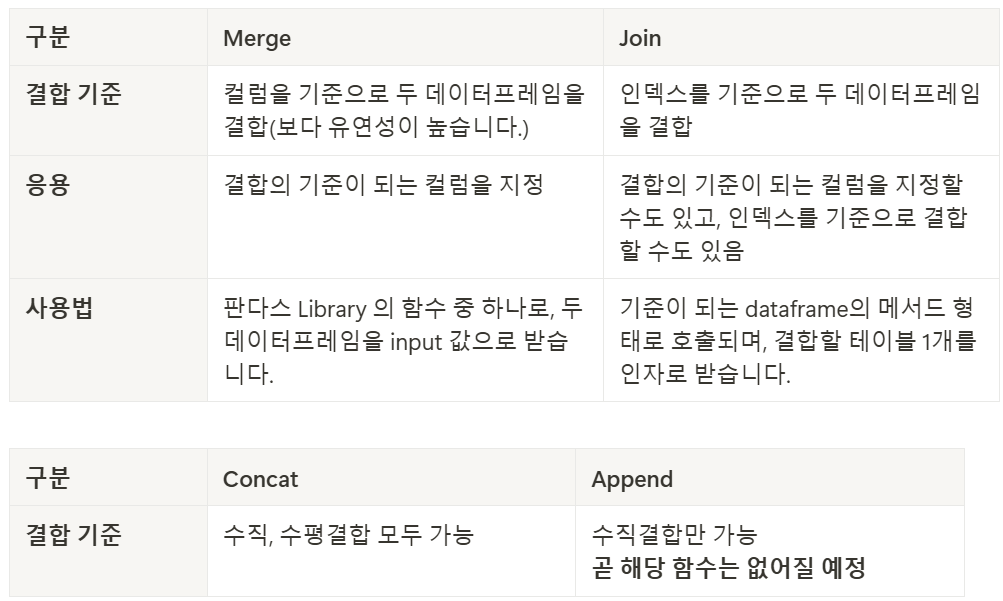
- 두 개 이상의 테이블을 수평 결합하는 pandas의 함수 중 하나로, SQL의 JOIN과 유사
- 주요 옵션
- on : 조건 컬럼(공통 컬럼)이 한 개인지 여러 개인지
- how : 어떤 조인을 사용할 것인지 (inner, outer, left, right)
- left on / right on : 열기준 병합 시 기준으로 할 열의 양측 이름이 다르다면, 각각 어떤 열을 기준으로 할 지 지정
- sort: 병합 후 인덱스 정렬 여부(True/False) = SQL의 order by 역할
- suffixes: 중복된 컬럼 이름의 처리
- indicator: True 로 할 경우, 마지막 열에 병합 정보를 출력
# 기본 작성구문으로, 디폴트값은 inner join
# 공통컬럼값은 합쳐져 하나의 컬럼으로 출력
merge_df = pd.merge(df2,df3)

# 위 코드와 동일한 기능. 웬만하면 on은 작성해주자.
merge_df = pd.merge(df2,df3, how='inner', on='Customer ID')

# 공통컬럼이 2개 이상일 때
merge_df = pd.merge(df2, df3, how='inner', on=['공통컬럼1','공통컬럼2'])

# 기준 컬럼(공통 컬럼) 이름이 다를 때, 각 테이블에서 기준 컬럼을 어떻게 설정할지
merge_df = pd.merge(df2,df3, how='inner', left_on = 'Customer ID', right_on = 'user id')

# 공통컬럼을 개별로 출력하고 싶을 때
merge_df = pd.merge(df2,df3, how='inner', on='Customer ID', suffixes=('_left','_rihgt'))
2) join ⭐⭐
- join은 인덱스 기준으로 테이블을 수평 병합하는 pandas 함수 중 하나
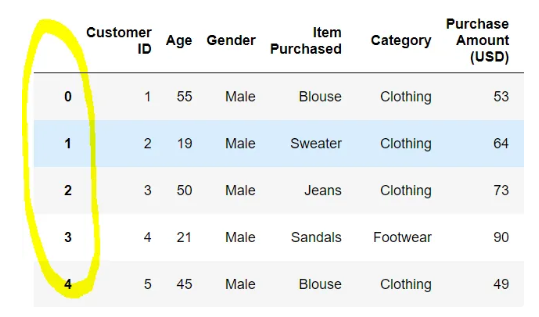
- 주요 옵션
- how : 어떤 조인 방식을 사용할 것인지 (inner, outer, left, right)
- lsuffix / rsuffix : 이름이 같은 컬럼이 존재할 때, 문자열을 지정하여 구별할 수 있도록
- sort : 인덱스 정렬 여부 (True / False)
# 단순 조인
df2.join(df3)

# join 방식 설정
df2.join(df3, how='right')

# join시 이름이 같은 컬럼이 있을 경우, 옵션으로 설정하여 조인 가능
# 아래 코드는 오류가 발생함
# df.join(df2)
df.join(df2,how='left', lsuffix='1', rsuffix='2')

# join 이후, 인덱스 정렬하기
df.join(df2,how='left', lsuffix='1', rsuffix='2', sort=True)
✅ merge로 구현해보고 join 으로도 똑같이 구현해보기!
3) concat ⭐⭐⭐
- 여러 데이터프레임 또는 시리즈를 특정 축을 따라 연결하는 pandas의 함수 중 하나 (수평, 수직 parameter를 통해 모두 가능)
- 주요 옵션
- axis : axis = 0 : 수직결합(기본값) / axis = 1 : 수평결합
- join : 조인 방식 설정
- join_axes : 조인 축 설정
- keys : 데이터프레임 축이름 설정
- ignore_index = True : 인덱스 재배열
# 기본 작성구문
pd.concat([df2, df3])

# 세로로 결합
pd.concat([df2, df3], axis=0, ignore_index=True, join='inner')

# 가로로 결합
pd.concat([df2, df3], axis=1, ignore_index=True, join='inner')
4) append
- 데이터프레임에 행을 추가하는 메서드, 데이터프레임을 행 기준으로 결합하는 pandas의 함수
- 주요 옵션
- ignore_index: 기존 인덱스를 사용할지 여부. False로 할 경우 0,1,2,..,n 이 부여
- sort : 열을 사전적으로 정렬할 지 여부
# 기능이 없어질 예정으로 아래와 같이 concat 으로 변경하여 실행해주시면 됩니다.
# 에러가 아닌 경고메시지로, 이를 무시하고 싶다면 아래와 같은 코드를 입력해주시면 됩니다.
# import warnings
# warnings.filterwarnings('ignore')
# 단순 결합, 없는 건 NaN으로 처리되고 결합
# df2 가 df 의 아래로 붙음

df.append(df2)
5) Merge 와 Join 의 차이점 / Concat 과 Append의 차이점
02. pivot table
1) pivot table의 기능
-
데이터의 열을 기준으로 피벗 테이블을 만들어 내가 원하는 컬럼들로 새로운 데이터프레임을 만들 수 있음
-
주요 옵션
-
index : 인덱스(축)으로 사용될 열
-
columns : 열로 사용될 열
-
values : 값으로 사용될 열
-
index 및 columns에 리스트 형태를 입력할 경우 -> 멀티 인덱스 기반 피벗테이블이 생성됨
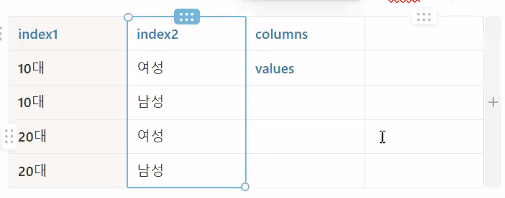
-
values에 리스트를 입력할 경우 -> 각 값에 대한 테이블이 연속적으로 생성됨
✅ 직접 사용해보기 -
aggfunc : 어떠한 계산을 할 것인지
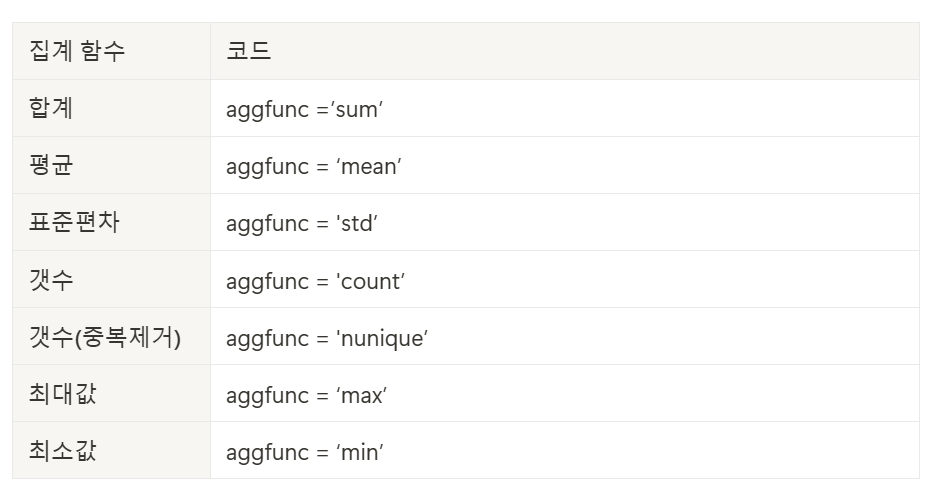
-
# age 라는 축을 기준으로 카테고리별 고객id 카운트
pd.pivot_table(df2, index='Age', columns='Category', values='Customer ID', aggfunc='count')

# age, Category 라는 축을 기준으로 성별 Previous Purchases 최소, 최대값 구하기
pd.pivot_table(df2, index=['Age','Category'],columns='Gender', values='Previous Purchases', aggfunc=['min','max'])

# 성별을 축으로 하고, 사이즈, 나이별 고객id 고유하게 카운트
pd.pivot_table(df2, index=['Gender'],columns=['Size','Age'], values='Customer ID', aggfunc='nunique')
03. 그외의 유용한 메소드
1) lambda ⭐⭐⭐⭐
- 이름이 없는 함수로, 일반적으로 함수를 한 번만 사용하거나 함수를 인자로 전달해야 하는 경우에 유용
# lambda 함수를 이용한 홀수 출력하기
mylist = [1, 2, 3, 4, 5]

mylist2 = list(filter(lambda x: x % 2 == 1, mylist))
print(mylist2)

# lambda 함수를 이용한 정렬
mylist = ['apple', 'banana', 'cherry']
mylist2 = sorted(mylist, key=lambda x: len(x))
print(mylist2)
2) split
- 하나의 값으로 묶여있는 데이터를 문자열을 기준으로 나눌 때 사용
- 주요 옵션
- sep : 문자열을 나눌 '구분자'
- maxsplit : 최대 split 횟수 (모두 나누는 것이 기본값)
# 예시 문자열 선언
s = "aa.bb.cc.dd.ee.ff.gg"

# '.' 구분자를 기준으로 데이터를 나눔
# 아래 두 코드 결과 동일
s.split('.')
s.split(sep='.')

# '.' 구분자를 기준으로 데이터를 나누고 컬럼으로 받음
# lambda 함수와 결합하여 사용하는 경우
# 7번 반복, a 를 컬럼 구분자로 받아주고, format 함수를 통해 a0, a1, a2 ... 로 표기
# lambda 함수를 통해 '.' 로 구분. 단, len(x.split('.') 즉 7 보다 i 가 작을 때 수행
# 중요
for i in range(i):
    df2["a{}".format(i)] = df2['x'].apply(lambda x: x.split('.')[i] if len(x.split('.'))>i else None)