문제 1번.
category 컬럼의 값이 'n/a' 또는 NULL으로 되어 있는 경우, '분류되지 않은 상담'으로 간주
전체 상담 건수 대비 분류되지 않은 상담 비율(%)을 구하는 SQL 쿼리를 작성해주세요.
-
결과는 소수점 1자리까지 반올림
-
call_date가 2024-04-15 이전
-
출력 예시
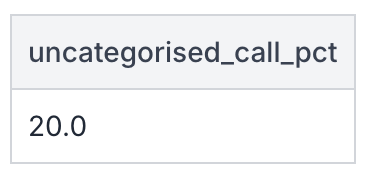
- 제출한 답
select
	round((count(case when (category = 'n/a' or category is NULL) then 1 end) / count(*))*100, 1) as uncategorised_call_pct
from calls
where call_date < '2024-04-16'- 정답
select
  round((sum(if(category = 'n/a' or category is null, 1, 0))/
    count(1)) * 100, 1) as uncategorized_call_pct
from calls
where date_format(call_date, '%Y-%m-%d') < '2024-04-16'-
회고
- count(case when ~ )으로 집계
'n/a'라고 되어있는 부분은 실제로 따옴표로 묶여져 있기 때문에 문자를 의미한다.
NULL은 실제로 NULL값인 경우를 의미하므로 is NULL을 사용하여 NULL값인 경우를 구할 수 있다.
count()안에 case when으로 조건을 걸어 집계할 수 있다.
아래의 링크에서 집계함수와 case when을 사용하는 예시를 정리해뒀었다.
상당히 자주 사용되며 테스트에서도 자주 출제되는 경우기 때문에 꼭 기억해두어야 할 것 같다.
[TIL]_2025.04.08 본캠프 51일차 (1) : 코드카타 SQL
- 정답에서는 if를 사용하여 집계하고 있다. 강의 초반에 if를 지양하라는 튜터님의 말씀이 있어서 아예 if의 문법을 공부하지 않아서 사용을 못했다.
IF(condition, true_value, false_value)
조건을 넣고 조건이 참인 경우 출력할 값, 거짓일 경우 출력할 값을 순서대로 입력해서 사용할 수 있다.
SELECT, WHERE, ORDER BY, GROUP BY, HAVING, 집계함수 내부에서 -
where call_date < '2024-04-16'
또한 call_date가 timestamp 타입이기 때문에,
2024-04-15일 까지인 경우라는 의미는 2024-04-15 23:59:59를 의미한다.
❌ call_date <= '2024-04-15'
- 자동으로 '2024-04-15 00:00:00'으로 캐스팅됨
따라서 4월 15일의 자정만 포함되기 때문에 사용 불가
❌ DATE_FORMAT(call_date, '%Y-%m-%d') <= '2024-04-15'
- DATE_FORMAT()은 타임스탬프를 문자열로 변환한 뒤 비교함.
이 경우 인덱스를 타지 않아서 쿼리 성능이 크게 저하될 수 있음.
또한 '2024-04-15 23:59:59.999999’ 이후의 미세한 시간 단위 데이터는 반올림되어 '2024-04-16'으로 변환되기 때문에, 조건에서 제외될 수 있음.
무엇보다도 문자열로 변환하는 것이기 때문에 데이터 처리 속도 측면에서도 지양하는 것이 좋다.
✅ call_date <= '2024-04-15 23:59:59'
- 명시적으로 15일의 마지막 시간까지 포함되므로 그 날 하루 전체를 포함하게 됨.
✅ call_date < '2024-04-16'
- 다음 날 0시 전까지 포함하는 방식이라 더 깔끔하고 에러도 줄일 수 있다. 날짜 기반 필터링에서 베스트 프랙티스로 자주 쓰임.
문제 2번.
2023년 1월 1일 가입자부터 연령대별 주문 전환율을 파악하기 위해,
결과를 나이 구간으로 오름차순 정렬해주세요.
결과를 소수점 2자리로 반올림해서 출력해주세요
주문 전환율 정의 : order / (view + order)
-
출력 예시
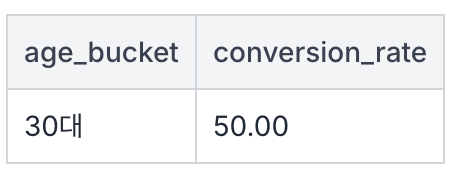
-
제출한 답
select
  u.age_bucket,
  round(count(case when a.event_type = 'order' then 1 end) / count(case when a.event_type in('view', 'order') then 1 end) *100, 2) as conversion_rate
from app_events a
join user_profiles u
on a.user_id = u.user_id
where u.signup_date >= '2023-01-01'
group by 1
order by 1- 정답
select
	up.age_bucket,
    round((sum(if(event_type = 'order', 1, 0)) / count(1)) * 100, 2) conversion_rate
  -- 분자가 order한 수
  -- 분모가 order / view 한
  from user_profiles up
join app_events ap
on up.user_id = ap.user_id
where up.signup_date >= '2023-01-01'
and event_type in ('order', 'view')
group by 1
order by 1- 회고
정답은 where조건으로 order, view 먼저 필터링 한 후 if를 사용하여 집계했다.
1번 문제에 join을 추가로 사용한 문제다.
문제 3번.⭐️
누적 10건 이상의 주문을 완료한 사용자를 우수 고객으로 정의하고,
DATEDIFF()를 사용하여 가장 짧은 기간 내에 우수 고객이 된 사용자 1명을 파악하세요.
-
출력 예시
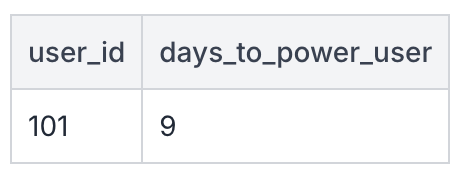
-
제출한 답
with order_order as (
  select user_id,
          order_datetime,
          row_number() over (partition by user_id order by order_datetime) as rnk
  from user_orders
  ),
order_rank as (
  select
    user_id,
    min(case when rnk = 1 then order_datetime end) as first_order,
    min(case when rnk = 10 then order_datetime end) as tenth_order
  from order_order
  group by user_id
  having tenth_order is not null
)
select
  user_id,
  datediff(tenth_order, first_order) as days_to_power_user
from order_rank
order by 2 limit 1- 정답
select user_id,
    datediff(tenth_ordertime, order_datetime) days_to_power_user
from (
  select user_id
    , order_datetime -- n번째 주문
    , lead(order_datetime, 9) over
      (partition by user_id order by order_datetime) as tenth_ordertime -- n+9번째 주문
    , row_number() over (partition by user_id order by order_datetime) as seq -- n
  from user_orders
) a
where seq = 1 and tenth_ordertime is not null
order by 2
limit 1- 회고
- LEAD()
LEAD(column_name, offset, default_value) OVER (PARTITION BY ... ORDER BY ...)
현재 행 기준으로 다음 행의 값을 가져오는 함수
정답에서는 1번째 주문일자의 9번째 뒤인 10번째 주문일자를 tenth_ordertime이라는 컬럼에 담는다.
그 후에 각 날짜가 몇번째 날짜인지 ROW_NUMBER()를 사용하여 seq이라는 컬럼에 담는다.
그리고 where절로 조건을 걸어, 1번째 주문일자와 10번째 주문일자가 있는 경우를 한번에 불러왔다.
진짜 너무너무 멋있고 고능하게 푸셨다...미쳤다...아예 생각을 못했다. 이거는 진짜 너무 유용할 것 같고 이런 식으로 윈도우 함수 뿐만 아니라 집계 함수도 여러 개를 응용해서 사용해보는 연습이 정말 정말 필요할 것 같다.
내가 푼 방법은, with를 두 번 사용하여 일단 먼저 주문 날짜가 몇번째 주문인지 표시하고,
min()으로 1번째 주문과 10번째 주문일자를 담는 컬럼을 각각 만들었다. 그 후에 where절로 1번째 주문과, 10번째 주문 건을 필터링 한 후, datediiff로 두 일자의 차이를 구하고 order by로 limit 1로 제일 빠른 기간 내에 우수 고객이 된 사용자를 구했다. 여기서 10번째 주문 in NULL을 안하면 NULL값이 가장 첫번째 행에 위치하기 때문에 꼭 걸어줘야 했다.
전반적인 난이도는 지난 번 회차가 더 어려웠던 것 같다.
그치만 문제를 풀 수 있는 다양한 방법에 대해서 알 수 있었다.
