6. API를 통한 데이터 수집 과제
과제 1: 네이버 트렌드 API를 활용한 데이터 수집
개요
네이버 데이터랩에서 제공하는 검색어 트렌드 API를 활용하여 특정 키워드의 검색량 추이를 분석하는 과제입니다. 시간에 따른 검색어 관심도 변화를 확인하고 데이터를 수집하여 저장합니다.
준비사항
- 네이버 개발자 센터(https://developers.naver.com) 회원가입 및 로그인
- 애플리케이션 등록 (데이터랩(검색어 트렌드) API 사용 신청)
- 클라이언트 ID와 시크릿 발급
- Python 설치 및 requests 라이브러리 설치
- VSCode 주피터 환경 설치
⭐과제 요구사항
- 네이버 데이터랩 검색어 트렌드 API를 활용하여 다음 작업을 수행하세요:
- 최소 3개 이상의 키워드에 대한 검색 트렌드 데이터 수집
- 최근 1년간의 주간 트렌드 데이터 수집
- JSON 형식으로 응답 데이터 저장
- 수집한 데이터를 분석하여:
- 키워드별 검색량 추이 비교
- 최대 검색량을 기록한 시기 파악
- CSV 파일로 가공하여 저장
사용할 키워드는 내가 요즘 관심을 갖고 있는 SQLD로 결정했다.
키워드 : SQLD, SQLD 자격증, SQLD 일정
그리고 뭔가 그냥 분석을 하기엔 심심해서
연령별, 성별 검색 트렌드를 구해보고 싶었다.
네이버 통합 검색어 트렌드의 경우 각각의 연령과 성별에 따른 검색량 비중을 보기 위해서는 각각의 조합을 전부 구해야 한다.
따라서 이를 for문을 활용하여 성별 2가지, 연령대 11가지로 총 22개의 조합을 만들었다.
# requests 라이브러리 임포트
import requests # HTTP 요청을 보내는 외부 라이브러리 / GET, POST, PUT, DELETE 등의 메소드로 웹 서버와 통신 가능
from urllib.parse import quote # URL에 넣는 문자열 인코딩 함수
import time

# API 기본 URL - 네이버 제공
base_url = "https://openapi.naver.com/v1/datalab/search"

# API 요청 헤더 설정 - 네이버 제공
headers = {
    "X-Naver-Client-Id": client_id,
    "X-Naver-Client-Secret": client_secret,
    "Content-Type" : 'application/json'
}

# 성별, 연령별 데이터 요청을 위해 변수 설정
genders = ["f", "m"] # 성별 설정
ages = [str(i) for i in range(1, 12)] # 1~11 문자열 리스트 생성

# 결과를 저장할 results 딕셔너리 지정
results = []

# 모든 성별, 연령별 조합을 요청하기 위한 반복문
for gender in genders:
    for age in ages:
        # API 요청 body (JSON) - 최근 1년 간의 주간(week) 데이터 수집, 모든 age, gender, device 조건 검색
        data = {
            "startDate": "2024-05-22",
            "endDate": "2025-05-23",
            "timeUnit": "week",
            "keywordGroups": [
            {"groupName": "SQLD", "keywords": ["SQLD"]},
            {"groupName": "SQLD 자격증", "keywords": ["SQLD 자격증"]},
            {"groupName": "SQLD 일정", "keywords": ["SQLD 일정"]}
            ],
            "gender" : gender,
            "ages" : [age]
        }

        # POST 요청 보내기 - 검색어 트렌드의 경우 HTTP 메서드로 POST를 사용
        response = requests.post( # 한글 자동으로 UTF-8인코딩 함
            base_url,
            headers=headers,
            json=data
        )

        # 응답 상태 코드 확인 및 결과 출력 (200번대는 정상 응답, 성공)
        if response.status_code == 200:
            # JSON 형식으로 응답 데이터 파싱 : 데이터를 읽어서 의미 있는 구조나 값으로 해석하고 변환하는 과정
            result = response.json()
            results.append({
                "gender" : gender,    # gender 파라미터 넣어주기
                "ages" : age,         # ages 파라미터 넣어주기
                "data" : result
            })
            print(f'성공! 결과 : gender={gender}, age={age}')
        else:
            # 에러 발생시 상태 코드와 에러 메시지 출력
            print(f"Error {response.status_code}: gender={gender}, age={age}")
            print(f"Error Message: {response.text}")

        time.sleep(0.5)    # API 과부하 방지를 위한 대기 시간
‼️여기서 JSON이란?
JavaScript Object Notation의 약자로, 자바스크립트의 객체(모든 메서드, 속성)을 텍스트로 나타내는 형식. 데이터를 나타내는 표현 방식
출처 : JSON이란 무엇인가?
import json
print(json.dumps(results[0], indent=2, ensure_ascii=False))

# ratio란? 해당 기간 동안 해당 키워드의 검색량이 차지하는 비율
JSON으로 잘 저장되었는지 확인해보기 위해서 0번째 위치의 데이터를 가져와서 확인해봤다. 성별과 연령대와 키워드 3가지에 대한 기간과 검색 비중이 잘 나왔다. 굿굿.
그러면 이 데이터를 시각화로 분석하기 위해서 DataFrame으로 만들어주자.
import pandas as pd
# json을 DataFrame으로 불러오기 / 각 성별, 연령별, 기간별로 행 만들기
data_rows = []

for item in results:
    gender = item["gender"]    # 성별 가져오기
    age = item["ages"]         # 연령 가져오기
    for group in item["data"]["results"]:     # 각 기간별 data
        title = group["title"]
        for record in group["data"]:
            data_rows.append({
                "gender": gender,
                "age": age,
                "title": title,
                "period": record["period"],
                "ratio": record["ratio"]
            })

df = pd.DataFrame(data_rows)
그 다음 seaborn으로 검색어 트렌드 추이를 살펴볼 수 있는 그래프를 만든다.
import matplotlib.pyplot as plt
import seaborn as sns
import matplotlib.dates as mdates

plt.figure(figsize=(16, 6))

# 선 그래프 + 마커 + 신뢰구간 제거
sns.lineplot(data=df, x='period', y='ratio', hue='title', marker='o', errorbar=None)

# x축 눈금 설정: 주간 단위로 모두 표시
plt.xticks(ticks=df['period'].unique(), rotation=45)
plt.gca().xaxis.set_major_formatter(mdates.DateFormatter('%Y-%m-%d'))

# 격자 무늬 추가
plt.grid(True)

plt.title('키워드별 검색량 주간 추이 (2024-05-22 ~ 2025-05-23)')
plt.xlabel('기간')
plt.ylabel('검색 비율')

# 오타 수정
plt.tight_layout()
plt.show()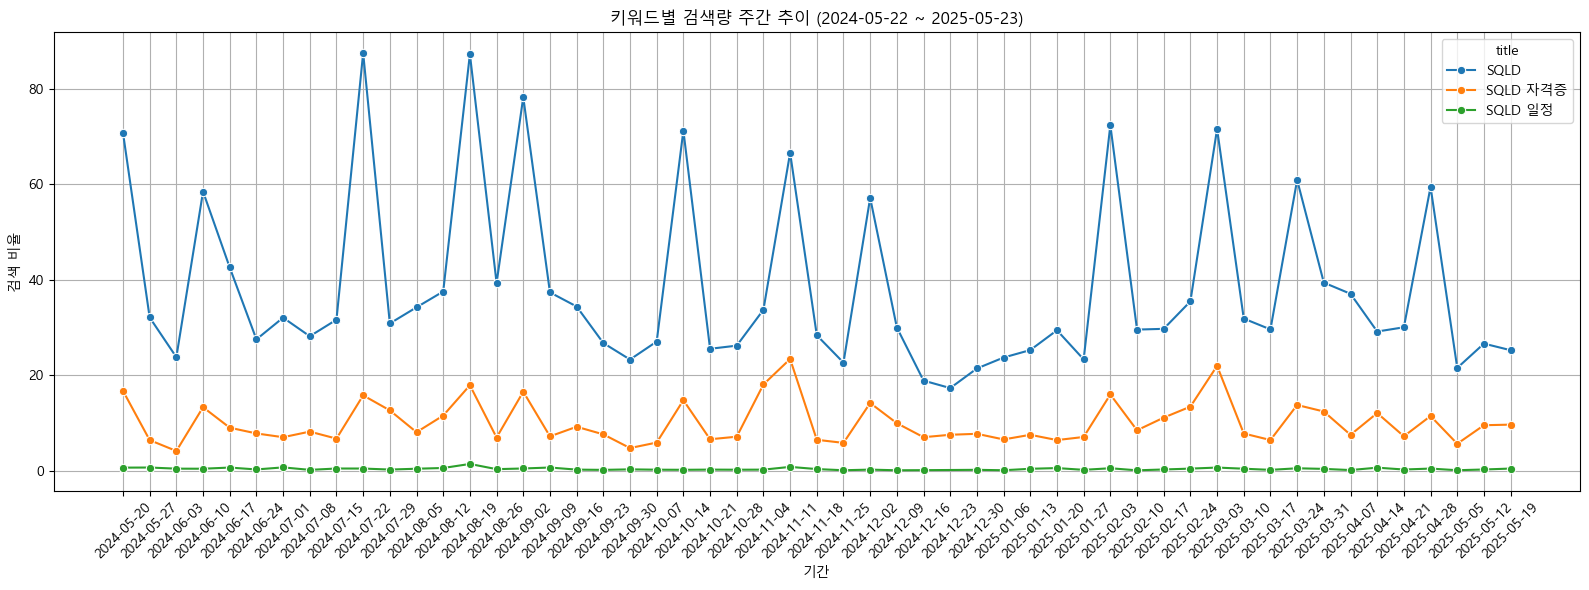
이 그래프에서 확인해봤을 때에는 'SQLD'와 'SQLD 자격증'이라는 키워드는 증감 추세가 거의 흡사하다. 하지만 SQLD 일정은 검색량이 거의 없는 수준인 것을 볼 수 있다.
SQLD, SQLD 자격증이라는 키워드는 2024-07-22에 검색량이 폭발적으로 증가했는데, 이날이 바로 SQLD 시험 접수 시작일이었다.
그리고 2024-08-19 역시 검색량이 가장 많았던 날 중 하나인데, 이날은 시험이 있는 주 월요일이였다. 무슨 상관이 있는지는 모르겠지만, 혹시 시험장소나 시험 시간을 다시 확인하려고 접속한걸까?
2024-09-02는 또 사전점수가 뜨는 주 월요일이었다.
2024-10-14는 또 역시나 SQLD 시험 접수가 시작되는 날이었는데, 7월 대비 많이 감소된 것으로 보인다. 24년도 가장 마지막 SQLD 시험은 응시생이 비교적 적지 않았을까?
25년도 SQLD 시험은 2025-04-28이었는데, 전년도의 같은 시기의 시험 대비 검색량이 확연히 줄었다.
과제 2: 카카오 맵 API를 활용한 할리스 카페 위치 정보 수집
개요
카카오 맵 API를 활용하여 할리스 카페 매장의 주소를 위도와 경도 좌표로 변환(지오코딩)하고, 이 데이터를 수집하여 저장하는 과제입니다.
준비사항
- 카카오 개발자 사이트(https://developers.kakao.com) 회원가입 및 로그인
- 애플리케이션 등록 및 API 키 발급
- REST API 키 확인
- Python 설치 및 requests 라이브러리 설치
- VSCode 주피터 환경 설치
과제 요구사항
- 카카오 로컬 API의 주소 검색 기능을 활용하여:
- 제공된 할리스 카페 주소 목록에 대한 위도, 경도 정보 수집 hollys_stores.csv
- 주소, 매장명, 위도, 경도를 포함한 데이터 저장
- 오류 발생 시 적절한 예외 처리 구현
- 제공된 할리스 카페 주소 목록에 대한 위도, 경도 정보 수집 hollys_stores.csv
- 수집한 데이터 처리:
- CSV 파일로 정리하여 저장
- 선택적: 수집한 좌표를 지도에 표시(folium 라이브러리 활용)
# 할리스 카페 주소 목록
hollys = pd.read_csv('hollys_stores.csv')

# REST API 키 입력
REST_KEY = "My_key"

# 주소를 좌표 변환 함수
def get_coords(address):
    url = "https://dapi.kakao.com/v2/local/search/address.json"
    headers = {"Authorization": f"KakaoAK {REST_KEY}"}
    params = {"query": address}

    response = requests.get(url, headers=headers, params=params)

    if response.status_code != 200:
        print(f"❌ 요청 실패: {response.status_code} / {response.text}")
        return None, None

    result = response.json()

    if not result['documents']:
        print(f"❌ 좌표 검색 실패: '{address}'")
        return None, None

    longitude = result['documents'][0]['x']
    latitude = result['documents'][0]['y']
    return latitude, longitude

# 정규표현식으로 주소 정제
import re

# 주소 정제 함수
def clean_address(addr):
    addr = re.sub(r'\([^)]*\)', '', addr)                   # 괄호 제거
    addr = re.sub(r'\d+~\d+(층|호)', '', addr)              # 1~2층 제거
    addr = re.sub(r'\d+(층|호)', '', addr)                  # 1층 제거
    addr = addr.strip().rstrip('.')                         # 끝 점 제거
    return addr.strip()

# 위경도 컬럼 초기화
hollys['latitude'] = None
hollys['longitude'] = None

# 주소 정제 및 좌표 변환
for i, row in hollys.iterrows():
    raw_addr = row['address']
    clean_addr = clean_address(raw_addr)
    lat, lon = get_coords(clean_addr)
    hollys.at[i, 'latitude'] = lat
    hollys.at[i, 'longitude'] = lon
    print(f"[{i}] {raw_addr} → 위도: {lat}, 경도: {lon}")

# 결과 저장
hollys.to_csv("hollys_stores_with_coords.csv", index=False)
여기까지 작성했으나, 현재 403 오류 (권한 문제)가 발생하여 완료하지 못했다.
플랫폼에 web을 등록을 안했기 때문인 것 같아서 추가해봤지만 여전히 403오류가 해결되지 않았다.
