- 1차 모델링
XGBoost, CatBoost, LightGBM, GBM, RF를 선정
Feature selection : feature importance vs permutation importance
- 딥러닝 모델 선정 : Transformer 계열 모델
[논문리뷰] Attention is All you need의 이해
먼저 Transformer 계열의 딥러닝 모델에 대해서 알아보기 전에, 가장 기반이 되는 부분으로 돌아가서 RNN에 대해서 알아보자.
LSTM(RNN)소개
RNN?
RNN(Resurrent Neural Networks)는 순환신경망으로, 유닛 간의 연결이 순환적 구조를 갖는 특징을 갖는 인공 신경망이다. 라는 설명을 하면 솔직히 나로서는 이해가 안간다. 이 말이 무슨 뜻인지 풀어서 설명하면 다음과 같다.
RNN은 과거의 정보가 현재의 출력에 영향을 미치는 순환적 구조를 가지고 있다. 이것이 기존의 전통적인 인공 신경망과의 차이이다.
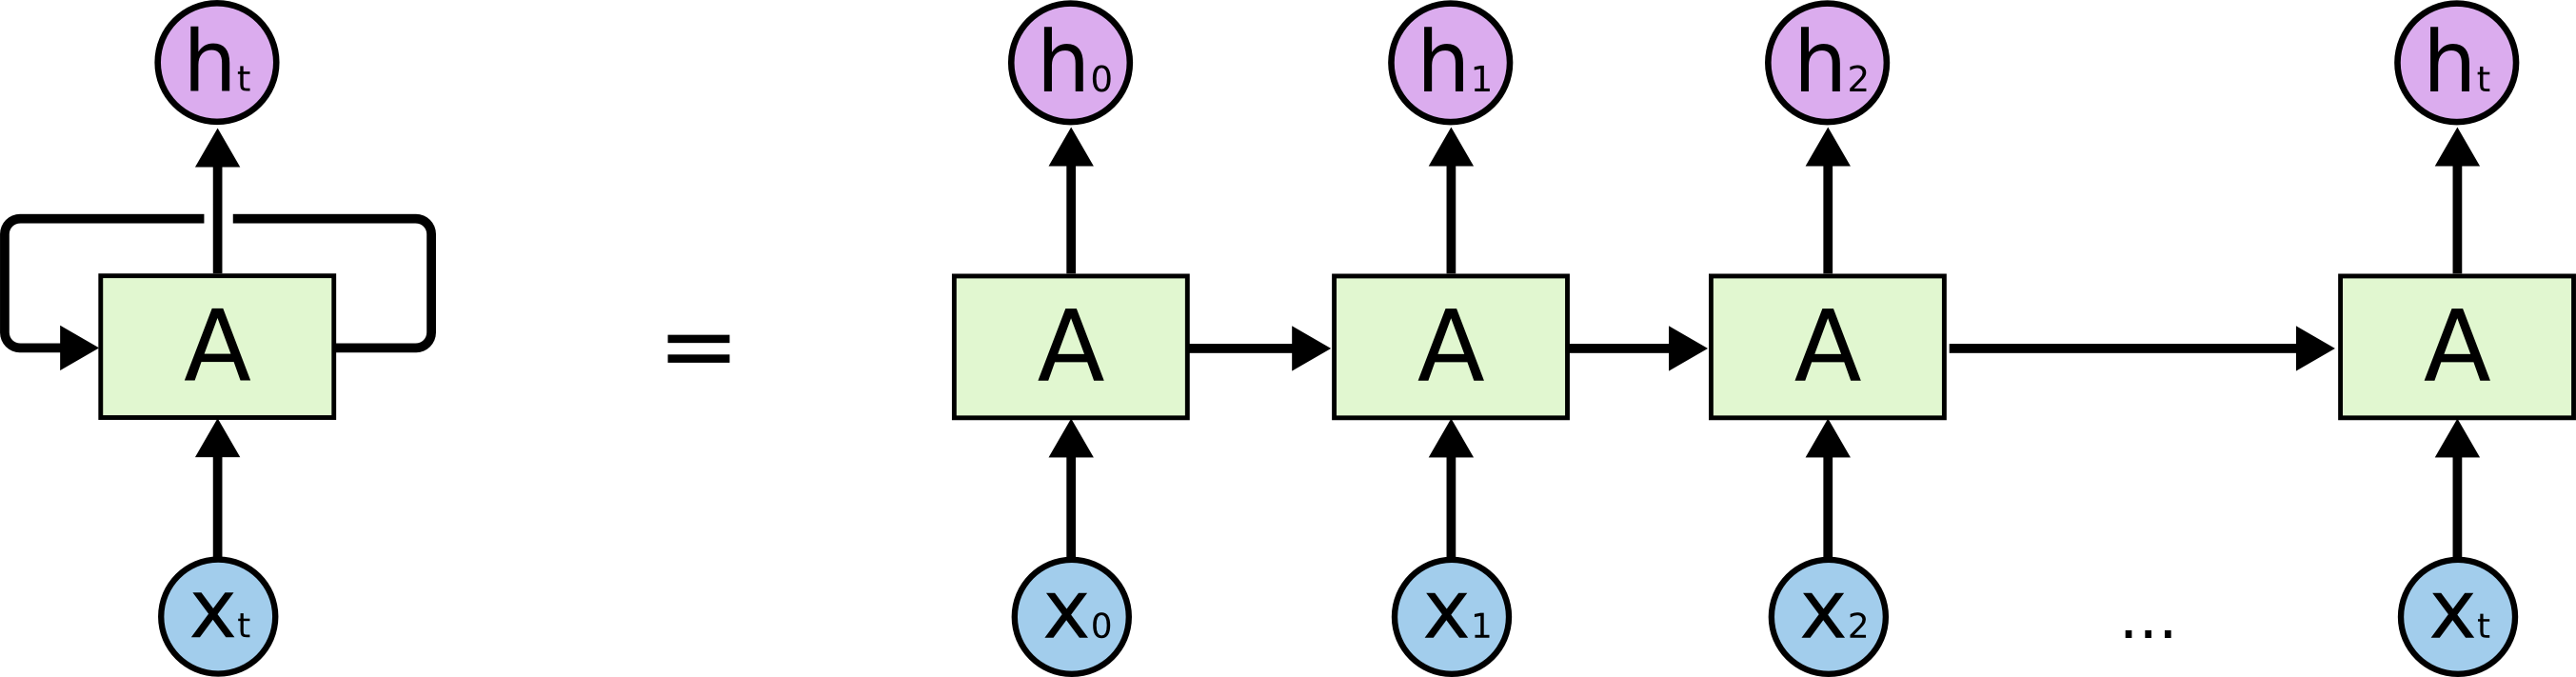
위의 그림과 마찬가지로 각 단계의 은닉 상태를 다음 시점의 입력으로 전달하는 구조이다. 즉, 이전 출력이 현재의 입력과 합쳐져서 다음 출력을 계산하는 방식을 의미한다. 순서를 기억하는 구조이므로 순서가 중요한 자연어 처리, 시계열 예측, 음성 인식 등에 적합한 모델 기법이다. 하지만, 기억을 하는 구조이므로 오래된 과거의 정보가 점점 거리가 멀어지기 때문에 정보가 사라지는 문제(장기 의존성 문제)가 있다. 이 문제를 해결할 수 있는 모델이 LSTM (Long Short-Term Memory)과 GRU (Gated Recurrent Unit), Transformer 다.
LSTM & GRU?
LSTM(Long Short-Term Memory)의 구조와 데이터 처리 방식
LSTM은 RNN(Recurrent Neural Network)의 일종으로, 기본 RNN이 가진 장기 의존성(Long-Term Dependency) 문제를 해결하기 위해 고안된 모델이다. 일반적인 RNN은 입력 시퀀스가 길어질수록 과거 정보가 소실되는 문제가 발생하는데, LSTM은 이러한 문제를 해결하기 위해 셀 상태(Cell State)와 게이트(Gate) 구조를 도입하였다. 이를 통해 중요한 정보를 오랜 시간 동안 보존하고, 불필요한 정보는 선택적으로 제거할 수 있다.
LSTM의 핵심 구성요소는 셀 상태와 세 가지 게이트(forgot gate, input gate, output gate)이다. 셀 상태는 시간 흐름에 따라 정보를 전달하는 일종의 메모리 역할을 하며, 게이트는 이 셀 상태에 어떤 정보를 추가하거나 제거할지를 제어하는 역할을 한다.
1. Forget Gate
첫 번째 단계는 기존 셀 상태에서 어떤 정보를 제거할지를 결정하는 과정이다. 이때 사용하는 것이 forget gate로, 시그모이드 함수의 출력(0~1 사이의 값)을 기반으로 각 정보 항목의 유지 여부를 판단한다. 출력값이 1에 가까울수록 해당 정보는 유지되고, 0에 가까울수록 해당 정보는 삭제된다. 예를 들어, 문장의 주어가 바뀌는 경우 이전 주어의 성별 정보는 잊고 새 주어에 대한 정보로 갱신해야 한다.
2. Input Gate와 새로운 후보값 생성
다음 단계는 셀 상태에 어떤 새로운 정보를 추가할지를 결정하는 과정이다. 우선 input gate가 시그모이드 함수를 통해 업데이트할 정보의 위치를 선택한다. 이후 tanh 함수를 이용해 새로운 후보값 벡터를 생성한다. 이 후보값은 새로운 정보로 추가될 수 있는 값들의 집합이며, input gate의 출력과 곱해져서 실제로 저장될 정보를 결정한다.
3. 셀 상태 업데이트
앞 단계에서 결정된 삭제 및 추가 정보를 반영하여 셀 상태를 업데이트한다. 먼저 이전 셀 상태에 forget gate의 출력을 곱하여 잊기로 한 정보를 제거한다. 그 다음 input gate의 출력과 새로운 후보값을 곱해, 이를 기존 셀 상태에 더함으로써 새로운 정보를 반영한다. 이로써 현재 시점의 셀 상태가 완성된다.
4. Output Gate와 최종 출력
마지막으로 output gate는 현재 시점의 출력값을 생성하는 역할을 한다. 이 게이트는 시그모이드 함수를 통해 셀 상태 중 어떤 부분을 출력으로 보낼지를 결정하며, 셀 상태에 tanh 함수를 적용하여 값을 -1에서 1 사이로 정규화한 뒤 output gate의 결과와 곱하여 최종 출력값을 생성한다. 이 출력값은 다음 시간 스텝의 입력이 되거나, 모델의 예측 결과로 사용된다.
이와 같은 구조 덕분에 LSTM은 시계열 데이터, 자연어 처리 등 시간적 흐름이 중요한 데이터에 효과적으로 활용된다. 특히 문맥을 장기간 유지하거나 앞뒤 관계를 반영한 예측이 필요한 작업에 강점을 가진다.
GRU란?
GRU(Gated Recurrent Unit)는 기존의 RNN 모델을 개선한 구조로, 순차적인 데이터를 처리하는 데 사용되는 모델이다. GRU에는 Reset Gate와 Update Gate라는 두 개의 게이트가 존재한다.
- 리셋 게이트 : 과거 정보를 얼마나 무시할지를 결정하며,
- 업데이트 게이트 : 과거 정보를 얼마나 유지할지를 결정한다.
이 두 게이트는 모두 시그모이드 함수를 활성화 함수로 사용하므로, 출력은 0~1 사이의 값을 가지며 정보 반영의 정도를 결정한다.
- 리셋 게이트 계산: 과거 상태 중 어떤 정보를 얼마나 사용할지를 결정
- 업데이트 게이트 계산: 과거 상태를 얼마나 유지할지를 결정
- 새로운 후보 은닉 상태 생성: 리셋 게이트가 조절한 과거 상태와 현재 입력을 바탕으로 생성
- 최종 은닉 상태 결정: 업데이트 게이트의 값에 따라 과거와 새 정보 중 어느 쪽을 더 반영할지 결정
GRU는 이러한 과정을 통해 정보 손실을 줄이고, 시계열 데이터에 대해 더 효율적으로 학습할 수 있도록 돕는다.
또한 LSTM보다 구조가 단순하여 연산이 빠르다는 장점도 있다.
Transformer 계열 모델
전통적인 ARIMA 모델 외에도 RNN, LSTM, GRU 같은 딥러닝 모델들의 연구가 진행되고 있으나 장기 데이터 손실에 있어서의 한계를 극복하기 위해 Transformer 계열 모델이 도입되었다. 원래 transformer 모델은 자연어 처리에서 우수한 성능을 보이는 모델이었으나 여러 장점 중 장거리 종속성과 상호작용을 활용하는 기능이 시계열 데이터를 처리하는 방식에 도움이 될 것이라 판단되어 시계열 예측에서도 종종 사용되곤 한다.
Transformer 계열 모델의 가장 큰 장점은 모든 시점의 데이터를 동시에 고려할 수 있는 어텐션 메커니즘에 있다. 이 구조는 과거와 현재의 정보 간 장기적인 의존 관계를 효과적으로 포착할 수 있어, 시계열 데이터와 같이 시간 간격이 긴 변수들 사이의 관계를 학습하는 데 유리하다. 또한 RNN 기반 모델과 달리 순차적으로 계산할 필요가 없어 병렬 처리가 가능하고, 이로 인해 학습 속도나 추론 속도 측면에서 효율성이 높다는 특징이 있다.
시계열 데이터에 Transformer가 사용되는 이유는, 시계열 특성상 특정 시점 간의 복잡한 상호작용을 다루어야 하는 경우가 많기 때문이다. 특히 주기성이나 추세처럼 장기적인 패턴을 학습해야 하는 과제에서 Transformer의 구조가 잘 작동한다는 점에서 활용 가능성이 높게 평가되고 있다.
하지만 Transformer 계열 모델은 모든 문제에 적합한 것은 아니다. 일반적으로 모델의 파라미터 수가 많고 구조가 복잡하기 때문에, 상대적으로 적은 양의 데이터나 짧은 시계열에는 과적합(overfitting)될 위험이 있으며 학습 시간이 오래 걸리는 단점도 존재한다. 또한 self-attention 메커니즘이 모든 시점을 비교하게 되면서 긴 시계열일수록 계산량이 기하급수적으로 증가하게 되어, 이를 해결하기 위한 다양한 경량화 모델이 최근 활발히 연구되고 있다.
과적합을 방지하기 위한 모델 중에서 하나로 FiLM(Frequency improved Legendre Memory Model)은 시계열 예측에서 과적합을 완화하고 긴 시퀀스 입력을 활용하기 위해 제안되었다. 이 모델은 다음의 세 가지 구조를 가진다.
1. Mixture of Experts (MoE) 구조
FiLM은 하나의 통합된 모델 대신 여러 개의 전문가 모듈(Experts)을 구성하여 입력 데이터의 시계열 길이에 따라 적절한 전문가를 선택한다. 이 구조는 다양한 시계열 길이에 유연하게 대응할 수 있도록 하며, 모델의 학습 효율성과 표현력을 증가시킨다.
2. LPU (Legendre Projection Unit)
LPU는 시계열 데이터의 과거 정보를 압축적으로 표현하기 위한 모듈이다. 기존의 FFT(Fast Fourier Transform)와 달리 Legendre 다항식을 이용하여 시간 영역 정보를 보존하면서 주파수 특성까지 반영한다. 이를 통해 시계열 데이터의 장기 의존성을 보다 안정적으로 모델링할 수 있다.
3. FEL (Frequency Enhanced Layer)
FEL은 LPU를 거쳐 생성된 시계열 표현을 다시 한 번 푸리에 변환한 뒤에 일부 주파수 영역만을 선택적으로 샘플링한다. 이후 low-rank matrix approximation 기법을 적용하여 불필요한 고주파 잡음을 제거한다. 이 과정을 통해 모델은 더 정제된 주파수 정보를 기반으로 예측을 수행하게 된다.
2022년도에 발표된 'Are Transformer Effective for Time Series Forecasting?'이라는 논문에서는 트랜스포머 모델이 명확한 추세와 주기성을 지닌 장기 시계열 예측에 효과가 있는지 의문을 던지며 트랜스포머 모델의 특성으로 인해 시간 순서에 따른 정보의 손실이 불가피할 수 박에 없다고 주장하며 LTSF- Linear라는 간단한 선형 모델을 제시함.
LTSF-Linear(DLinear, NLinear) 논문 리뷰/구현(Are Transformers Effective for Time Series Forecasting?)
출처: https://today-1.tistory.com/60 [Better Than,:티스토리]
Dliner는 시계열 데이터의 명확한 추세와 주기성이 있을 때 일반적인 바닐라 선형 모델보다 더 나은 성능을 가질 수 있기 때문에 먼저 트랜스포머로 해보고 Dlinear 모델로도 해보면 좋을 것 같음..
https://infossm.github.io/blog/2022/09/17/time-series-forecasting/
다변량 시계열 예측
https://dacon.io/competitions/official/236264/codeshare/10891?page&dtype&ptype&fType&category
https://aboutnlp.tistory.com/55
https://doheon.github.io/%EC%BD%94%EB%93%9C%EA%B5%AC%ED%98%84/time-series/ci-4.transformer-post/
