1. 시카고 50개 맛집 샌드위치 가게 이름과 메뉴 정보 모으기
- 시카고 50개 맛집 샌드위치 가게에 대한 메뉴와 가게 이름
# main page
https://www.chicagomag.com/Chicago-Magazine/November-2012/Best-Sandwiches-Chicago/
최종목표 총 51개 페이지에서 각 가게의 정보를 가져온다.
-
가게이름
-
대표메뉴
-
대표메뉴의 가격
-
가게주소
-
순위 페이지
https://www.chicagomag.com/Chicago-Magazine/November-2012/Best-Sandwiches-Chicago/- 그 중 하나 세부 페이지 (예) Old Oak Tap BLT)
https://www.chicagomag.com/Chicago-Magazine/November-2012/Best-Sandwiches-in-Chicago-Old-Oak-Tap-BLT/- 주소와 대표메뉴 가격 있음
(1) 구조
- 메인 page : 시카고 50개 맛집 샌드위치 - 가게이름, 메뉴
- 세부 page : 각각 소개한 50개의 페이지 - 가게 주소, 대표 메뉴 가격
- 수집하고자 하는 정보 : 총 51개 페이지에서 각 가게의 정보 수집 - 가게이름, 대표메뉴, 대표메뉴 가격, 가게주소
(2) 시카고 맛집 데이터 수집 및 정리
	# pip install fake-useragent (터미널에서 인스톨)
   import pandas as pd
   import ssl
   from urllib.request import urlopen, Request
   from urllib.parse import urljoin
   from fake_useragent import UserAgent # 이것은 header request 부분 User Agent부분 임의로 만들어줌
   from bs4 import BeautifulSoup
(3) 메인 페이지
- 시카고 매거진 기사에 대한 html 요청 및 BeautifulSoup으로 읽기
# pip install fake-useragent (터미널에서 인스톨)

from urllib.request import Request, urlopen
# 이것은 header request부분 User Agent부분 임의로 만들어줌
from fake_useragent import UserAgent
from bs4 import BeautifulSoup

url_base = "https://www.chicagomag.com/"
url_sub = "chicago-magazine/november-2012/best-sandwiches-chicago/"
url = url_base + url_sub

# response = urlopen(url)  # 그냥 이렇게 하면 403 error가 나옴. 이것을 구글서 서치   이것은 서버에서 내 접근을 막은 것임.

# 이것을 극복하려면... ctr+shift+i에서 network열고 첫 페이지 맨 밑에header reqest부분에 User Agent부분 복사

# req = Request(url, headers={"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/121.0.0.0 Safari/537.36"}) #403error시 이렇게 입력해야 함.

# 또는
# user agent 붙여넣음 (dictionary 형태로 키와 밸류값을 넣어줌)
req = Request(url, headers={"user-agent": "chrome"})
# 이래도 response 받아올 수 있다.
# 이렇게 간단히 해서 열리면 되는데 아닌 페이지는 위와 같이 header request부분 User Agent부분 복사해 붙여야 함

#response = urlopen(req)
#response
#response.status # 비로서 status 200이 나옴

# 또는 이렇게 해도 됨
# ua = UserAgent()
# req = Request(url, headers={"user-agent": ua.ie})
html = urlopen(req)
soup = BeautifulSoup(html, "html.parser")

# 아니면 터미널에서 ds_study활성화 시켜 준 후
# pip install fake-useragent 입력 인스톨 후  위와 같이 UserAgent 해도 됨.

# 원하는 페이지의 모든 html부분 가져올 수 있음
print(soup.prettify())
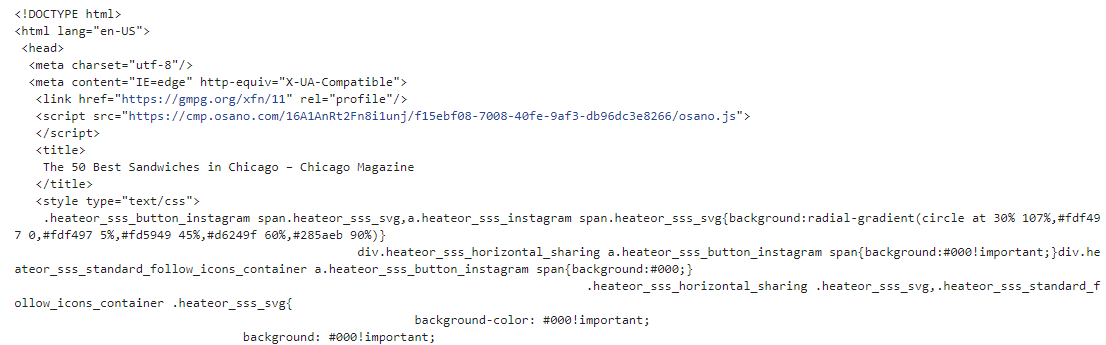
# 찾고자 하는 부분을 ctr + shift + i 부분서 찾아내면 tag는 div  class는 sammy 를 확인 할 수 있음.

soup.find_all("div", class_="sammy"), len(soup.find_all("div", class_="sammy"))

# 또는
# soup.select(".sammy"), len(soup.select(".sammy"))
# 실행결과 : 50- div의 sammy 클래스가 50개 임을 확인
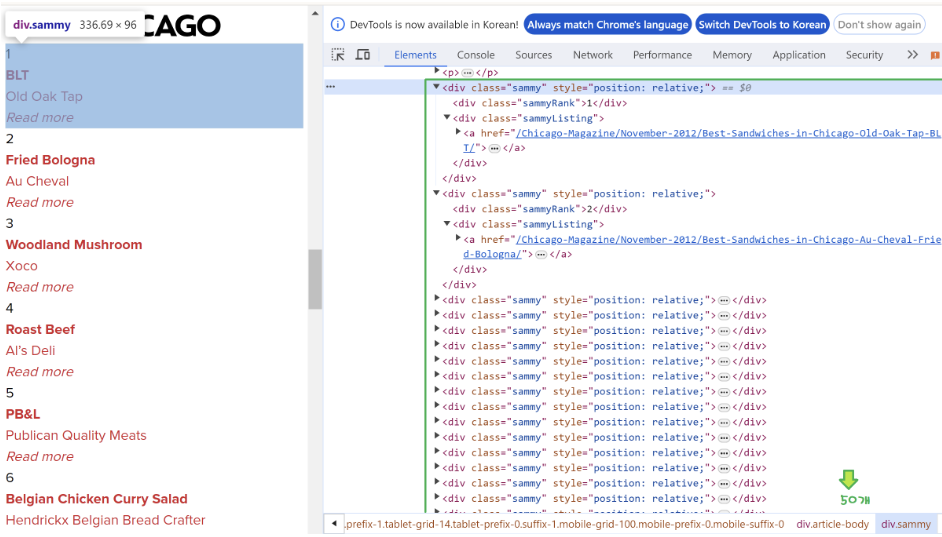
- 랭킹, 가게이름, 대표 메뉴, url 주소 데이터 찾아보기
# 필요한 첫번째 랭크 1의 내용 담음
tmp_one = soup.find_all("div","sammy")[0]

# select문으로도 할 수 있음
#tmp_one.select_one(".sammyRank").text
#type(tmp_one)

tmp_one.find("div", {"class":"sammyListing"})
tmp_one.find("div", {"class":"sammyListing"}).get_text()

# 또는
# tmp_one.select_one(".sammyListing").text
tmp_one.find("a")["href"]

# 또는
# tmp_one.select_one("a").get("href")
# \n 이런 표현 없애기 (\n 이나 \r\n 기준으로 없애기)
import re
tmp_string = tmp_one.find(class_="sammyListing").get_text()
re.split("\n|\r\n", tmp_string)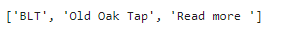
print(re.split(("\n|\r\n"), tmp_string)[0]) # 메뉴이름
print(re.split(("\n|\r\n"), tmp_string)[1]) # 카페이름
from urllib.parse import urljoin
url_base = "https://www.chicagomag.com/"

# 필요한 내용을 담을 빈 리스트
# 리스트로 하나씩 컬럼을 만들고 Dataframe으로  합칠 예정
rank = []
main_menu = []
cafe_name = []
url_add = []

list_soup = soup.find_all("div", "sammy") # soup.select(".sammy")

for item in list_soup:
    rank.append(item.find(class_="sammyRank").get_text())
    tmp_string = item.find(class_="sammyListing").get_text()
    main_menu.append(re.split(("\n|\r\n"), tmp_string)[0])
    cafe_name.append(re.split(("\n|\r\n"), tmp_string)[1])
    url_add.append(urljoin(url_base, item.find("a")["href"]))

len(rank), len(main_menu), len(cafe_name), len(url_add)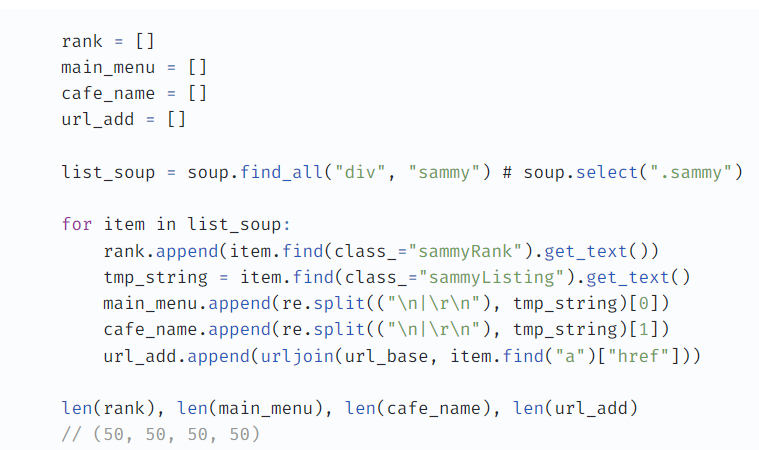
rank[:5]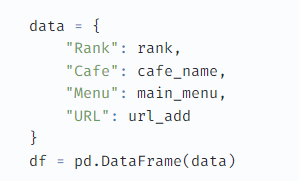
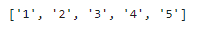
main_menu[:5]
cafe_name[:5]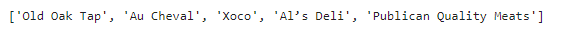
url_add[:5]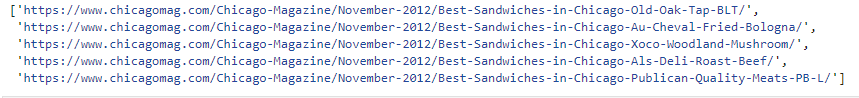
import pandas as pd

data = {
    "Rank": rank,
    "Menu": main_menu,
    "Cafe": cafe_name,
    "URL": url_add,
}
df = pd.DataFrame(data)
df.tail(5)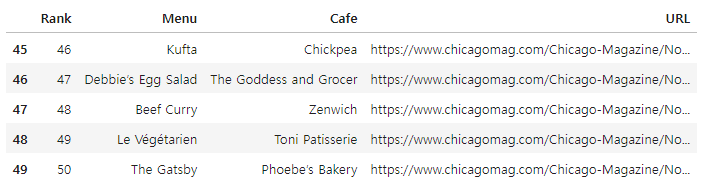
# 컬럼 순서 변경
df = pd.DataFrame(data, columns=["Rank", "Cafe","Menu","URL"])
df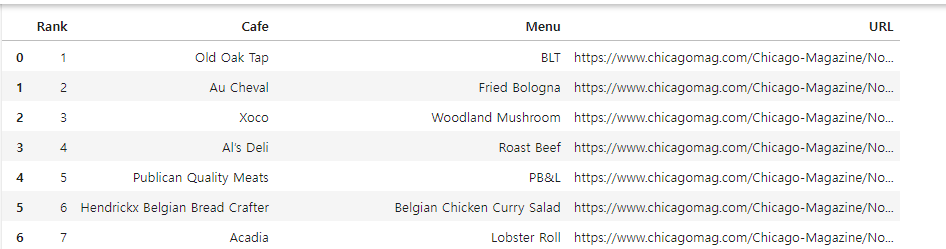
# 데이터 저장
df.to_csv(
    "../data/03. best_sandwiches_list_chicago.csv", sep=",", encoding="utf-8"
)
(4) 시카고 맛집 데이터 분석 - 하위데이터
# Requirements
import folium
import pandas as pd
import numpy as np
from urllib.request import urlopen, Request
from fake_useragent import UserAgent
from bs4 import BeautifulSoup

df = pd.read_csv("../data/03. best_sandwiches_list_chicago.csv")
df.tail()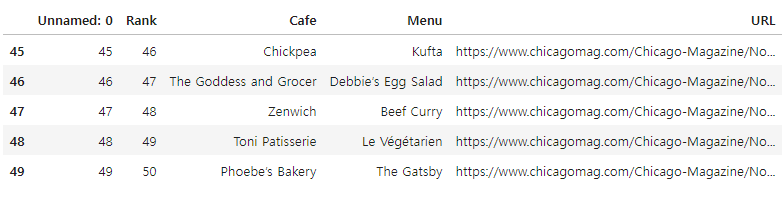
df["URL"][0]
# 주소부분 ctrl+shift+i 하면 주소 위치를 감싸는 class가 p이고 addy을 알 수 있음regular expression
price_tmp = soup_tmp.find("p","addy").text
price_tmp
import re
re.split(",", price_tmp)
price_tmp = re.split(",", price_tmp)[0]
price_tmp
tmp = re.search("$\d+.(\d+)?", price_tmp).group()
price_tmp[len(tmp) + 2:]
from tqdm import tqdm
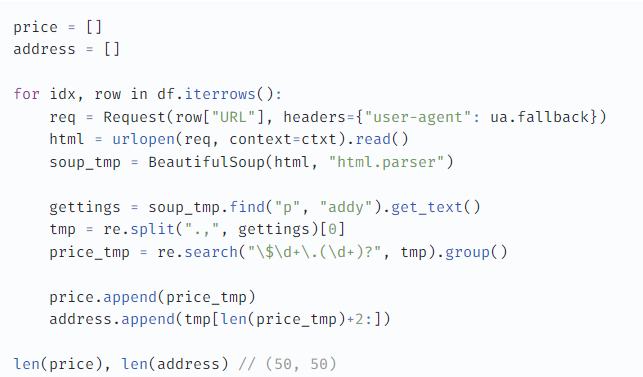
address.append(price_tmp[len(tmp)+2:])
print(idx)
price, address

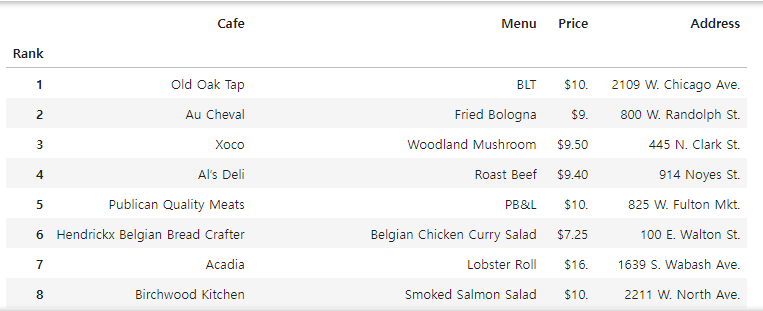
df["Price"] = price
df["Rank"] = rank
df["Address"] = address
df = df.loc[:,["Rank","Cafe","Menu","Price","Address"]]
df.set_index("Rank", inplace = True)
df- csv로 저장하고 읽어오기
df.to_csv("../data/03. best_sandwiches_list_chicago2.csv", sep=",", encoding= "UTF-8")

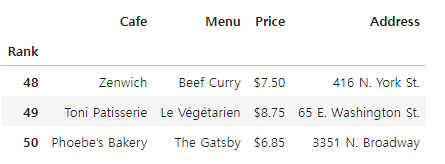
pd.read_csv("../data/03. best_sandwiches_list_chicago2.csv", index_col=0)
'''
2. 시카고 맛집 데이터 지도 시각화
(1) setting
import pandas as pd
import numpy as np
import googlemaps
import folium
from tqdm import tqdm
df = pd.read_csv("../data/03. best_sandwiches_list_chicago2.csv", index_col=0)df.tail(3)
(2) GoogleMaps에서 위치 정보 가져오기
- 가게 주소 정보로 위도, 경도 데이터 가져오기
- folium으로 지도 시각화
gmaps_key = "나의 api_key"
gmaps = googlemaps.Client(key=gmaps_key)
lat = []
lng = []

for idx, row in tqdm(df[:].iterrows()):
    if not row["Address"] == "Multiple location":
        target_name = row["Address"] + ", " + "Chicago"
        #print(target_name)
        #위도와 경도값을 다 가져옴
        gmaps_output = gmaps.geocode(target_name)
        #딕셔너리 형태로 데이터가 있음
        #print(gmaps_output)
        location_output = gmaps_output[0].get("geometry")
        #지리정보에 해당하는 속성값만 가져옴
        #print(location_output)
        lat.append(location_output["location"]["lat"])
        lng.append(location_output["location"]["lng"])
        #location_target - gmaps_output[0]
    else:
        lat.append(np.nan)
        lng.append(np.nan)
df["latt"] = lat
df["lng"] = lng

len(lat), len(lng)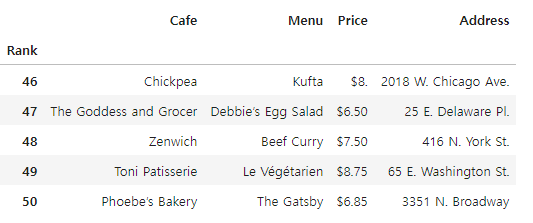
df.tail()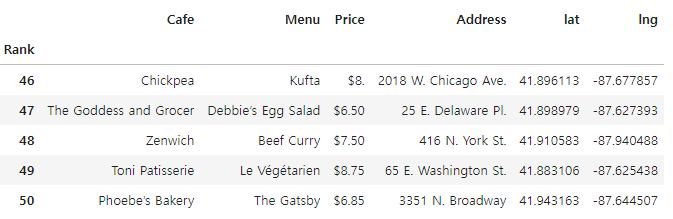
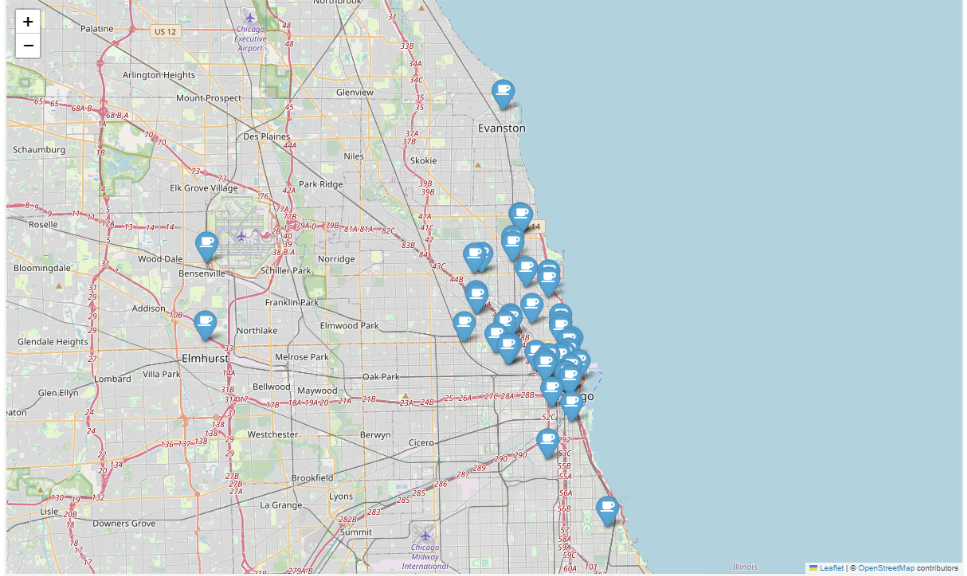
(3) folium 지도 시각화
- 지도 상 카페 위치 Marker로 찍기
 mapping = folium.Map(location=[41.8781136, -87.6297982], zoom_start=11)

    for idx, row in df.iterrows():
        if row["Address"] != "Multiple location":
            folium.Marker(
                  location=[row["lat"], row["lng"]],
                  popup=row["Cafe"],
                  tooltip=row["Menu"],
                  icon=folium.Icon(icon="coffee", prefix="fa")
            ).add_to(chicago_map)

    mapping
Data Science 스터디로그