해당 paper는 2000년부터 2024년까지 머신러닝(ML) 기반 소프트 센서 기술의 진화 과정을 포괄적으로 다루고 있으며, 제조 현장에서의 품질 예측을 위한 알고리즘, 산업별 적용, 그리고 방법론적 변화를 상세히 분석하고 있다.
Summary
01 Motivation
물리적 측정의 한계와 오프라인 분석의 지연(최대 12시간)으로 인한 제조 현장의 실시간 품질 제어 불가능 문제를 해결하기 위한 기술적 대안이 필요하다.
02 Review Focus
2000년부터 2024년까지의 연구를 분석하여, 단순 통계 모델에서 딥러닝으로 이어지는 소프트 센서 기술의 진화(Evolution)와 산업별 적용 양상을 체계적으로 규명한다.
03 Key Challenges
공정 데이터의 비선형성(Nonlinearity), 시계열적 지연(Time Delay), 그리고 데이터 주기 차이(Multirate Sampling)로 인한 데이터 불균형이 소프트 센서 개발의 주요 걸림돌이다.
04 Contribution
머신러닝 알고리즘의 분류 체계(Taxonomy)를 정립하고, 시멘트 공정 등에서 에너지 소비를 최대 9.3%까지 절감할 수 있는 실질적 효용성을 입증했다.
05 Comparative Analysis
딥러닝은 정확도가 높으나 연산 비용이 크고, Tree 기반 모델은 의 선형적 복잡도와 낮은 성능 편차를 보여 실시간성과 안정성 면에서 우수하다.
06 Practical Insight
현장 적용(Deployment) 시, 무조건적인 고성능 딥러닝보다는 경량화(Lightweight)와 성능 안정성이 보장된 Tree 모델이나 엣지 컴퓨팅 전략이 더 유효할 수 있다.
07 Future Directions
딥러닝의 데이터 요구량을 충족하기 위한 GAN 기반 데이터 증강, 타 공정 지식을 활용하는 전이 학습(TL), 그리고 데이터 보안을 위한 연합 학습(FL)이 핵심 연구 주제가 될 것이다.
0. Abstract
-
최근 머신러닝은 제조 공장의 품질 관리를 강화하는 핵심 도구이다. 그러나 제조 현장에서 실시간 품질 평가는 여전히 어려운 과제이다. 이에 대한 해결책으로 2000년 이후 소프트 센서(Soft Sensor)가 주목받고 있다. 소프트 센서는 ML을 활용해 공정 품질 지표를 예측하는 기술로, 공정 안정성 확보, 제품 폐기율 감소, 에너지 및 연료 효율 향상과 같은 이점을 제공한다.
-
초기에는 정유, 폴리머, 시멘트, 철강 산업을 중심으로 개발되었으나 점차 다양한 산업으로 확산되고 있다. 알고리즘 측면에서는 단순 선형 알고리즘에서 시작하여 신경망, SVM(Support Vector Machine), 트리 기반 모델을 거쳐, 최근에는 복잡한 딥러닝 모델로 진화하였다. 데이터 가용성과 컴퓨팅 파워의 증가는 딥러닝 알고리즘을 소프트 센서 연구의 주류로 만들고 있으며, 이는 에너지 소비 절감과 생산율 향상, 발자국 감소에 기여할 것이다.
1. Introduction
- Problem
물리적 센서의 설치 제약과 오프라인 분석의 긴 소요 시간(최대 12시간)으로 인해 제조 현장에서 실시간 품질 평가 및 즉각적 제어가 불가능한 한계를 해결하고자 한다.
1.1 Problem Definition
2000년 이후 철강, 시멘트, 폴리머, 정유 등 공정 제조 산업은 새로운 도전에 직면했다. 과거에는 단순히 비용 절감과 생산 용량 증대가 주된 관심사였으나, 현재는 사회적 책임과 생태학적 발자국(Ecological Footprint) 감소가 필수적인 요구사항으로 대두되었다. 낮은 품질은 단순한 비용 손실을 넘어 사회적, 환경적 악영향을 초래하기 때문이다.
1. 실시간 품질 평가의 불가능성: 적절한 측정 장비의 부재, 설치 공간의 제약, 높은 비용 문제로 인해 공정 중 실시간으로 품질을 확인하는 것은 현실적으로 불가능에 가깝다.
2. 오프라인 분석의 시간 지연: 기존 방식은 공정 후 샘플을 채취하여 실험실에서 분석하는 오프라인 방식에 의존한다. 이 과정은 결과 확인까지 최대 12시간이 소요되므로, 공정 엔지니어가 이상 상황에 대해 즉각적으로 대응하거나 제어하는 것을 어렵게 만든다.
1.2 Solution
이러한 물리적 센서의 한계를 극복하고 실시간 대응 체계를 구축하기 위해 소프트 센서(Soft Sensor) 기술이 개발되었다. 이는 하드웨어 센서를 대체하는 수학적 모델로서, 2000년 이후 데이터 가용성의 증가와 함께 급격히 성장하고 있다.
1. 소프트 센서의 정의 및 원리: 소프트 센서는 이용 가능한 공정 데이터(온도, 압력 등)와 품질 변수 간의 상관관계를 분석하여, 측정하기 어려운 미지의 실시간 품질 변수를 정확히 추정해 내는 가상의 센서 모델이다.
2. 에너지 및 비용 절감 효과: 소프트 센서를 통한 실시간 예측은 공정 효율을 극대화한다. 예를 들어, 시멘트 밀(Mill) 공정에서 1일 압축 강도를 예측하여 클링커 분말도를 최적화할 경우 약 3%의 에너지를 절감할 수 있다. 또한, 시멘트 킬른(Kiln)에서 유리 석회(Free lime)를 예측하여 제어할 경우 연료 소비를 9.3%까지 줄일 수 있음이 입증되었다.
3. 데이터 기반 모델로의 진화: 복잡한 물리, 화학적 공정 지식이 없어도 구축 가능한 데이터 기반(Data-driven) 모델이 확산되고 있다. 이는 공정 데이터가 풍부해짐에 따라 더욱 정교해지고 있으며, 제조 현장의 품질 관리 패러다임을 사후 분석에서 실시간 예측 및 제어로 전환시키는 핵심 솔루션으로 자리 잡고 있다.
2. Methodology
저자들은 주요 데이터베이스에서 390개 이상의 연구를 검색하고 스크리닝하여, 최종적으로 107개의 논문을 선정하였다. 선정 기준은 출판 연도, 적용된 ML 알고리즘, 관련 산업(정유, 시멘트, 수처리 등), 샘플링 모델, 튜닝 접근법, 평가 지표 등을 고려하였다.
본 리뷰 논문은 다음의 4가지 주요 질문에 대한 답을 찾는 것을 목표로 수행되었다.
Key Research Question
1. 2000년 이후, 공정 제조 산업에서 품질 변수 예측을 위한 소프트 센서 개발과 관련하여 머신러닝은 어떻게 발전해 왔는가?
2. 해당 기간 동안 주로 사용된 지배적인 ML 알고리즘은 무엇인가?
3. 제조 분야의 품질 관리를 목적으로 소프트 센서가 주로 개발된 핵심 산업군은 어디인가?
4. 샘플 확보, 모델 튜닝, 그리고 성능 평가를 위해 어떠한 방법론이 사용되었는가?
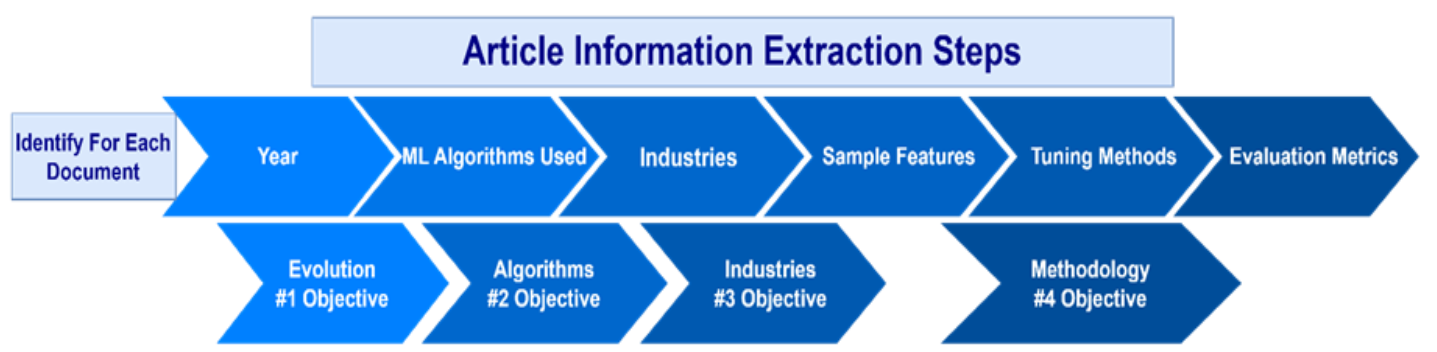
1. 정보 추출 단계
- Year (연도): 해당 연구가 출판된 시점
- ML Algorithms Used (사용된 ML 알고리즘): 소프트 센서 구현에 사용된 머신러닝 모델의 종류
- Industries (산업): 해당 기술이 적용된 제조 분야 (예: 시멘트, 정유, 철강 등)
- Sample Features (샘플 특징): 데이터의 특성 및 샘플링 방법
- Tuning Methods (튜닝 방법): 모델의 성능을 최적화하기 위해 사용된 하이퍼파라미터 튜닝 기법
- Evaluation Metrics (평가 지표): 모델의 성능을 측정하기 위해 사용된 척도 (RMSE, 등)
2. 연구 목표 달성 단계
-
Objective (Evolution): 'Year' 데이터를 분석하여 시간의 흐름에 따른 기술의 진화(Evolution) 양상 파악
-
Objective (Algorithms): 'ML Algorithms Used' 데이터를 통해 시기별 지배적인 알고리즘 트렌드 분석
-
Objective (Industries): 'Industries' 데이터를 통해 어떤 산업 분야에서 소프트 센서가 주로 활용되는지 파악
-
Objective (Methodology): 'Sample Features', 'Tuning Methods', 'Evaluation Metrics' 데이터를 종합하여 연구 방법론(Methodology)의 변화와 표준 정립
3. Data
3.1 ML Taxonomy
소프트 센서에 사용되는 ML 알고리즘은 크게 지도 학습(Supervised)과 비지도 학습(Unsupervised)으로 나뉜다.

-
지도 학습과 비지도 학습을 상위 계층으로 두고, 각각 전통적 방법(Non-DL)과 딥러닝(DL)으로 세분화한 분류도이다.
-
지도 학습 (Supervised):
-
전통적 방법: 회귀(Regression), 트리 기반(Tree-based), KNN, SVM/SVR, 베이지안, 얕은 신경망(Shallow Neural Net)
-
딥러닝(DL): 다층 퍼셉트론(MLP), CNN, RNN
-
-
비지도 학습 (Unsupervised):
-
전통적 방법: 클러스터링, PCA, LDA
-
딥러닝(DL): 오토인코더(AE), DBN(Deep Belief Network), RBM(Restricted Boltzmann Machine), SOM(Self-Organizing Map), GAN
-
3.2 Histroical Background
지난 20여 년간 제조 공정의 품질 예측을 위한 소프트 센서 기술은 단순한 통계 모델에서 복잡한 딥러닝 시스템으로 비약적인 발전을 이루었다. 이 과정은 공정 데이터의 특성(비선형성, 시계열성, 데이터 불균형)을 극복하기 위한 알고리즘의 진화 과정과 궤를 같이한다.
1. 1990년대 ~ 2000년대
1990년대 초반, 연구자들은 제조 품질 변수를 예측하기 위해 PLS(부분 최소 제곱), PCA, ANN과 같은 데이터 기반 알고리즘을 사용하기 시작했다. 그러나 이 분야에 대한 집중적인 연구와 새로운 알고리즘의 개발은 2000년 이후 본격화되었으며, 이는 공정 품질 예측을 위한 소프트 센서(Soft Sensor)의 실질적인 적용으로 이어졌다.
2. 2010년 ~ 2016년: ANN과 SVM을 통한 비선형성 극복
이 시기에는 공정의 복잡한 비선형성을 처리하기 위해 ANN의 변형 모델들과 SVM이 집중적으로 연구되었다.
- ANN 변형 모델 (ELM, RBF): 기존 ANN의 느린 학습 속도와 지역 최소값(Local Minima) 문제를 해결하기 위해 ELM(Extreme Learning Machine)이 도입되었다. 또한, RBF(방사 기저 함수) 신경망 역시 ANN보다 우수한 성능을 보이며 활발히 연구되었다.
- SVM (Support Vector Machine): 통계학적 학습 이론에 기반한 SVM은 적은 데이터로도 일반화 성능이 뛰어나고 비선형성 처리에 강점을 보였다. 시멘트 가마의 유리 석회(Free lime) 예측, 철강 빌렛 온도 예측, 폴리머 용융 지수 예측 등 다양한 분야에서 SVM 기반 소프트 센서가 개발되었다.
- 앙상블(Ensemble) 기법: 단일 모델로는 계절성이나 공정 노후화 같은 다양한 운전 모드를 대변하기 어렵다는 한계를 극복하기 위해, 여러 하위 모델을 결합하여 예측 안정성을 높이는 앙상블 기법이 제안되었다.
3. 2018년 이후: 딥러닝(Deep Learning)의 부상과 데이터 문제 해결
2018년을 기점으로 딥러닝(DL) 모델이 소프트 센서 개발의 주류로 부상했다.
- Stacked AE(SAE), CNN, GRU, MLP 등의 알고리즘은 단순한 예측을 넘어 특징 추출(Feature Extraction)과 데이터 증강(Data Augmentation)이라는 새로운 가능성을 열었다.
- 특징 추출 및 예측: SAE를 이용해 품질과 관련된 비선형 특징을 추출하고 이를 회귀 모델에 입력하는 방식을 제안했다.
- CNN은 특징 추출기와 예측기 역할을 동시에 수행하기도 한다.
- 데이터 불균형 해소 (GAN의 활용): 소프트 센서 개발의 고질적인 문제는 '공정 데이터(빠른 주기)'와 '품질 데이터(느린 주기)' 간의 다중 속도 샘플링(Multirate sampling)으로 인한 데이터 불균형이다. 이를 해결하기 위해 GAN(생성적 적대 신경망)이 활용된다.
- 원리: 생성자(Generator)는 실제 데이터 분포를 모방하여 가짜 샘플을 만들고, 판별자(Discriminator)는 진위를 가려내며 경쟁적으로 학습한다.
- 효과: GAN을 통해 부족한 레이블 데이터를 증강했을 때 RMSE와 성능이 크게 향상되었다. 이는 딥러닝이 단순한 모델링 도구를 넘어, 데이터 부족 문제를 근본적으로 해결하는 데 기여하고 있음을 시사한다.
4. Results and Discussion
4.1 Industries and Algorithms
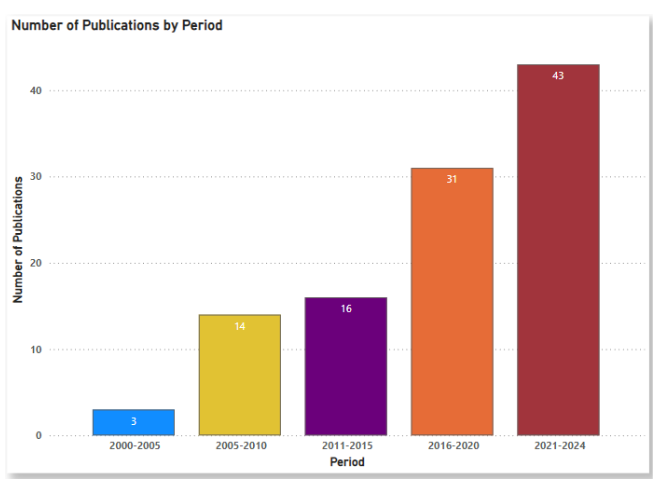
- 2000년 이후 소프트 센서 관련 연구가 급격히 증가하고 있음을 보이고 있음
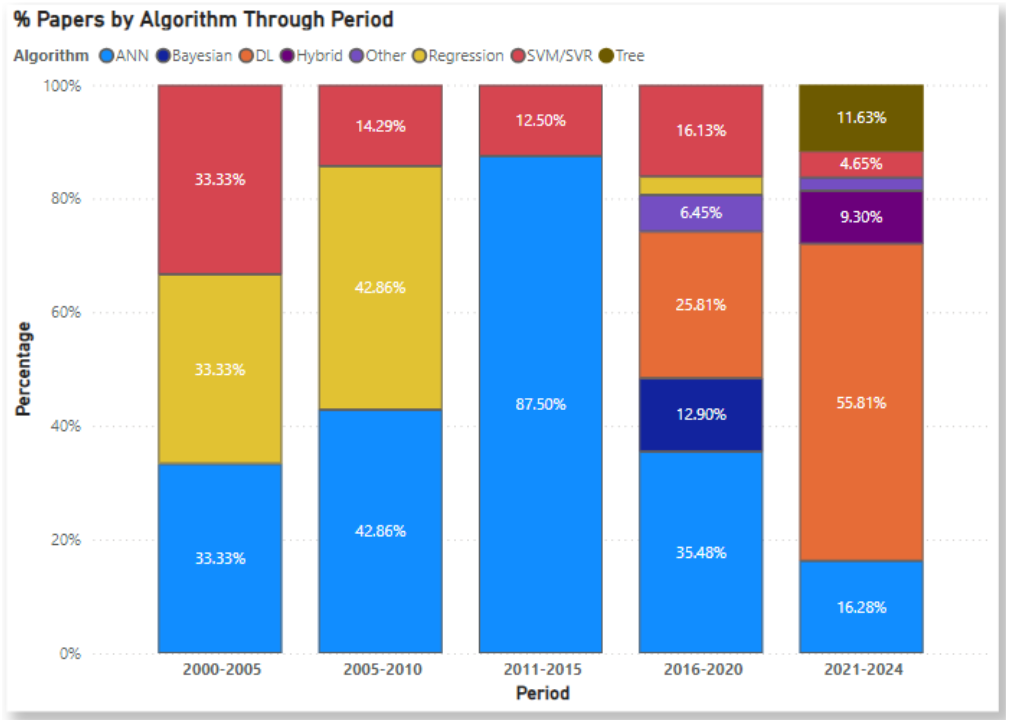
- 2000-2005년에는 선형 회귀가 1/3을 차지했으나, 2021-2024년 기간에는 딥러닝(DL) 알고리즘이 전체 논문의 약 56%를 차지할 정도로 비중이 확대되었다.
- 그럼에도 SVM/SVR, 트리 기반 모델은 그 단순성과 효율성 덕분에 여전히 널리 사용되고 있다.
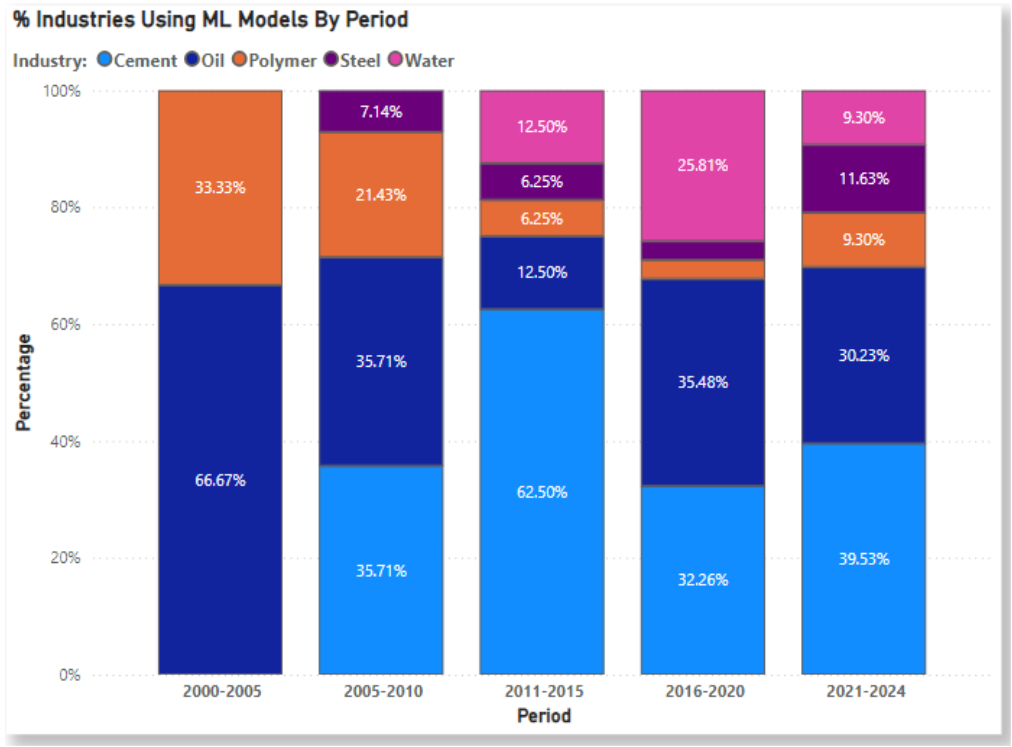
- 정유, 폴리머, 시멘트 산업이 전통적으로 가장 많은 비중을 차지하지만, 최근에는 수처리(Water treatment) 및 철강(Steel) 공정에서의 도입이 증가하고 있다.
4.2 Sampling
일반적인 경험 법칙(Rule of thumb)에 따르면, 샘플 수는 입력 파라미터(Feature) 수의 10배에서 100배가 되어야 한다. 따라서 품질 데이터의 경우 드물게 생성되는 반면 공정 데이터는 빈번하게 생성되므로 데이터 불균형이 발생한다. 이를 해결하기 위해 GAN(생성적 적대 신경망)을 활용하여 가상 샘플을 생성하고 라벨 데이터를 증강하는 연구가 활발하다.
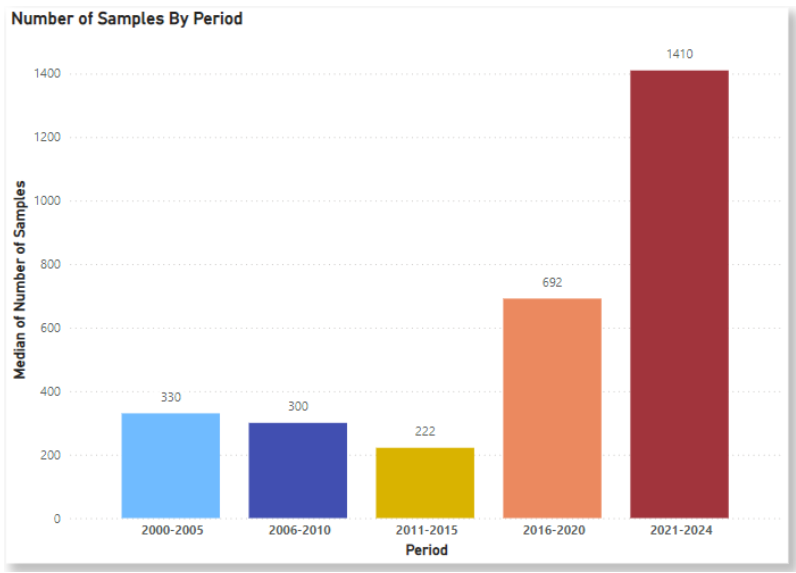
- 딥러닝 모델의 등장과 함께 요구되는 샘플 수가 급증했다.
- 예를 들어, LSTM 모델의 경우 3만 개 이상의 파라미터 학습을 위해 58,364개의 샘플이 사용되었습니다.
4.3 Metrics
모델 적합성을 평가하기 위해 다양한 지표가 사용된다.
1. 결정계수 (): 모델 예측값과 실제값의 관계를 측정하며 단위가 없다.
2. RMSE (Root-Mean-Square Error): 가장 널리 쓰이는 지표이나, 측정 단위에 의존적이라 서로 다른 공정 간 비교가 어려울 수 있다.
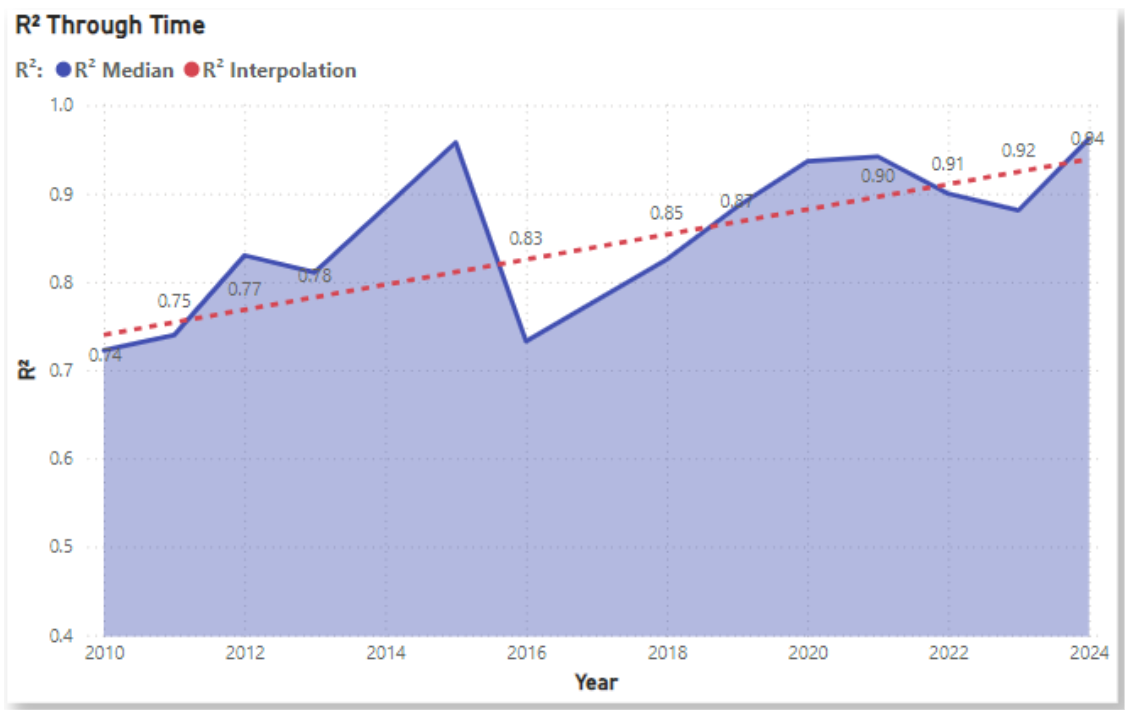
- 모델의 적합도가 시간이 지남에 따라 평균 0.74에서 0.94로 크게 향상되었음을 보여준다.
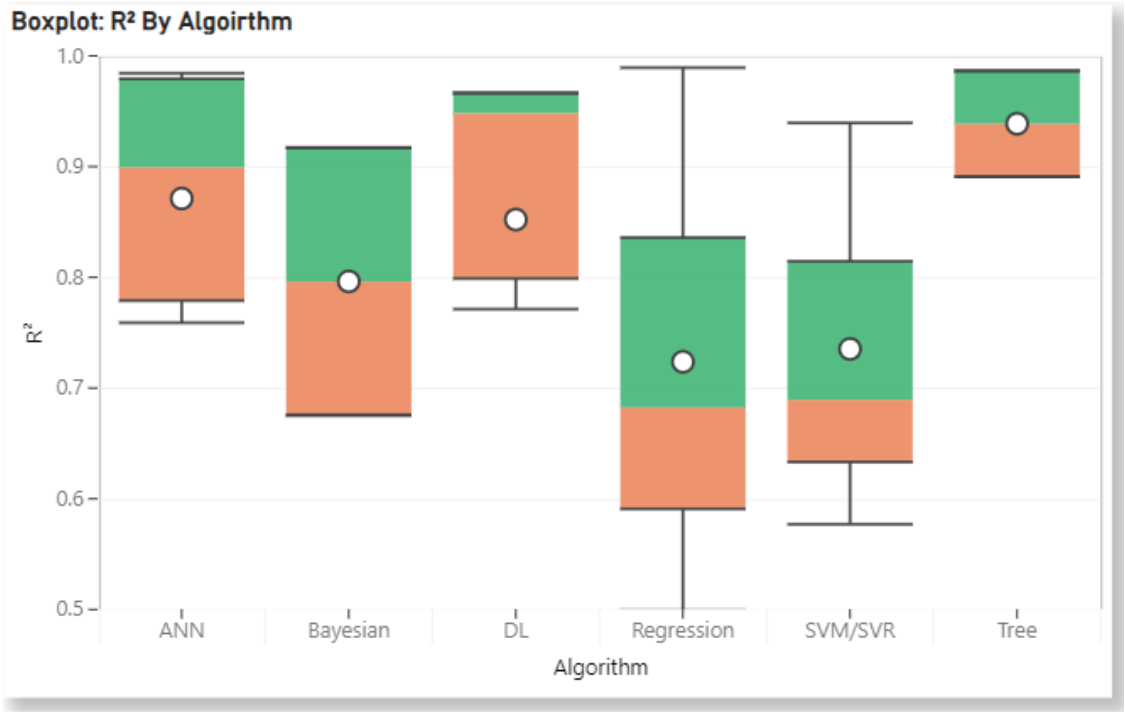
- ANN, 딥러닝(DL), 트리 기반 알고리즘이 타 모델 대비 더 높은 적합도를 달성하는 경향이 있다.
- 특히 Tree 기반 모델은 Q1과 Q3 사이의 범위(IQR)가 가장 좁게 나타나는데, 이는 다양한 연구 및 적용 환경에서도 성능 편차가 크지 않고 타 알고리즘 대비 가장 일관되고 안정적인 예측 정확도를 보임을 시사한다.
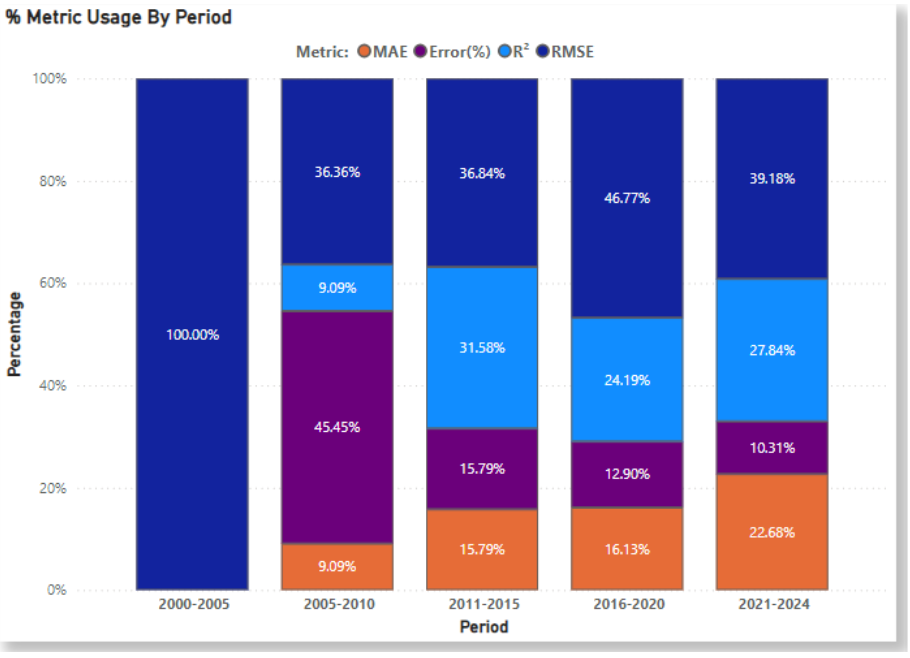
- 여전히 RMSE가 선호되지만, 최근 들어 산업 간 비교가 용이한 의 사용이 증가하고 있다.
4.4 Lightweight Models & Edge Computing
리소스가 제한적인 환경이나 빠른 응답이 필요한 경우, 클라우드 대신 엣지 컴퓨팅(Edge Computing)이 유리할 수 있다. 이를 위해 모델의 크기를 줄이는 경량화 기술이 중요해졌음을 시사한다.
-
경량화 기술 목록은 아래와 같다.
-
가중치 압축(Weight Compression): SVD 등을 통해 가중치를 줄임
-
가지치기(Pruning): 덜 중요한 가중치를 제거하여 모델 크기를 최대 90%까지 축소
-
양자화(Quantization): 파라미터를 낮은 비트 수로 변환하여 메모리 사용량 감소
-
지식 증류(Distillation): 복잡한 교사 모델(Teacher)의 지식을 작은 학생 모델(Student)에 전달하여 정확도를 유지하면서 연산량을 줄임
-
4.5 Performance Criteria
소프트 센서 알고리즘 선택 시 고려해야 할 정성적 비교 결과는 다음과 같다.
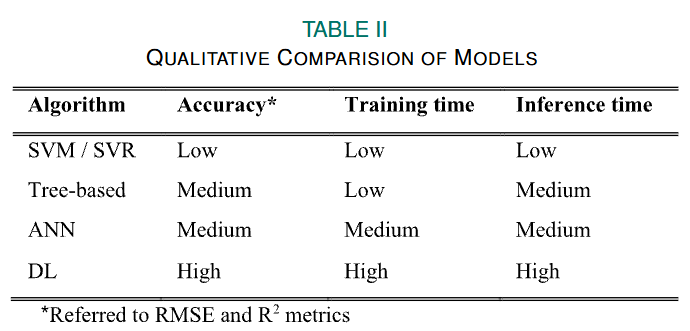
- 정확도가 최우선 목표라면 DL이나 SVM이 적합하며, 학습 속도가 중요하다면 트리 기반 알고리즘이나 KNN, Naïve Bayes가 추천된다.
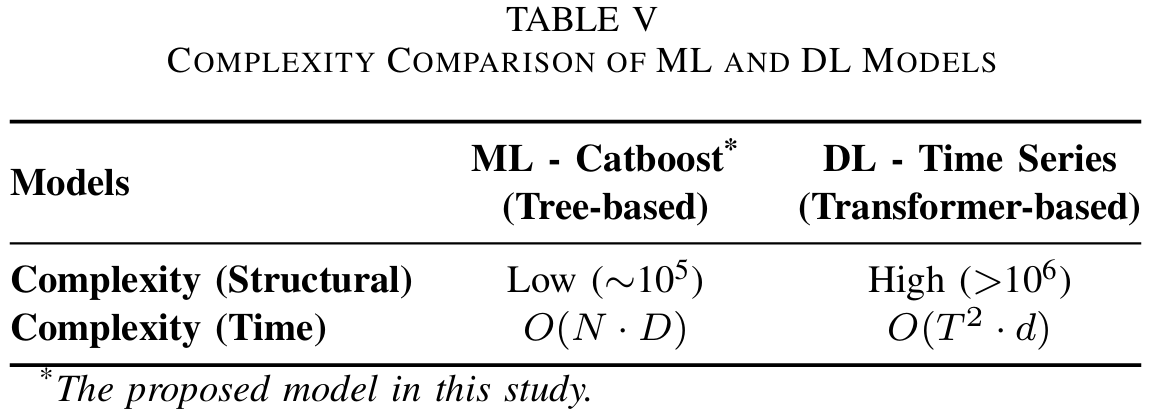
Ja Hyeob Koo, Yong Ho Song, Jae Hyeon Shim, So Yeong Lee, Young Hoon Lee, LOL: Learning with One Lightweight Sensor-Aware Predictive Model For Sleep Quality, IEEE ICTC 2025 proceeding, Jeju, 2025
- 2025 IEEE ICTC에서 직접 연구했던 표를 가져오면, Transformer 모델() 대비 선형적인 시간 복잡도()와 현저히 낮은 구조적 복잡도를 가짐으로써 실제 현장 적용성(Deployment)까지 보장한다는 점을 강력하게 뒷받침한다.
- 즉, Tree 모델은 단순히 성능의 편차가 적을 뿐만 아니라, 연산 효율성 측면에서도 딥러닝 모델 대비 압도적인 경량화가 가능하여 실시간성이 요구되는 제조 현장에 가장 최적화된 모델임을 알 수 있다.
5. Conclusion
-
연구의 급성장: 2000년 이후 머신러닝 기술의 확산과 공정 효율화(에너지 절감, 불량률 감소)에 대한 산업계의 강력한 동기가 맞물려 소프트 센서 연구가 급증했다.
-
기술의 진화: 초기 단순 선형 알고리즘에서 시작하여, 공정의 비선형성, 다중 속도 샘플링, 시간 지연 등의 복잡한 문제를 해결하기 위해 딥러닝(DL) 모델로 발전했다.
-
모델의 공존: 딥러닝이 주류가 되었으나, 자원이 제한된 환경에서는 여전히 SVM, 트리 기반 모델 등 전통적 알고리즘이 효율적인 대안으로 활용되고 있다.
-
평가 지표의 변화: 전통적으로 사용되던 RMSE 외에, 단위의 영향을 받지 않아 산업 간 성능 비교가 용이한 결정계수()의 활용이 확대되었다.
-
새로운 접근법: 개별 공정 모델의 한계와 데이터 부족 문제를 극복하기 위해, 지식을 공유하는 전이 학습(Transfer Learning)과 연합 학습(Federated Learning)이 새로운 해결책으로 부상했다.
-
향후 과제: 미래 연구는 딥러닝을 중심으로 전개되겠지만, 실시간 공정 통합을 위한 시간 제약 극복, 입력 변수의 자동 선택, 그리고 GAN 등을 활용한 부족한 라벨 데이터 생성 기술이 해결해야 할 핵심 과제로 남아있다 .