오늘의 학습 키워드
Heap
공부한 내용 본인의 언어로 정리하기
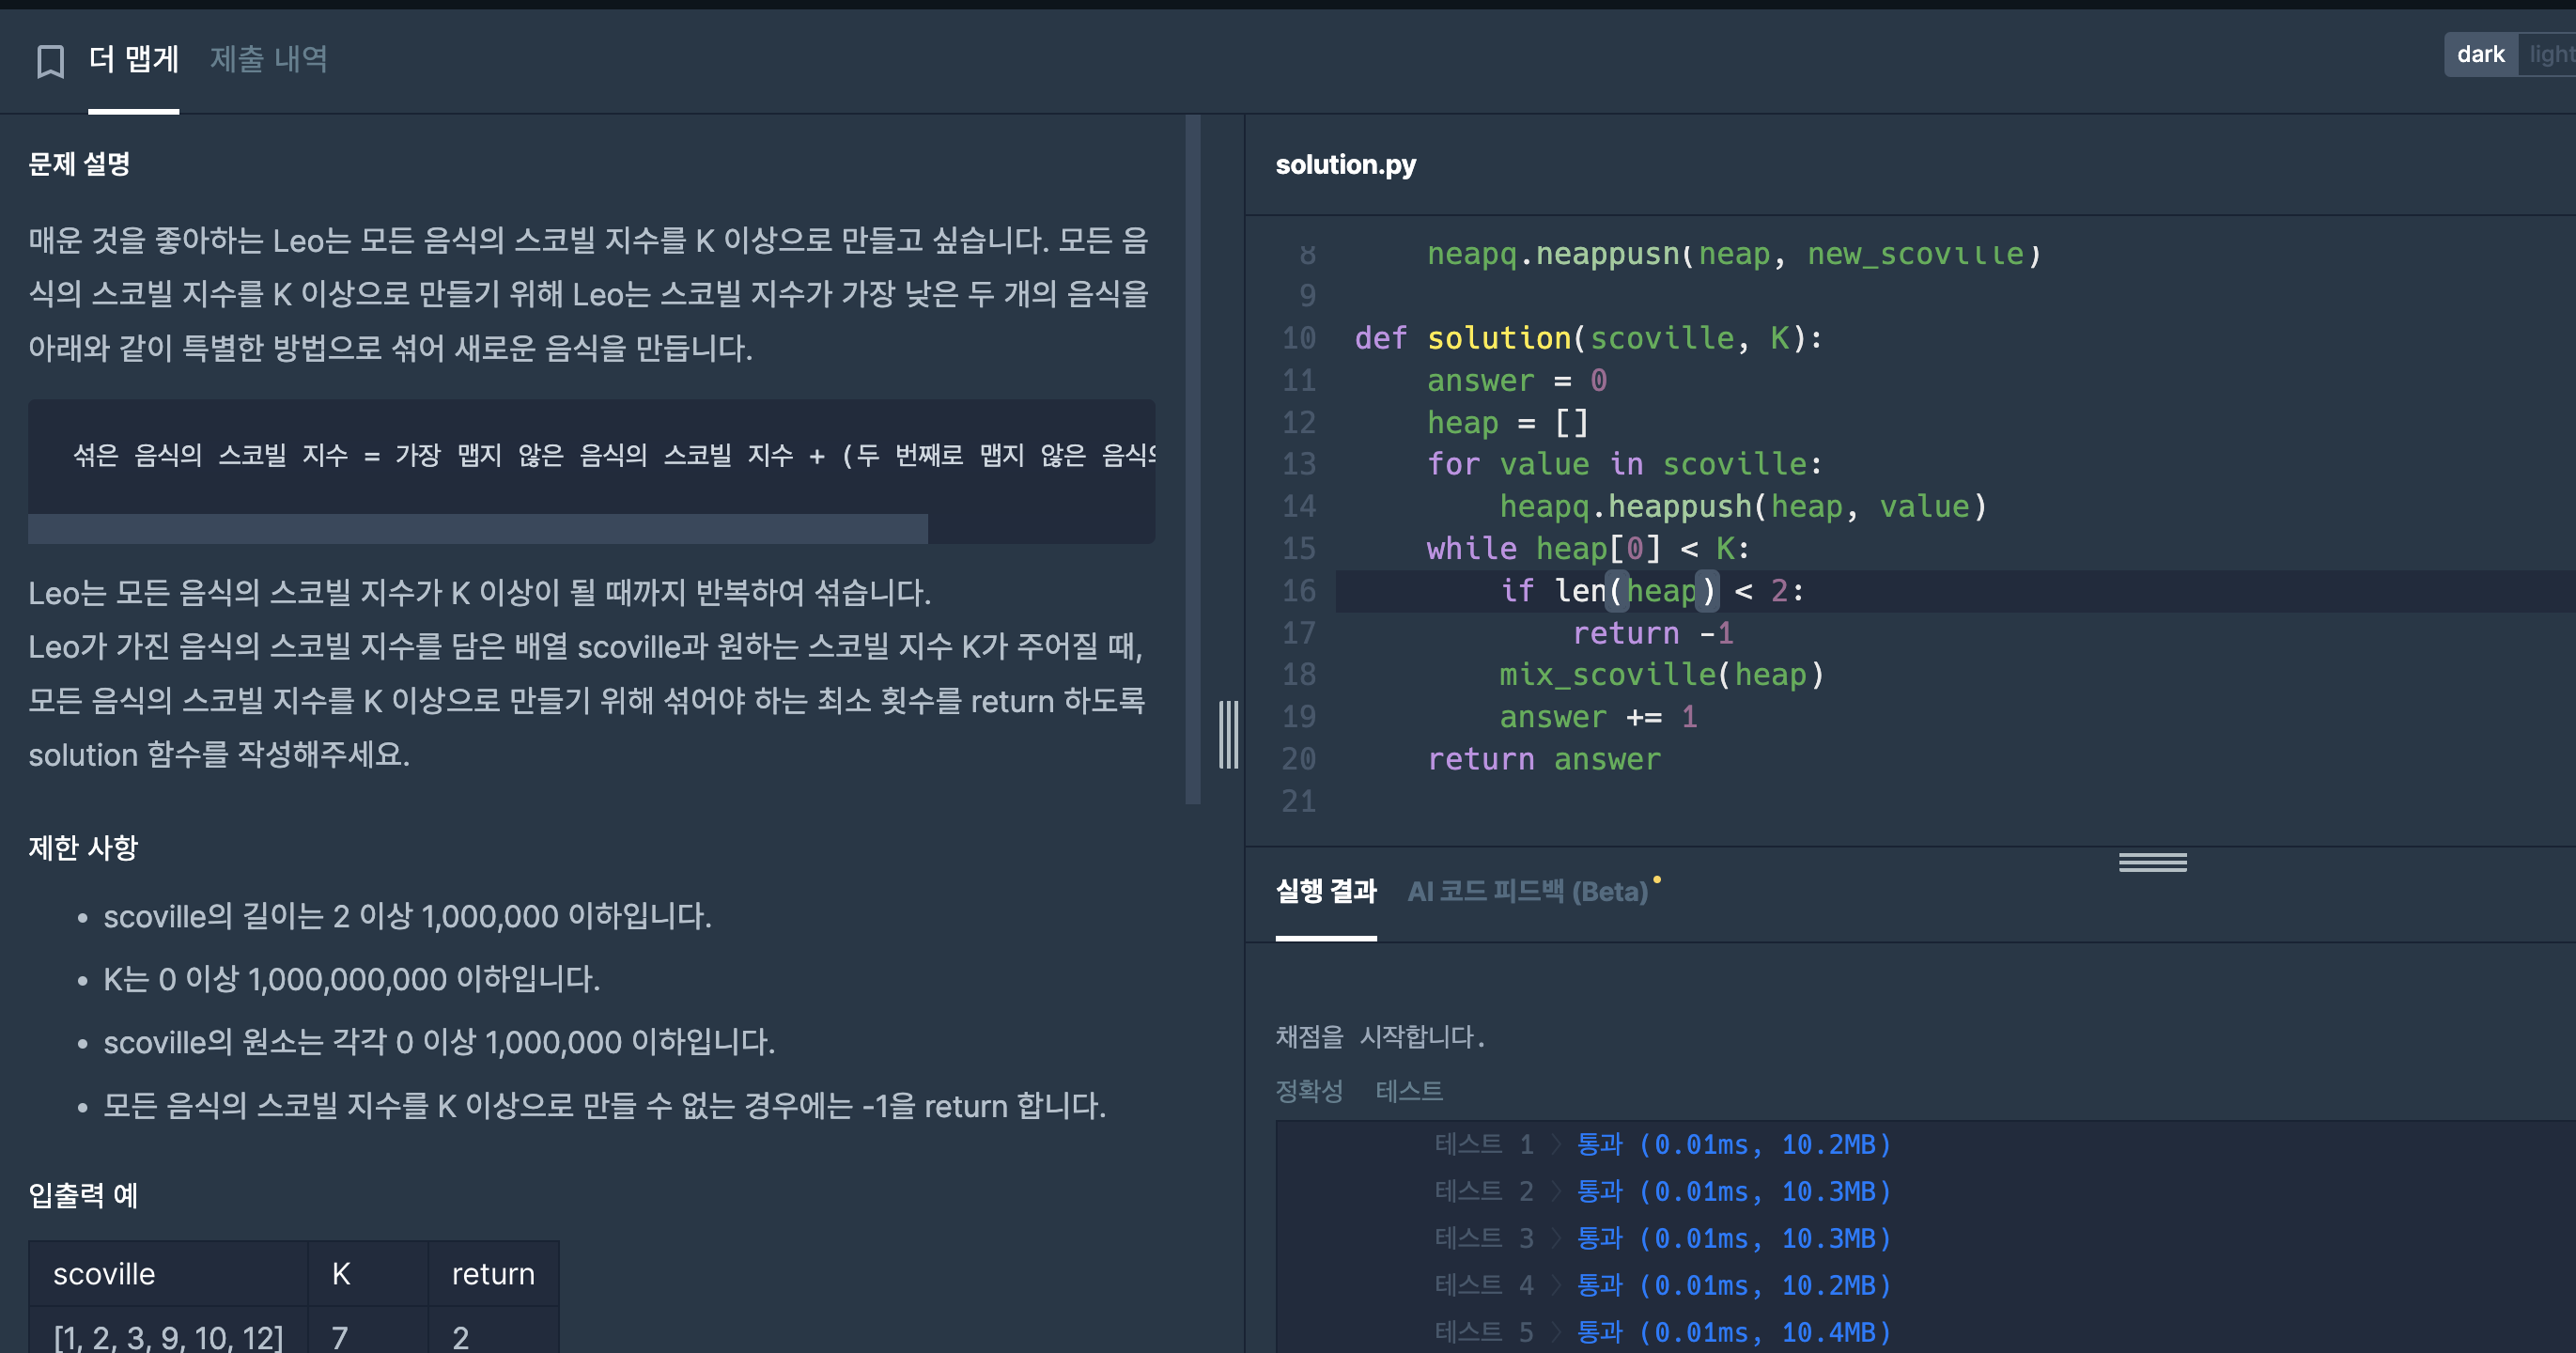
문제
- 모든 음식의 스코빌 지수를 K 이상으로 만드려고 한다. 모든 음식의 스코빌 지수를 K 이상으로 만들기 위해 스코빌 지수가 가장 낮은 두 개의 음식을 아래와 같이 특별한 방법으로 섞어 새로운 음식을 만든다
- 섞은 음식의 스코빌 지수 = 가장 맵지 않은 음식의 스코빌 지수 + (두 번째로 맵지 않은 음식의 스코빌 지수 * 2)
- Leo가 가진 음식의 스코빌 지수를 담은 배열 scoville과 원하는 스코빌 지수 K가 주어질 때, 모든 음식의 스코빌 지수를 K 이상으로 만들기 위해 섞어야 하는 최소 횟수를 return 하도록 solution 함수를 작성해주세요.
어떤 문제가 있었고, 나는 어떤 시도를 했는지
나의 첫번째 시도
from collections import deque


def func_scoville(scoville):
    arr = deque(sorted(scoville))
    first = arr.popleft()  # 최소값을 pop
    sec = arr.popleft()    # 두 번째 최소값을 pop
    new_scoville = first + (sec * 2)
    arr.appendleft(new_scoville)  # 새로운 스코빌 지수를 arr에 추가
    arr = sorted(arr)
    return list(arr)

def solution(scoville, K):
    answer = 0
    scoville = sorted(scoville)
    while scoville[0] < K:
        # 모든 음식의 스코빌 지수를 K 이상으로 만들 . 수없는경우
        if len(scoville) < 2:
            return -1
        scoville = func_scoville(scoville)
        answer += 1
    return answer
- 우선 힙이라고 해서 heap 에 대한 개념을 되새기기 위해 검색을 해봤다.
- heap 을 구현하기 위해서 deque를 사용한다고 해서 deque를 사용하여 구현하였다
- 각 음식을 정렬하였고, 작은것부터 하나씩 꺼내와서 스코빌 함수를 적용하였다
- 스코빌 함수를 통해 가장 지수가 낮은 두 음식을 섞고 arr 에 append 하는 방식
채점 결과
정확성: 83.9
효율성: 0.0
합계: 83.9 / 100.0
이러한 feedBack 을 얻었다
파이썬의
sorted함수를 사용하면 리스트 또는deque의 모든 원소를 정렬하게 되는데, 이 과정은 시간 복잡도 측면에서 비효율적입니다. 더 근본적인 문제는, 매 섞는 작업마다 전체를 다시 정렬하는 것은 필요한 작업이 아닐 수 있으며, 이러한 접근 방식은 문제를 푸는데 요구되는 '힙(Heap)' 자료구조의 특성을 활용하지 않는다는 점입니다.
문제 해결을 위한 힌트로, 파이썬에서는 최소 힙 구조를 구현하기 위해heapq모듈을 제공합니다. 따라서,func_scoville함수 대신heapq모듈을 사용하여 문제 접근 방식을 재고해보세요.
그래서 최소힙을 제대로 활용하지 않고 있다는 것을 알게되었고 deapq 를 활용하기 위한 예시를 찾아보게되었다.
from collections import deque
import heapq

def mix_scoville(heap):
    first = heapq.heappop(heap)
    sec = heapq.heappop(heap)
    new_scoville = first + (sec * 2)
    heapq.heappush(heap, new_scoville)

def solution(scoville, K):
    answer = 0
    heap = []
    for value in scoville:
        heapq.heappush(heap, value)
    while heap[0] < K:
        if len(heap) < 2:
            return -1
        mix_scoville(heap)
        answer += 1
    return answer
기존 코드와 다른점
- heapq 를 사용하여 같은 로직이지만 시간복잡도를 줄였다
무엇을 새롭게 알았는지
- heapq 사용
학습할 것은 무엇인지
- heapq에 대한 추가적인 정리 필요