[학습 일기 #37] 딥러닝 5일차 정리: 전이학습(Transfer Learning) · CV 심화(분할/탐지/생성) · Transformer/LLM
[학습 일기 시리즈]
1. 전이학습(Transfer Learning)
1.1. 전이학습이란?
- 사전학습(pre-trained) 모델이 이미 배운 지식(특징 추출 능력)을 새로운 문제에 재활용하는 방식.
- 의료 영상처럼 데이터 수집/라벨링이 비싸고 어려운 분야에서 특히 강력하다.
(라벨링에 전문 의료진 필요 → 의료 영상은 수집이 어렵고 비용이 큼) - 데이터가 적으면 딥러닝 학습이 불안정해짐
→ 그래서 보통 ImageNet 같은 대규모 데이터로 학습된 모델을 가져온다.
🩺 비유로 이해하기
새 질병을 공부하는 내과 의사가 “해부학/생리학” 같은 기본기를 재사용하듯,
모델도 “엣지/질감/패턴” 같은 기본 시각 특징은 그대로 재사용하고 마지막 결정 부분만 새로 학습한다.
1.2. 왜 전이가 가능한가? (CNN 층별 특징의 “범용성”)
CNN은 보통 아래와 같이 특징이 깊어질수록 “특화”된다.
- 초기 층: 엣지, 선, 색상 → 매우 범용(전이 쉬움)
- 중간 층: 질감, 패턴, 모양 → 전이 가능성 높음
- 깊은 층: 물체의 부분, 얼굴 등 → 전이 가능성 중간
- 마지막 층: 특정 클래스에 최적화 → 새 task에선 교체가 거의 필수
그래서 전이학습은 보통:
- 초반부(backbone)는 유지(동결)
- 마지막 분류기(FC head)만 교체/학습
1.3. 전이학습 전략 2가지: Feature Extraction vs Fine-tuning
1.3.1. Feature Extraction(특징 추출)
백본(backbone)은 동결하고, 마지막 레이어(분류기)만 학습한다.
- 장점: 빠른 학습, 적은 데이터에서도 안정적, 과적합 위험 낮음
- 단점: 성능 상한이 있을 수 있음, 도메인이 크게 다르면 효과 감소
코드) “백본 동결 + FC 교체”
import torch
import torch.nn as nn
from torchvision import models

# 사전학습된 ResNet 로드
model = models.resnet18(pretrained=True)  # ImageNet 사전학습

# 모든 파라미터 동결
for param in model.parameters():
    param.requires_grad = False

# 마지막 FC층만 교체
num_features = model.fc.in_features
model.fc = nn.Linear(num_features, num_classes)
1.3.2. Fine-tuning(미세조정)
사전학습 모델의 일부 또는 전체를 재학습한다.
- 장점: 더 높은 성능 가능, 새 도메인에 맞춤 조정
- 단점: 더 많은 데이터 필요, 과적합 위험 증가, 학습 시간 증가
코드) 전체/부분 미세조정
from torchvision import models
import torch.nn as nn

model = models.resnet18(pretrained=True)
num_features = model.fc.in_features
model.fc = nn.Linear(num_features, num_classes)

# 전략 1: 전체 미세조정
for param in model.parameters():
    param.requires_grad = True

# 전략 2: 일부만 미세조정 (마지막 몇 층만)
for name, param in model.named_parameters():
    if "layer4" in name or "fc" in name:
        param.requires_grad = True
    else:
        param.requires_grad = False
1.3.3. 전략 선택 가이드(결정 매트릭스. 참고용)
| 조건 | 추천 |
|---|---|
| 데이터 적고, 도메인 유사 | Feature Extraction |
| 데이터 많고, 도메인 유사 | Full Fine-tuning |
| 데이터 적고, 도메인 다름(의료영상 등) | Feature Extraction(주의) |
| 데이터 많고, 도메인 다름 | Fine-tuning(초기층 동결부터) |
1.4. torchvision에서 자주 쓰는 사전학습 모델들(참고)
- ResNet-18: 가벼움, 빠름(약 11M params)
- ResNet-50: 균형(약 25M)
- VGG-16: 단순 구조지만 무거움(약 138M)
- DenseNet-121: 효율적, 그라디언트 흐름 좋음(약 8M)
- EfficientNet-B0: 최신/효율적(약 5M)
1.5. 전이학습 파이프라인
Step 1) 데이터 준비: ImageNet 정규화 값 유지 + 증강 분리
사전학습 모델이 ImageNet 통계(mean/std)에 맞춰 학습됬다면, 입력 정규화도 동일하게 맞추는 게 기본이다.
import torch
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

# 검증/테스트용(고정 변환)
transform = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406],
                         std=[0.229, 0.224, 0.225])
])

# 학습용(증강 포함)
train_transform = transforms.Compose([
    transforms.RandomResizedCrop(224),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406],
                         std=[0.229, 0.224, 0.225])
])

train_dataset = datasets.ImageFolder('data/train', transform=train_transform)
val_dataset   = datasets.ImageFolder('data/val',   transform=transform)

train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
val_loader   = DataLoader(val_dataset,   batch_size=32, shuffle=False)
Step 2) 모델 수정: 백본 동결 옵션 + 분류 헤드에 Dropout 추가
import torch.nn as nn
from torchvision import models

def create_transfer_model(num_classes, freeze_backbone=True):
    model = models.resnet18(pretrained=True)

    if freeze_backbone:
        for param in model.parameters():
            param.requires_grad = False

    num_features = model.fc.in_features
    model.fc = nn.Sequential(
        nn.Dropout(0.5),
        nn.Linear(num_features, num_classes)
    )
    return model

model = create_transfer_model(num_classes=5, freeze_backbone=True)
📌 분류 헤드에 Dropout layer 추가 이유 ⭐️
데이터가 적어 특정 특징들만 집중해서 외워버릴 수 있음(즉, 과적합 위험이 크다는 말)
이를 방지하기 위해(일반화 성능을 높이기 위해) dropout을 사용.
Step 3) 학습 설정: requires_grad=True인 파라미터만 optimizer에 넣기
import torch
import torch.optim as optim
import torch.nn as nn

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model = model.to(device)

params_to_update = [p for p in model.parameters() if p.requires_grad]

criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(params_to_update, lr=0.001)
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=7, gamma=0.1)
📌 'scheduler'가 하는 일 ⭐️
- 처음에는
optimizer가 가진 학습률(lr)로 시작하고, step_size=7에폭마다- 현재 lr에
gamma=0.1을 곱해서 lr을 낮춘다.
실 사용 코드 예시
for epoch in range(num_epochs):
    train(...)
    validate(...)
    scheduler.step()  # epoch 끝날 때 lr 업데이트
1.6. Gradual Fine-tuning(단계적 미세조정)
한 번에 전체를 풀어버리면(Full FT) 과적합/불안정이 올 수 있다.
그래서 실무에선 “조금씩 풀어가는 방식”을 자주 쓴다.
전략
- Step1. FC만 학습(학습률 높게)
- Step2. 마지막 블록(layer4) + FC 학습(학습률 낮추기)
- Step3. 전체 미세조정(학습률 매우 낮게)
import torch.optim as optim

# 1단계: FC층만 학습
for param in model.parameters():
    param.requires_grad = False
for param in model.fc.parameters():
    param.requires_grad = True

optimizer = optim.Adam(model.fc.parameters(), lr=0.001)
# 학습...

# 2단계: layer4 + FC 학습
for name, param in model.named_parameters():
    if "layer4" in name or "fc" in name:
        param.requires_grad = True

optimizer = optim.Adam(
    filter(lambda p: p.requires_grad, model.parameters()),
    lr=0.0001
)
# 학습...

# 3단계: 전체 미세조정
for param in model.parameters():
    param.requires_grad = True

optimizer = optim.Adam(model.parameters(), lr=0.00001)
# 학습...
1.7. 전이학습 실전 팁
1.7.1. 층별 학습률(Discriminative LR)
백본은 아주 조금만 움직이고(작은 lr), 헤드는 더 크게 학습(큰 lr).
param_groups = [
    {'params': model.backbone.parameters(), 'lr': 1e-5},
    {'params': model.classifier.parameters(), 'lr': 1e-3}
]
optimizer = optim.Adam(param_groups)
1.7.2. 배치 크기
- Feature Extraction: 비교적 큰 배치도 가능
- Fine-tuning: 보통 작은 배치가 더 안정적(그라디언트 노이즈/과적합 방지 관점)
1.7.3. 데이터 증강
- 도메인이 다를수록(특히 의료) 증강이 더 중요해진다.
- 회전/반전/밝기/색상 조절 등을 상황에 맞게 설계.
2. CV 심화
딥러닝은 분류만 하는 게 아니라, 아래처럼 출력 형태 자체가 완전히 달라진다.
| Task | 설명 | 출력 |
|---|---|---|
| 분류(Classification) | 이미지 전체 클래스 | 클래스 라벨 |
| 탐지(Detection) | 물체 위치+클래스 | 바운딩 박스 + 클래스 |
| 분할(Segmentation) | 픽셀 단위 분류 | 분할 마스크 |
| 생성(Generation) | 새로운 데이터 생성 | 생성 이미지 |
예시를 들자면:
- 분류: X-ray로 폐렴 여부 판단
- 탐지: CT에서 종양 위치 찾기
- 분할: MRI에서 뇌 영역 구분
- 생성: 의료 데이터 증강
2.1. 이미지 분할(Segmentation) = Pixel-wise Classification
2.1.1. 분할의 종류 3가지
1) Semantic Segmentation(의미적 분할)
- 모든 픽셀을 “클래스”로 라벨링
- 같은 클래스의 여러 객체가 있어도 하나의 덩어리로 처리
- “무엇(What)”인지는 알지만 “몇 개(How many)”인지 구분이 약함
의료에서 예:
- 폐 CT: 폐 전체를 하나로 라벨링
- 뇌 MRI: 종양 전체를 하나의 영역으로 표시
2) Instance Segmentation(인스턴스 분할)
- Semantic + “개별 객체 구분”이 추가
- 같은 클래스 안에서도 사람1/사람2처럼 인스턴스 ID를 분리
의료에서 예:
- 폐 CT: 결절(종양1, 종양2) 각각 분리
- 종양 크기/개수 분석에 유리
3) Panoptic Segmentation(전경+배경 통합)
- 장면 전체를 “빠짐없이” 라벨링
- Stuff(도로/하늘 같은 배경) + Thing(사람/차 같은 객체) 모두 처리
- 자율주행에서 대표적으로 많이 씀
2.1.2. U-Net 아키텍처(의료 영상 분할의 대표 모델) ⭐️
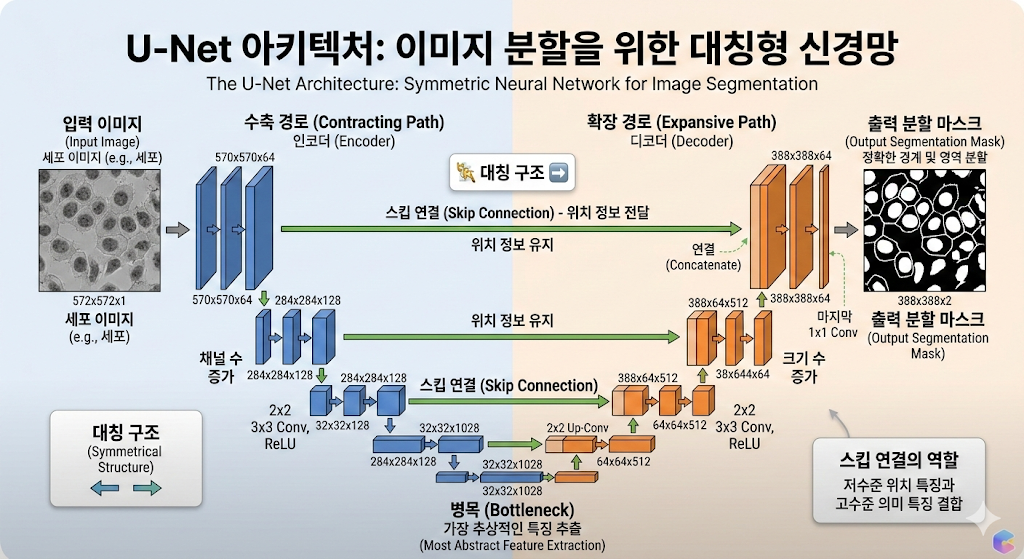
- “인코더-디코더” 구조에 Skip Connection을 붙여서,
- 인코더(왼쪽)에서 “전역 의미(요약하면서 특징 뽑기)”
DoubleConv(Conv → BN → ReLU 두 번)로 특징 추출MaxPool2d(2)로 해상도를 1/2로 줄이면서 더 큰 문맥을 보게 함- 결과: 해상도는 작아지고, 채널(특징 수)은 커짐
→ "무슨 물체인지"는 잘 아는데, "정확히 어디인지" 정보가 흐려지기 쉬움
- 병목(bottleneck) "가장 압축된 핵심 표현"
- 가장 작은 해상도에서 가장 풍부한 채널로 "전체 문맥"을 잡는 구간
- 디코더(오른쪽)에서 “공간 해상도 복원”
ConvTranspose2d로 업샘플링(해상도 복원)
- Skip Connection으로 “디테일(경계/형태)” 보존
- 인코더(왼쪽)에서 “전역 의미(요약하면서 특징 뽑기)”
PyTorch U-Net 구현(핵심 흐름)
import torch
import torch.nn as nn

class DoubleConv(nn.Module):
    """Conv → BN → ReLU → Conv → BN → ReLU"""
    def __init__(self, in_channels, out_channels):
        super().__init__()
        self.conv = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, 3, padding=1),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),
            nn.Conv2d(out_channels, out_channels, 3, padding=1),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True)
        )

    def forward(self, x):
        return self.conv(x)

class UNet(nn.Module):
    def __init__(self, in_channels=1, out_channels=1):
        super().__init__()

        # Encoder
        self.enc1 = DoubleConv(in_channels, 64)
        self.enc2 = DoubleConv(64, 128)
        self.enc3 = DoubleConv(128, 256)
        self.enc4 = DoubleConv(256, 512)
        self.pool = nn.MaxPool2d(2)

        # Bottleneck
        self.bottleneck = DoubleConv(512, 1024)

        # Decoder
        self.up4  = nn.ConvTranspose2d(1024, 512, 2, stride=2)
        self.dec4 = DoubleConv(1024, 512)

        self.up3  = nn.ConvTranspose2d(512, 256, 2, stride=2)
        self.dec3 = DoubleConv(512, 256)

        self.up2  = nn.ConvTranspose2d(256, 128, 2, stride=2)
        self.dec2 = DoubleConv(256, 128)

        self.up1  = nn.ConvTranspose2d(128, 64, 2, stride=2)
        self.dec1 = DoubleConv(128, 64)

        # Output
        self.out = nn.Conv2d(64, out_channels, 1)

    def forward(self, x):
        e1 = self.enc1(x)
        e2 = self.enc2(self.pool(e1))
        e3 = self.enc3(self.pool(e2))
        e4 = self.enc4(self.pool(e3))

        b = self.bottleneck(self.pool(e4))

        d4 = self.dec4(torch.cat([self.up4(b),  e4], dim=1))
        d3 = self.dec3(torch.cat([self.up3(d4), e3], dim=1))
        d2 = self.dec2(torch.cat([self.up2(d3), e2], dim=1))
        d1 = self.dec1(torch.cat([self.up1(d2), e1], dim=1))

        return self.out(d1)

model = UNet(in_channels=1, out_channels=1)  # 흑백 입력, 이진 분할
📌 'd4 = self.dec4(torch.cat([self.up4(b), e4], dim=1))'의 해석 ⭐️
self.up4(b): 업샘플한 “요약 정보(문맥)”e4: 인코더에서 저장해둔 “디테일/경계 정보”torch.cat(..., dim=1): 채널 방향으로 붙임(Concatenate)
즉, “큰 그림(문맥)” + “디테일(경계)”를 합쳐서 픽셀 단위로 더 정확하게 만드는 구조
2.1.3. 분할 손실 함수: BCE / CE / Dice
이진 분할
- 상황: 픽셀마다 “병변(1) vs 배경(0)”처럼 2가지 중 하나
- 출력: (H, W) 픽셀마다 “병변일 확률”
- 모델 출력: pred_logits shape = (B, 1, H, W) 또는 (B, H, W)
- 정답 마스크: target shape = (B, 1, H, W) (0/1)
- 보통 마지막에 sigmoid를 쓰는데, PyTorch는 안정성 때문에 BCEWithLogitsLoss를 자주 사용(내부에서 sigmoid 포함_이유)
criterion = nn.BCEWithLogitsLoss()다중 클래스 분할
- 상황:
- 픽셀마다 클래스가 3개 이상 (예: 배경/폐/심장/뼈 …)
- 각 픽셀은 딱 1개 클래스(서로 배타적)로 정해짐
- 출력:
- 모델 출력(로그릿): (B, C, H, W)
- C개의 “클래스 점수 맵”이 쌓여있다고 보면 됨
- 정답 마스크: (B, H, W)
- 각 픽셀에 0~C-1 정수 라벨
- 모델 출력(로그릿): (B, C, H, W)
criterion = nn.CrossEntropyLoss()Dice Loss(의료 영상에서 자주 사용) ⭐️
예시:
- 배경 픽셀 99,000개
- 병변 픽셀 1,000개
이때 BCE/CE만 쓰면 모델이 이런 “편법”을 쓸 수 있다:
- 전부 배경이라고 찍어도 정확도(accuracy)는 99%가 나옴 → 하지만 병변을 하나도 못 잡음
그래서 Dice는 “겹치는 정도”를 목표로 한다.
(“예측한 병변 영역”과 “정답 병변 영역”이 얼마나 많이 겹치냐)
- 상황:
- 병변이 작아서 클래스 불균형이 심한 경우에 유리한 편
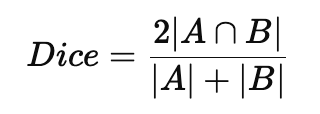
- 분자: 겹친 픽셀(진짜로 맞춘 병변)
- 분모: 예측 병변 크기 + 정답 병변 크기 → 병변이 작아도 “겹침”을 직접 키우는 방향으로 학습됨
그래서 Dice Loss는:
- 작은 병변(희소한 양성)을 잡는 데 유리한 편
- 실제로는 CE/BCE + Dice를 섞어서 쓰는 경우가 많다
- CE/BCE: 픽셀 단위 분류 안정성
- Dice: 겹침 최적화(불균형 대응)
📌 의문 1. 그럼 Dice는 클수록 좋은 지표 아닌가?
- 그래서 Dice Loss = (1 - Dice)의 형태(아래 코드의 return 값이 이를 표현)
- 변형
- Negative Dice Loss = −Dice
- Log Dice Loss = −log(Dice) (안정성/스케일 조절 목적)
📌 의문 2. DiceLoss는 미분을 어떻게 하지?
- pred는 sigmoid를 통과한 확률(0~1) 로 만들고,
- 그 확률을 그대로 교집합/합에 넣는다.
즉, 집합 연산처럼 보이지만 실제로는:
intersection = Σ (p_i * y_i)sum_p = Σ p_isum_y = Σ y_i (상수)
이건 전부 덧셈/곱셈/나눗셈이라 미분 가능하다.
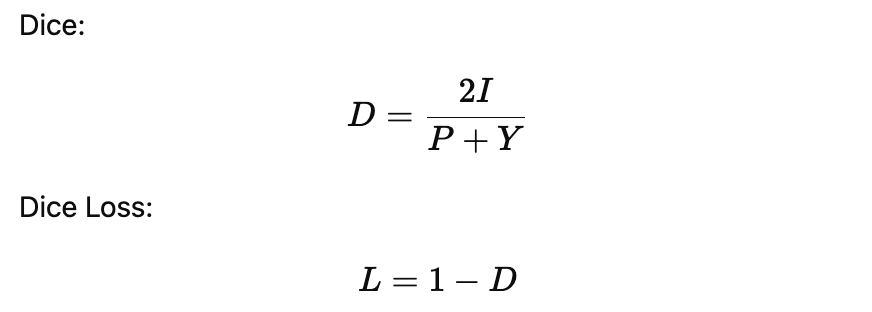
- : sigmoid(pred_logit) (예측 확률)
- : 정답
- (상수)
이때 특정 픽셀 에 대한 미분은 (형태만 보면):
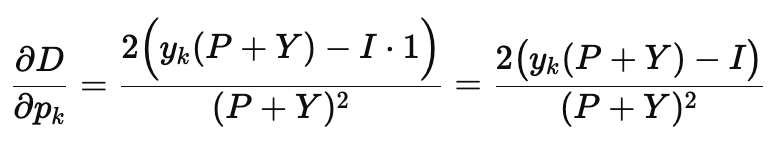
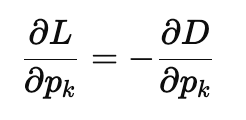
- (정답이 병변인 픽셀)이라면
→ 대체로 를 올리는 방향으로 그라디언트가 생김 - (정답이 배경인 픽셀)이라면
→ 대체로 를 내리는 방향으로 그라디언트가 생김
근데 BCE와 차이가 나는 부분은:
✅ Dice는 “전역 합(P, I)”이 들어가서 전체 픽셀 상황을 보며 업데이트가 걸린다
- BCE: 각 픽셀을 거의 독립적으로 혼냄(로컬)
- Dice: “전체 예측 마스크 크기(P)”와 “전체 겹침(I)”을 같이 보고 혼냄(글로벌)
그래서 병변이 작을 때 Dice가 강해지는 이유가 여기서 나온다:
- BCE는 배경 픽셀이 너무 많아서 gradient가 배경 쪽으로 쏠릴 수 있고
- Dice는 “병변을 맞춘 겹침(I)”을 키우는 게 목표라 작은 병변도 더 강하게 당겨줌
코드 예시
class DiceLoss(nn.Module):
    def forward(self, pred, target):
        smooth = 1e-5
        pred = torch.sigmoid(pred)
        intersection = (pred * target).sum()
        return 1 - (2. * intersection + smooth) / (pred.sum() + target.sum() + smooth)
2.2. 객체 탐지(Object Detection)
이미지에서 객체의 위치(바운딩 박스)와 클래스를 동시에 예측.
탐지는 보통 1개 객체당:
- 박스 좌표 (x1,y1,x2,y2) 혹은 (x,y,w,h)
- 클래스 라벨
- confidence score(“진짜 객체일 확률”)
이 출력된다.
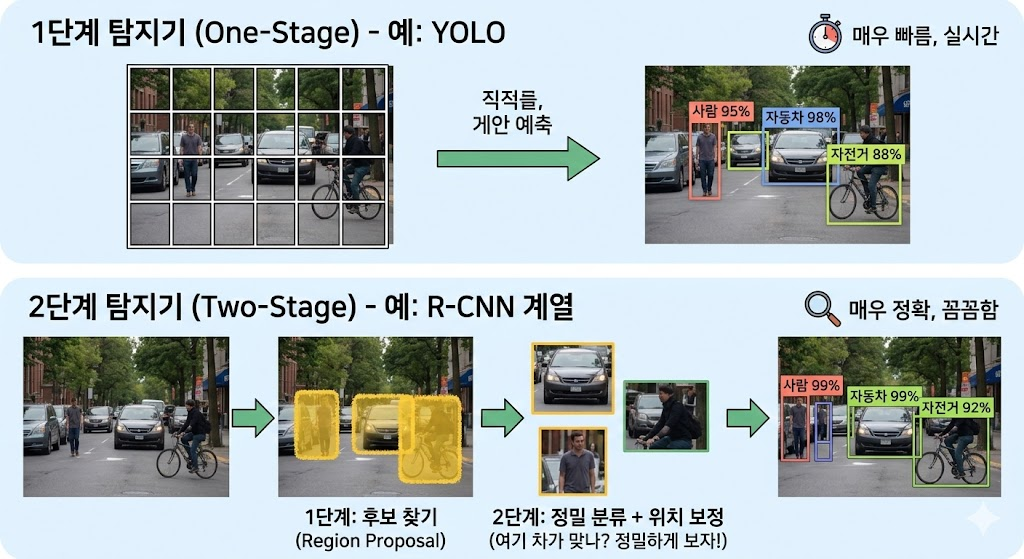
2.2.1. 1단계 탐지기(One-Stage)
한 번에 “여기 객체 있어?” + “어떤 클래스야?” + “박스는 어디야?”를 동시에 예측
- YOLO(You Only Look Once)
- SSD(Single Shot Detector)
- 빠른 속도, 실시간 처리 가능
- 단점: 아주 정밀한 위치/작은 객체에서 two-stage보다 불리한 경우가 있었음(요즘은 많이 개선)
YOLO
- 핵심 아이디어
- 이미지를 그리드로 나누고(마치 바둑판처럼),
- 각 칸이 “내가 맡은 영역에 객체가 있으면 박스/클래스를 예측”
- 마지막에 NMS로 겹치는 박스를 정리
2.2.2. 2단계 탐지기(Two-Stage)
2단계로 나눔
1) “객체일 것 같은 후보 박스들”을 먼저 뽑고(Region Proposal)
2) 그 후보에 대해 “정확한 분류 + 박스 보정”을 함
- R-CNN 계열(Fast R-CNN, Faster R-CNN)
- Region Proposal → Classification
- 높은 정확도(특히 작은 객체/정밀 위치)
- 단점: 느림(실시간엔 부담)
One-Stage vs. Two-Stage
2.2.3. 탐지 평가 지표: IoU와 mAP ⭐️
IoU(Intersection over Union)
예측 박스와 정답 박스가 얼마나 겹치는지((겹치는 부분의 넓이) / (두 박스를 합친 전체 넓이))
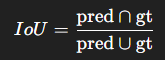
- IoU=1: 완벽히 겹침
- IoU=0: 전혀 안 겹침
mAP(mean Average Precision)
클래스별 AP(정밀도-재현율 곡선 아래 면적)를 평균낸 값
mAP는 대략 이렇게 만들어진다:
1) confidence score(“진짜 객체일 확률”) 높은 박스부터 정렬
2) 임계값을 바꿔가며 precision-recall 곡선을 그림
3) 그 곡선 아래 면적이 AP
4) 모든 클래스의 AP 점수를 다 더한 뒤, 클래스 개수로 나눈 것이 mAP
mAP가 높다 → 컴퓨터가 다양한 종류의 물체를 전반적으로 아주 잘 탐지한다
cf)mAP@0.5의 의미:
- "IoU가 0.5 이상이면 정답으로 인정해주겠다"는 기준 하에 계산한 mAP 점수
2.3. 생성 모델(Generative Models)
2.3.1. GAN(Generative Adversarial Network)
위조지폐범과 경찰의 끝없는 숨바꼭질
- 생성자(G): 가짜 이미지를 만든다
- 판별자(D): 진짜/가짜를 구분한다
→ 둘이 경쟁하면서 균형점으로 간다.- 한계:
- 둘 중 하나가 너무 강해지면 학습이 망가짐
- 생성자가 판별자를 속이기 쉬운 '꼼수(예: 똑같이 생긴 고양이만 계속 그리기)'를 발견하면, 다양한 이미지를 만들지 못하는 "모드 붕괴(Mode Collapse)" 현상이 발생
- 한계:
간단 GAN 구현(MLP 버전)
import torch
import torch.nn as nn

class Generator(nn.Module):
    def __init__(self, latent_dim=100, img_channels=1, img_size=28):
        super().__init__()
        self.model = nn.Sequential(
            nn.Linear(latent_dim, 256),
            nn.LeakyReLU(0.2),
            nn.Linear(256, 512),
            nn.LeakyReLU(0.2),
            nn.Linear(512, 1024),
            nn.LeakyReLU(0.2),
            nn.Linear(1024, img_channels * img_size * img_size),
            nn.Tanh()
        )
        self.img_shape = (img_channels, img_size, img_size)

    def forward(self, z):
        img = self.model(z)
        return img.view(img.size(0), *self.img_shape)

class Discriminator(nn.Module):
    def __init__(self, img_channels=1, img_size=28):
        super().__init__()
        self.model = nn.Sequential(
            nn.Flatten(),
            nn.Linear(img_channels * img_size * img_size, 512),
            nn.LeakyReLU(0.2),
            nn.Linear(512, 256),
            nn.LeakyReLU(0.2),
            nn.Linear(256, 1),
            nn.Sigmoid()
        )

    def forward(self, img):
        return self.model(img)

def train_gan(generator, discriminator, dataloader, epochs=100):
    criterion = nn.BCELoss()
    opt_g = torch.optim.Adam(generator.parameters(), lr=0.0002)
    opt_d = torch.optim.Adam(discriminator.parameters(), lr=0.0002)

    for epoch in range(epochs):
        for real_imgs, _ in dataloader:
            batch_size = real_imgs.size(0)

            real_labels = torch.ones(batch_size, 1)
            fake_labels = torch.zeros(batch_size, 1)

            # Discriminator
            z = torch.randn(batch_size, 100)
            fake_imgs = generator(z)

            d_real = discriminator(real_imgs)
            d_fake = discriminator(fake_imgs.detach())
            d_loss = criterion(d_real, real_labels) + criterion(d_fake, fake_labels)

            opt_d.zero_grad()
            d_loss.backward()
            opt_d.step()

            # Generator
            z = torch.randn(batch_size, 100)
            fake_imgs = generator(z)
            d_fake = discriminator(fake_imgs)
            g_loss = criterion(d_fake, real_labels)

            opt_g.zero_grad()
            g_loss.backward()
opt_g.step()🕵️♂️ Discriminator (판별자) 훈련 과정
1) z = torch.randn(batch_size, 100)
- 위조지폐를 만들 빈 종이와 잉크(랜덤 노이즈)를 준비
2) fake_imgs = generator(z)
- 위조지폐범(생성자)에게 빈 종이를 주면서 "가짜 이미지 좀 만들어봐"라고 시킴
3) d_real = discriminator(real_imgs)
- 경찰(판별자)에게 진짜 이미지를 보여주며 감정. (목표: "이건 1(진짜)이야!"라고 맞추기)
4) d_fake = discriminator(fake_imgs.detach())
- 경찰에게 방금 만든 가짜 이미지를 보여주며 감정. (목표: "이건 0(가짜)이야!"라고 맞추기)
5) d_loss = ... 및 업데이트
- 경찰이 얼마나 잘 맞췄는지 점수를 매기고, 더 잘 구분하도록 경찰의 능력을 업데이트(학습).
💡 보너스 지식: .detach()는 왜 있는가?
- 지금은 '경찰(판별자)만' 훈련시키는 시간.
- 가짜 이미지를 경찰에게 보여주고 경찰의 성적을 매기는데, 이때 위조지폐범(생성자)의 성적까지 같이 매겨져서 위조지폐범이 학습되어 버리면 안 됨.
- 가짜 이미지에서 생성자로 연결되는 연결 고리를 싹둑 잘라버리는 가위 역할. ("이 가짜 이미지를 만든 위조지폐범 쪽으로는 학습 신호(오차)를 보내지 마!"라고 차단해서, 판별자만 깔끔하게 학습할 수 있게 함.)
그럼 아래쪽 Generator 학습에 z = ...가 또 있는 이유는?
- 경찰(판별자)이 방금 막 훈련을 받고 조금 더 똑똑해졌음
- 그러면 위조지폐범(생성자)도 가만히 있으면 안 됨
- 똑똑해진 경찰을 속이기 위해 새로운 노이즈(z)로 완전히 새로운 가짜 지폐(fake_imgs)를 다시 만들어서, "이번엔 속일 수 있을까?" 하고 다시 시험해 보며 스스로를 훈련(Generator 학습)해야 하기 때문
2.3.2. Diffusion Models(확산 모델)
모래성을 부수고, 부서진 역순으로 다시 쌓기
- 핵심 아이디어:
- Forward: 이미지에 점진적으로 노이즈를 더해 결국 순수 노이즈로 만들기
- Reverse: 노이즈에서 이미지를 복원하는 과정을 학습하기
즉, 모델이 하는 일은:
“이 정도로 망가진 이미지에서, 노이즈를 얼마나 빼야 하나?”를 반복적으로 배우는 것
- 특징
- 생성 품질이 매우 좋고 학습이 안정적인 편
- 목표가 잘게 쪼개져 있어서 배우기 쉽기 때문
- 수학적으로 훈련 목표가 아주 명확해서 꼼수를 부리지 않고 데이터의 모든 디테일을 정직하게 다 외워버림 → 훨씬 더 다양하고 정교한 이미지 탄생 가능
- 대신 샘플링(이미지 생성 과정)이 여러 스텝이라 느릴 수 있음(요즘은 가속 방법이 많아짐)
- 처음에는 완전한 지지직거리는 TV 노이즈(스텝 1000)에서 시작
- 모델이 이 노이즈를 보고 "음, 이건 0.1% 정도 고양이의 윤곽선 노이즈 같아"라며 아주 미세하게 노이즈를 한 꺼풀 벗겨냄(스텝 999).
- 벗겨진 이미지를 다시 모델에 넣고 "이번엔 여기서 또 노이즈를 빼봐"라고 시킴(스텝 998).
- 이 과정을 수십 번에서 수백, 수천 번(여러 스텝) 반복
- 생성 품질이 매우 좋고 학습이 안정적인 편
- 대표 계열로 DDPM이 유명하다.
코드 예시
# 1. 원본 이미지(x_0)와 랜덤 스텝(t) 고르기
# 2. 순수한 노이즈(noise)를 무작위로 생성
noise = torch.randn_like(x_0)

# 3. 위에서 본 '수학의 마법' 공식(가우시안 분포 성질을 이용한 공식)으로 t번째 망가진 이미지(x_t) 한번에 생성
x_t = q_sample(x_0, t, noise)

# 4. 인공지능(U-Net)에게 망가진 이미지(x_t)와 현재 스텝(t)을 주고 노이즈를 예측
predicted_noise = unet(x_t, t)

# 5. 오차(Loss) 계산: 실제 넣었던 노이즈(noise)와 AI가 예측한 노이즈(predicted_noise)의 차이
loss = MSE(noise, predicted_noise)

# 6. 오차를 줄이는 방향으로 AI 업데이트 (학습)
loss.backward()
optimizer.step()
2.3.3. VAE(Variational Autoencoder): “잠재공간을 확률분포로 만들기”
오토인코더는 이미지를 아주 작은 '숫자들의 압축본(잠재 공간)'으로 만듦.
하지만 VAE는 한 발 더 나아가, 압축본을 고정된 숫자가 아니라 '범위(확률 분포)'로 만듦.
- 기존: "이 얼굴의 눈 크기는 5, 코 길이는 3이야."
- VAE: "이 얼굴의 눈 크기는 평균() 5이고 오차범위() 1 정도에서 변할 수 있어."
이렇게 여지를 두면 비슷한 듯 다른 새로운 이미지를 부드럽게 만들어낼 수 있다.
여기서 문제!
-
모델이 스스로 오답 노트를 쓰며 발전하려면, 역전파(Backpropagation) 계산 과정이 수학적으로 쭉 이어져 있어야 한다.
-
하지만 중간에 '랜덤 주사위 던지기(샘플링)'가 들어가면 계산의 맥락이 뚝 끊겨버린다.
- 여기서 샘플링이란?
- 인코더의 결과물: "이 강아지를 그리려면 털의 길이는 평균() 5cm로 하되, 오차범위() 1cm 안에서 적당히 아무 길이나 골라서 그려라."
- 그림을 그리려면 위의 범위 안에서 아무 숫자나(랜덤으로) 골라야 함.
- 이렇게 주어진 범위(평균과 표준편차) 안에서 실제 사용할 값 하나()를 무작위로 쏙 뽑아내는 행위, 이것이 바로 '샘플링(주사위 던지기)'이며, 인코더와 디코더 딱 중간에서 일어남.
→ 이걸 해결하는 속임수 = Reparameterization Trick(재매개변수화 기법) - 주사위 던지기를 밖으로 빼버리는 것.
("랜덤 주사위를 굴리긴 굴리되, 인코더가 책임지는 구역 밖에서 굴리자") - (평균): 인코더가 계산해서 정하는 값 (예: 5)
- (표준편차): 인코더가 계산해서 정하는 값 (예: 1)
- (순수한 주사위): 항상 평균이 0이고 표준편차가 1인 아주 표준적인 주사위. (인코더와 상관없이 그냥 외부에서 항상 똑같은 '기본 주사위'를 굴려 나온 숫자. 예: 0.2)
- 즉, 는 랜덤의 성격을 가지지만 상수인 셈(수식이 미분 가능해짐)
→ 랜덤성은 유지하면서도 컴퓨터가 수학적으로 학습할 수 있는 연결고리가 살아남음.
- 여기서 샘플링이란?
-
특징
- 잠재공간이 구조적으로 깔끔해서 조작/보간이 쉬움
- 대신 GAN/diffusion에 비해 샘플이 흐릿해지는 경향이 있었음(설계에 따라 개선 가능)
import torch
import torch.nn as nn

class VAE(nn.Module):
    def __init__(self, input_dim=784, hidden_dim=400, latent_dim=20):
        super().__init__()
        self.encoder = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.ReLU()
        )
        self.fc_mu  = nn.Linear(hidden_dim, latent_dim)
        self.fc_var = nn.Linear(hidden_dim, latent_dim)

        self.decoder = nn.Sequential(
            nn.Linear(latent_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, input_dim),
            nn.Sigmoid()
        )

    def encode(self, x):
        h = self.encoder(x)
        return self.fc_mu(h), self.fc_var(h)

    def reparameterize(self, mu, log_var):
        std = torch.exp(0.5 * log_var)
        eps = torch.randn_like(std)
        return mu + eps * std

    def decode(self, z):
        return self.decoder(z)

    def forward(self, x):
        mu, log_var = self.encode(x.view(-1, 784))
        z = self.reparameterize(mu, log_var)
        return self.decode(z), mu, log_var
3. Transformer와 LLM
3.0. RNN의 한계: 순차 처리의 굴레
LSTM이 기울기 소실을 어느 정도 완화했지만, 여전히 구조적 한계가 남는다.
- 병목: t=100 정보를 처리하려면 t=1~99를 순서대로 거쳐야 함
- 장거리 의존성: 먼 거리 정보 전달이 어려움
- 병렬 처리 불가: GPU 병렬 연산을 제대로 활용하기 어렵다
- 고정 크기 벡터로 압축: 시퀀스 전체 정보를 한 벡터에 욱여넣는 문제가 생기기 쉬움
3.1. Self-Attention의 등장: “직접 연결”
Self-Attention은 시퀀스 내 모든 위치가 서로를 참고할 수 있게 해서
멀리 떨어진 토큰끼리도 바로 상호작용할 수 있다.
각 토큰이:
- “내가 지금 필요한 정보가 뭐지?”를 기준으로
- 다른 토큰들을 쭉 훑고
- 중요한 토큰의 정보를 더 많이 섞어서 새 표현을 만든다
3.2. Q, K, V ⭐️
문장 속에 "Bank"라는 단어가 있다고 치자.
이게 은행인지 강둑인지 의미를 정확히 알려면 주변 단어들에게 물어봐야 한다.
- Query (Q, 질문):
- "Bank" 토큰이 주변에 묻는다.
- "나 지금 돈이랑 관련된 의미인지, 물이랑 관련된 의미인지 헷갈려.
나한테 힌트 줄 단어 있어?"
- Key (K, 명찰):
- 주변 단어들은 각자 명찰을 달고 있다.
- 예를 들어 'River(강)' 토큰은 "나는 물과 관련된 명사야"라는 명찰을, 'Deposit(입금)' 토큰은 "나는 돈과 관련된 동사야"라는 명찰을 달고 있다.
- Value (V, 진짜 정보):
- 그 단어들이 가진 실제 의미값.
절차:
1) Q로 K들을 전부 비교해서 “관련도 점수”를 만든다 (내적. dot product)
→ 값이 크다? = "서로 유사도가 높다, 관련이 깊다"
2) 점수가 너무 커지면 softmax가 극단적으로 쏠리니까 로 나눠 안정화(이게 Scaled Dot-Product Attention)
3) "Bank"의 Q와 "Deposit"의 K를 곱했더니 값이 아주 크게 나왔다.
→ 서로 강한 선(Attention Weight)으로 연결되고, "Deposit"이 가진 V(의미 정보)를 "Bank"에게 듬뿍 넘겨준다.
3.3. 가중치(W)는 사람의 의도 없이 스스로 Q, K, V의 역할을 어떻게 알까?
-
수식의 강제성:
사람은 네트워크 구조를 짤 때, 를 한 다음 거기에 를 곱하라고 수식을 고정해 둔다. 이 수식의 형태 자체가 '정보 검색(Information Retrieval)'의 구조를 띠고 있다. -
오답 노트(Backpropagation)의 마법:
처음에는 모두 아무 의미 없는 랜덤 숫자로 시작한다.
당연히 번역 결과는 엉망진창이 되고, 오차(Loss)가 엄청나게 커진다.
컴퓨터는 이 오차를 줄이기 위해 미분을 하며 가중치 숫자를 조금씩 바꾼다. -
역할의 자연스러운 분담:
오차를 가장 효과적으로 줄이려면 어떻게 해야 하는가?
모델 스스로 "아, 첫 번째 거울()은 다른 단어를 찾는 '질문' 형태로 숫자를 가공하고, 두 번째 거울()은 내 정체성을 나타내는 '명찰' 형태로 숫자를 가공해서 둘을 곱해야 오차가 확 줄어드는구나!"라는 것을 데이터를 수십억 번 보면서 수학적으로 깨닫게 된다.
3.3.1. 이를 표현한 이미지(행렬 이미지는 오류가 있을 수 있음)
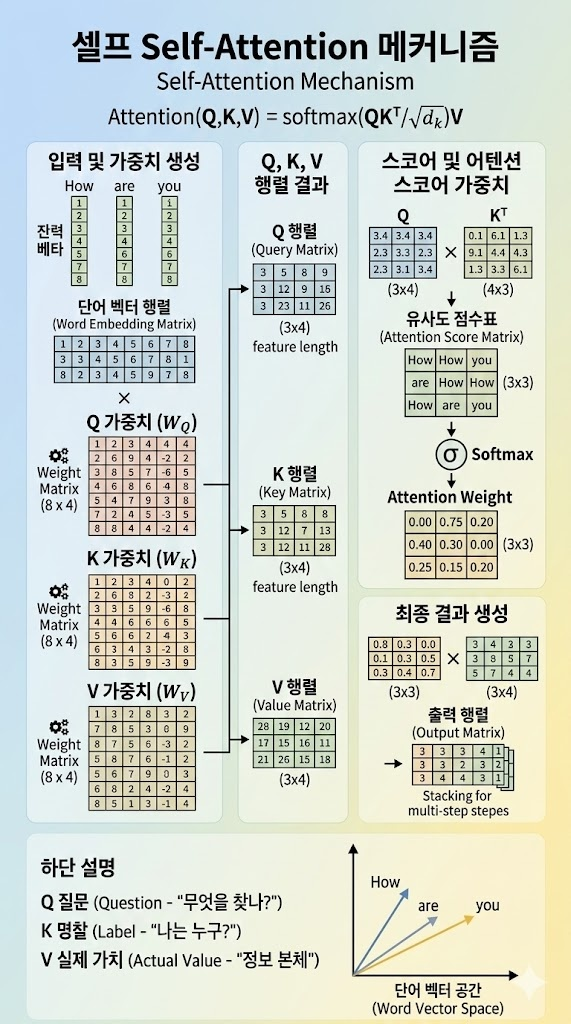
💡 [정리] 실제 트랜스포머에서의 정확한 행렬 사이즈 흐름
(단어 3개, 임베딩 차원 512, 헤드 하나의 차원이 64라고 가정할 때)
- (입력 행렬):
- (가중치): 각각
- (변신 결과): =
- 유사도 점수 (): =
- Softmax 결과 (Attention Weights): (단어 3개끼리의 상호작용 확률)
- 참고: 실제로는 Softmax 전에 점수가 너무 커지는 걸 막기 위해 루트 값()으로 한 번 나눠준다.
- 최종 출력 (): =
여기서 헤드 하나의 차원(64)이란?
토큰 하나의 벡터 길이(512) = '토큰의 특징의 개수'라고 비유 했을 때
한번에 다 처리하면 효율이 떨어질 수 있어서 이걸 여러개의 헤드(부서)로 나누어 처리.
일반적으로 8개로 나누고, 그래서 64가 된 것임(512 / 8 = 64)
3.4. Scaled Dot-Product Attention 수식
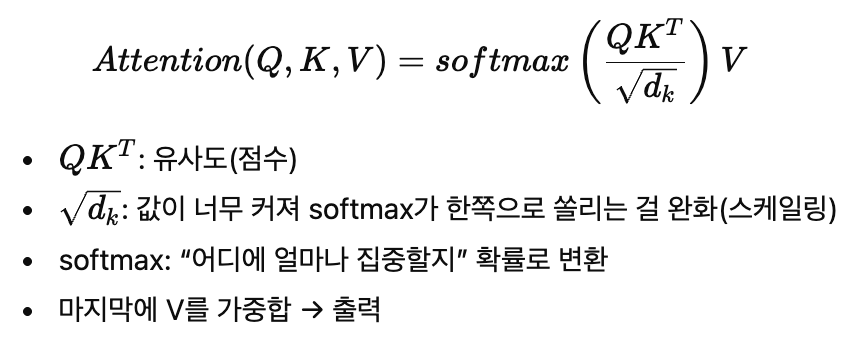
PyTorch 구현: Scaled Dot-Product Attention
import torch
import torch.nn as nn
import torch.nn.functional as F
import math

class ScaledDotProductAttention(nn.Module):
    def __init__(self, d_k):
        super().__init__()
        self.scale = math.sqrt(d_k)

    def forward(self, Q, K, V, mask=None):
        scores = torch.matmul(Q, K.transpose(-2, -1)) / self.scale

        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)

        attention_weights = F.softmax(scores, dim=-1)
        output = torch.matmul(attention_weights, V)
        return output, attention_weights
3.5. Multi-Head Attention: “관점 여러 개로 동시에 보기”
한 번의 attention만 쓰면 “한 종류의 관계”에만 강하게 쏠릴 수 있다.
Multi-head는 차원을 나눠서 여러 head가 서로 다른 관계를 학습하게 만든다.
(, , 세트를 여러개 넣어준다는 의미)
- head1: 문법 관계
- head2: 의미 관계
- head3: 위치/참조 관계
…처럼 서로 다른 패턴을 동시에 포착 가능.
이렇게 n개의 서로 다른 관점에서 단어들을 섞은 결과물 n개가 나오면, 이것들을 가로로 길게 이어 붙인다(Concatenation).
그리고 마지막으로 (Output 가중치 행렬)라는 또 다른 거울을 한 번 더 통과시켜서, 길어진 결과를 원래 원했던 예쁜 사이즈로 다시 꾹 압축해 다음 층(Layer)으로 넘겨준다.
PyTorch 구현: Multi-Head Attention
class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, num_heads):
        super().__init__()
        assert d_model % num_heads == 0

        self.d_model = d_model
        self.num_heads = num_heads
        self.d_k = d_model // num_heads

        self.W_q = nn.Linear(d_model, d_model)
        self.W_k = nn.Linear(d_model, d_model)
        self.W_v = nn.Linear(d_model, d_model)
        self.W_o = nn.Linear(d_model, d_model)

        self.attention = ScaledDotProductAttention(self.d_k)

    def forward(self, Q, K, V, mask=None):
        batch_size = Q.size(0)

        Q = self.W_q(Q).view(batch_size, -1, self.num_heads, self.d_k).transpose(1, 2)
        K = self.W_k(K).view(batch_size, -1, self.num_heads, self.d_k).transpose(1, 2)
        V = self.W_v(V).view(batch_size, -1, self.num_heads, self.d_k).transpose(1, 2)

        out, attention_weights = self.attention(Q, K, V, mask)

        out = out.transpose(1, 2).contiguous().view(batch_size, -1, self.d_model)
        out = self.W_o(out)
        return out, attention_weights
3.6. Transformer의 핵심 구성요소 3가지
3.6.1. Positional Encoding: “순서 정보 넣기”
Transformer는 구조적으로 “순서”가 없다.
그래서 토큰 위치 정보를 별도로 더해준다.
대표적인 방식이 sin/cos 기반 위치 인코딩이다.
sin/cos 방식의 장점:
- 길이가 더 길어져도(학습 때 없던 길이) 어느 정도 일반화 가능
- 상대적 거리 정보가 수학적으로 드러남
코드 예시
class PositionalEncoding(nn.Module):
    def __init__(self, d_model, max_len=5000):
        super().__init__()
        pe = torch.zeros(max_len, d_model)
        position = torch.arange(0, max_len).unsqueeze(1).float()
        div_term = torch.exp(torch.arange(0, d_model, 2).float() *
                           -(math.log(10000.0) / d_model))

        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)

        pe = pe.unsqueeze(0)
        self.register_buffer('pe', pe)

    def forward(self, x):
        return x + self.pe[:, :x.size(1)]
3.6.2. Feed-Forward Network(FFN): 토큰별 비선형 변환
Attention은 “섞는” 역할이 강하고, FFN은 비선형 변환으로 한 번 더 “가공”한다(표현력을 늘려줌).
코드 예시
class FeedForward(nn.Module):
    def __init__(self, d_model, d_ff=2048, dropout=0.1):
        super().__init__()
        self.linear1 = nn.Linear(d_model, d_ff)
        self.linear2 = nn.Linear(d_ff, d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        return self.linear2(self.dropout(F.relu(self.linear1(x))))
3.6.3. Encoder Layer: (Self-Attention + FFN) + Residual + LayerNorm
Transformer는 “깊게 쌓기” 위해 Residual과 LayerNorm을 기본으로 쓴다.
- Residual: “원본을 더해줘서 정보 흐름 보장”(gradient 문제 해결)
- LayerNorm: “각 토큰 표현의 스케일을 안정화”
class EncoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ff, dropout=0.1):
        super().__init__()
        self.self_attention = MultiHeadAttention(d_model, num_heads)
        self.feed_forward = FeedForward(d_model, d_ff, dropout)
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, mask=None):
        attn_out, _ = self.self_attention(x, x, x, mask)
        x = self.norm1(x + self.dropout(attn_out))

        ff_out = self.feed_forward(x)
        x = self.norm2(x + self.dropout(ff_out))
        return x
3.7. Transformer 아키텍처: 인코더-디코더
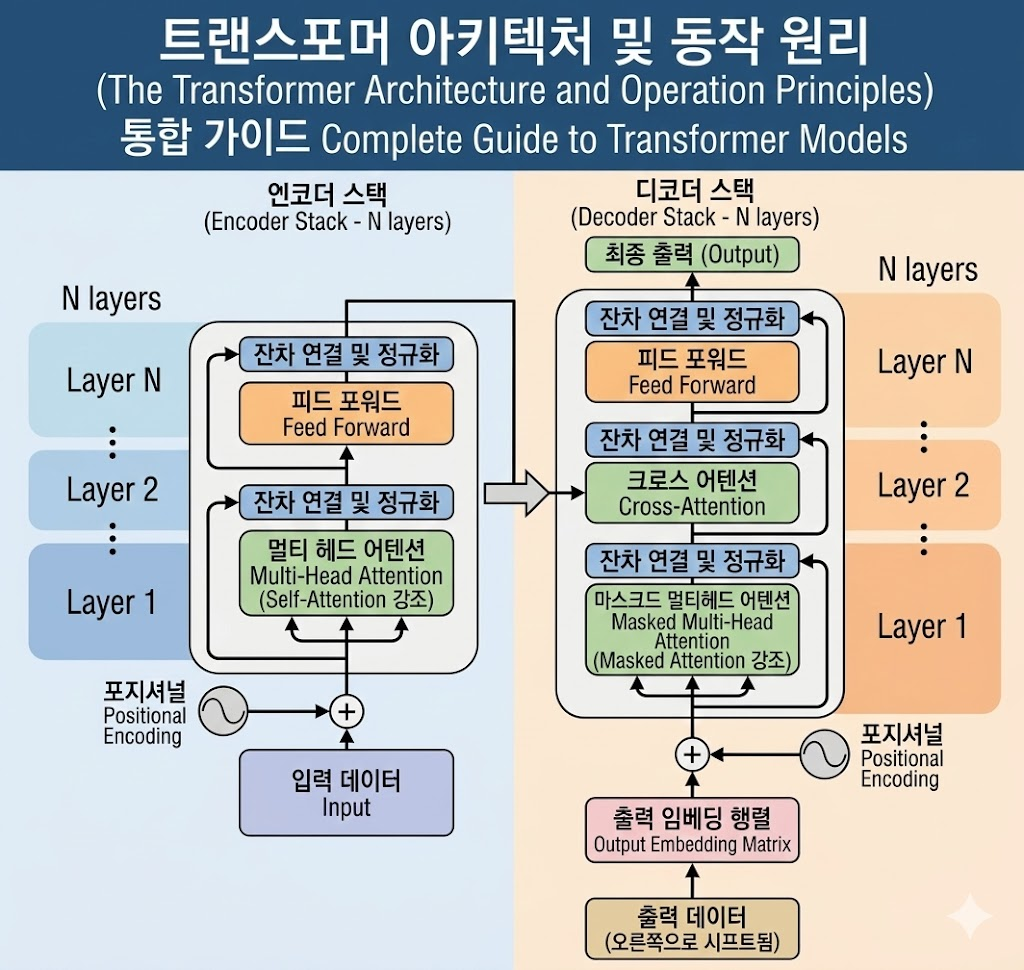
- Encoder: 입력을 이해해서 표현을 만든다
- Decoder: 그 표현을 참고해서 출력 시퀀스를 생성한다
- 디코더는 생성 시 Masked Multi-Head Attention(미래 토큰을 못 보게) 사용
이 기본 구조가 번역/요약/생성의 뼈대가 된다.
3.7.1. U-Net vs. Transformer 비교
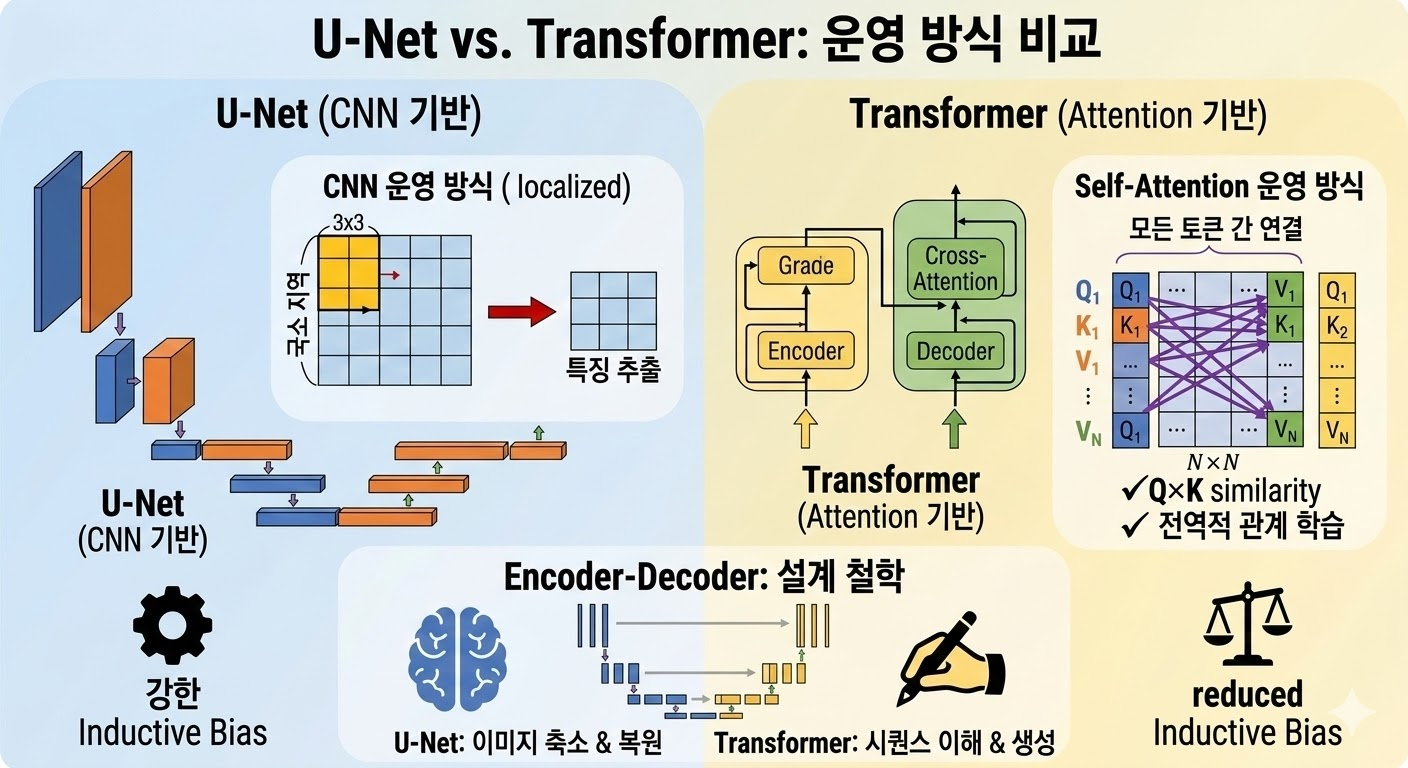
| 특징 | U-Net (이미지 분할) | Transformer (자연어/시퀀스) |
|---|---|---|
| 핵심 부품 | CNN (합성곱 연산) | Self-Attention (Q, K, V 연산) |
| 인코더의 역할 | 이미지를 돋보기(필터)로 줄여가며 특징 압축 | 단어들의 문맥과 관계를 Attention으로 파악해 압축 |
| 디코더의 역할 | 압축된 특징을 다시 큰 이미지 크기로 복원 (픽셀 칠하기) | 압축된 문맥을 바탕으로 새로운 시퀀스(단어) 생성 |
| 특징적 연결 | 스킵 커넥션 (인코더의 이미지를 디코더로 바로 복사해 넘겨줌) | 크로스 어텐션 (디코더가 인코더의 K, V를 참조함) |
4. Vision Transformer(ViT) vs. CNN
4.1. Vision Transformer(ViT)
핵심은 Patch Embedding: 이미지를 “토큰 시퀀스”로 바꾸기
- 이미지(224×224)를 16×16 패치로 쪼갬
- 각 패치를 벡터로 펼쳐 선형 변환 → 토큰처럼 사용
- 위치 정보(포지셔널 인코딩)를 더해 Transformer에 투입
즉, ViT는 “이미지의 픽셀 덩어리 = 단어 토큰”처럼 다룬다.
4.2. CNN vs ViT 비교
- CNN: 지역적 특징을 쌓아서 전역으로 확장(강한 inductive bias)
- ViT: 전역 관계를 직접 학습(대신 데이터가 필요)
| 특성 | CNN | ViT |
|---|---|---|
| 학습 방식 | 지역→전역 | 전역 관계 직접 학습 |
| 데이터 요구 | 상대적으로 적음 | 대량 데이터 유리 |
| 계산/메모리 | 효율적 | 메모리 집약적 |
| 해석 | 특징맵 시각화 | Attention map 분석 |
| 의료 적용 | 국소 병변 감지 강함 | 전신 상관관계 분석 강함 |
4.2.1. 데이터 크기에 따른 성능 경향(참고)
- 작은 데이터: CNN이 강한 baseline
- 초대규모 데이터: ViT가 CNN을 압도하기도 함(그럴 가능성이 있다는 것)
- 데이터가 충분히 크면 ViT는:
- 전체 이미지의 장거리 관계를 더 직접적으로 학습할 수 있고
- 표현력 측면에서 매우 강해질 수 있기 때문
- 데이터가 충분히 크면 ViT는:
4.2.2. 그래서 어떤 모델을 선택해야 할까?
- 학습 데이터가 천만 단위 이상: ViT가 매력적
- 실시간/저사양에서 빠른 응답이 중요: CNN
- 10M+로 사전학습된 좋은 체크포인트가 있고, 시간이 충분: ViT도 고려
- 도메인이 매우 다르면(의료 등): 전이학습 관점에서 신중히(초기엔 CNN이 안전한 경우가 많음)
4.2.3. 하이브리드 모델의 등장: Swin / ConvNeXt
- Swin Transformer:
- attention을 “윈도우(지역 블록)”로 제한해서 효율을 올림
- 대신 계층적으로 윈도우를 이동/병합해 전역 정보도 점점 섞음
→ Transformer 표현력 + 계산 효율 타협점
- ConvNeXt: CNN 구조에 Transformer 설계 원칙(정규화 위치, 큰 커널, 구조 단순화 등)을 반영해 성능을 끌어올림
“CNN vs Transformer”가 아니라, 실제론 서로 장점을 섞어 최적점을 찾는 흐름으로 발전 중이다.
4.3. LLM의 세계: BERT · GPT · 프롬프트 엔지니어링
4.3.1. LLM(Large Language Model)이란?
- Large: 수십억~수조 파라미터
- Language Model: 텍스트 생성/이해 모델
- 사전학습: 인터넷 규모 텍스트로 학습
LLM의 대표 능력
- In-Context Learning: 예시만 보고 새 태스크 수행
- Chain-of-Thought: 단계적 추론
- Instruction Following: 지시 따르기
- 멀티모달: 텍스트+이미지 이해/생성(모델에 따라)
4.3.2. BERT vs GPT
BERT(양방향 인코더)
- 양방향 문맥을 동시에 고려
- 사전학습: MLM(마스크 복원) + NSP(문장 관계 예측)
- 강점: 분류/QA 같은 “이해” 작업
GPT(자기회귀 디코더)
- 왼쪽→오른쪽 단방향으로 다음 토큰 예측
- 강점: “생성” 작업(텍스트 생성)
HuggingFace로 BERT 사용(실전 입문 코드)
from transformers import BertTokenizer, BertModel, BertForSequenceClassification

tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
model = BertModel.from_pretrained('bert-base-uncased')

text = "Hello, how are you?"
inputs = tokenizer(text, return_tensors='pt')

outputs = model(**inputs)
last_hidden_state = outputs.last_hidden_state  # (1, seq_len, 768)
pooled_output = outputs.pooler_output          # (1, 768) - [CLS]

classifier = BertForSequenceClassification.from_pretrained(
    'bert-base-uncased',
    num_labels=2
)
HuggingFace로 GPT 사용(텍스트 생성)
from transformers import GPT2Tokenizer, GPT2LMHeadModel

tokenizer = GPT2Tokenizer.from_pretrained('gpt2')
model = GPT2LMHeadModel.from_pretrained('gpt2')

prompt = "딥러닝은"
inputs = tokenizer(prompt, return_tensors='pt')

outputs = model.generate(
    inputs['input_ids'],
    max_length=50,
    num_return_sequences=1,
    temperature=0.7,
    do_sample=True
)

generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)
4.3.3. 프롬프트 엔지니어링: Zero-shot / Few-shot / CoT
- Zero-shot: 예시 없이 지시만
- Few-shot: 입력-출력 예시를 몇 개 제공
- Chain-of-Thought: “단계별로 생각하라” 형태로 추론을 유도