소개
DiffusionGemma가 이번에 공개되었다.
이전에 Gemini Diffusion이 나왔을 때 discrete diffusion 대해서 소개글을 작성한 적이 있었는데 이번에 Gemma의 diffusion 버전으로 새롭게 공개되었다.
discrete diffusion에서는 이전에 소개글을 작성하였는데 기존에 left-to-right로 생성하는 autoregressive llm과는 다르게 text를 병렬로 생성해서 매우매우 빠른 것이 특징이다.
Self-conditioning
제목에 Self-conditioning을 추가한 이유는 이번 DiffusionGemma에 내가 논문으로 작성한 방법이 들어가서 추가했다.
논문의 제목은 이전에 작성한 적이 있는데 Loopholing Discrete Diffusion: Deterministic Bypass of the Sampling Wall 이다.
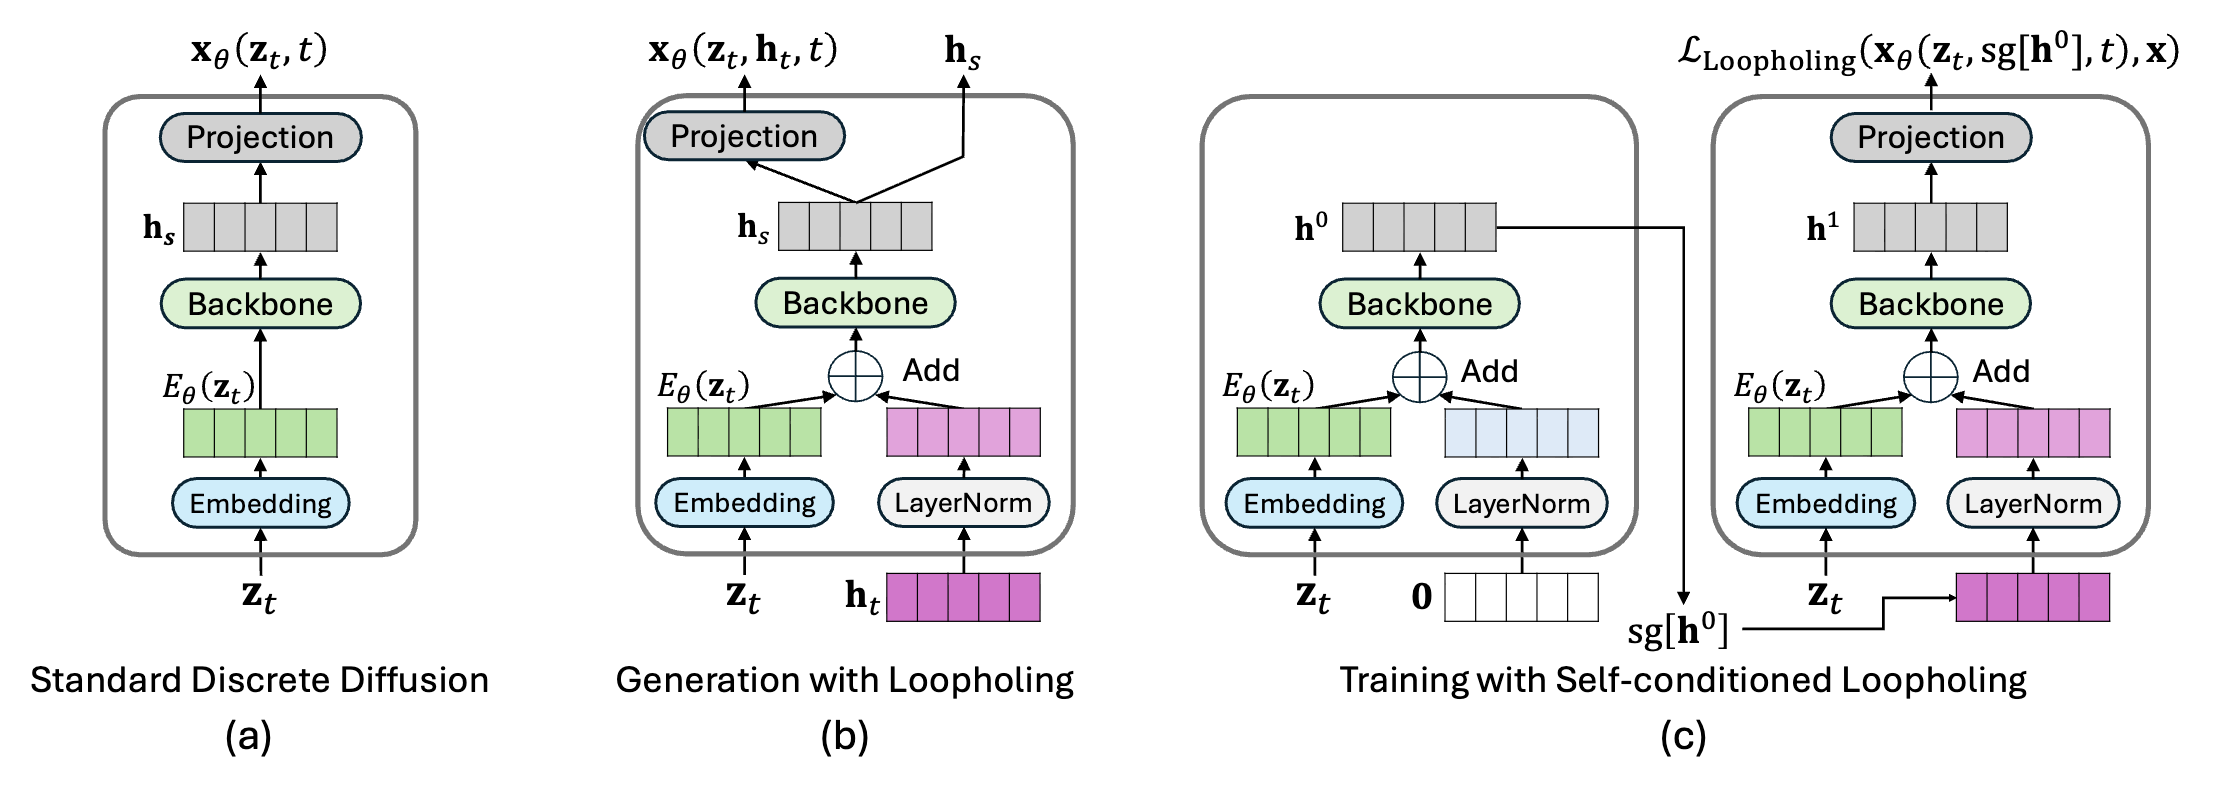
Loopholing의 방법은 간단하게 sampling과정에서 버려지는 정보를 유지하기 위해서 self-conditioning으로 Latent를 propagate하는 것을 근사해서 학습하고 inference time에 token probablity와 함께 latent를 propagate해서 토큰의 확률에 대한 정보를 유지하면서 generation을 진행하는 것이다.
성능
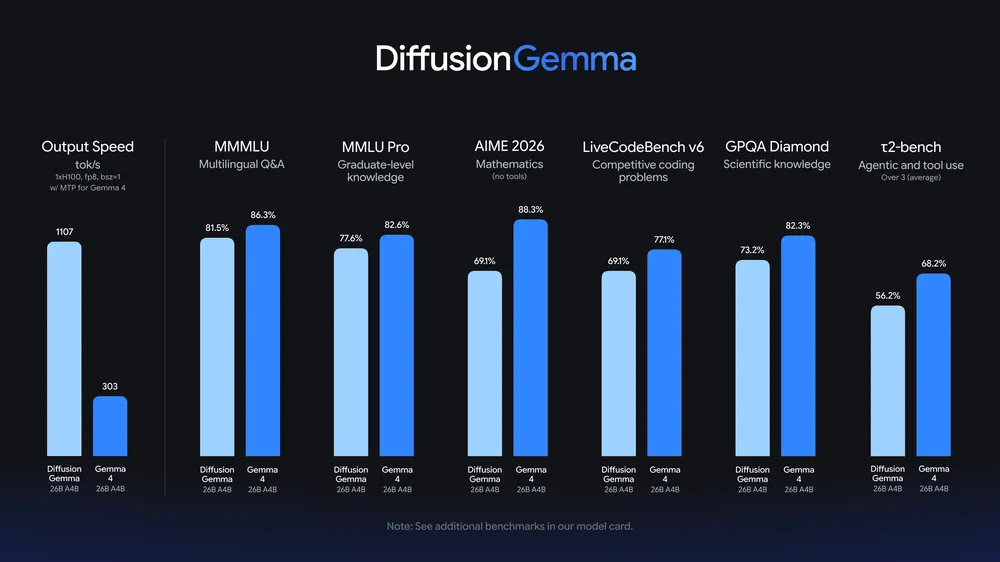
기존 autoregressive model인 Gemma4와 비교했을 때 장점과 단점이 명확한데
우선 장점은 token을 생성하는 속도가 diffusion model은 병렬로 진행되기 때문에 대략 4배 정도로 어마어마하게 빠르다.
단점은 autoregressive model보다 성능은 떨어진다...
이는 보통 text가 left to right로 작성된다는 것을 가정하고 학습하고 inference에 causal하게 생성하는 LLM과는 다르게 diffusion model은 전체 text를 any-order로 학습하기 때문에 더 학습하기 어렵고 text에 대한 causality가 떨어질 수도 있어서 그런 것으로 생각된다.
그러나 diffusion LLM은 전체 sequence에 대한 이해가 필요한 문제는 매우매우 잘푼다. 예를 들어 미로찾기는 앞에서 가는 경로나 뒤에서 가는 경로 동시에 모델링하면 더 잘하는 것이나 sudoku에서 board를 한번에 모델링하는 등 병렬 생성에서 장점을 얻을 수 있는 task도 있다.
DiffusionGemma 구조
DiffusionGemma에 추가된 방법은 다음과 같다.
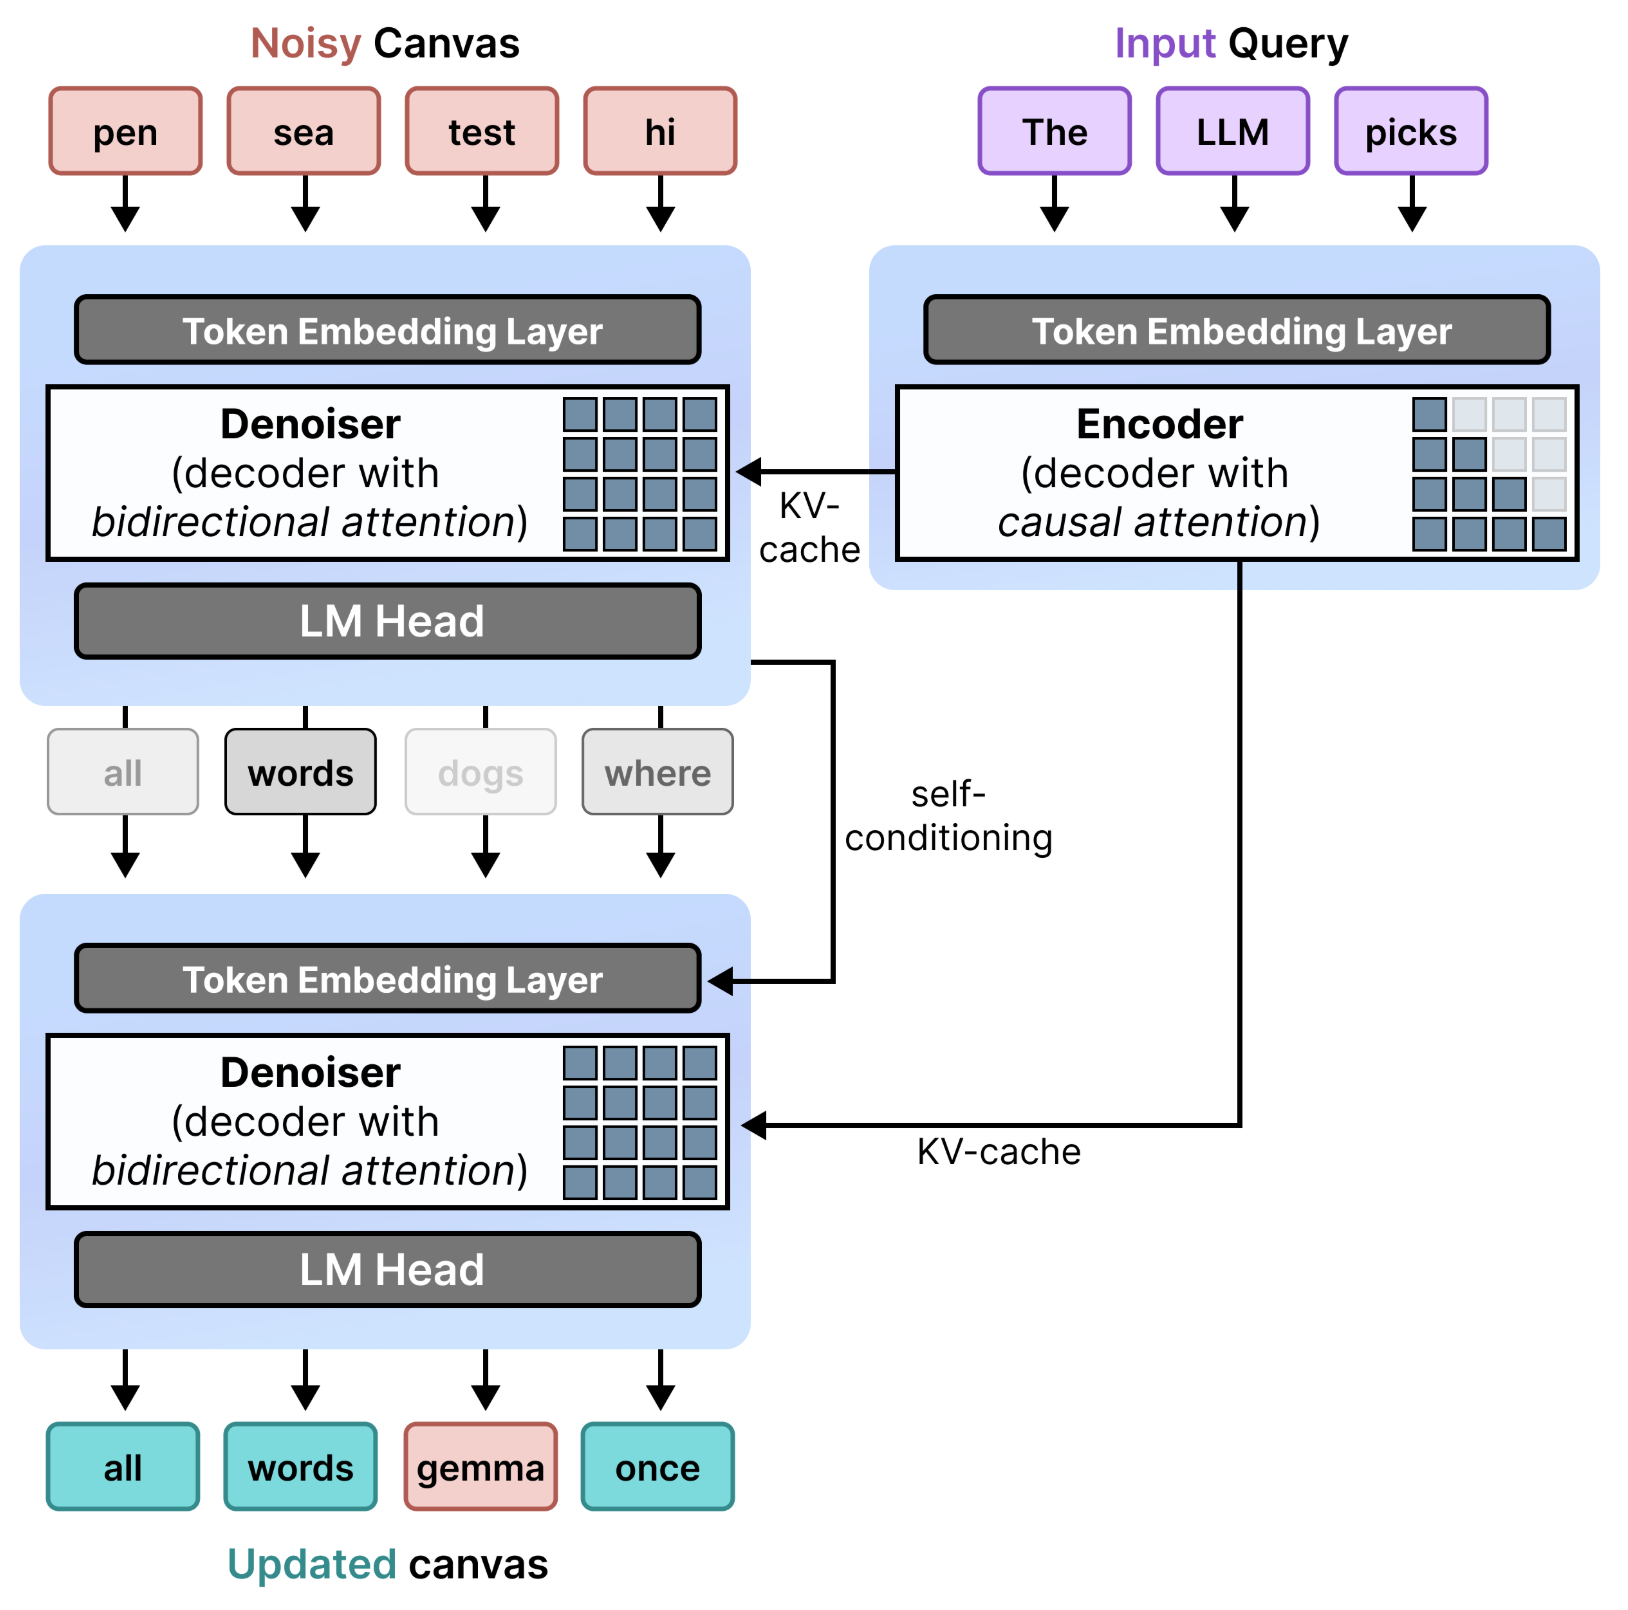
Block diffusion
기존에 전체 sequence를 생성하는 것이 아니라 256개의 token chunk를 생성하고나서 다음 token chunk를 생성하는, 그러니까 block diffusion의 구조를 가지고 있다.
사실 discrete diffusion은 전체 sequence를 만드는 것은 total sequence를 jointly 학습할 수 있지만 몇개의 token으로도 생성할 수 있는 내용을 전체 text sequence를 전부 생성해야하기 때문에 너무 cost가 낭비가 되어 이런 구조를 택한 것 같다.
Self-conditioning
위에서 말한 것처럼 self-conditioning이 들어갔는데.
token embedding + layer(latent)로 token sampling에 대한 information loss를 없애는 식으로 loopholing의 핵심 구조와 동일하게 진행이 되지만 약간의 튜닝이 들어가서 latent embedding을 그대로 활용하는 것이 아니라 soft embedding을 활용했다.
canvas
이거는 처음보는데 canvas구조로 encoder, decoder구조를 가지는 것처럼 묘사가 되는데 또 google연구원이 x 댓글로 이 구조는 decoder구조가 아니라고 해서 좀 헷갈린다.
그냥 간단하게 앞에서 말한 block diffusion에서 생성하는 block 단위인 token block으로 생각하면 될 것 같다.
잡담
핵심은 google은 gemini diffusion도 그렇고 diffusion기반의 language model의 가능성을 보고 계속 연구를 진행하는 것 같다.
이는 기존 autoregressive language model 외에도 다양한 실험을 진행하는 것으로 보이고 매우 긍정적인 것 같다.