Spring Boot로 백엔드 개발을 처음 배우면 거의 항상 이런 구조를 만나게 된다.
Controller
Service
Repository
처음에는 Spring에서 정해놓은 규칙처럼 보일 수 있다.
요청은 Controller에서 받고,
Service를 호출하고,
Repository에서 DB를 조회한다.
그래서 처음에는 이런 생각이 들기도 한다.
“Controller, Service, Repository 폴더만 나누면 레이어드 아키텍처 아닌가?”
하지만 레이어드 아키텍처에서 중요한 것은 폴더를 몇 개 만들었는가가 아니다.
각 코드가 어떤 책임을 가지고 있는지, 그리고 서로 어떤 방향으로 의존하는지가 더 중요하다.
이번 글에서는 Spring Boot에서 흔히 볼 수 있는 Controller, Service, Repository 구조를 통해 레이어드 아키텍처를 쉽게 이해해보자.
레이어드 아키텍처란?
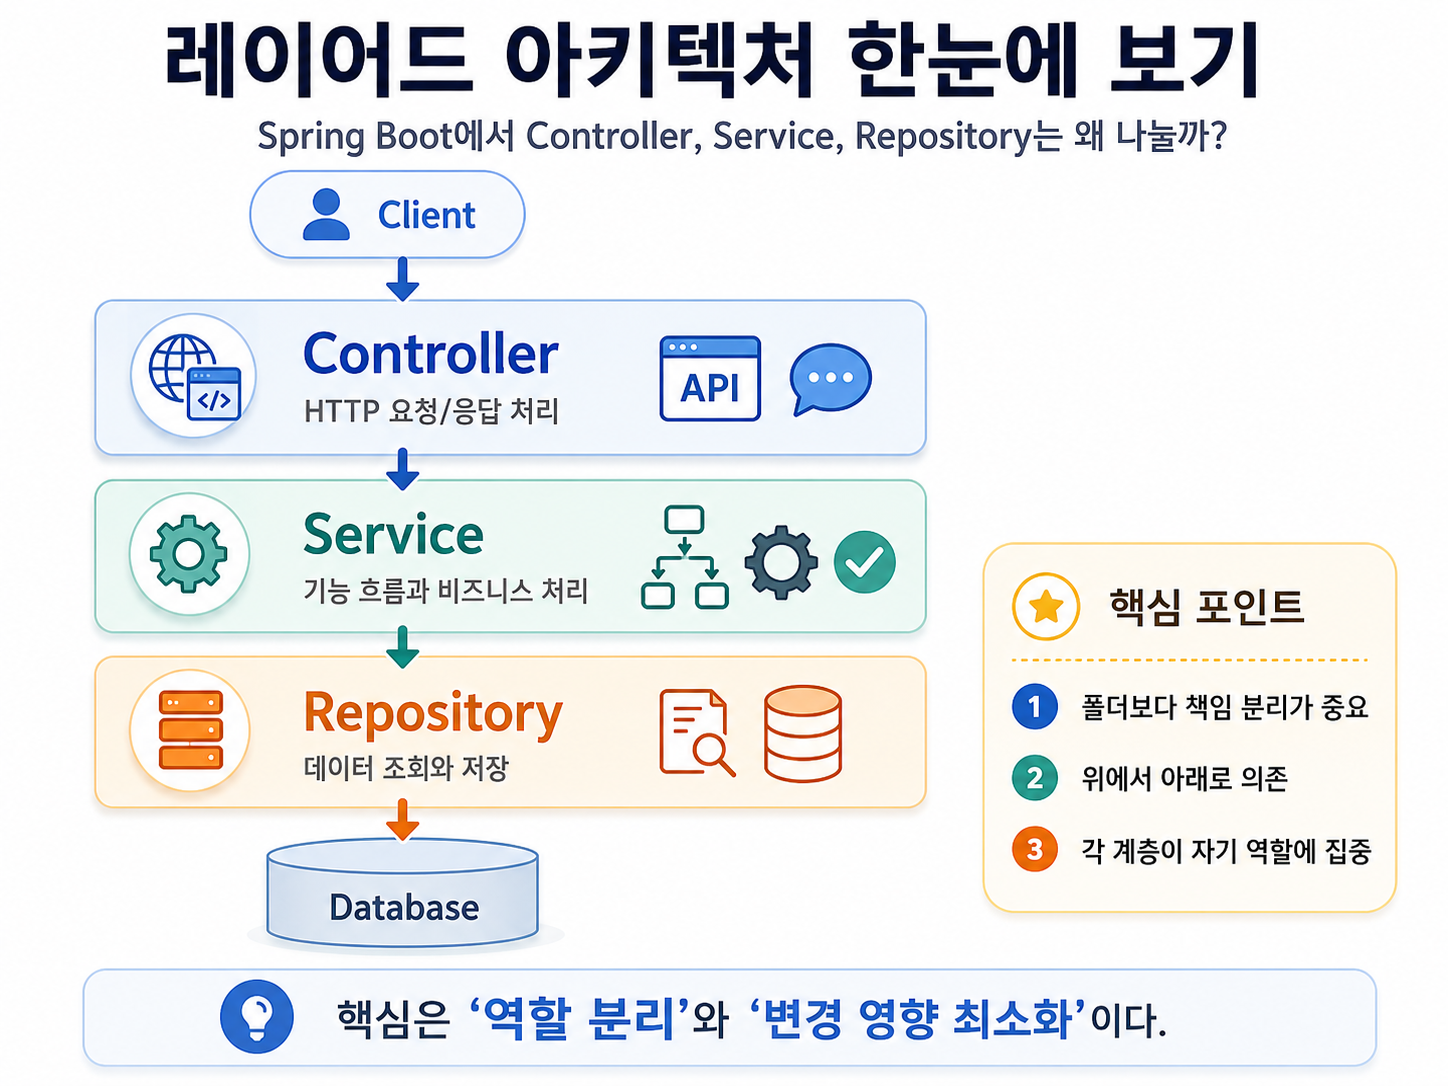
레이어드 아키텍처는 애플리케이션을 역할에 따라 여러 계층으로 나누는 구조다.
Spring Boot API 서버에서는 보통 다음과 같이 표현된다.
Controller
↓
Service
↓
Repository
↓
Database
각 계층의 역할을 아주 단순하게 표현하면 다음과 같다.
Controller
HTTP 요청과 응답 처리

Service
애플리케이션의 작업과 비즈니스 처리

Repository
데이터 조회와 저장
핵심은 하나다.
각 계층이 자기 역할에 집중하도록 만드는 것
레이어드 아키텍처의 기본 구조
Microsoft의 N-tier Architecture 문서에서는 애플리케이션을 여러 논리적 계층으로 나누는 전통적인 아키텍처 스타일을 설명한다.
대표적으로 다음과 같은 계층을 볼 수 있다.
Presentation
Business Logic
Data Access
Spring Boot 애플리케이션으로 옮겨 생각하면 대략 다음과 같이 연결할 수 있다.
Presentation
→ Controller

Business / Application
→ Service

Data Access
→ Repository
Spring에서는 클래스가 어떤 역할을 담당하는지 표현하기 위한 stereotype annotation도 제공한다.
@Controller
@Service
@Repository
대략적인 역할은 다음과 같다.
@Controller
웹 요청을 처리하는 컴포넌트

@Service
서비스 계층의 작업을 담당하는 컴포넌트

@Repository
데이터 접근을 담당하는 컴포넌트
따라서 Spring Boot에서 흔히 볼 수 있는 Controller-Service-Repository 구조는 레이어드 아키텍처를 구현하는 대표적인 형태 중 하나라고 이해하면 된다.
레이어를 나누는 이유
작은 프로그램이라면 Controller 하나에 모든 코드를 작성할 수도 있다.
예를 들어 주문 취소 기능을 만든다고 생각해보자.
해야 하는 일은 대략 다음과 같다.
1. 주문 취소 요청을 받는다.
2. 주문을 DB에서 찾는다.
3. 주문이 취소 가능한 상태인지 확인한다.
4. 주문 상태를 취소로 변경한다.
5. 결과를 응답한다.
기술적으로는 이 모든 코드를 Controller 하나에 작성할 수도 있다.
하지만 기능이 많아지기 시작하면 문제가 생긴다.
HTTP 처리 코드
DB 조회 코드
비즈니스 규칙
트랜잭션 처리
응답 생성 코드
서로 다른 관심사의 코드가 한곳에 섞이게 된다.
그래서 역할을 나눈다.
Controller
→ 요청을 받는다.

Service
→ 주문 취소 작업을 수행한다.

Repository
→ 주문 데이터를 조회하고 저장한다.
쉽게 말하면 애플리케이션 안에서 업무 분장을 하는 것이다.
역할 분리로 이해하기
레이어드 아키텍처를 회사의 업무 분장에 비유해보자.
고객이 회사에 전화를 걸어 이렇게 요청했다고 생각해보자.
"주문을 취소하고 싶어요."회사 안에서는 여러 사람이 역할을 나눠서 처리할 수 있다.
상담 직원
→ 고객의 요청을 접수한다.

업무 담당자
→ 해당 주문이 취소 가능한지 판단한다.

자료 담당자
→ 시스템에서 주문 정보를 조회한다.
상담 직원 한 명이 모든 일을 처리할 수도 있다.
하지만 회사가 커질수록 역할을 나누는 편이 관리하기 쉽다.
백엔드 애플리케이션도 비슷하다.
Controller
→ 요청 접수

Service
→ 필요한 작업 수행

Repository
→ 데이터 조회 및 저장
레이어드 아키텍처는 이런 역할 분리를 코드 구조로 표현한 것이라고 생각하면 이해하기 쉽다.
주문 취소 예제로 이해하기
실제 코드로 주문 취소 API를 만들어보자.
전체 흐름은 다음과 같다.
POST /orders/1/cancel

        ↓

Controller

        ↓

Service

        ↓

Repository

        ↓

Database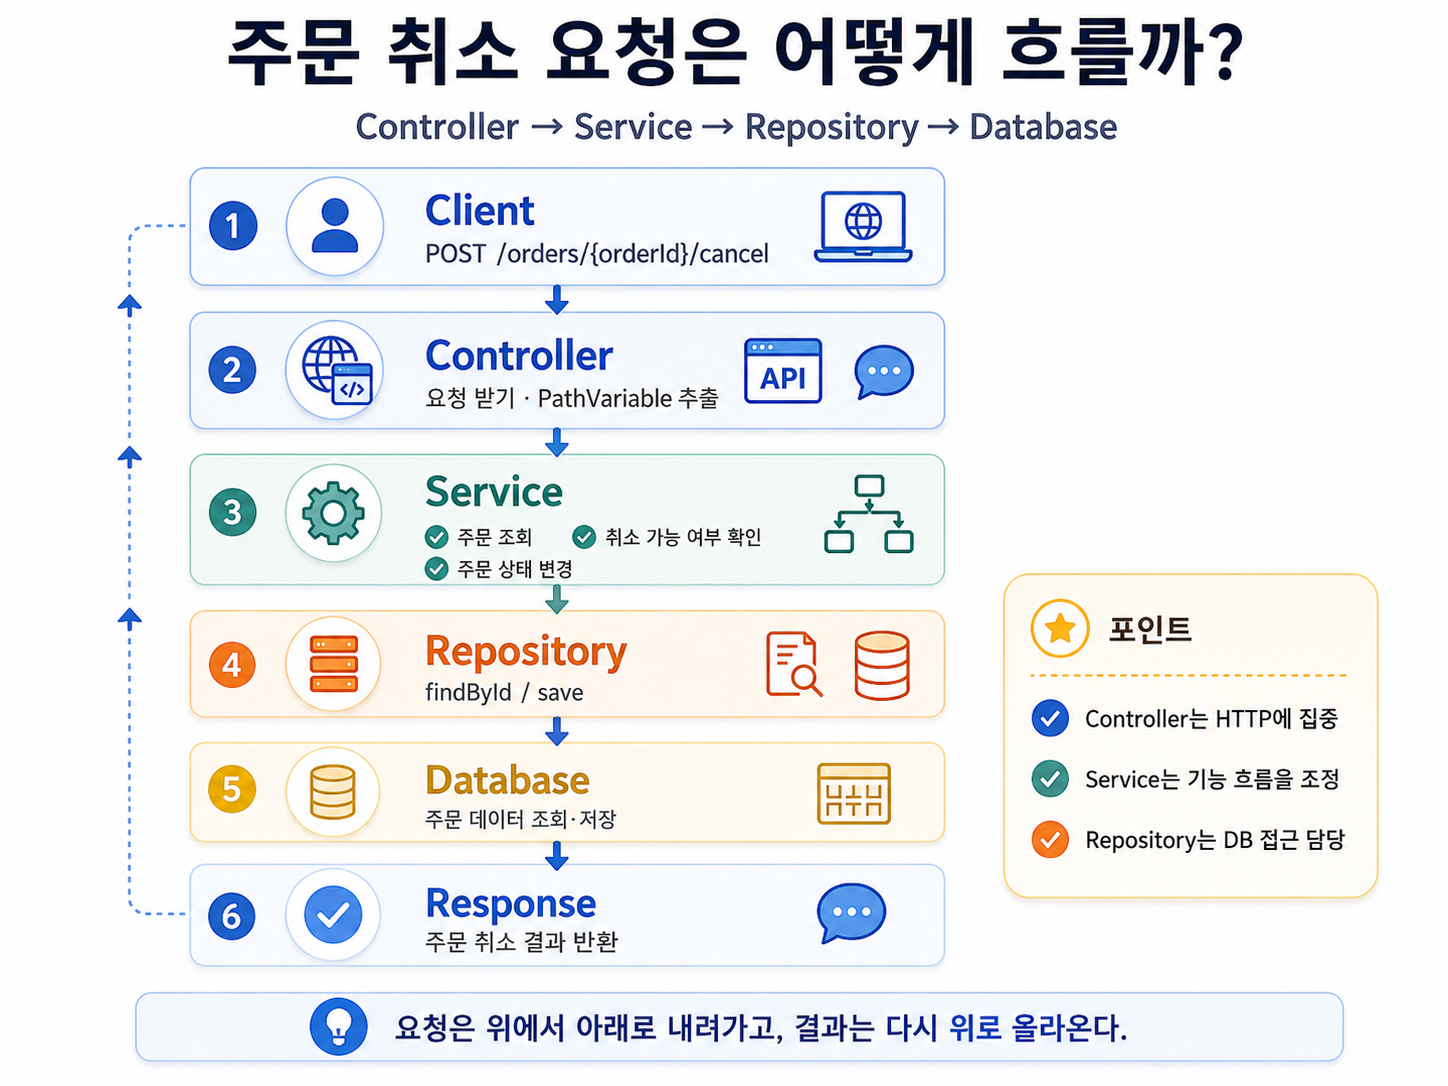
1. Controller
먼저 HTTP 요청을 받는 Controller다.
@RestController
@RequestMapping("/orders")
public class OrderController {

    private final OrderService orderService;

    public OrderController(OrderService orderService) {
        this.orderService = orderService;
    }

    @PostMapping("/{orderId}/cancel")
    public OrderCancelResponse cancelOrder(
            @PathVariable Long orderId
    ) {
        return orderService.cancelOrder(orderId);
    }
}
Controller가 하는 일을 살펴보면 대부분 HTTP와 관련되어 있다.
POST 요청 받기
URL에서 orderId 받기
Service 호출하기
결과 응답하기
코드에서도 HTTP와 관련된 요소들이 등장한다.
@RestController
@RequestMapping
@PostMapping
@PathVariable
따라서 Controller는 웹과 가장 가까운 계층이라고 생각하면 된다.
2. Service
이번에는 실제 주문 취소 작업을 수행하는 Service다.
@Service
public class OrderService {

    private final OrderRepository orderRepository;

    public OrderService(OrderRepository orderRepository) {
        this.orderRepository = orderRepository;
    }

    public OrderCancelResponse cancelOrder(Long orderId) {

        Order order = orderRepository.findById(orderId)
                .orElseThrow(() ->
                        new OrderNotFoundException(orderId)
                );

        if (!order.canCancel()) {
            throw new OrderCannotCancelException(orderId);
        }

        order.cancel();

        return new OrderCancelResponse(
                order.getId(),
                order.getStatus()
        );
    }
}
여기서는 HTTP보다 애플리케이션의 작업 자체가 중요하다.
주문을 찾는다.
주문이 존재하지 않으면 예외를 발생시킨다.
주문이 취소 가능한지 확인한다.
주문을 취소한다.
결과를 만든다.
이런 작업의 흐름을 조정하는 것이 Service의 대표적인 역할이다.
다만 한 가지 주의할 점이 있다.
모든 비즈니스 로직을 반드시 Service 안에 작성해야 한다는 뜻은 아니다.
예를 들어 주문 자체의 규칙은 Order 도메인 객체가 가지고 있을 수도 있다.
if (!order.canCancel()) {
    throw new OrderCannotCancelException(orderId);
}

order.cancel();
이 경우 Service는 여러 객체와 Repository를 조합해 하나의 기능을 수행하고, 실제 주문의 규칙은 Order 객체가 담당한다.
처음에는 다음 정도로 이해하면 충분하다.
Controller가 HTTP를 담당한다면, Service는 애플리케이션에서 실제로 수행해야 하는 작업의 흐름을 담당한다.
3. Repository
마지막은 데이터 접근을 담당하는 Repository다.
@Repository
public interface OrderRepository
        extends JpaRepository<Order, Long> {
}
Repository는 데이터베이스와 가장 가까운 계층이다.
대표적으로 이런 작업을 담당한다.
주문 조회
주문 저장
회원 조회
상품 조회
데이터 존재 여부 확인
Spring Data JPA에서는 다음과 같은 메서드를 자주 볼 수 있다.
findById(id);

existsByEmail(email);

findByUserId(userId);
Repository의 관심사는 주로
데이터를 어떻게 가져오고 저장할 것인가
에 있다.
요청은 어떻게 흐를까?
지금까지 살펴본 주문 취소 요청을 하나로 연결하면 다음과 같다.
Client
  |
  | POST /orders/1/cancel
  v
Controller
  |
  | cancelOrder(1)
  v
Service
  |
  | findById(1)
  v
Repository
  |
  v
Database
요청은 위에서 아래로 내려간다.
DB에서 데이터를 가져온 뒤에는 결과가 다시 반대 방향으로 올라온다.
Database
   ↓
Repository
   ↓
Service
   ↓
Controller
   ↓
Client
전체 흐름으로 표현하면 다음과 같다.
HTTP Request
    ↓
Controller
    ↓
Service
    ↓
Repository
    ↓
Database
    ↓
Repository
    ↓
Service
    ↓
Controller
    ↓
HTTP Response
이 흐름을 머릿속에 그릴 수 있다면 레이어드 아키텍처의 기본 구조를 이해한 것이다.
Controller, Service, Repository의 역할
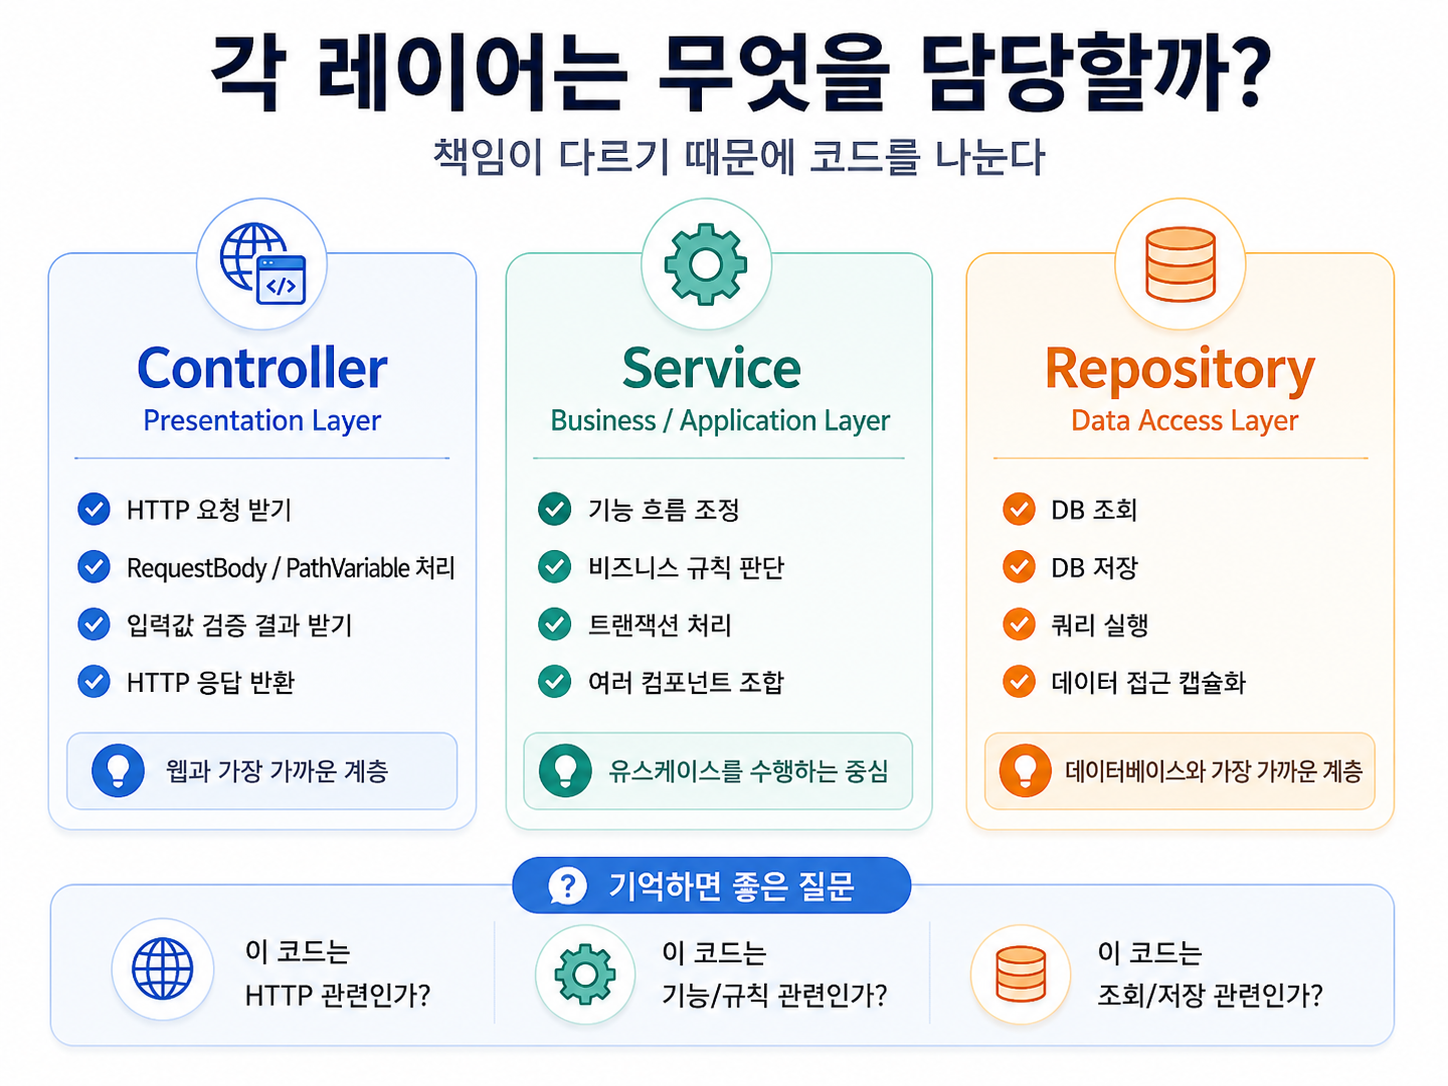
각 레이어의 책임을 조금 더 자세히 살펴보자.
Presentation Layer
Spring Boot API 서버에서는 일반적으로 Controller가 이 역할을 한다.
주요 관심사는 HTTP다.
HTTP 요청 받기
RequestBody 받기
PathVariable 받기
RequestParam 받기
입력값 검증 결과 처리
Service 호출
HTTP 응답 반환
그래서 다음과 같은 코드들이 주로 등장한다.
@GetMapping
@PostMapping
@RequestBody
@PathVariable
@RequestParam
ResponseEntity
Controller는 웹과 애플리케이션 내부를 연결하는 입구라고 볼 수 있다.
Service Layer
Service에서는 하나의 기능을 수행하기 위해 필요한 작업들을 조정한다.
예를 들어 주문 취소 기능이라면 다음과 같은 작업이 있을 수 있다.
주문 조회
주문 상태 확인
주문 취소
결제 취소 요청
포인트 복구
결과 반환
여러 Repository나 다른 컴포넌트를 함께 사용할 수도 있다.
orderRepository
paymentRepository
pointService
notificationService
트랜잭션 경계를 Service에 두는 경우도 많다.
@Transactional
public void cancelOrder(Long orderId) {
    ...
}
즉 Service는 보통 하나의 유스케이스를 실행하는 중심 역할을 한다.
Data Access Layer
Repository가 대표적인 데이터 접근 계층이다.
주요 관심사는 다음과 같다.
DB 조회
DB 저장
DB 수정
DB 삭제
Query 실행
예를 들면 다음과 같다.
Optional<Order> findById(Long id);

boolean existsByEmail(String email);

List<Order> findByUserId(Long userId);
비즈니스 규칙보다는 데이터를 어떻게 가져오고 저장할 것인가에 집중한다.
폴더 분리만으로는 부족하다
다음과 같은 폴더 구조가 있다고 해보자.
controller
service
repository
겉으로 보면 레이어드 아키텍처처럼 보인다.
하지만 Controller가 다음과 같이 작성되어 있다면 어떨까?
@PostMapping("/{orderId}/cancel")
public OrderCancelResponse cancelOrder(
        @PathVariable Long orderId
) {

    Order order = orderRepository.findById(orderId)
            .orElseThrow();

    if (order.getStatus() == OrderStatus.SHIPPING) {
        throw new IllegalStateException();
    }

    order.setStatus(OrderStatus.CANCELED);

    orderRepository.save(order);

    return new OrderCancelResponse(
            order.getId(),
            order.getStatus()
    );
}
Controller 안에서 다음 작업을 모두 처리하고 있다.
DB 조회
비즈니스 규칙 확인
상태 변경
DB 저장
응답 생성
폴더는 나뉘어 있지만 역할은 제대로 분리되지 않은 셈이다.
따라서 레이어드 아키텍처에서 중요한 것은 폴더 이름이 아니라 다음 질문이다.
이 코드의 책임은 무엇인가?

HTTP와 관련된 코드인가?

애플리케이션의 기능이나 규칙과 관련된 코드인가?

데이터 접근과 관련된 코드인가?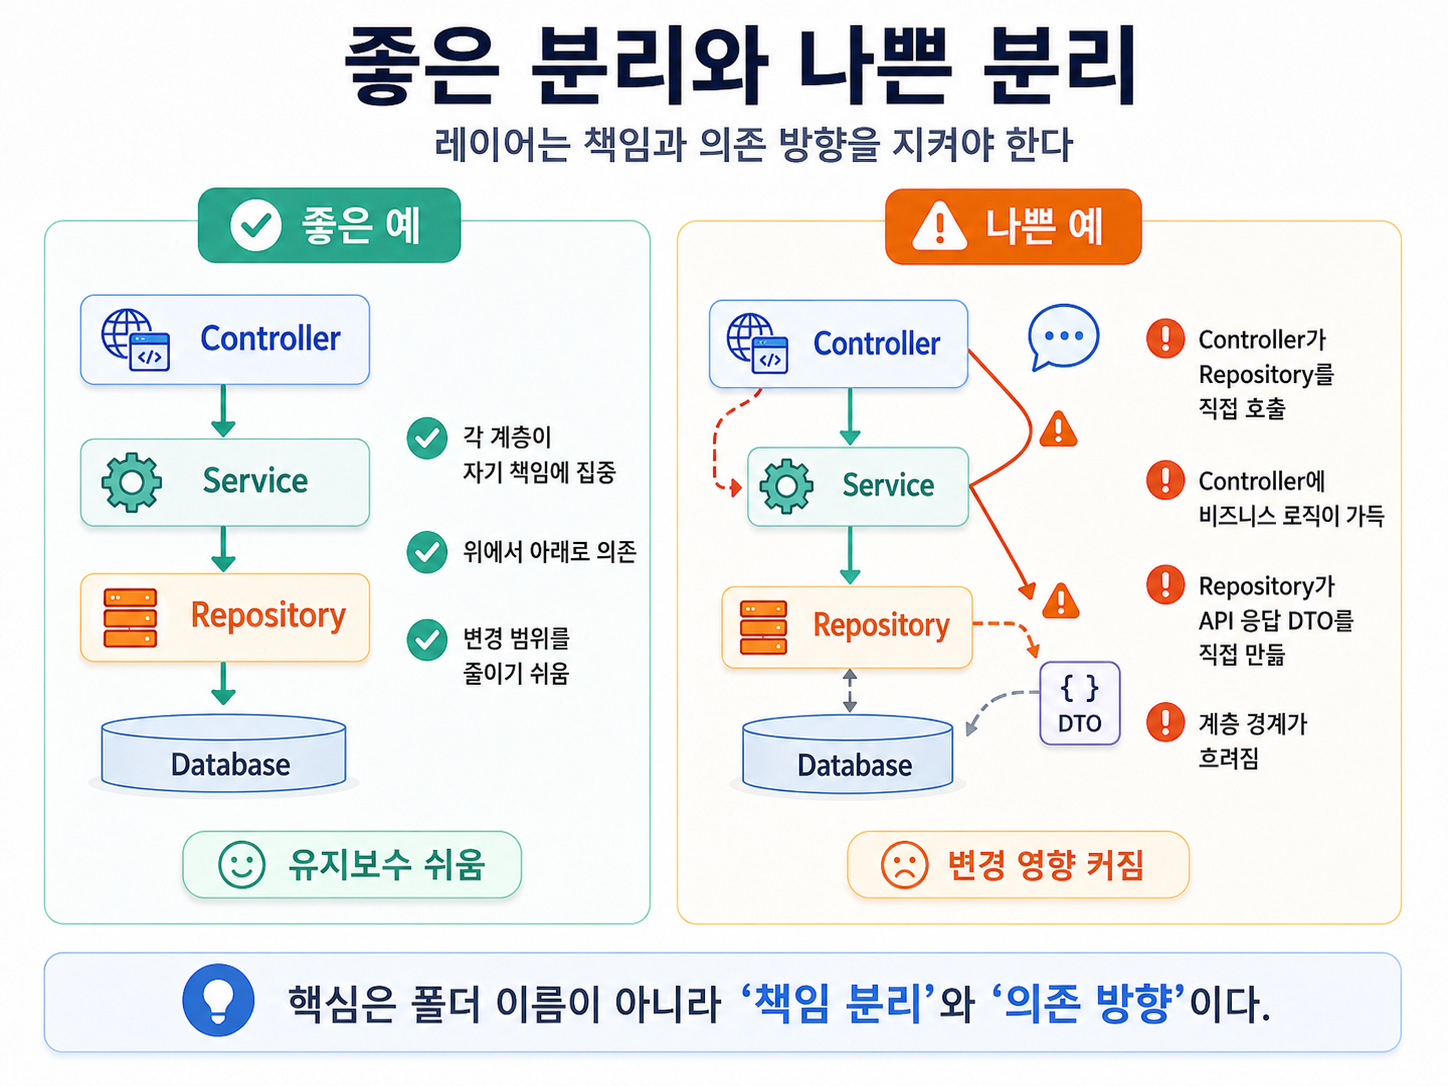
레이어 간 의존 방향
일반적인 레이어드 아키텍처에서는 위쪽 레이어가 아래쪽 레이어를 사용한다.
Controller
    ↓
Service
    ↓
Repository
즉,
Controller는 Service를 알고 있다.

Service는 Repository를 알고 있다.
반대로 Repository가 Controller를 알아야 할 이유는 거의 없다.
Repository
    ↓
Controller
이렇게 되면 데이터 접근 계층이 웹 계층에 의존하게 된다.
예를 들어 Repository가 Controller 전용 응답 DTO를 직접 사용한다고 생각해보자.
public interface UserRepository
        extends JpaRepository<User, Long> {

    @Query("""
        select new com.example.api.UserResponse(
            u.id,
            u.name
        )
        from User u
    """)
    UserResponse findUserResponse(Long id);
}
JPQL Projection 자체가 잘못된 것은 아니다.
실제로 조회 성능이나 편의성을 위해 DTO Projection을 사용하는 경우도 많다.
문제는 UserResponse가 특정 API의 응답만을 위한 DTO인데 Repository가 여기에 직접 의존하는 경우다.
API 응답 구조가 바뀌면 데이터 접근 계층까지 함께 수정해야 할 수 있기 때문이다.
API 응답 구조 변경
        ↓
Repository Query 수정
레이어를 분리했는데도 변경이 여러 계층으로 퍼진다면 경계가 제대로 나뉘지 않았을 가능성이 있다.
그래서 계층 간 의존성을 설계할 때는 다음 질문을 생각해보는 것이 좋다.
이 객체가 정말 이 계층이 알아야 하는 객체인가?
책임을 분리하면 무엇이 좋아질까?
레이어를 나누는 가장 큰 이유 중 하나는 변경의 영향을 줄이기 위해서다.
예를 들어 API 응답 형식이 다음과 같다고 해보자.
{
  "id": 1,
  "name": "Lee"
}
이를 다음과 같이 변경했다고 가정해보자.
{
  "userId": 1,
  "userName": "Lee"
}
API 응답 형식이 바뀌었다고 해서 DB 조회 방법까지 반드시 변경되어야 하는 것은 아니다.
레이어가 잘 나뉘어 있다면 변경은 주로 해당 책임을 가진 계층에서 발생한다.
HTTP 요청/응답 변경
→ Controller / Request DTO / Response DTO

비즈니스 규칙 변경
→ Service / Domain

DB 조회 방식 변경
→ Repository
즉 서로 다른 코드는 서로 다른 변경 이유를 가지게 된다.
이것이 책임 분리의 중요한 목적이다.
레이어드 아키텍처의 장점
1. 코드를 찾기 쉽다
새로운 프로젝트를 처음 보더라도 구조를 어느 정도 예상할 수 있다.
API 요청을 보고 싶다.
→ Controller

기능이 어떻게 동작하는지 보고 싶다.
→ Service

DB 조회 방법이 궁금하다.
→ Repository
어떤 코드를 어디서 찾아야 하는지 기준이 생긴다.
2. 테스트 범위를 나누기 쉽다
Controller에서는 HTTP 동작을 중심으로 테스트할 수 있다.
URL이 올바른가?
HTTP Status가 올바른가?
Request Body를 제대로 받는가?
Response Body가 올바른가?
Service에서는 기능과 규칙을 중심으로 테스트할 수 있다.
취소 가능한 주문이면 취소된다.

배송이 시작된 주문은 취소할 수 없다.

존재하지 않는 주문이면 예외가 발생한다.
Repository에서는 데이터 접근을 확인할 수 있다.
Query Method가 올바르게 동작하는가?

JPQL이 원하는 데이터를 조회하는가?

Entity Mapping이 올바른가?
테스트의 목적도 계층별로 나누기 쉬워진다.
3. 변경 범위를 줄일 수 있다
응답 형식이 바뀌었다고 해서 모든 코드를 수정할 필요는 없다.
DB 조회 방식이 변경되더라도 Controller까지 영향을 받지 않도록 설계할 수 있다.
각 코드가 서로 다른 변경 이유를 가지도록 만드는 것이다.
4. 코드의 책임이 명확해진다
코드를 작성할 때도 판단 기준이 생긴다.
HTTP 관련 코드
→ Controller

주문 취소 작업
→ Service / Domain

DB 조회
→ Repository
“이 코드를 어디에 넣어야 하지?”라는 고민을 할 때 기준점이 생긴다.
레이어드 아키텍처의 단점
레이어드 아키텍처도 모든 상황에서 완벽한 구조는 아니다.
1. 파일이 많아질 수 있다
회원 조회 기능 하나만 만들어도 다음과 같이 여러 파일이 생길 수 있다.
UserController
UserService
UserRepository
UserRequest
UserResponse
User
기능이 매우 단순한 프로젝트에서는 오히려 복잡하게 느껴질 수도 있다.
2. Service가 너무 커질 수 있다
비즈니스 로직을 전부 Service에 몰아넣으면 다음과 같은 클래스가 만들어질 수 있다.
UserService

회원가입
로그인
비밀번호 변경
프로필 수정
회원 탈퇴
권한 변경
포인트 적립
쿠폰 지급
알림 발송
처음에는 괜찮지만 기능이 계속 추가되면 Service가 수백 줄, 수천 줄까지 커질 수 있다.
이런 경우에는 상황에 따라 책임을 더 나눌 수 있다.
도메인 객체
정책 객체
별도 Service
UseCase
Validator
Manager
중요한 것은 새로운 클래스를 많이 만드는 것이 아니라 하나의 클래스가 너무 많은 책임을 가지지 않도록 하는 것이다.
3. 의미 없는 계층이 생길 수도 있다
다음과 같은 Service가 있다고 생각해보자.
public User getUser(Long id) {
    return userRepository.findById(id)
            .orElseThrow();
}
Repository 메서드를 한 번 호출하고 바로 반환한다.
이런 코드가 반드시 잘못된 것은 아니다.
프로젝트 전체의 일관성을 유지하거나 이후 기능 확장을 고려해 Service를 둘 수도 있다.
하지만 단순히
“레이어드 아키텍처니까 무조건 Service를 만들어야 한다.”
라고 생각하는 것은 조심해야 한다.
계층을 나누는 목적은 파일 개수를 늘리는 것이 아니라 책임을 나누는 것이기 때문이다.
4. 계층 경계가 쉽게 흐려질 수 있다
프로젝트를 개발하다 보면 편의를 위해 다음과 같은 코드가 생기기 쉽다.
Controller가 Repository를 직접 호출한다.

Controller에 비즈니스 로직이 들어간다.

Service가 HttpServletRequest를 직접 다룬다.

Repository가 API 응답 모델을 직접 사용한다.
한두 번은 큰 문제가 없어 보일 수 있다.
하지만 이런 코드가 계속 늘어나면 각 계층이 무엇을 담당하는지 모호해진다.
결국 처음에 레이어를 나눈 의미가 약해질 수 있다.
Entity와 Response DTO는 왜 나눌까?
초보 프로젝트에서는 다음과 같은 코드를 쉽게 작성할 수 있다.
@GetMapping("/{id}")
public User getUser(@PathVariable Long id) {
    return userService.getUser(id);
}
JPA Entity를 그대로 API 응답으로 보내는 것이다.
간단한 프로젝트에서는 동작할 수 있다.
하지만 규모가 커지면 여러 문제가 생길 수 있다.
예를 들어 Entity가 변경되면 API 응답까지 같이 변경될 수 있다.
Entity 변경
     ↓
API Response 변경
또 Entity에는 API 사용자에게 보여주면 안 되는 필드가 있을 수도 있다.
예를 들어 다음과 같은 필드가 있다고 해보자.
password
internalMemo
deletedAt
이런 정보가 외부 응답에 노출되는 것은 원하지 않을 수 있다.
그래서 일반적으로 API 응답용 DTO를 따로 둔다.
public record UserResponse(
        Long id,
        String name
) {
}
그러면 역할을 다음처럼 구분할 수 있다.
Entity
→ 내부 데이터와 도메인을 표현

Response DTO
→ 외부에 보여줄 API 응답을 표현
이렇게 경계를 나누면 내부 데이터 구조와 API 응답 구조를 독립적으로 변경하기 쉬워진다.
코드를 어느 레이어에 둘지 판단하는 기준
실제로 개발하다 보면
“이 코드는 Controller에 넣어야 할까? Service에 넣어야 할까?”
라는 고민을 자주 하게 된다.
그럴 때는 다음 질문을 기준으로 생각해보면 좋다.
Controller
이 코드는 HTTP 요청이나 응답과 관련되어 있는가?예를 들면 다음과 같다.
RequestBody
PathVariable
RequestParam
HTTP Status
Response
그렇다면 Controller와 가까울 가능성이 높다.
Service
이 기능을 수행하려면 어떤 작업이 필요한가?예를 들면 다음과 같다.
주문을 조회한다.
취소 가능한지 판단한다.
주문을 취소한다.
결제를 취소한다.
포인트를 복구한다.
이런 작업의 흐름을 조정한다면 Service와 가까울 가능성이 높다.
Repository
데이터를 어떻게 조회하거나 저장할 것인가?예를 들면 다음과 같다.
ID로 회원 조회
이메일 존재 여부 조회
사용자의 주문 목록 조회
특정 상태의 주문 조회
이런 코드라면 Repository와 가깝다.
결국 가장 중요한 질문은 다음이다.
이 코드가 변경되는 이유는 무엇인가?
HTTP가 바뀔 때 변경되는 코드인지, 비즈니스 규칙이 바뀔 때 변경되는 코드인지, 데이터 저장 방식이 바뀔 때 변경되는 코드인지 생각해보면 위치를 판단하기 쉬워진다.
항상 같은 구조를 따라야 할까?
꼭 그렇지는 않다.
레이어드 아키텍처는 매우 흔하고 이해하기 쉬운 구조지만 시스템이 복잡해지면 다른 아키텍처를 고민할 수도 있다.
예를 들어 다음과 같은 구조가 있다.
Hexagonal Architecture
Clean Architecture
Onion Architecture
이런 구조들은 특히 도메인과 외부 기술 사이의 의존성을 어떻게 분리할 것인지 더 적극적으로 고민한다.
하지만 처음부터 무조건 이런 구조를 적용해야 하는 것은 아니다.
오히려 백엔드를 처음 공부할 때는
Controller
Service
Repository
구조부터 제대로 이해하는 것이 좋다.
이 구조를 사용하면서 다음과 같은 질문을 직접 경험하게 되기 때문이다.
왜 Controller에서 DB를 바로 호출하면 불편할까?

왜 Service가 계속 커질까?

왜 Entity를 API 응답으로 바로 사용하면 문제가 생길까?

왜 계층 간 의존성을 고민해야 할까?
이런 문제를 경험한 뒤에는 Hexagonal Architecture나 Clean Architecture 같은 구조가 왜 등장했는지도 훨씬 쉽게 이해할 수 있다.
정리
레이어드 아키텍처는 단순히 다음과 같은 폴더를 만드는 것이 아니다.
controller
service
repository
핵심은 책임을 나누는 것이다.
Spring Boot에서는 보통 다음과 같이 이해할 수 있다.
Controller
→ HTTP 요청과 응답

Service
→ 애플리케이션의 작업 흐름과 비즈니스 처리

Repository
→ 데이터 접근
그리고 일반적인 요청 흐름은 다음과 같다.
Client
   ↓
Controller
   ↓
Service
   ↓
Repository
   ↓
Database
레이어드 아키텍처를 처음 배울 때는 이것만 기억해도 좋다.
레이어드 아키텍처는 코드를 역할별로 나누고, 각 코드가 자기 책임에 집중하도록 만드는 구조다.
코드를 작성하다가 위치가 고민된다면 다음 질문을 해보자.
이 코드는 HTTP 요청이나 응답을 처리하는 코드인가?

이 코드는 애플리케이션의 기능이나 규칙을 처리하는 코드인가?

이 코드는 데이터를 조회하거나 저장하는 코드인가?

이 코드가 다른 계층의 책임까지 알고 있지는 않은가?

이 코드가 변경되는 이유는 무엇인가?
이 질문을 반복하다 보면 Controller, Service, Repository를 단순히 관습적으로 나누는 것을 넘어
“왜 레이어를 나누는가?”
를 이해할 수 있게 된다.
결국 레이어드 아키텍처의 핵심은 폴더 구조가 아니라,
책임을 분리하고 변경의 영향을 줄이는 것
이라고 생각하면 된다.