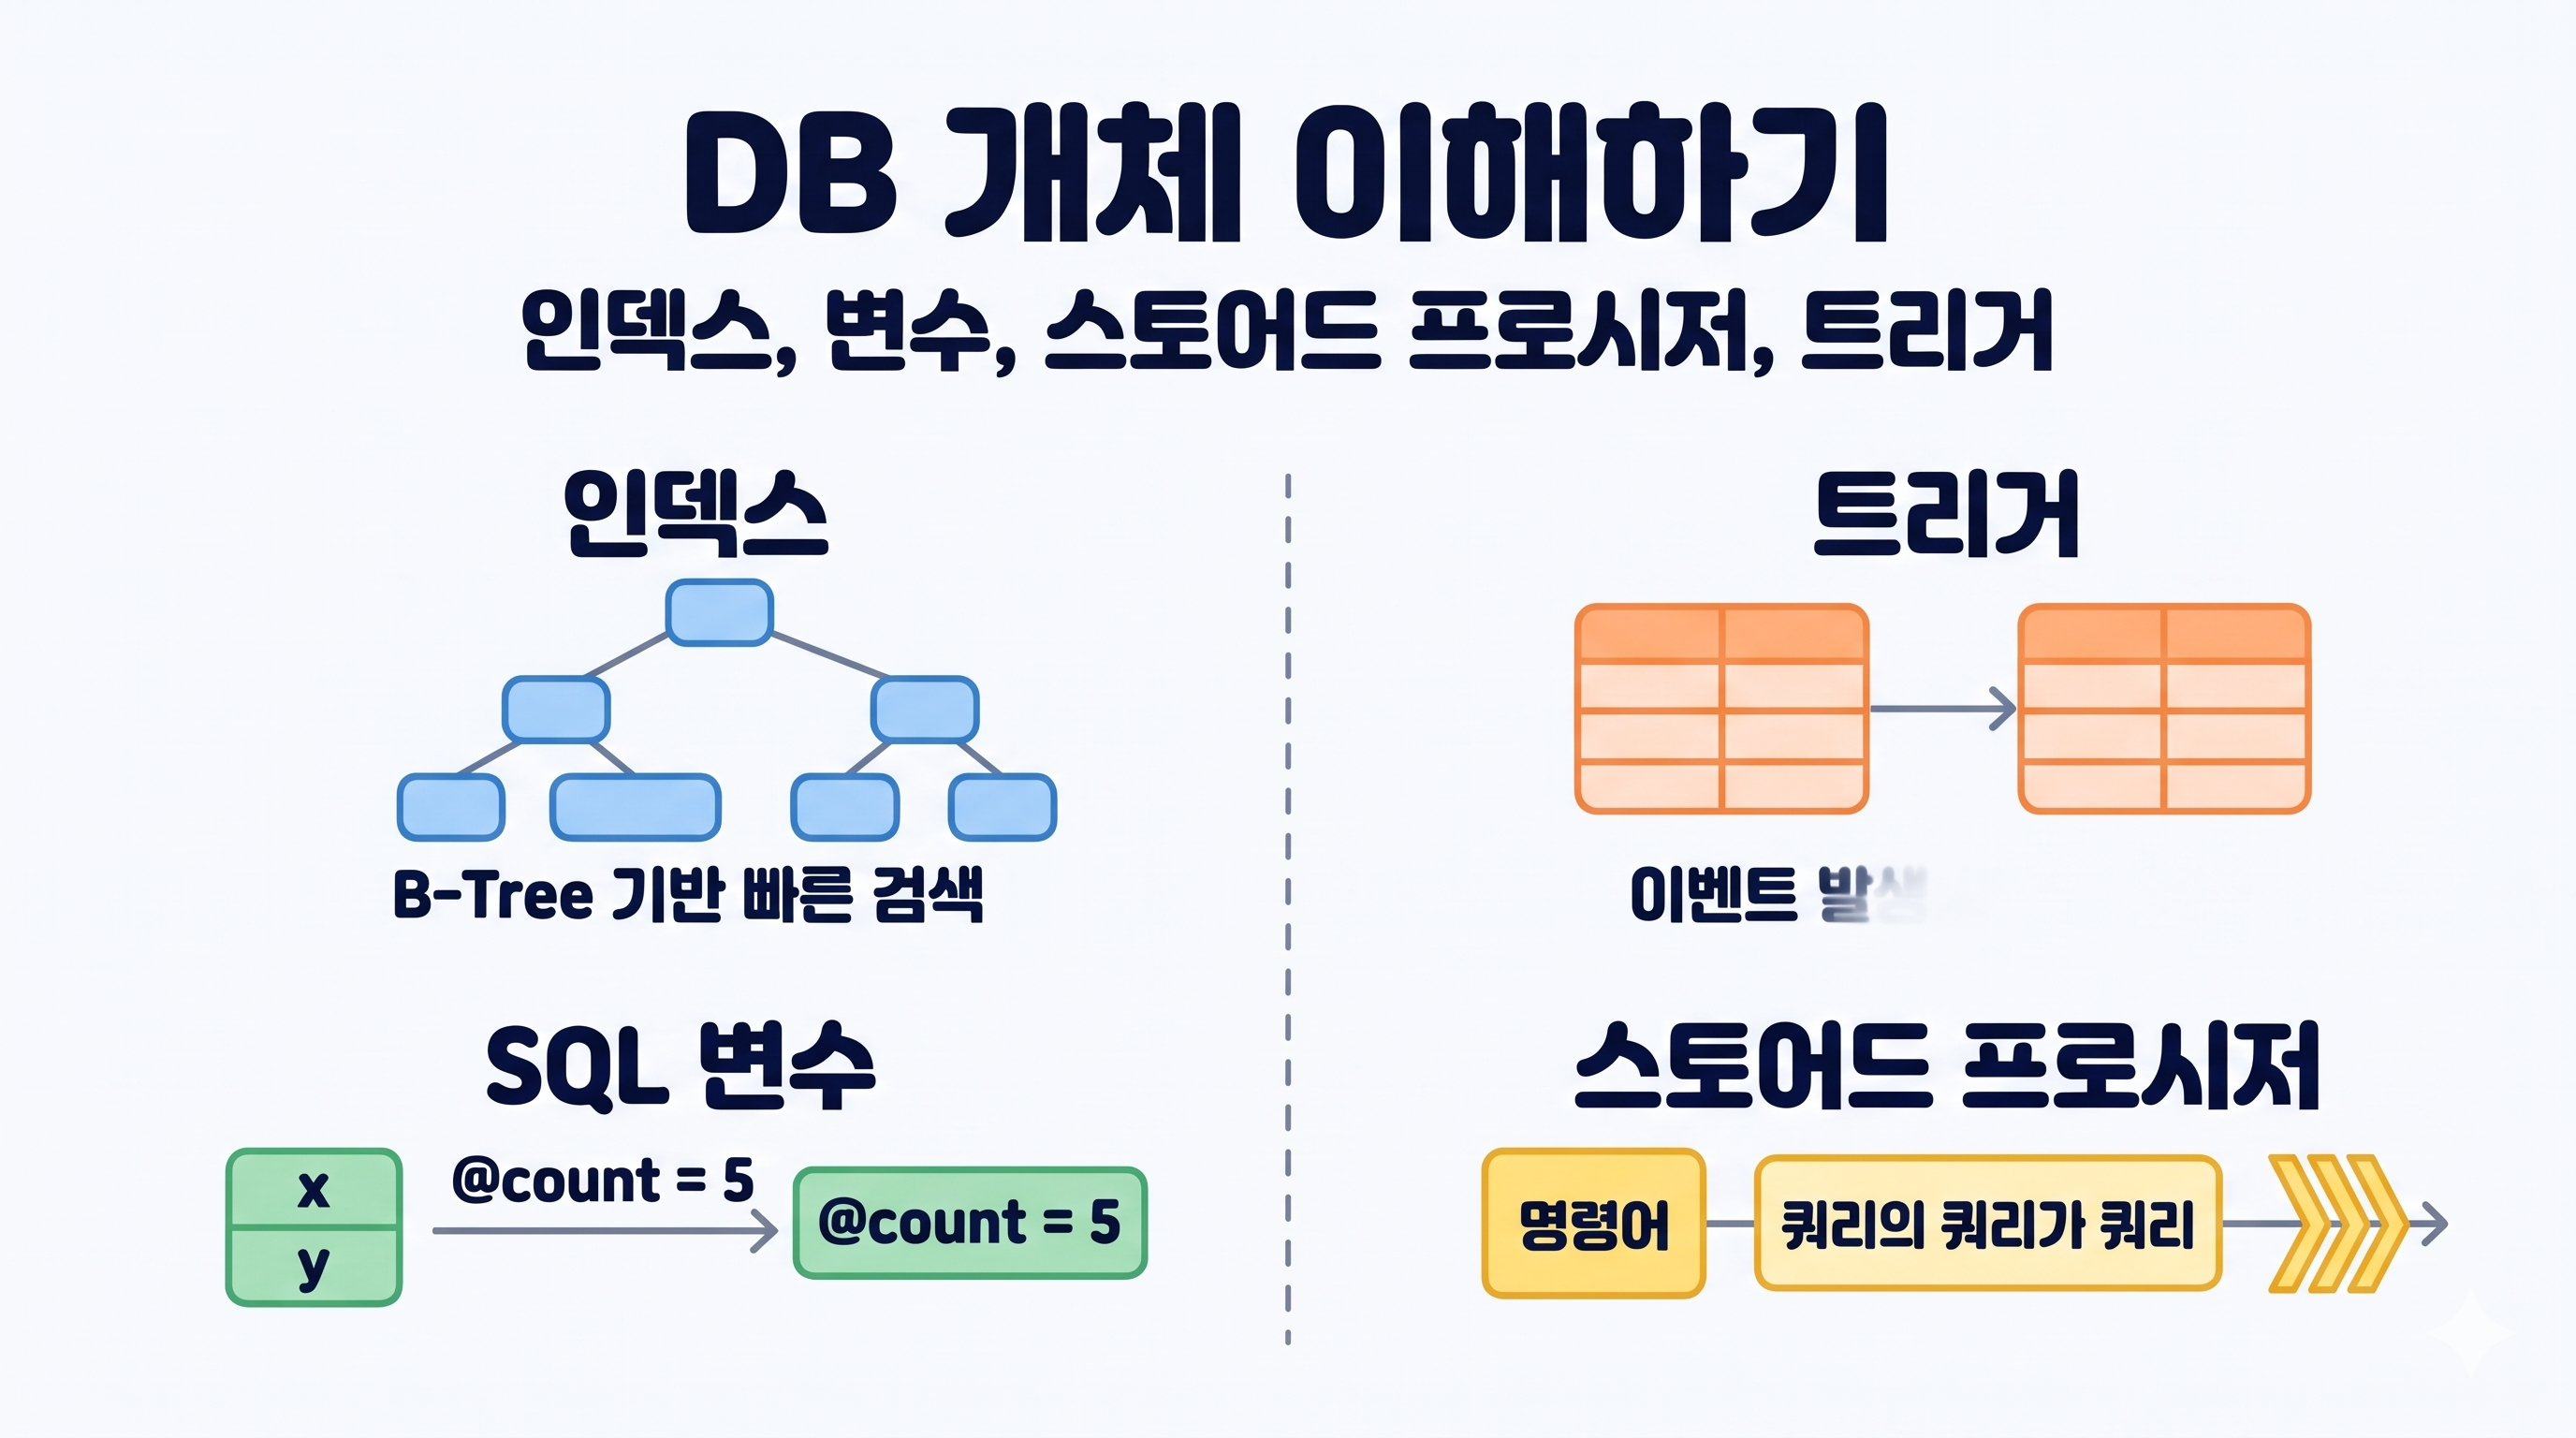
DB 개체
인덱스
B-Tree 자료구조 기반 데이터 검색 효율 향상 기법
새로운 레코드 삽입 및 수정 시에도 활용
- 클러스터형 인덱스
- 인덱스 자체가 데이터의 물리적인 순서 결정-
1 테이블 1 클러스터형 인덱스
-
예: PRIMARY KEY, UNIQUE NOT NULL
// 방법 1
ALTER TABLE students ADD PRIMARY KEY (id);

// 방법 2
CREATE CLUSTERED INDEX 인덱스명 ON students (id);
-
- 보조 인덱스
- PK 이외의 다른 컬럼을 기준으로 생성되는 인덱스
- 테이블의 실제 데이터 행과 별도로 저장됨-
1 테이블 多 보조 인덱스 가능
-
클러스터형 인덱스보다 한 단계(인덱스 키로 데이터 행의 위치 검색) 더 필요
-
예: UNIQUE, UNIQUE NULL
// 방법 1
ALTER TABLE students ADD INDEX 인덱스명 (id);

// 방법 2
CREATE [UNIQUE] INDEX 인덱스명 ON students (id);
-
어떻게 써야 하나?
- WHERE 절에 많이 사용되는 열에 사용
- 자주 사용하는 컬럼에 사용
- 사용하지 않는 인덱스는 제거
쓰지 말아야 하는 경우는?
- 인덱스 지정하는 컬럼 크기가 크거나 인덱스 수가 많으면 너무 많은 데이터 저장 공간 더 필요
- '성별'처럼 중복 데이터가 많은 컬럼에는 사용 X
- 데이터의 삽입/수정/삭제 작업 자체가 느려질 수 있음
SQL 변수
- SQL도 다른 일반적인 프로그래밍 언어처럼 변수를 선언하고 사용할 수 있음
- 변수는 워크벤치를 재시작할 때까지 유지되다가 종료하면 없어짐
형식
SET @변수이름 = 변수의 값;
예: SET @count = 5;
주의사항
SELECT문에서 LIMIT문에는 변수 사용 불가 → PREPARE, EXCUTE문으로 대체
SET @count = 5;
PREPARE mySQL FROM 'SELECT code, name, continent, region, population
  FROM world.country
 ORDER BY 1 ASC
 LIMIT ?';
EXECUTE mySQL USING @count;
스토어드 프로시저
- 자주 사용하는 여러 개의 SQL문을 하나로 묶어 함수처럼 일괄적으로 처리
- 네트워크 소요 시간 감소- 개발 업무 구분 가능
CALL 프로시저명();형식으로 SQL 묶음을 호출
예시
gender가 'man'인 학생들의 수를 세는 스토어드 프로시저
DELIMITER //	-- 시작

CREATE PROCEDURE count_men()

BEGIN		-- sql 시작
    DECLARE count INT;
    SELECT COUNT(*) INTO count FROM students WHERE gender = 'man';
    IF count > 3 THEN
        SELECT 'Many men' AS result;
    ELSE
        SELECT 'Few men' AS result;
    END IF;
END //		-- sql 끝

DELIMITER ;		-- 끝

select * from students;
call count_men();
TRIGGER
테이블에서 어떤 이벤트(update, insert, delete)가 발생했을 때, 실행시키고자 하는 추가 쿼리 작업들을 자동으로 수행
- DML에만 작동되며, MySQL에서는 VIEW에는 트리거 사용 불가
- truncate는 commit까지 완료되므로 trigger를 부착 불가
구분
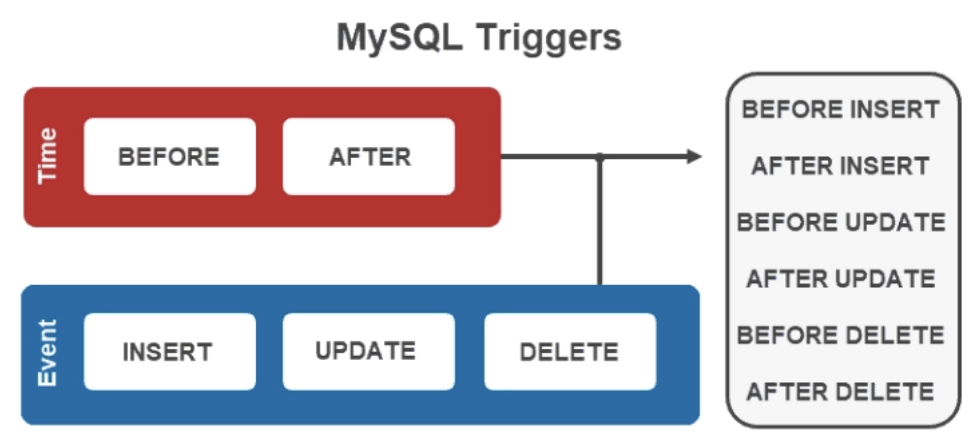
- BEFORE/AFTER는 명령 키워드가 사용된 후에 처리할지 아니면 끝난 후 처리할지 나타냄
- 처리할 내용 부분에서 OLD, NEW 명령 키워드로 변경되는 테이블에 접근 가능
- ( OLD : 변경되기 전 테이블, NEW : 변경된 후 테이블 )
예시
DELIMITER $$

CREATE TRIGGER 트리거이름
    AFTER DELETE -- 트리거를 달 동작
    ON 테이블 FOR EACH ROW

BEGIN
    -- 문장
END $$

DELIMITER ;
-