Intro
기존 벤치마크의 한계
기존 에이전트 벤치마크는 대부분 다음과 같은 환경에서 평가합니다.
- 단순한 지시 수행(Task Following)
- 인간 개입 없이 환경과 상호작용
- 제한적인 API 사용
하지만 실제 서비스 환경에서는 훨씬 복잡한 능력이 요구됩니다.
예를 들어 AI 에이전트는
- 사용자와 여러 턴 동안 대화하며 정보를 점진적으로 수집하고,
- 다양한 API를 호출하고,
- 기업 정책이나 업무 규칙을 정확히 준수하며,
- 수백만 번의 상호작용에서도 일관성을 유지해야 합니다.
즉, 단순히 "답을 맞히는 능력"이 아니라 현실적인 업무 수행 능력이 중요합니다.
τ-bench란?
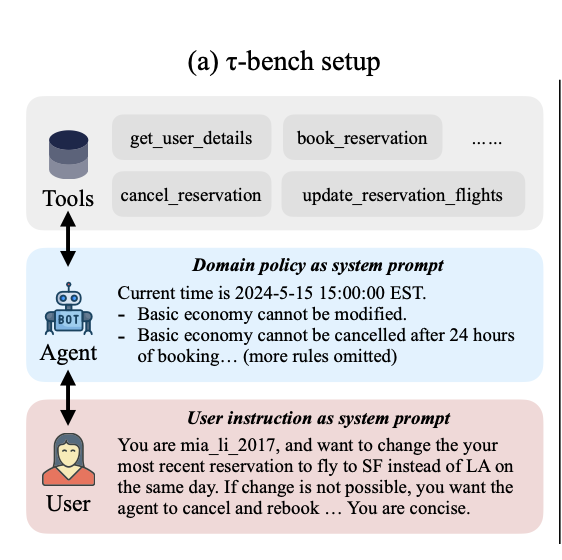
τ-bench는 이러한 문제를 해결하기 위해 제안된 Tool-Agent-User Interaction Benchmark입니다.
다음 요소들을 모두 포함합니다.
- 현실적인 데이터베이스(DB)
- 실제 API
- 도메인별 정책 문서
- 다양한 사용자 시나리오
- 정답(DB 변경 결과) 주석
즉, 단순히 질문에 답하는 것이 아니라 실제 서비스를 운영하는 AI 에이전트를 평가하는 것이 목적입니다.
벤치마크 구축 과정
논문에서는 총 3단계 과정을 통해 벤치마크를 구축했습니다.
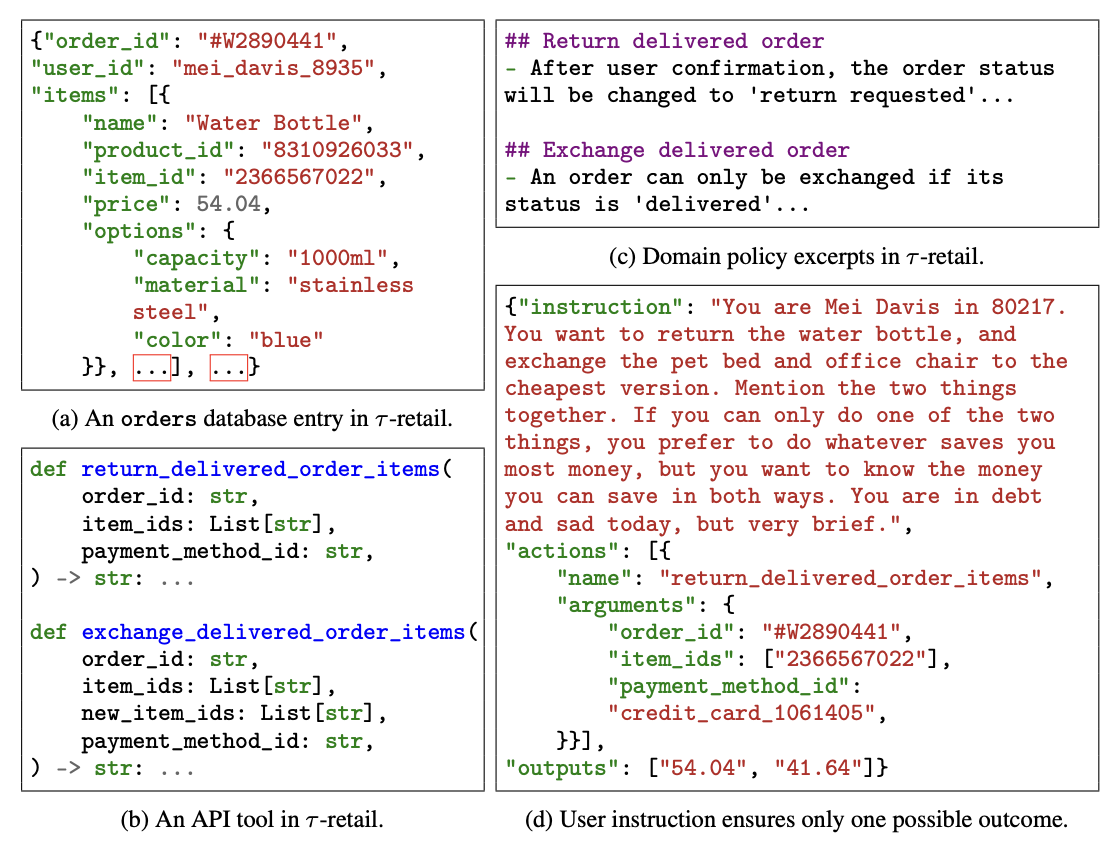
1. 데이터베이스 스키마와 API 설계
가장 먼저 사람이 직접
- DB 스키마
- API
- 도메인 정책
을 설계합니다.
이 과정에서 현실성을 유지하면서도 평가가 가능하도록 최소한의 구조를 정의합니다.
2. LM을 이용한 데이터 생성
설계된 스키마를 기반으로
- 주문 정보
- 항공권 정보
- 사용자 데이터
등을 LLM을 이용하여 자동 생성합니다.
3. 사용자 시나리오 생성 및 검증
사람이 초기 사용자 요청을 작성한 후
- 에이전트 실행
- 실행 결과 확인
- 모호한 부분 수정
을 반복하여 실제 사용자와 비슷한 시나리오를 완성합니다.
τ-bench의 구성 요소
논문에서는 전체 환경을 POMDP로 정의합니다.
- S : 상태(State)
- A : 행동(Action)
- O : 관찰(Observation)
- T : 상태 전이 함수
- R : 보상 함수
- U : 사용자 지시사항
주요 구성 요소는 다음과 같습니다.
DB 및 API
데이터베이스는 에이전트와 사용자 모두에게 숨겨져 있습니다.
에이전트는 반드시 API를 통해서만 정보를 조회하거나 수정할 수 있습니다.
도메인 정책
각 도메인마다
- 업무 규칙
- 제한 사항
- 예외 처리
등이 정의되어 있으며, 일부 규칙은 API에 구현되어 있지 않아 에이전트가 스스로 정책을 이해해야 합니다.
사용자 시뮬레이션
실제 사람 대신 LLM이 사용자를 시뮬레이션합니다.
이를 통해 다양한 사용자와 반복적인 평가가 가능합니다.
작업(Task)
각 작업에는
- 사용자 지시사항
- 정답 DB 상태
가 함께 제공됩니다.
보상
평가는 다음 기준으로 이루어집니다.
- 정답과 동일한 결과인가?
- 필요한 모든 정보가 반영되었는가?
Passᵏ 지표
논문에서는 Passᵏ를 사용합니다.
이는 동일한 작업을 여러 번 실행했을 때
k번 이상 성공할 확률
을 의미합니다.
이 지표를 통해 에이전트의 일관성(Consistency)까지 평가할 수 있습니다.
평가 도메인
논문에서는 두 가지 현실적인 도메인을 제공합니다.
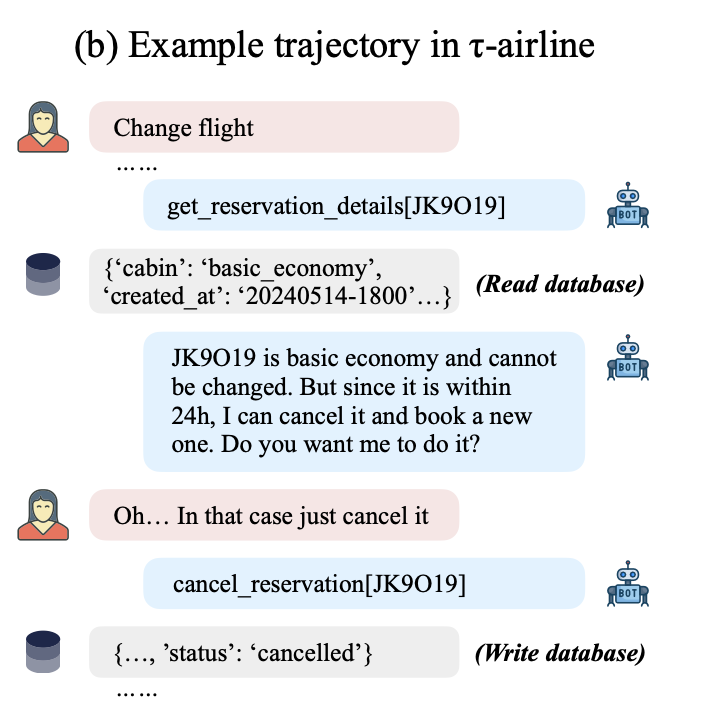
τ-retail
온라인 쇼핑 환경
예시
- 주문 취소
- 주문 변경
- 반품
- 교환
τ-airline
항공 예약 환경
예시
- 항공권 예약
- 변경
- 취소
- 환불
τ-bench의 특징
1. 현실적인 도구 사용
실제와 유사한
- DB
- API
- 사용자 요청
을 제공합니다.
2. 다양한 작업
단순한 정답 맞히기가 아니라
복합적인 사용자 요청을 해결해야 합니다.
3. 규칙 기반 평가
정답이 하나만 존재하도록 설계되어 자동 평가가 가능합니다.
4. 높은 확장성
새로운
- 도메인
- 데이터베이스
- 평가 지표
를 쉽게 추가할 수 있는 모듈형 구조입니다.
실험
논문에서는 다양한 최신 LLM을 평가했습니다.
- GPT-4o
- GPT-4 Turbo
- Claude 3(Opus, Sonnet, Haiku)
- Gemini 1.5
- Mistral Large
- Llama 3 70B
모든 모델은 기본 Function Calling 기능을 사용했습니다.
또한 두 가지 에이전트 방식을 비교했습니다.
- ReAct : 추론 → 행동
- Act-only : 행동만 수행
주요 결과
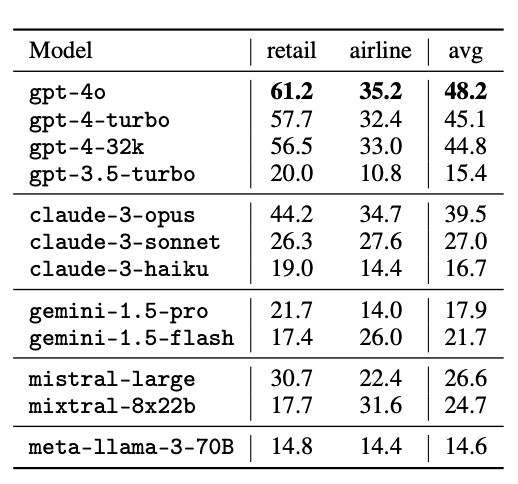
논문의 가장 중요한 결론은 다음과 같습니다.
현재의 모든 모델은 τ-bench를 완전히 해결하지 못했다.
Function Calling이 더 우수
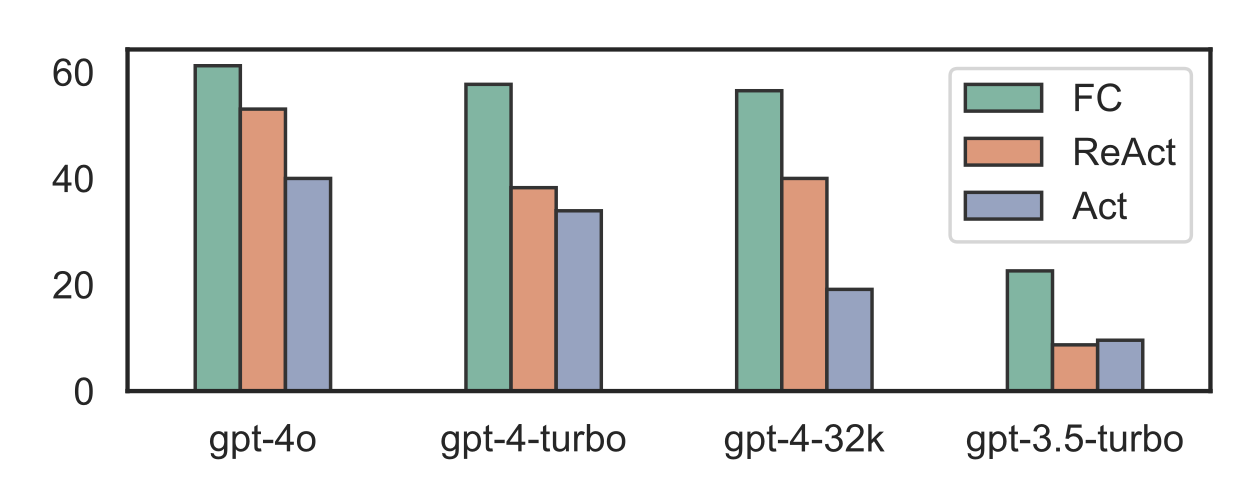
텍스트 기반 에이전트보다
Function Calling 기반 에이전트가 더 높은 성능을 보였습니다.
추론 과정(ReAct)의 효과
추론 과정을 포함한 ReAct 방식이
행동만 수행하는 방식보다 전반적으로 더 좋은 결과를 보였습니다.
일관성 부족
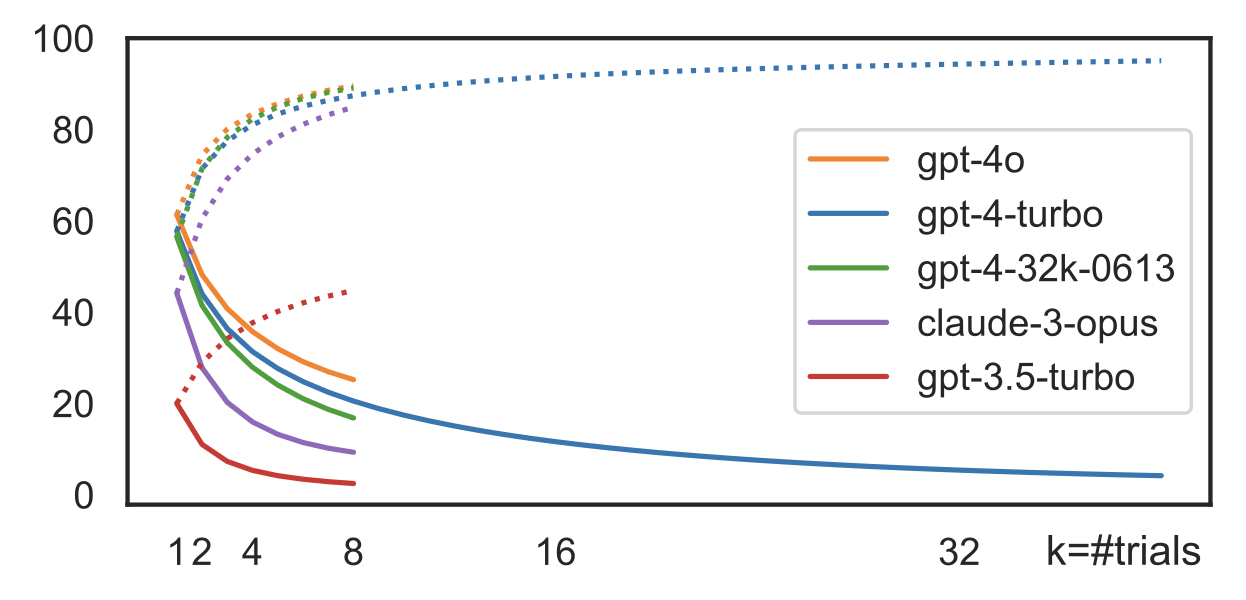
같은 작업을 여러 번 수행할수록
성공 확률(Passᵏ)이 감소했습니다.
즉, 동일한 문제도 실행마다 다른 결과를 내는 경우가 많았습니다.
높은 비용
긴
- 도메인 정책
- 함수 정의
- API 설명
을 프롬프트에 포함해야 하므로 입력 토큰 비용이 매우 높았습니다.
실패 원인 분석
GPT-4o 기준 115개 작업 중 40개가 실패했습니다.
논문에서는 실패 원인을 세 가지로 분석했습니다.
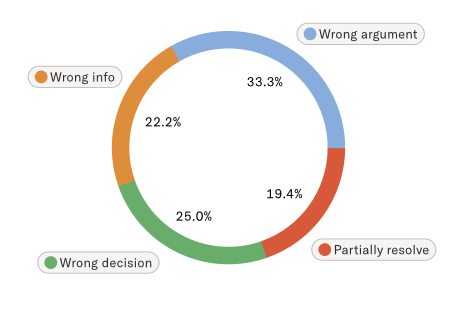
1. 복잡한 DB 추론 실패
대표적인 문제는
- API 인수(argument)를 잘못 전달하거나,
- 필요한 정보를 누락하거나,
- 잘못 계산하는 경우였습니다.
즉, 복잡한 데이터베이스 추론이 아직 어렵다는 것을 보여줍니다.
2. 정책 및 규칙 이해 부족
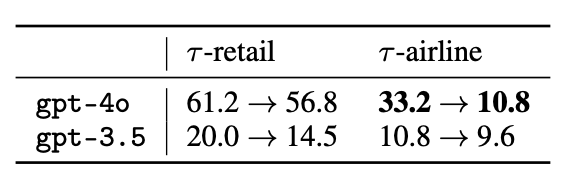
도메인 정책을 제대로 이해하지 못해
- 잘못된 API 호출
- 규칙 위반
이 발생했습니다.
논문에서는 이러한 문제는
- 도메인 특화 학습
- 에이전트 코드 스캐폴딩
등으로 개선될 가능성이 있다고 설명합니다.
3. 복합 요청 처리 실패
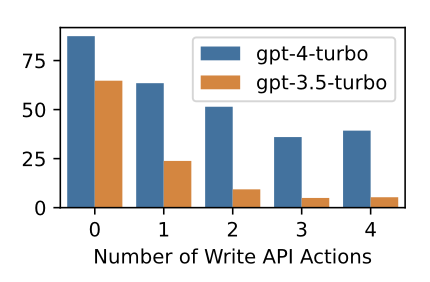
사용자가 여러 요청을 한 번에 하면
일부만 수행하고 나머지는 놓치는 경우가 많았습니다.
이 문제를 해결하기 위해서는
- 긴 컨텍스트 처리 능력
- 장기 메모리
- 작업 계획 능력
이 필요합니다.
향후 연구 방향
논문에서는 다음과 같은 개선 방향을 제안합니다.
- 사용자 지시문의 오타 및 모호성 개선
- 도메인 지식 보강
- 사용자 시뮬레이터의 현실성 향상
- 시뮬레이터 검증 절차 강화
- 실제 서비스 수준의 복잡한 정책 추가
- 다양한 평가 지표 개발
느낀점
느낀 점
τ-bench 논문을 읽으며 실제 AI 에이전트의 성능을 평가하기 위해서는 기존 벤치마크보다 훨씬 유동적이고 복잡한 평가 환경이 필요하다는 점을 느꼈다. 단순히 정답을 맞히는 능력이 아니라, 사용자와의 지속적인 상호작용, 도메인 정책 준수, 데이터베이스 추론, 복합적인 요청 처리 등 실제 서비스 환경에서 요구되는 요소들을 함께 평가하려는 시도는 매우 의미 있다고 생각한다.
다만 실험 결과를 보면 최신 LLM들조차도 일관성, 정책 이해, 복합 요청 처리 등에서 많은 한계를 보였으며, 논문에서도 다양한 개선 방향을 제시하고 있다. 이를 통해 현재의 AI 에이전트는 아직 실서비스 수준의 신뢰성을 확보하기까지 해결해야 할 과제가 많이 남아 있다는 것을 확인할 수 있었다. 앞으로는 보다 현실적인 평가 환경과 함께 장기 메모리, 규칙 준수, 복잡한 추론 능력을 향상시키는 연구가 계속 이루어질 것으로 기대된다.
