0. Background
- Transformer 기반 LLM은 난해한 다단계 추론을 요구하는 작업에서 놀라운 성능을 보였다
- 그러나 동시에, 놀라울 정도로 단순한 문제에서도 실패하는 모습을 보였다.
Transformer LLM은
다단계 조합 추론 문제를 선형화된 부분 그래프 매칭(linearized subgraph matching)으로 바꿔서 해결하며 반드시 체계적인 문제 해결 능력을 학습하는 것은 아니다.
1. Introduction
ChatGPT, GPT-4 같은 대규모 Transformer 모델들은 지금까지 없던 수준의 뛰어난 능력을 보여주고 있다. 하지만 3자리 곱셈과 같은 단순한 작업에서 55%-59%의 정확도밖에 보이지 않는다.
어떤 조건에서 성공하고, 실패하며, 이유는 무엇인가?
어떤 종류의 오류를 만드는가?
Transformer는 숨겨진 문제 해결 규칙을 스스로 찾아낼 수 있는가,혹은 추론 과정을 따르도록 학습될 수 있는가?
이러한 조합적 문제들은 AI 시스템에게 중요한 도전 과제가 된다.
왜냐하면 이 문제들은 기본적인 추론 연산들을 조합해서, 유일한 정답에 도달하는 계산 경로를 따라가야 하기 때문이다.
이를 증명하기 위해 대표적인 3가지를 가지고 연구하였다.
- Long-form multiplication
- 여러 자리 곱셈
- Logic grid puzzles
- 논리 격자 퍼즐, 즉 아인슈타인 퍼즐
- Classic dynamic programming problem
- 고전적인 동적 계획법 문제
두가지 가정
- Transformer는 다단계 조합 추론을 선형적인 경로 매칭(linearized path matching)으로 단순화해서 문제를 해결한다.
- 정답을 만들기 위해 필요한 계산 규칙을 학습하고 단계적으로 적용하는 체계적인 다단계 추론 접근과는 다르다
- 비슷한 패턴의 문제에서는 빠르고 정확한 답안을 낼 수 있지만, 특이 케이스에 한해서는 적용되지 않는다
- 오류 전파(error propagation) 때문에 Transformer는 새로운 패턴을 포함한 복잡한 조합 문제를 해결하는 데 근본적인 한계가 있을 수 있다.
계산 과정의 초반 단계에서 발생한 오류는 이후 단계에서 점점 누적되며, 결국 모델이 올바른 정답에 도달하지 못하게 만든다.
이를 Computation graph를 만들어 표현하였다.
Computation Graph란?
문제 해결 과정을 여러 개의 작은 연산 단계로 나누어,문제의 복잡도를 구조적으로 측정하고 각 계산 단계를 언어 모델이 이해할 수 있는 순차적인 입력 형태
2. Measuring Limitations of Transformers in Compositional Tasks
2.1 Computation Graph Definition
: 문제를 푸는 알고리즘
(primitive functions): 알고리즘이 사용하는 기본 연산
: 문제 입력
(computational graph):입력 x에 대해 알고리즘이 실제 수행하는 모든 계산 흐름을 표현한 그래프
- (V, E, s, op) 로 구성
- (nodes): 계산 과정의 모든 값
- (edges): 계산 흐름
- (value function): 각 노드 값
- op(operation): 각 노드가 만들어진 연산
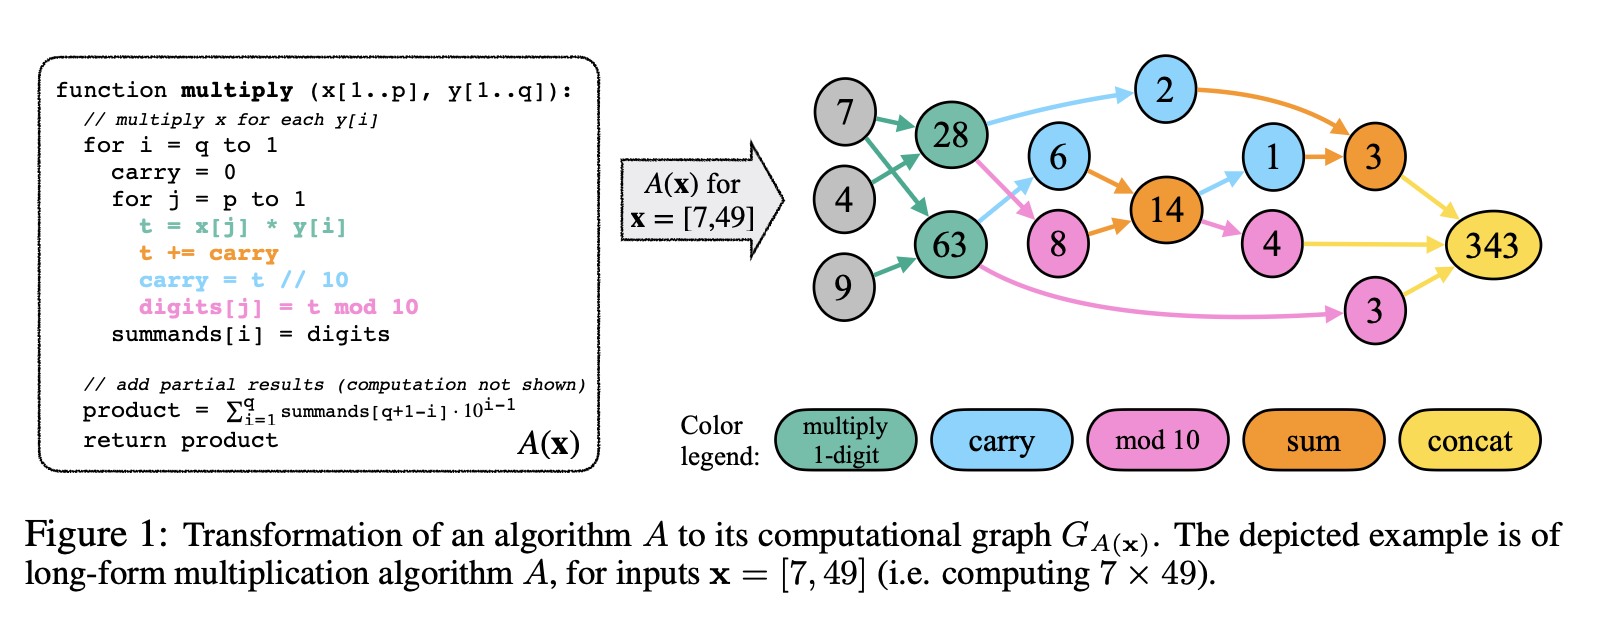
모든 계산 결과: 노드
각 노드가 가지는 값
계산에 사용되는 입력 관계: 엣지
하나의 기본 연산
Source node: S
Output node: O
→ 방향성이 있고, 사이클이 없는 Directed Acyclic Graph이다.
알고리즘 A를 llm에 적용하기 위해서는 그래프를 텍스트로 변환해야 한다
- 이 순서는 반드시 topological order여야 한다
2.2 Quantifying Compositional Complexity using Graph Metrics
그래프 를 통해 작업 복잡도를 다각도에서 측정할 수 있다
- 노드 v의 layer number: 입력에서 v까지 가는 가장 긴 경로 길이
Reasoning Depth
Multi-step reasoning의 난이도를 의미
- 입력부터 결과까지 가는 가장 긴 경로 길이 = 그래프에서 가장 큰 layer number
Reasoning Width
계산 중에 동시에 유지해야 하는 변수의 수
- 한 단계에서 몇개를 계산하는가
Average Parallelism
평균적으로 얼마나 많은 계산이 병렬적으로 필요한가
2.3 Predicting Surface Patterns through Relative Information Gain
전체 답은 틀렸지만, 일부는 맞는 경우가 있음
Relative Information Gain을 통해 확인
입력 : X, 출력: Y
출력 가 입력 일부 만 보고 얼마나 결정되는지 측정
((원래 불확실성) - (X를 알때 불확실성)) / (원래 불확실성)
2.4 Exploring Three Representative Compositional Tasks: Definitions
- 곱셈, Einstein 퍼즐, Dynamic Programming 3가지 문제로 LLM의 다단계 추론 능력을 테스트
Multiplication
일반적인 곱셈 (long-form multiplication algorithm) 사용
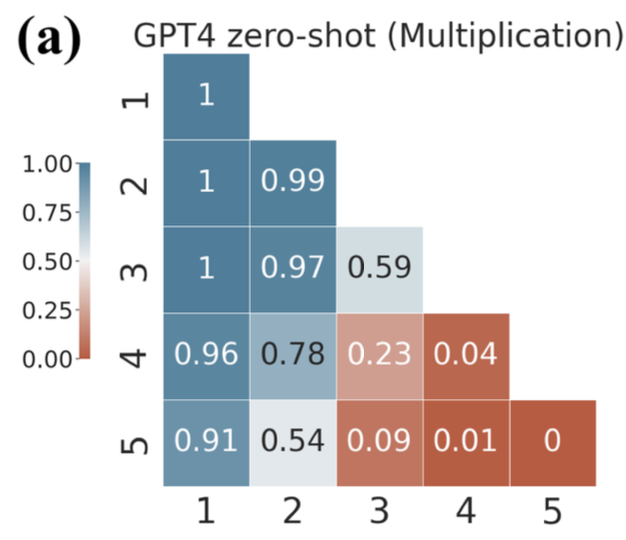
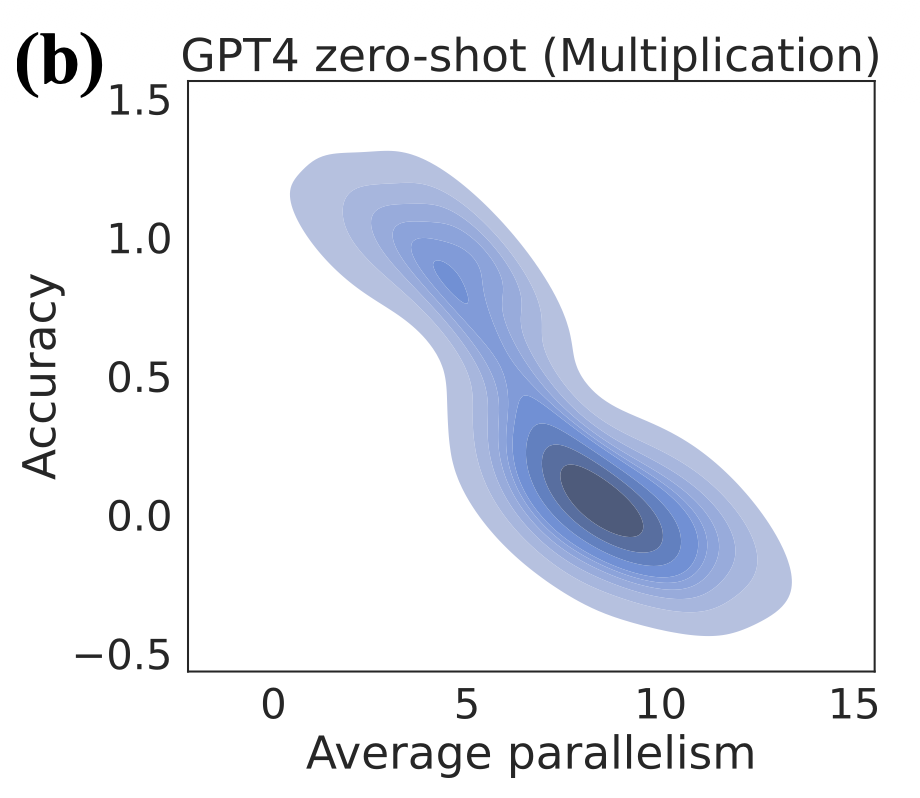
- 자릿수가 많아질수록 Average parallelism이 증가하며, 성능이 떨어진다.
Einstein’s Puzzle
여러 집과 속성이 있고, 조건들을 조합해서 답을 찾는 퍼즐 (K x M 행렬)
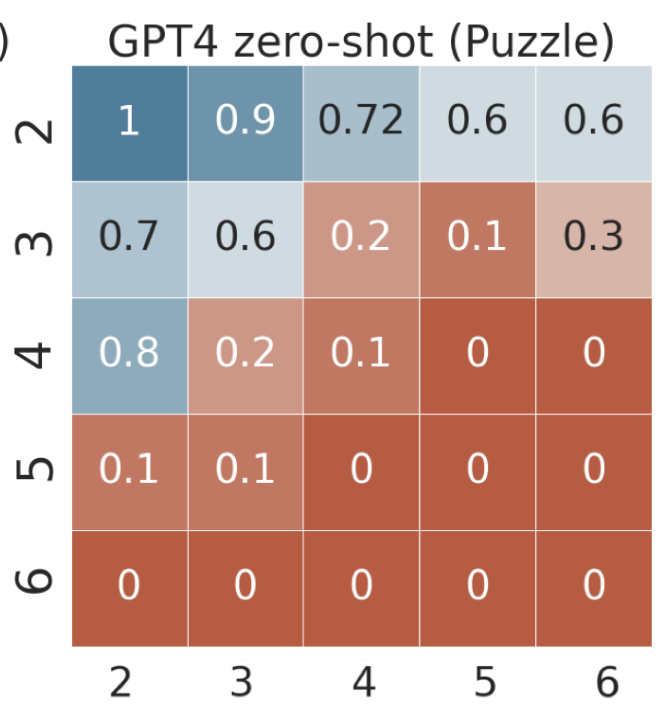
- K, M이 증가할수록 성능이 떨어진다.
Dynamic Programming (DP)
인접하지 않게 숫자 선택하여 최대 합을 구함
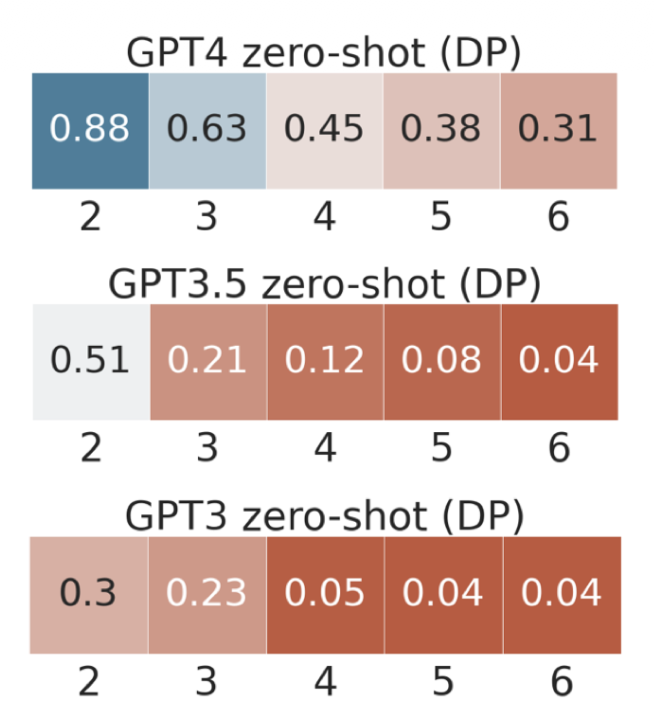
- 규모가 커질수록 성능이 떨어진다.
작업이 복잡해질수록 성능이 떨어짐을 확인
3. Testing the Limits of Transformers: Empirical Evidence
GPT3, ChatGPT, GPT4 모델을 가지고 zero-shot, few-shot, finetuning, scratchpads 기법을 사용해 평가
두가지 방식으로 실험
- question → answer
- question → scratchpad
3.1 Testing the Limits of Transformers with Zero-shot, Few-shot and Finetuning
Task-Specific 데이터가 부족해 성능이 낮은가?
가능한 모든 문제를 학습 시켜 성능 평가
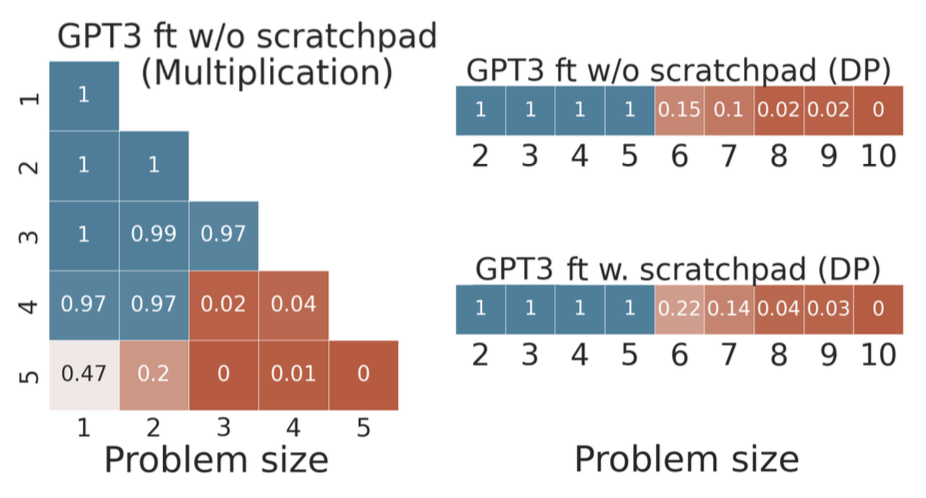
-
학습한 범위 안(파란 영역) 안에서는 완벽하지만, 학습 범위 밖(빨간 영역)에서는 정확도가 떨어진다.
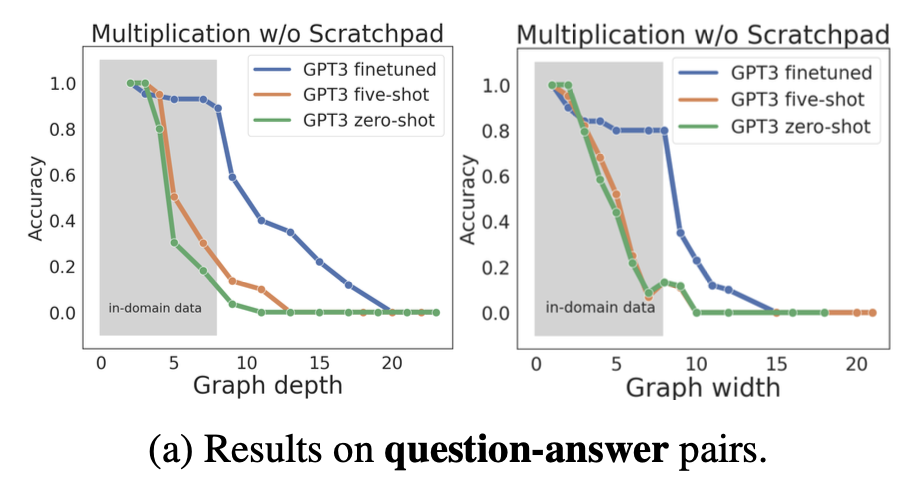
-
문제가 복잡해질수록 OOD (Out-Of-Domain) data가 많이 생겨 성능 감소
scratchpad 학습을 진행한다면? (풀이 과정을 준다면?)
계산 과정에 대한 직접적인 풀이 제공
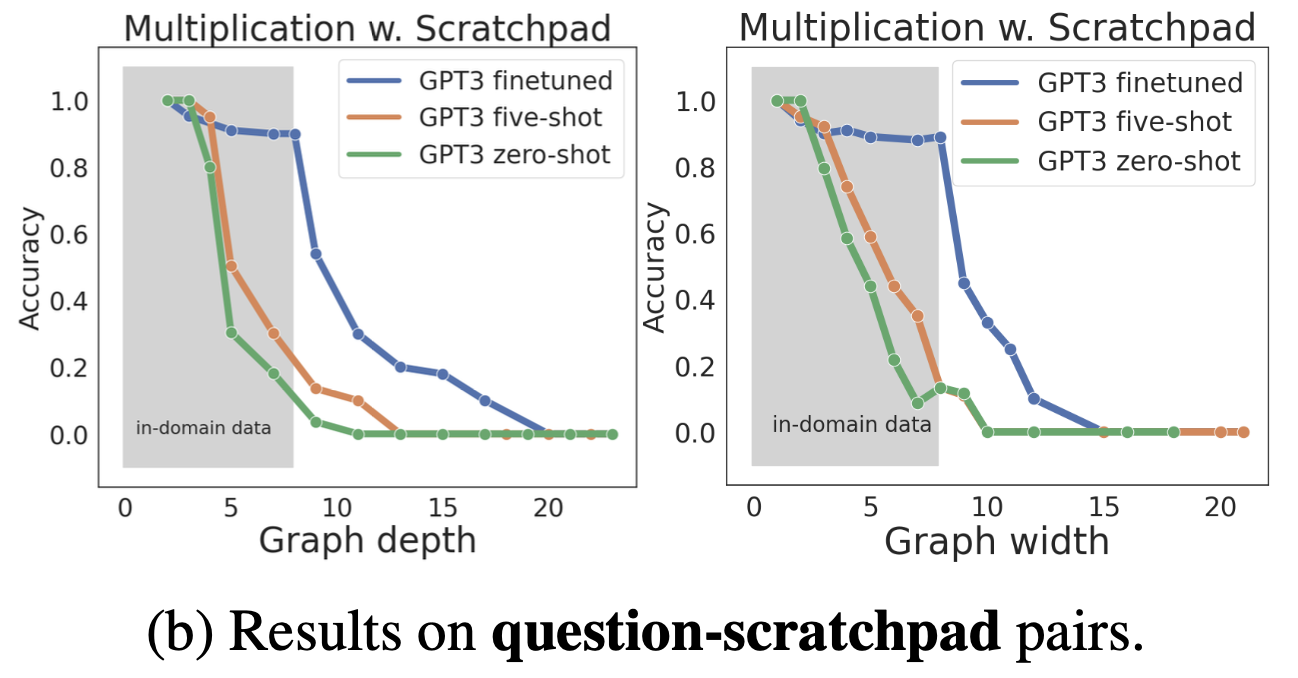
마찬가지로 OOD에서 성능이 급격하게 감소
계산 과정을 가르쳐도 모델이 이를 일반화 가능한 방식으로 배우지 못한다.
전체적인 문제 해결 규칙을 학습하기보다는, 다음 단어를 예측하는 방식으로 패턴을 암기 (Transformer의 Autoregressive의 한계)
grokking에서 transformer의 한계
학습을 overfitting보다 길게 하면 일반화 능력이 향상될까? (grokking)
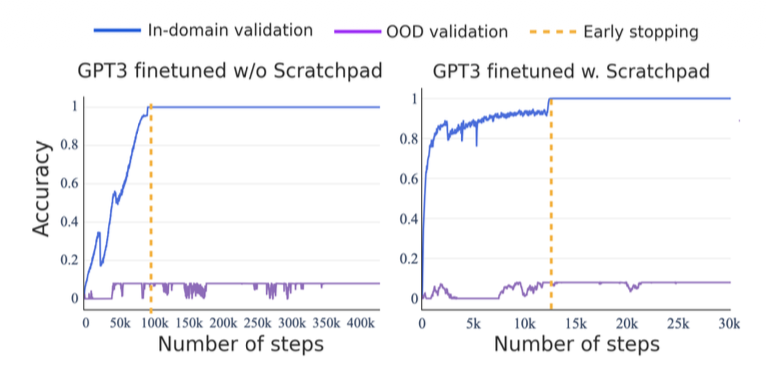
곱셈 문제에서 모델을 overfitting 이후까지 계속 학습시켜서, OOD 일반화 능력(grokking)이 나타나는지 확인했다.
성능에 변화가 없다. 아무리 오래 학습해도 OOD 일반화 능력이 생기지 않는다.
- 작업 난이도가 어렵기 때문 → grokking이 생긴다 해도 시간이 너무 걸려 비효율적
3.2 Breaking Down Success and Failures of Transformers
3.2.1 Information Gain Explains Where Transformers Partially Excel
모델은 전체 계산을 안 해도, 일부 규칙만으로 답의 일부를 맞출 수 있다
→ 전체 추론을 하지 않아도 일부 답을 찍을 수 있는 구조 때문
Relative Information Gain 사용
곱셈 결과의 앞자리 - 입력의 앞자리와 강한 연관
곱셈 결과의 마지막자리 - 입력의 마지막자리만 고려대상
- 복잡한 단계별 계산 없이 패턴을 이용해 일부를 맞춤
“규칙 이해가 아닌 패턴 매칭이다”
3.2.2 Transformers Reduce Multi-Step Compositional Reasoning into Linearized Subgraph Matching
모델의 올바른 예측이 알고리즘 이해 때문인가, train에서 본 비슷한 패턴 때문인가?
문제를 풀기 위해 필요한 계산이 train data에 얼마나 있었는지 측정
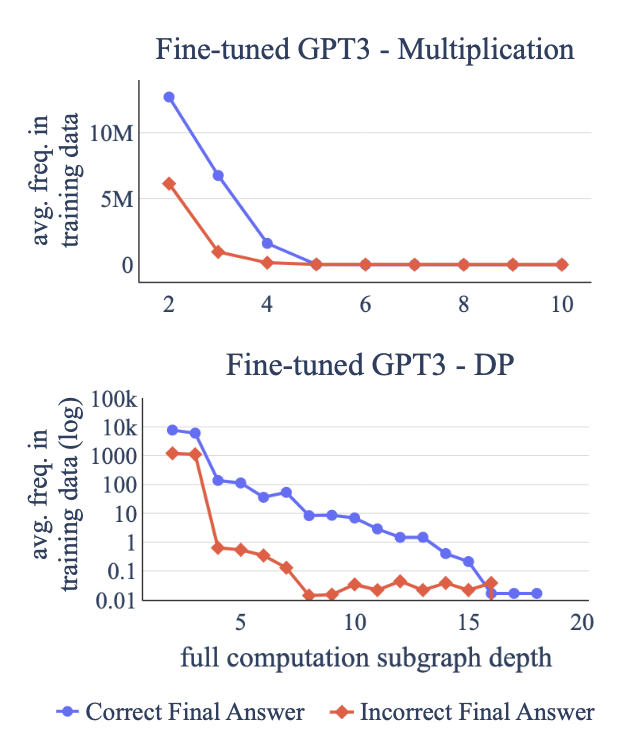
테스트 문제를 풀기 위해 필요한 계산 과정(subgraph)이 학습 데이터에 얼마나 자주 등장했는지의 평균 빈도
- 맞은 경우, training data에서 계산이 자주 보였음을 확인
모델이 잘 맞추는 이유는 패턴 매칭이며, 쉬운 문제는 잘하지만 복잡한 문제에서는 무너진다
3.2.3 What Types of Errors do Transformers Make at Different Reasoning Depths?
Transformer가 어디서 틀리는지 분석
- 답이 맞는지
- 계산과정이 맞는지
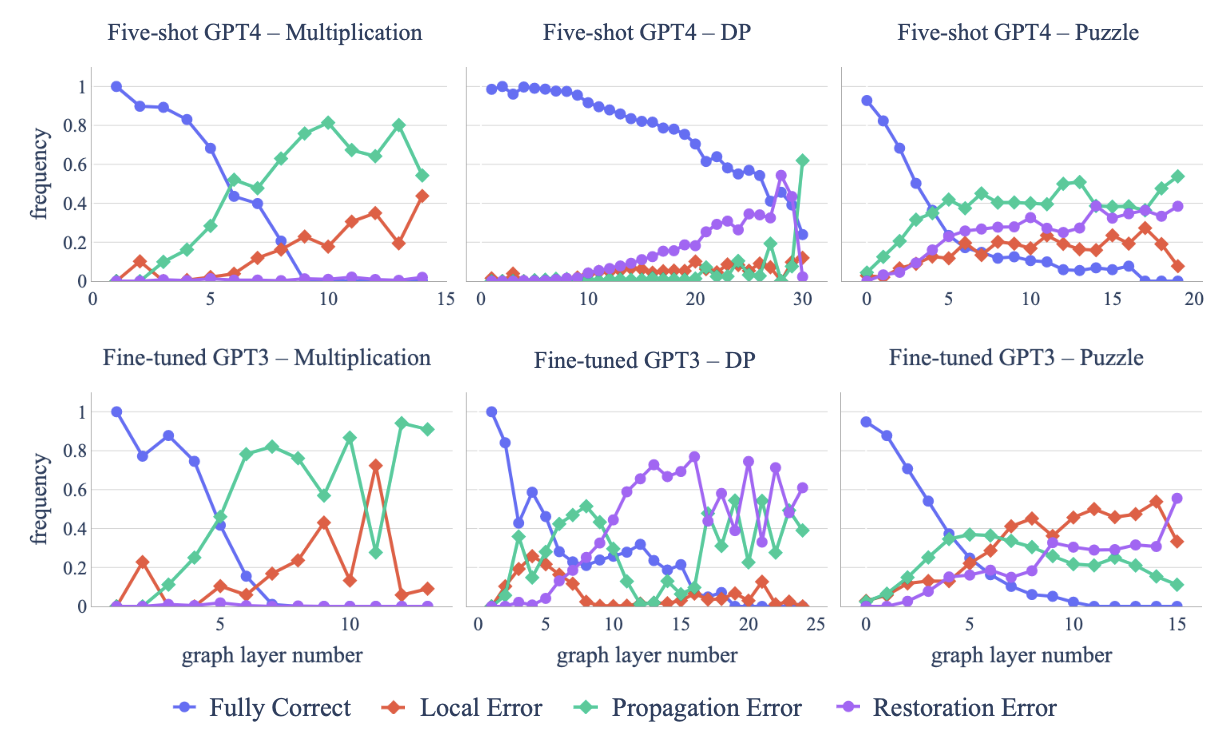
- 각 노드를 4가지 카테고리로 분류
- Fully Correct: 값과 계산과정 모두 맞음
- Local Error: 입력은 맞으나 계산이 틀림
- Propagation Error: 이전 단계가 틀려 오류가 전달
- Restoration Error: 계산은 틀리나 결과는 맞음
Layer가 증가할수록 Fully correct 감소 (복잡해지기 때문)
Propagation error > Local error (한번 틀리면 계속 틀림)
Restoration error 많음 (패턴 매칭이기 때문)
4. Error Propagations: The Theoretical Limits
왜 복잡도가 증가할수록 성능이 감소하는가?
Proposition 4.1 (병렬 계산)
n개의 독립 계산을 수행한다 가정
각 단계 오류 확률
각 계산이 독립이고, 하나라도 틀리면 실패라면
전체가 맞을 확률은 이므로 n이 커질수록 지수적으로 감소
Proposition 4.2 (순차 구조)
한번 틀리면 계속 틀림
recovery 확률: 실수 후 다시 맞출 확률 - 매우 낮음
n이 커질수록 틀릴 확률이 1로 수렴
5. Discussion
Collapsed Compositionality and Robustness Implications
다단계 조합 계산을 추론으로 풀지 않고 패턴 매칭으로 줄여서 처리
복잡한 문제에서는 일반화에 실패
Theoretical Findings and their Empirical Implications
각 단계에서 발생하는 작은 오류가 누적되면서,
문제의 길이가 증가할수록 전체 정답 확률은 지수적으로 감소한다.
원인은 next-token 기반 구조
그래서 LLM은 짧은 추론·근사 문제·외부 모듈과의 결합으로 써야 한다
Call for Broad Participation to Investigate Limitations
Transformer의 구조적 한계를 제시하지만, 더 큰 모델과 더 많은 데이터 환경에서의 검증은 제한적이므로,
향후 연구를 통해 이러한 한계가 어디까지 극복 가능한지 추가적인 분석이 필요하다.
느낀점
현 시대의 거의 모든 LLM이 Transformer을 기반으로 하고 있기 때문에 필수적인 실험이라고 생각한다.
3년이 지난 지금까지도 마땅한 해결방안이 나타나지 않는다는 점이 급변하는 AI 세상에서는 이례적이며 중요한 일이라고 생각한다.
SSM / RWKV / Hyena라는 모델들을 조사해 보았을 때, attention 메커니즘을 대체한 모델들이지만 비슷한 문제를 해결했다는 내용은 없었다.
또한, 요즘 모델들은 Transformer + 외부 모듈 방식으로 작동하기 때문에, 이런 경우 성능이 얼마나 개선될 지 실험해볼 가치가 있다고 생각한다.
