Intro
기존 RAG는 외부 문서를 검색한 뒤, 검색된 일부 문서를 LLM의 Context Window에 넣어 답변을 생성한다.
이 방식은 소수의 문서만으로 답할 수 있는 질문(Local Question) 에는 매우 효과적이다.
예를 들어,
- “A 회사의 CEO는 누구인가?”
- “이 문서에서 OAuth를 어떻게 설명하는가?”
같은 질문은 관련 문서 몇 개만 찾아도 충분히 답할 수 있다.
하지만 다음과 같은 질문은 다르다.
- 이 회사의 전체적인 전략 변화는 무엇인가?
- 인터뷰 전체에서 반복적으로 등장하는 주제는 무엇인가?
- 여러 사건 사이에는 어떤 관계가 있는가?
이처럼 전체 데이터셋을 이해해야 하는 질문(Global Question) 에서는 Vector RAG가 한계를 가진다.
논문에서는 이를 Sensemaking 능력 부족이라고 말한다.
사람, 장소, 사건 사이의 연결 관계를 파악하고,
여러 단서를 종합하여 현재 상황을 이해하고,
앞으로의 방향을 예측하며 의사결정을 지원하는 과정
즉 단순 검색이 아니라 전체적인 의미를 이해하는 능력이다.
이를 해결하기 위해 제안된 방법이 GraphRAG이다.
GraphRAG는 문서에서 Knowledge Graph를 생성하고,
- Entity 추출
- Relationship 생성
- Community 분할
- Community Summary 생성
과정을 거쳐 전체 문서를 계층적으로 이해하도록 만든다.
또한 논문에서는 이러한 능력을 평가하기 위해 LLM-as-a-Judge 기반 평가도 함께 제안하였다.
Background
2.1 RAG Approaches and Systems
RAG는 사용자 질문에 대해 외부 데이터를 검색하고, 검색 결과를 이용하여 답변을 생성하는 모든 시스템을 의미한다.
대표적인 방식인 Vector RAG는 질문과 가장 비슷한 문서를 Embedding 기반으로 검색한다.
하지만 Global Question에서는 문제가 발생한다.
왜냐하면 질문의 답이 여러 문서에 흩어져 있기 때문이다.
2.2 Using Knowledge Graphs with LLMs
Knowledge Graph 자체는 새로운 개념이 아니다.
기존에도
- Rule-based
- Pattern Matching
- Embedding
등을 이용하여 그래프를 구축하였다.
하지만 GraphRAG는 LLM을 활용하여 그래프를 구축한다는 점이 다르다.
또한 그래프를 단순 검색 인덱스로 사용하는 것이 아니라,
Community 구조를 생성하는 것에 집중한다.
전체 과정은 다음과 같다.
Knowledge Graph 생성
↓
Community 분할
↓
Community Summary 생성
↓
재귀적으로 상위 Summary 생성
↓
Global Summary
2.3 Adaptive benchmarking for RAG Evaluation
GraphRAG를 어떻게 평가할 것인가도 중요한 문제였다.
기존 벤치마크는 대부분 Vector RAG 성능 평가를 위해 만들어져 있었다.
논문에서는 Adaptive Benchmarking을 제안한다.
단순히 문서에서 질문을 생성하면 너무 쉬운 문제가 되기 때문에,
LLM을 이용하여 질문을 만든다.
- Persona 생성
- 사용 목적(Task) 생성
- 실제 물어볼 질문 생성
2.4 RAG evaluation criteria
VectorRAG의 평가 방식은 다음과 같다
- Fluency: 문장의 자연스러움
- Context Relevance: 문맥의 적절성
- Faithfulness: 근거 충실성
- Answer Relevance: 질문과 답변의 관련성
GraphRAG는 Global Question을 해결하는 것이 목적이므로 새로운 평가 기준을 사용한다
- Comprehensiveness
- 얼마나 많은 측면을 다루는가
- Diversity
- 다양한 관점과 통찰을 제공하는가
- Empowerment
- 사용자의 이해와 의사결정을 얼마나 돕는가
- Directness
- 질문에 얼마나 직접적으로 답하는가
이상적인 정답 (Gold Standard)이 존재하지 않음
- LLM-as-a-Judge 방식 사용
Methods
3.1 GraphRAG Workflow
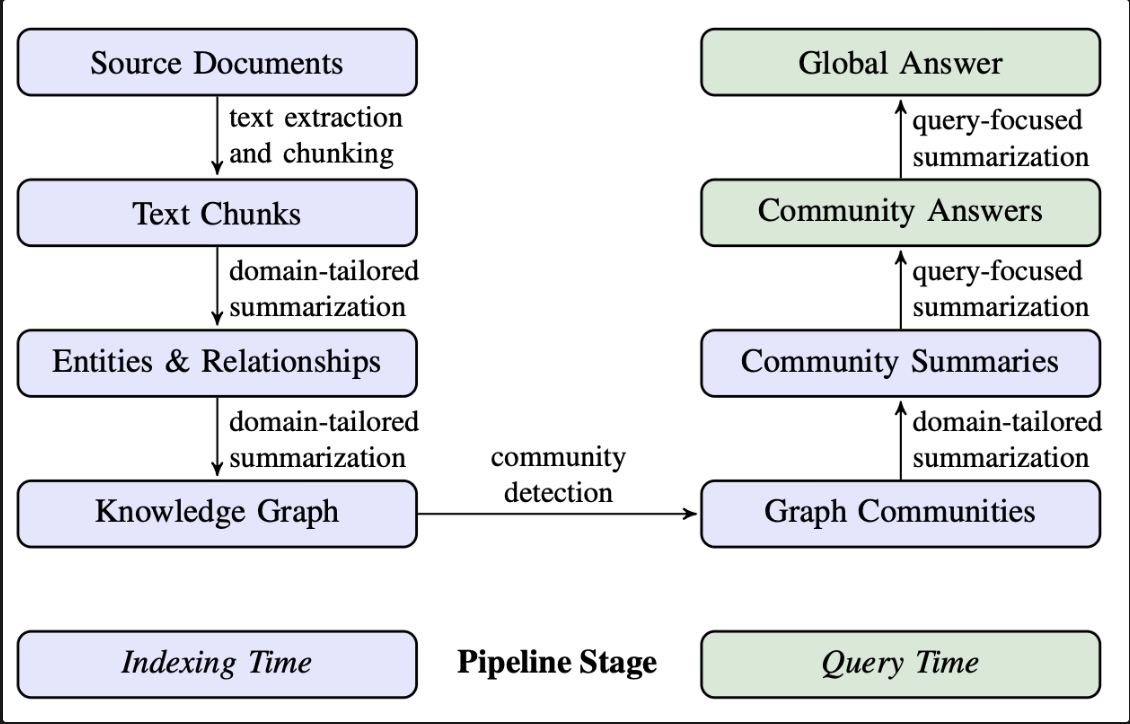
GraphRAG 전체 과정
3.1.1 Source Documents → Text Chunks
먼저 문서를 일정 크기의 Text Chunk로 분할한다.
Chunk 크기는 매우 중요하다.
너무 크면
- LLM 호출 횟수 감소
- 비용 감소
하지만 다음과 같은 단점이 있다
- Chunk 앞부분 정보 회수율 감소
3.2 Text Chunks → Entities & Relationships
LLM은 각 Chunk에서
- Entity
중요한 객체를 추출한다.
예)
- 사람
- 장소
- 기업
- 기술
- Relationship
Entity 사이 관계를 추출한다.
예)
Apple ─ develops → Vision Pro
- Claim
검증 가능한 사실을 추출한다.
예)
Apple announced Vision Pro in 2023.
도메인에 맞는 예시를 Prompt에 제공하면 해당 분야에 특화된 그래프도 생성 가능하다.
3.3 Entities & Relationships → Knowledge Graph
Entity 추출은 여러 번 수행된다.
이후 Graph를 하나로 합친다.
-
Entity Description Aggregation
- 그래프 생성 단게 마지막에 중복된 Entity 합침
- 하나의 노드로 생성 및 설명 합치기
-
Relationship Aggregation
- 자주 등장할수록 Edge Weight 증가
-
Claim Aggregation
- 동일한 Claim 합치기
- Exact String Matching 사용
Leiden Community Detection 단계에서 같은 Community로 묶일 가능성이 높다고 설명한다.
3.4 Knowledge Graph → Graph Communities
Graph를 주제별 Community로 분할한다.
사용하는 알고리즘은 Leiden Algorithm이다.
- Leiden 알고리즘이 그래프를 강하게 연결된 노드로 분할
- 비슷하게 연결된 노드로 그룹 생성
- 커뮤니티 안 커뮤니티 안 커뮤니티. 더이상 쪼갤 수 없을 때까지 (계층 분할)
3.5 Graph Communities →Community Summaries
GraphRAG의 핵심 단계이다.
Leaf Community
가장 작은 Community부터 Summary를 만든다.
Priority는 다음과 같다
- 출발 노드(Source Node) 설명
- 도착 노드(Target Node) 설명
- 관계(Edge) 설명
- 관련 Claim
연결된 두 노드의 degree가 큰 순서대로 (영향력이 큰 순서대로)
LLM의 Context window가 허용하는 만큼 정보를 추가한다
Higher-level Community
모든 정보가 Context Window에 Leaf Node와 같은 방식으로 요약한다
Context Window를 초과한다면, Node/Edge/Claim 정보 대신 하위 community 요약 데이터로 대체한다 (전체가 context window에 들어올 때까지)
3.6 Community Answers → Global Answer
질문이 들어온다면
Prepare Community Summaries:
Community Summmary들을 모아서 섞은 뒤 Chunk로 나눈다.
- 정보 편향을 방지하기 위함이다
Map Community Answers:
각 Chunk를 독립적으로 LLM에게 보내 중간 답변(intermidiate answer)을 생성
- 동시에 답변이 질문에 얼마나 도움이 되었는가 평가
Reduce to Global Answer:
중간 답변들을 도움 점수(Helpfulness Score) 순으로 정렬
Score가 0인 답변은 제거한다.
높은 순서대로 Context Window에 넣고, 그 기반으로 최종 답변 생성.
3.2 Global Sensemaking Question Generation
논문에서는 Global Sensemaking Question도 직접 생성하였다
생성 과정은 다음과 같다.
Corpus 설명 기반 페르소나 생성(사용자 K명)
Task N개생성 (무슨 목적으로 사용하는가)
Question M개 생성: (K,N) 조합별 질문 수
최종 질문 수 : KNM
전체 문서를 이해해야 답할 수 있는 질문이어야 함 (Global Understanding)
3.3 Criteria for Evaluating Global Sensemaking
GraphRAG 평가 방식은 LLM as a judge이며,
GraphRAG 평가 기준은 다음과 같다.
Comprehensiveness: 얼마나 많은 측면을 다루는가
Diversity: 여러 관점과 통찰을 제공하는가
Empowerment: 읽는 사람이 더 잘 이해하고 판단할 수 있게 돕는가
Directness: 질문에 명확하고 직접적으로 답했는가
Directness는 Comprehensiveness, Diversity와 반대되는 경향을 보였다.
LLM의 랜덤성을 방지하기 위해 여러번 평가후 평균을 반영
4. Analysis
4.1 Experiment 1
Dataset
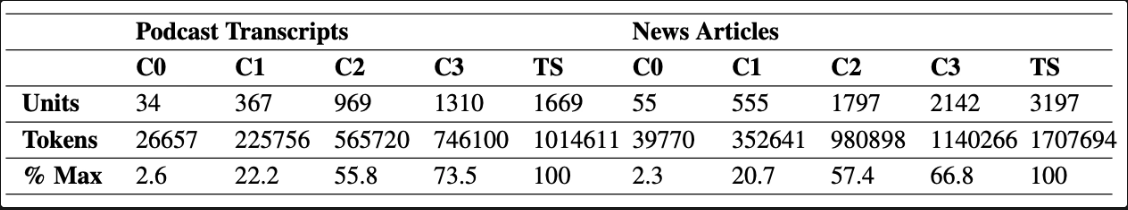
podcast 대본 - 과학,기술,산업 관련 인터뷰 (600토큰의 청크 1669개, 중복 100토큰, 전체 100만토큰)
뉴스 기사 - 경제,스포츠,기술,건강과학,예능 (600토큰 청크 3197개, 중복 100개, 전체 170만 토큰)
Conditions
C0: 최상위 Community Summary - 가장 적은 수, 가장 Global
C1: C0의 아래 단계
C2: 중간 단계. 더 세부적
C3: 가장 작은 Community. 가장 local - 좁은 범위, 더 detail
TS(Text Summarization) : Graph 없이 원문 청크를 요약
SS(Semantic Search): vector RAG
context 생성 방식(VectorRAG vs GraphRAG) 외 조건 동일 (8k Context Window, 동일 LLM, 동일 Prompt)
4.2 Experiment 2
Claim 기반 평가 - 검증 가능한 사실 평가
Clamify LLM사용
Experiment1의 모든 답변에 적용
Comprehensiveness 측정 ( 더 포괄적 = 더 많은 사실 포함): 답변당 평균 claim 수
Diversity 측정(Claim을 Clustering): Cluster수 많을수록 다양한 주제를 다룸 - 평균 Cluster 수
Claim끼리 유사도 계산: 1−ROUGE-L (유사 Claim끼리 묶기)
5. Results
5.1 Experiment 1
Global approaches vs vector RAG
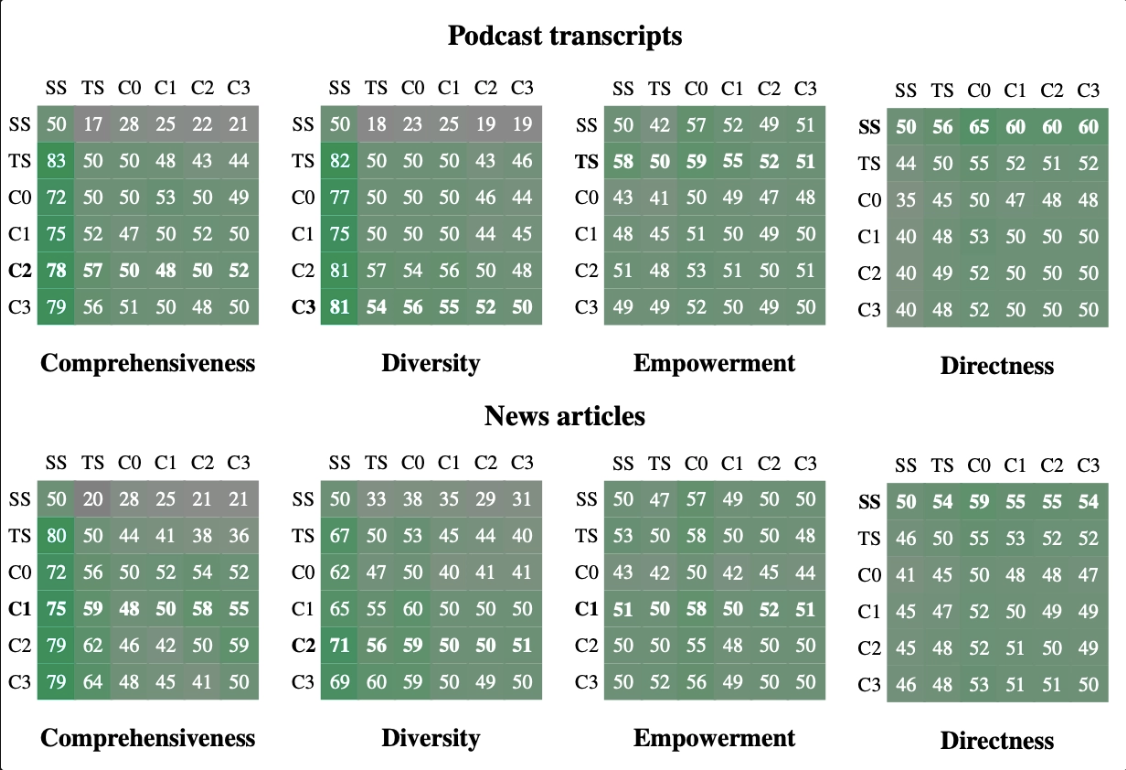
Comprehensiveness:
GraphRAG가
- Podcast: 72-82% 승률
- News: 72-80% 승률
Diversity:
GraphRAG가
- Podcast: 75-82% 승률
- News: 62-71% 승률
즉, Global Sensemaking 문제에서는 Global search 접근 (C+TS)가 Vector RAG보다 훨씬 유리하다.
Directness:
Vector RAG가 가장 높았다.
질문과 관련있는 짧고 직접적이며 명확한 답변을 생성하기 때문이다 (전체적인 요약 X)
Empowerment:
일관된 결과는 나오지 않았다.
GPT-4는
- 구체적 예시
- 직접적 인용
- 정확한 출처
를 중요하게 평가하는데,
GraphRAG는 Summary에서 세부 내용,인용문,예시가 일부 소실될 수 있기 때문이라 분석하였다.
Community summaries vs. source texts: GraphRAG vs TS 비교
작지만 일관된 결과가 나타났다.
Community Summary가 원문보다 Comprehensiveness, Diversity 조금 더 높게 나타났다.
이유는
- 노이즈 감소
- 핵심 정보 압축
때문이라 설명한다.
토큰 효율성
C3: 26-33% 토큰 절약
C0: 97%이상 절약
- 그럼에도 VectorRAG보다 좋음
C0 vs VectorRAG
C0이
- Comprehensiveness: 72% 승률
- Diversity: 62% 승률
중요 발견:
GraphRAG 안에서는 C0,C1,C2,C3 사이에 큰 성능 차이가 없었다.
즉,
97% 이상의 토큰을 절약하는 C0만 사용해도
더 세부적인 Community와 거의 비슷한 성능을 얻을 수 있었다.
이는 GraphRAG의 가장 인상적인 결과 중 하나였다.
Claim 기반 평가
Claim 개수와 Cluster 수를 이용한 평가에서도
Experiment 1과 거의 동일한 결과가 나타났다.
또한
LLM-as-a-Judge 평가와 실제 Claim 기반 평가는
- Comprehensiveness : 약 78%
- Diversity : 약 70%
수준으로 일치하였다.
즉 LLM-as-a-Judge가 어느 정도 신뢰할 수 있는 평가 방식임을 확인하였다.
6. Discussion
6.1 Limitations of Evaluation Approach
100만 토큰 규모의 2개 데이터셋만 사용하였다
- 다른 도메인에서도 잘 동작하는지
- 다른 사용 사례에서도 효과적인지
확인이 필요하다
또한, Hallucination, Fabrication 평가가 충분히 이뤄지지 않았다.
6.2 Future Work
- Local + Global Hybrid RAG (Vector + Graph)
- Roll-up (하위 → 상위)
- Drill-down (상위 → 하위)
7. 느낀점
가장 인상 깊었던 결과는 Global Question에서는 C0와 C3의 성능 차이가 거의 없었다는 점이다. C0는 최상위 Community Summary만 사용하기 때문에 C3보다 97% 이상의 토큰을 절약할 수 있는데도 비슷한 성능을 보였다. 처음에는 “그렇다면 당연히 C0만 사용하는 것이 가장 효율적인 선택 아닌가?“라는 생각이 들었다.
하지만 논문에서 수행한 실험은 어디까지나 Global Question을 대상으로 한 결과였다. 전체 문서의 흐름이나 주제를 이해하는 질문에서는 C0만으로도 충분할 수 있지만, 특정 사건이나 세부 정보를 묻는 Local Question에서는 더 세밀한 Community인 C3가 유리할 가능성이 있다. 따라서 Global Question뿐 아니라 Local Question까지 포함하여 각 Community Level의 성능을 비교하는 추가 실험도 이루어진다면 GraphRAG를 실제 서비스에 적용할 때 더 명확한 기준을 제시할 수 있을 것이라고 생각했다.
또 하나 흥미로웠던 점은 연구 전반에서 LLM의 활용 범위가 매우 넓어지고 있다는 것이다. 과거에는 데이터를 생성하는 데 LLM을 활용하는 연구가 많았다면, 이번 논문에서는 사용자 페르소나와 질문 생성뿐 아니라 최종 성능 평가까지 LLM이 담당한다. 특히 정답(Gold Standard)이 없는 Global Sensemaking 문제에서는 LLM-as-a-Judge가 현실적인 대안이라는 점은 이해되었지만, 한편으로는 데이터 생성, 문제 생성, 평가까지 모두 LLM에 의존하는 흐름이 이어지는 것이 다소 우려되기도 했다. 물론 사람의 비용과 시간을 크게 줄일 수 있다는 장점은 분명하지만, 앞으로는 LLM의 판단을 얼마나 신뢰할 수 있는지, 그리고 사람의 평가와 어떻게 균형을 맞출 것인지에 대한 연구도 함께 이루어질 필요가 있다고 생각한다.
