자연어 처리 분야에서 LLM은 좋은 성능을 보여주지만, 여전히 “사실 기반 응답” 이라는 점에서 한계가 있다.
특히 특정 도메인 지식이나 최신 정보가 필요한 질문에 대해 정확한 답변을 제공하는 것은 어렵다.
이를 보완하기 위한 기술은 바로 RAG이다.
LLM이 아닌 RAG한테 질문해보자
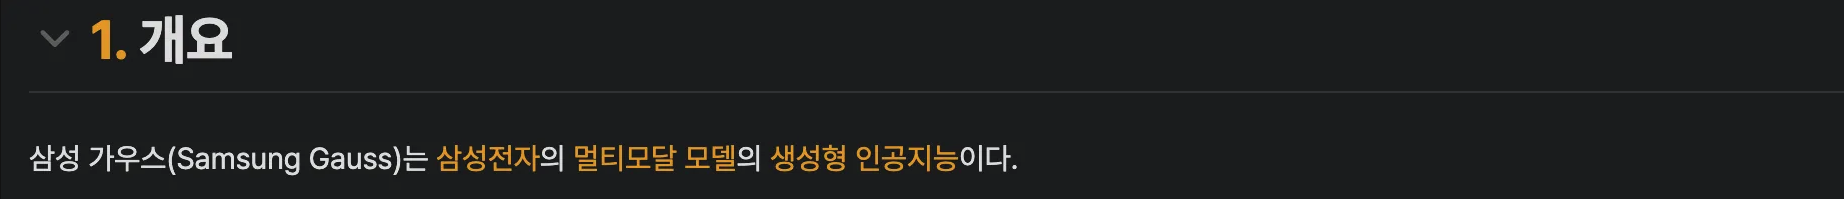
Q. 삼성전자가 자체 개발한 생성형 AI가 뭐야?
- LLM은 대답한다. 삼성 뉴런이라고
- RAG는 대답한다. 삼성 가우스라고
차이는 어디서 발생했을까?
LLM은 학습된 지식만 사용
RAG는 문서를 검색한 후, 그 내용을 기반으로 답변
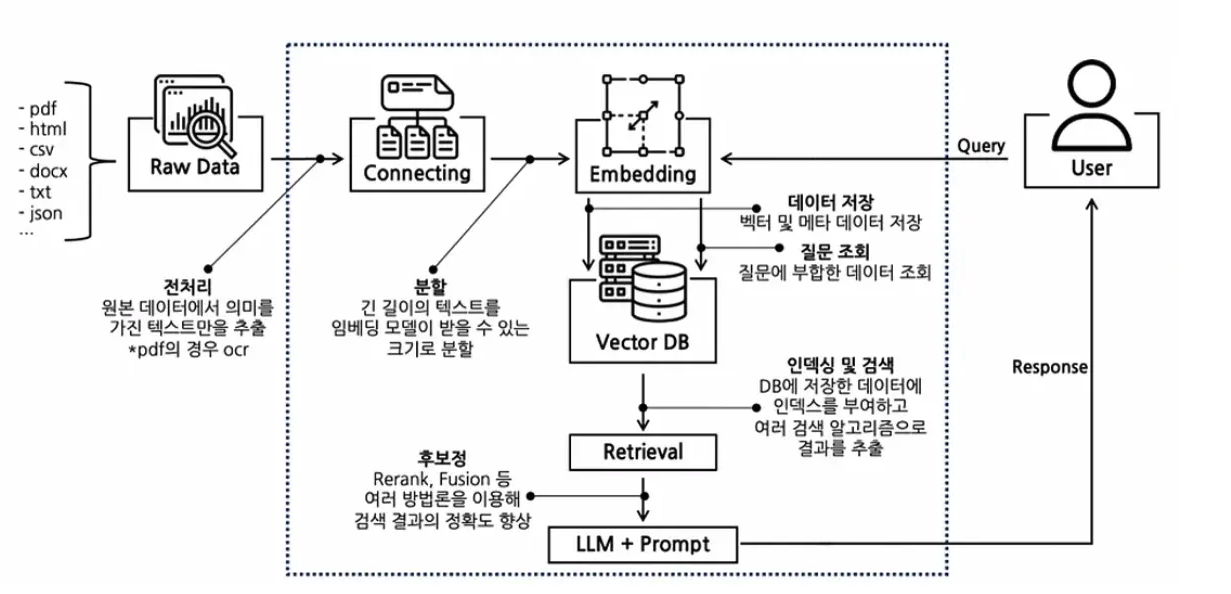
이 과정을 이해하기 위해 4단계 프로세스를 살펴보겠다.
RAG의 4단계 프로세스
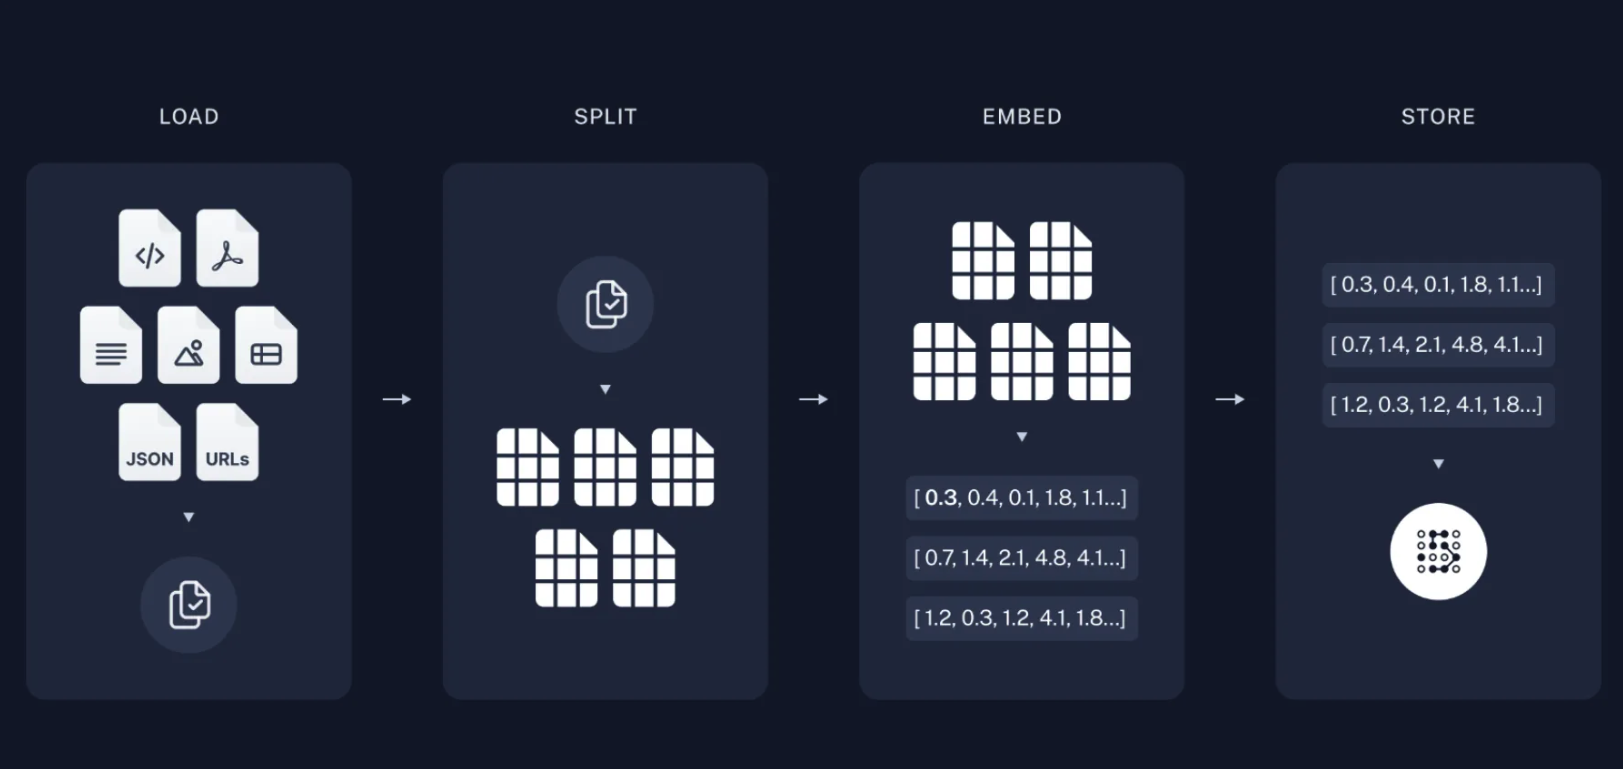
1. Document Load – 문서 로딩
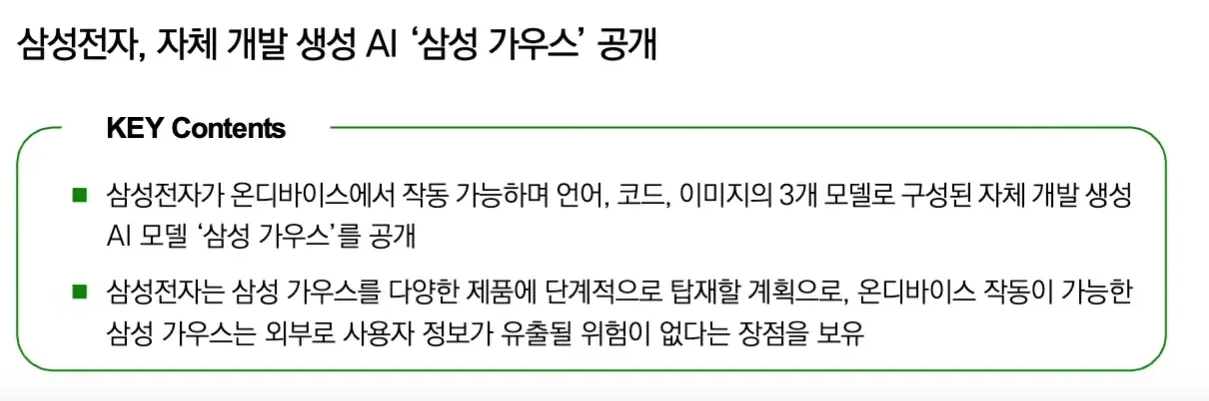
우선, 시스템은 질문과 관련이 있을 법한 문서를 불러온다.
이 문서는 웹 문서, PDF, Word, 텍스트 파일 등 다양한 형태일 수 있으며,
삼성전자의 생성형 AI 가우스에 대한 공식 보도자료나 내부 문서가 될 수 있다.
2. Text Split – 문서 분할
불러온 문서는 그대로 사용하는 것이 아니라, 작은 단위로 분할한다.
이를 청크라고 부르며, 일반적으로는 토큰 기준으로 자른다.
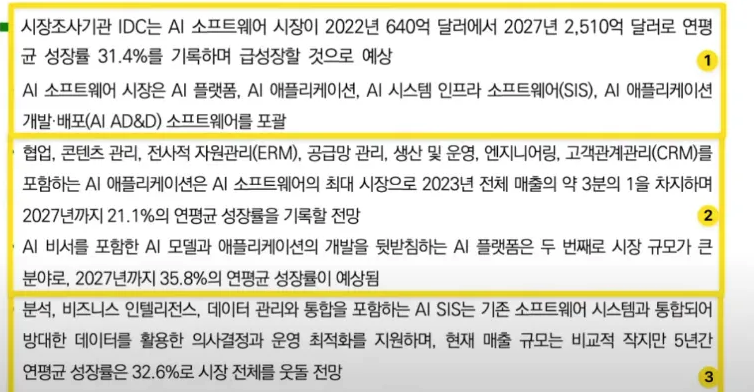
예: 3페이지 문서 → 페이지당 3문단 → 총 9개의 청크 생성
[임베딩된 단락 활용 예시]
왜 나누는가?
질문과 관련된 일부만 쓰기 위해 / 청크가 작을수록 정확한 정보 추출이 가능
또한 단락을 나눌 때, 청크 오버랩 기법을 사용해 문맥이 잘리는 문제를 최소화한다.
청크 오버랩이란?
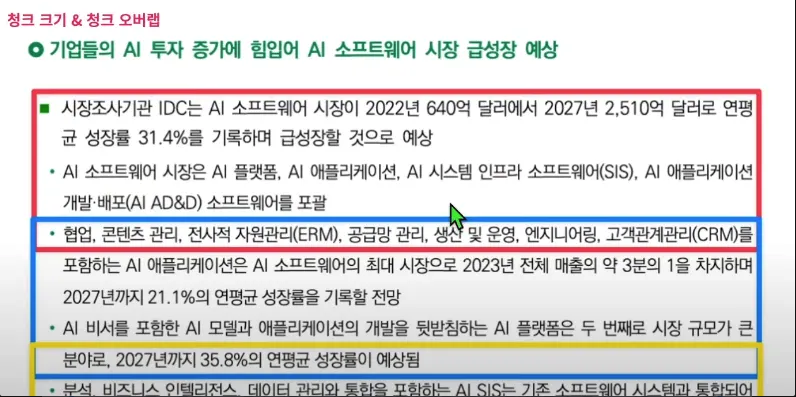
청크를 자를 때 일정 구간을 겹치게 자른다
- 청크 크기: 100 토큰
- 1번 청크: 1~100
- 2번 청크: 51~150 (50토큰 겹침)
이렇게 하면 각 청크가 서로 일부 내용을 공유하게 되어, 문단의 경계에서 문맥이 끊기는 현상을 방지한다.
3. Embedding – 수치 벡터화
문자 형태의 질문과 문단은 수학적으로 비교할 수 없다. 그래서 각 문단을 벡터 형태로 변환한다.
이게 임베딩이다.
이 단계에서 문장의 의미가 고차원 벡터로 표현된다.
예시:
- 질문 Q: [0.1, 0.2, 0.8, ..., 0.2]
- 문단 A: [0.1, 0.3, 0.9, ..., 0.2]
- 문단 B: [0.7, 0.1, 0.3, ..., 0.6]
→ Q와 A의 벡터가 가장 유사 → A를 context로 사용
어떤 알고리즘을 쓰냐에 따라, 숫자 갯수가 달라진다.
일반적으로 숫자가 많을 수록 정교하지만 리소스를 많이 사용하게 된다.
벡터 간 유사도 계산 방식
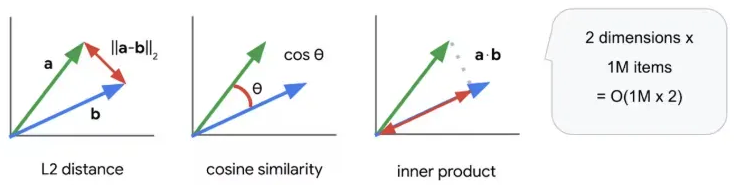
- 코사인 유사도
- 유클리드 거리
- 내적
일반적으로 코사인 유사도를 많이 쓴다고 한다.
4. Vector DB – 벡터 저장 및 검색
생성한 벡터들은 벡터 DB에 저장
대표적인 벡터 DB: FAISS, Pinecone, Weaviate
질문도 벡터로 변환 → 벡터 DB에서 가장 유사한 청크 검색
→ 이렇게 찾은 문맥이 Prompt에 삽입되어, 최종적으로 LLM이 문장을 생성하게 된다.
결론
LLM은 질문에 답한다.
RAG는 질문 전에 관련 정보를 찾는다.
단순히 답변하는 게 아니라, 정보를 검색 → 참조 → 생성하는 구조
참고자료