들어가며
내 개인기록어플을 개발하며, LLM이 이미지 기반 표정과 분위기를 분석하여 그 날의 감정을 추론해주는 기능을 구현하였다.
초기에는 로컬로 비용없이 사용하기 위해 로컬 LLM인 Ollama를 선택했고, 이미지분석 역시 ollama vision model을 사용하고자 했다. 하지만 이 과정에서 문제가 발생했고, 이에 모델 선택 시 고려해야할 것에 대해 공부도 해보고 해결방안도 찾았다. 이 과정을 정리해보고자한다.
문제상황
내가 처음 의도했던 기능은
- 사용자가 이미지 여러장 업로드
- 여러 장의 이미지를 base64로 인코딩
- Ollama 비전 모델 (llama3.2-vision)로 이미지 분석
이었다.
즉, 멀티 이미지를 비전 모델에 전달하고 한꺼번에 이 이미지들에서 보이는 감정과 분위기를 분석하는 기능을 의도했었다.
그런데 처음 llama3.2-vision을 이용하여 이미지 분석을 돌렸을 때, 다음과 같은 서버에러가 발생하였다.
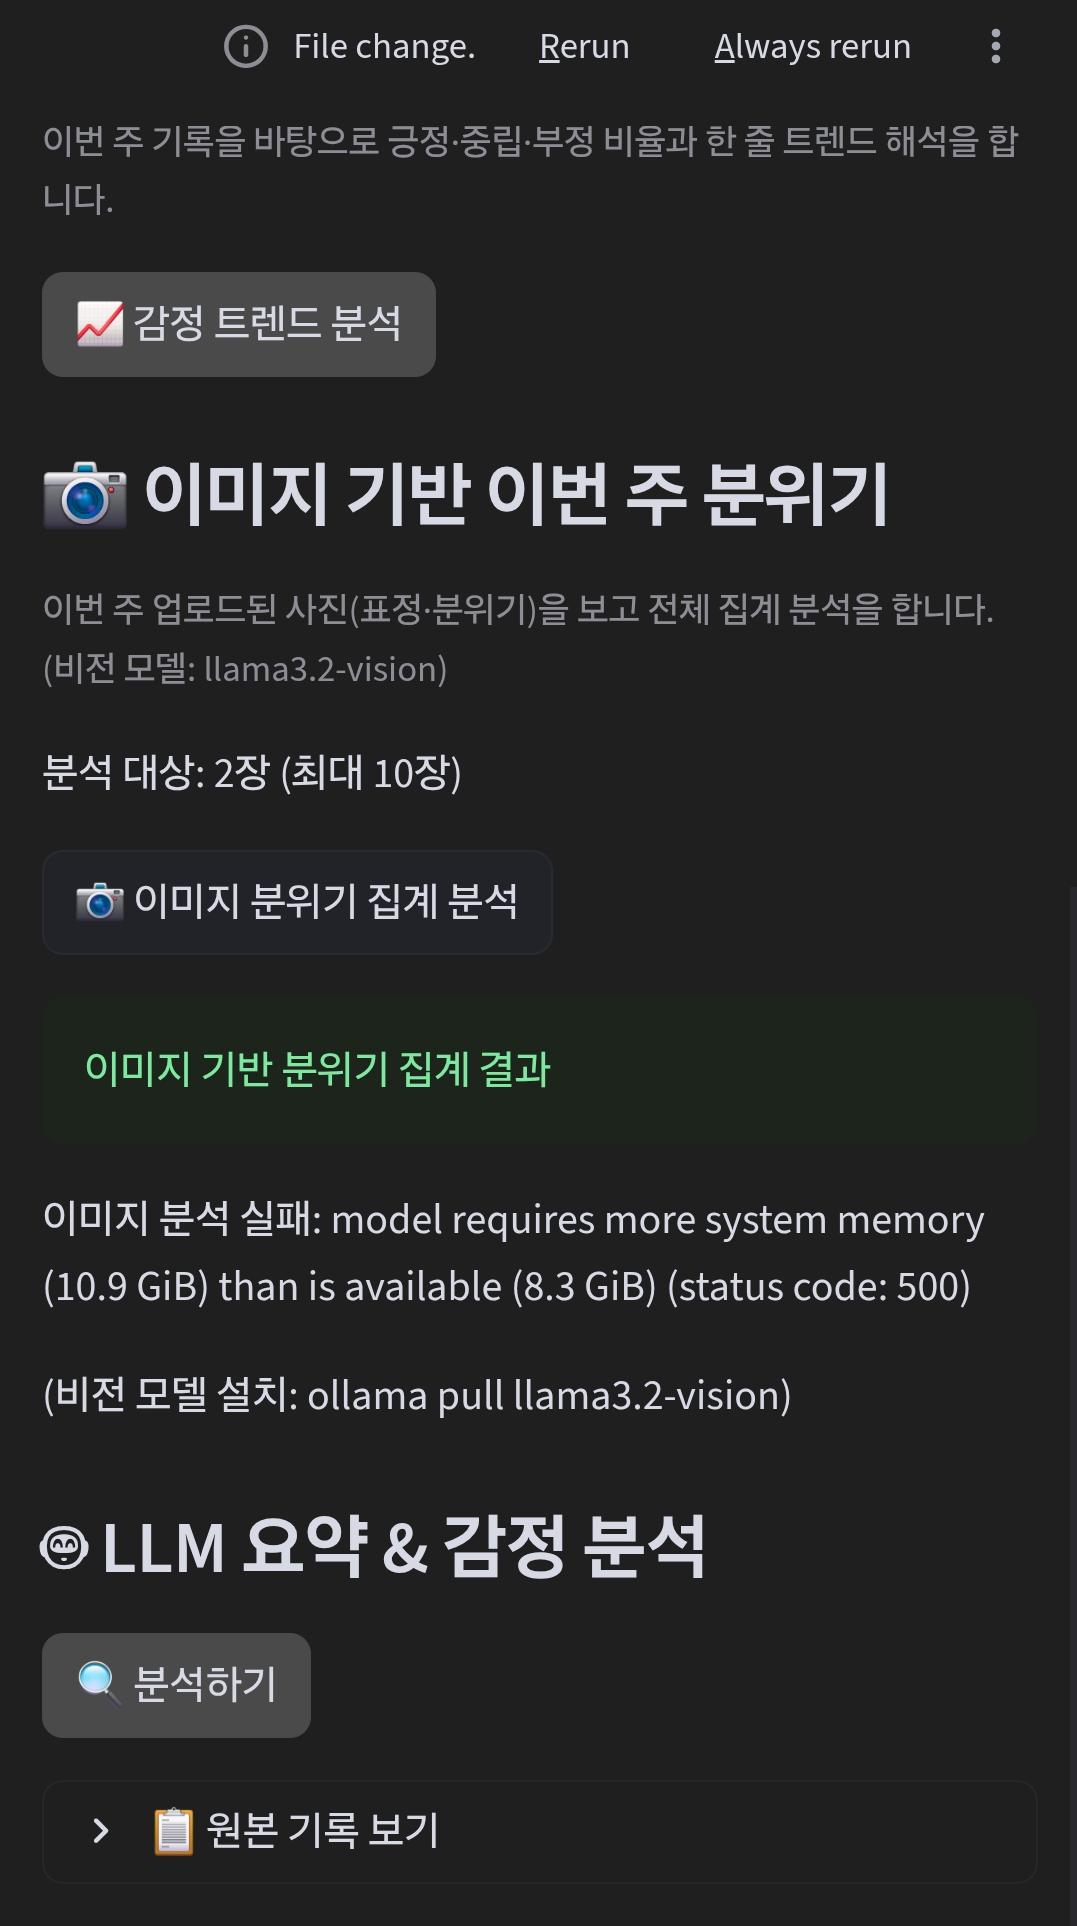
model requires more system memory (10.9 GiB) than is available (8.3 GiB) (status coded:500)해당 에러는 코드 문제라기보다는 메모리 부족으로 인해 모델 실행 자체가 불가능하다는 것을 의미했다.
내 노트북 메모리가 부족한가...? 로컬로 돌리는데도 노트북 성능이 좋아야하나 ? 여러가지 생각이 들며
단순히 로컬 LLM이라고 다되는건 아니고 잘 알아보고 써야하는구나 깨달았고,
원인을 제대로 분석하고 내 노트북 성능 및 내 프로젝트에 필요한 적정한 수준의 LLM을 고르는 게 낫겠다 싶었다.
원인 분석
llama3.2-vision 모델이 내 로컬에서 에러가 난 이유는 다음과 같았다.
💥1. 해당 비전 모델의 높은 메모리 요구량
일반적으로 "이미지 분석 모델"은 텍스트 모델보다 훨씬 많은 메모리를 필요로 한다.
그 이유는 비전 모델은 멀티 모달로
분석을 위해서, 이미지 인코딩, 시각 정보 처리, 텍스트 생성의 세 과정이 동시에 수행되어야 하기 때문이다.
💥2. 여러 장의 이미지 동시 처리 구조
내가 의도한 기능의 경우, 여러장을 동시에 LLM에 전달해서 총평을 말해줘! 였기에, 모델이 한번에 처리해야 할 입력 데이터가 많았다.
💥3. base64 인코딩 방식
LLM을 돌리는데에도 메모리가 필요하지만,
이미지를 base64 문자열로 변환하면서 데이터 크기가 증가하고, 이미 이 과정에서 메모리를 많이 잡아먹었다.
이러한 복합적인 문제가 합쳐지면서 로컬에서 CPU만으로 LLM을 돌리기에는 메모리가 부족했다 ...
해결방법
1. 경량 모델로 변경 (llama3.2-vision -> llava)
먼저 나는 llama3.2-vision이 아닌 더 가벼운 모델인 llava로 변경했다.
해당 모델도 Ollama 비전 모델로 무료였고,
모델구조와 요구 메모리, 실행방식 등이 달랐고 현재 환경 (내 노트북 16GB RAM) 에서 실행 가능한 수준의 자원만 요구했기 때문이다.
2. 이미지 개수 제한
경량 모델로 변경할뿐만 아니라, 이미지 개수도 무제한에서 3~4장으로 줄임으로써, 모델에 주는 부담(?)을 줄였다.
즉, 모델의 성능을 높이기 위해 입력 구조 자체도 변경해야할 필요성을 느꼈다.
이렇게 구조와 모델을 변경한 후
다시 실행해봤을 때,
이미지 분석에 시간이 많이 들긴했지만....! 에러 발생없이 분석을 마무리할 수는 있었다.
❗또 다른 문제
다만, 이렇게 Ollama를 사용하면서 느꼈던 건
첫번째는,
💥 품질이 굉장히 좋지않다...?
한글로 답해달라했는데 여러 외국어가 섞여있거나 한자가 나오거나, 아예 분석을 못하는 경우도 많았다.
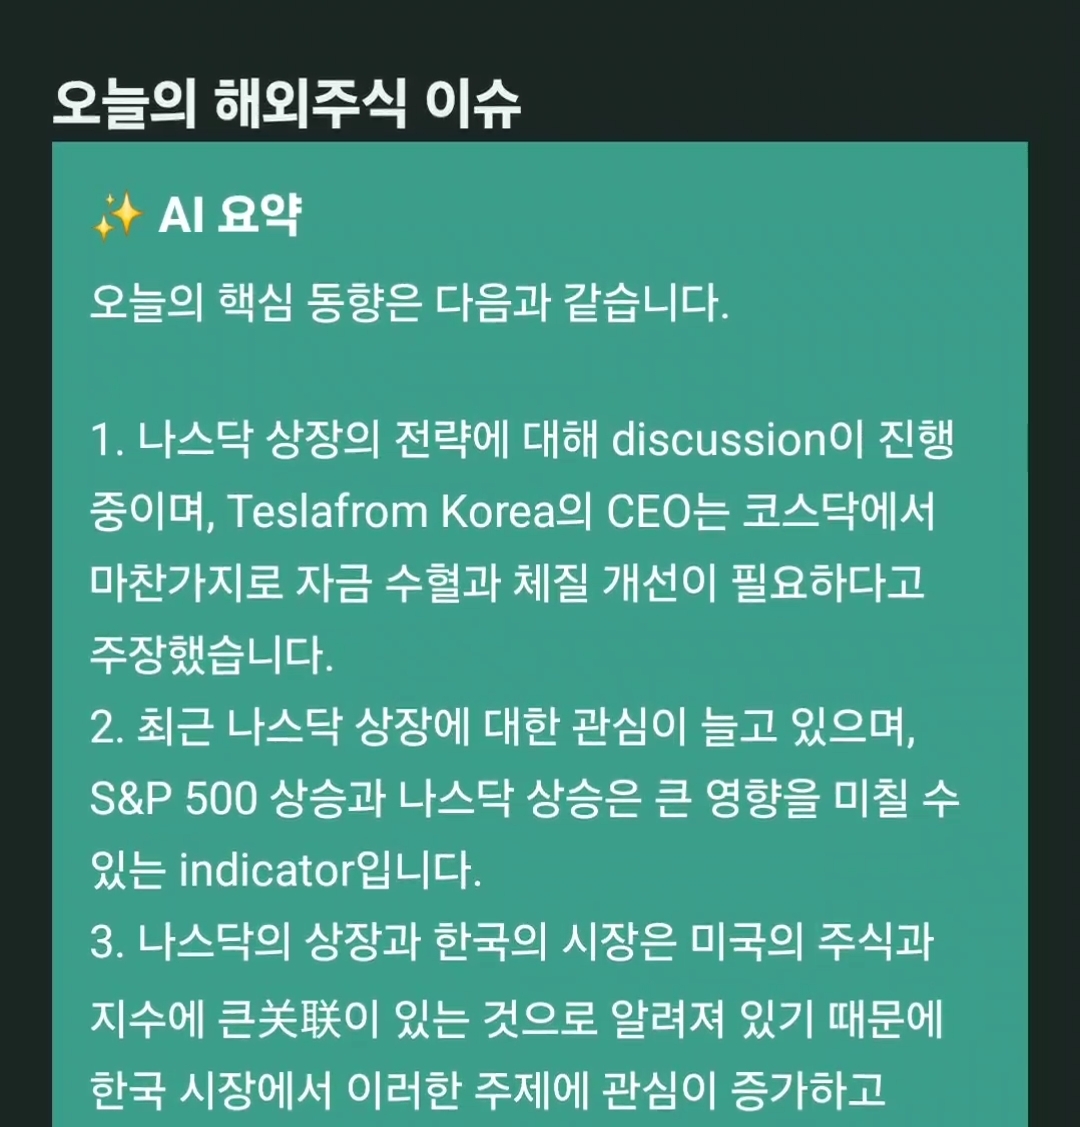
위 사진이 llama를 사용했을 때의 텍스트 분석 및 요약이다. 한자에 영어에 가끔은 독일어인지 프랑스어인지 섞여있는 것도 있었다.
두번째는,
💥 이미지 분석에 시간이 5분 넘게 소요되는 문제가 있었다...!
그만큼 싼 게 비지떡이라구.......
실제 서버에서는 이걸 사용하는 순간 불만 폭발이겠구나 싶었다
세번째는,
💥 이렇게 로컬에서 메모리를 순식간에 잡아먹는데, 이걸 서버에 그대로 올린다면,,,, 서버에서 직접 이미지 분석을 수행하는 것이니 서버비용이 순식간에 어마어마하게 증가하지않을까..? 생각이 들었다.
⚠️ 참고로 ollama 로컬 LLM을 고대로 서버에 올렸을 때의 문제점
1) 메모리 사용량 증가 - 비전 모델은 높은 RAM을 요구, 요청 증가할수록 부담이 커짐
2) CPU 사용량 증가 - GPU 없이 운영할 경우, 모든 추론을 CPU가 담당하여 부하가 커짐 (모델 가중치를 전부 RAM에 올리고 중간 계산도 전부 메모리에서 처리해야하기에)
3) GPU 서버 필요 가능성 - 성능과 안정성을 확보하려면 GPU서버를 고려해야하고 이는 비용 상승과 직결한다
결론적으로
나는 상용화할건 아니었지만 (그럴 어플도아녔지만)
실제로 서버에 배포하고, 가족이나 친구한테 테스트겸 써보라고 해보고싶었기에, 좀 빠르고 잘 분석해주는 좋은 LLM을 사용해보고 싶었다.
해결 방법
배포서버에서는 질 좋고 빠른 LLM 모델을 사용하여 분석의 질을 높이기 위해 외부 API를 사용하고자 했다.
OpenAI와 Gemini, HuggingFace의 API 이 셋 중에 고민을 했는데
내가 선택할 때 고려한 것은 다음과 같다.
- 비용 구조
- 이미지 처리를 지원하는가?
- 구현의 난이도는?
- 응답 속도와 안정성은 괜찮은가?
- 개인 프로젝트에 적절한가?
이를 고려했을 때,
OpenAI의 경우)
실제 써본 경험도 있고,, 굉장히 질도 좋고 속도도 좋다는 것을 안다. 문서도 많다.
하지만 비용이 제일 문제다. 개인프로젝트인데, 과금을 할 정도로 나는 돈이없다. 그러므로 탈락
HuggingFace의 경우)
모델이 다양하다. 무료 모델이 일부 이용 가능하다. 오픈 소스이다.
하지만 모델마다 성능 편차가 크고, 설정이 복잡하고 각 모델마다 안정성과 속도가 차이가 크기에 이 안에서도 여러개 비교분석해야햇는데, 너무 번거로웠다! (물론 나중엔 비교분석 해볼 마음이 있다..)
Gemini의 경우)
멀티모달 (이미지+텍스트) 이 가능하다. 무료 토큰이 조금 있다. API구조가 간단하다. 속도도 안정적이다.
반면 디버깅 정보가 OpenAI보다 복잡하고, 찾기 어려운 경우가 있을 수 있다.
결국 나는
비용 부담이 낮고, 구현 난이도도 낮으며, 비교적 인지도가 있는..! Gemini API를 선택하였다.
변경 방법
model을 변경하는 건 어렵지않았다 !
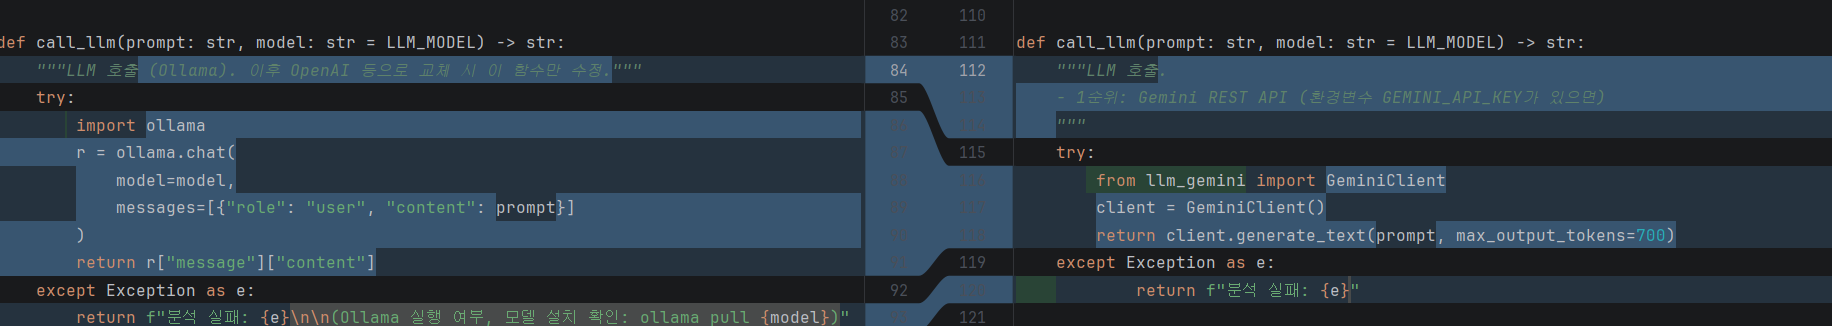
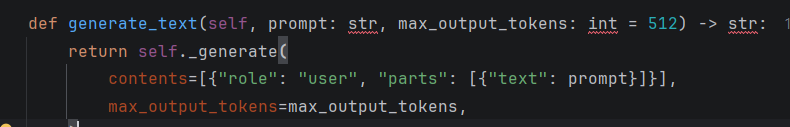
단순히 LLM 호출하던 부분에서 ollama를 Gemini로 변경하면 되었다.
변경한 코드는 대략 다음과 같다.
효과
이렇게 로컬 LLM 에서 외부 API로 변경함으로써 얻은 효과 및 장점은 다음과 같다 !
1. 서버 리소스 절약
- 모델의 실행을 직접하지 않으므로 리소스가 절약된다.
- 메모리와 CPU 부담이 감소된다
2. 확장성 확보 가능
- 트래픽 증가에 대응이 가능하다 !
- 로컬에서는 여러 요청이 LLM에게 가면 CPU 부담, 메모리 부족, 요청 대기열이 생기므로 서버 과부하 가능성이 높지만, 외부API의 경우 모델 처리 부담 및 스케일링 책임이 모두 외부 서비스에게 가기에 확장성에 좋다 !
3. 구현이 단순화된다
- 모델 관리가 따로 필요없으므로 단순해진다 !
- 모델을 직접 운영한다면 모델 다운로드와 버전 관리, 업데이트, 메모리 튜닝 등 모두 직접해야하지만 외부 API를 사용하면 API 키 관리와 요청 보내기가 끝이다 !
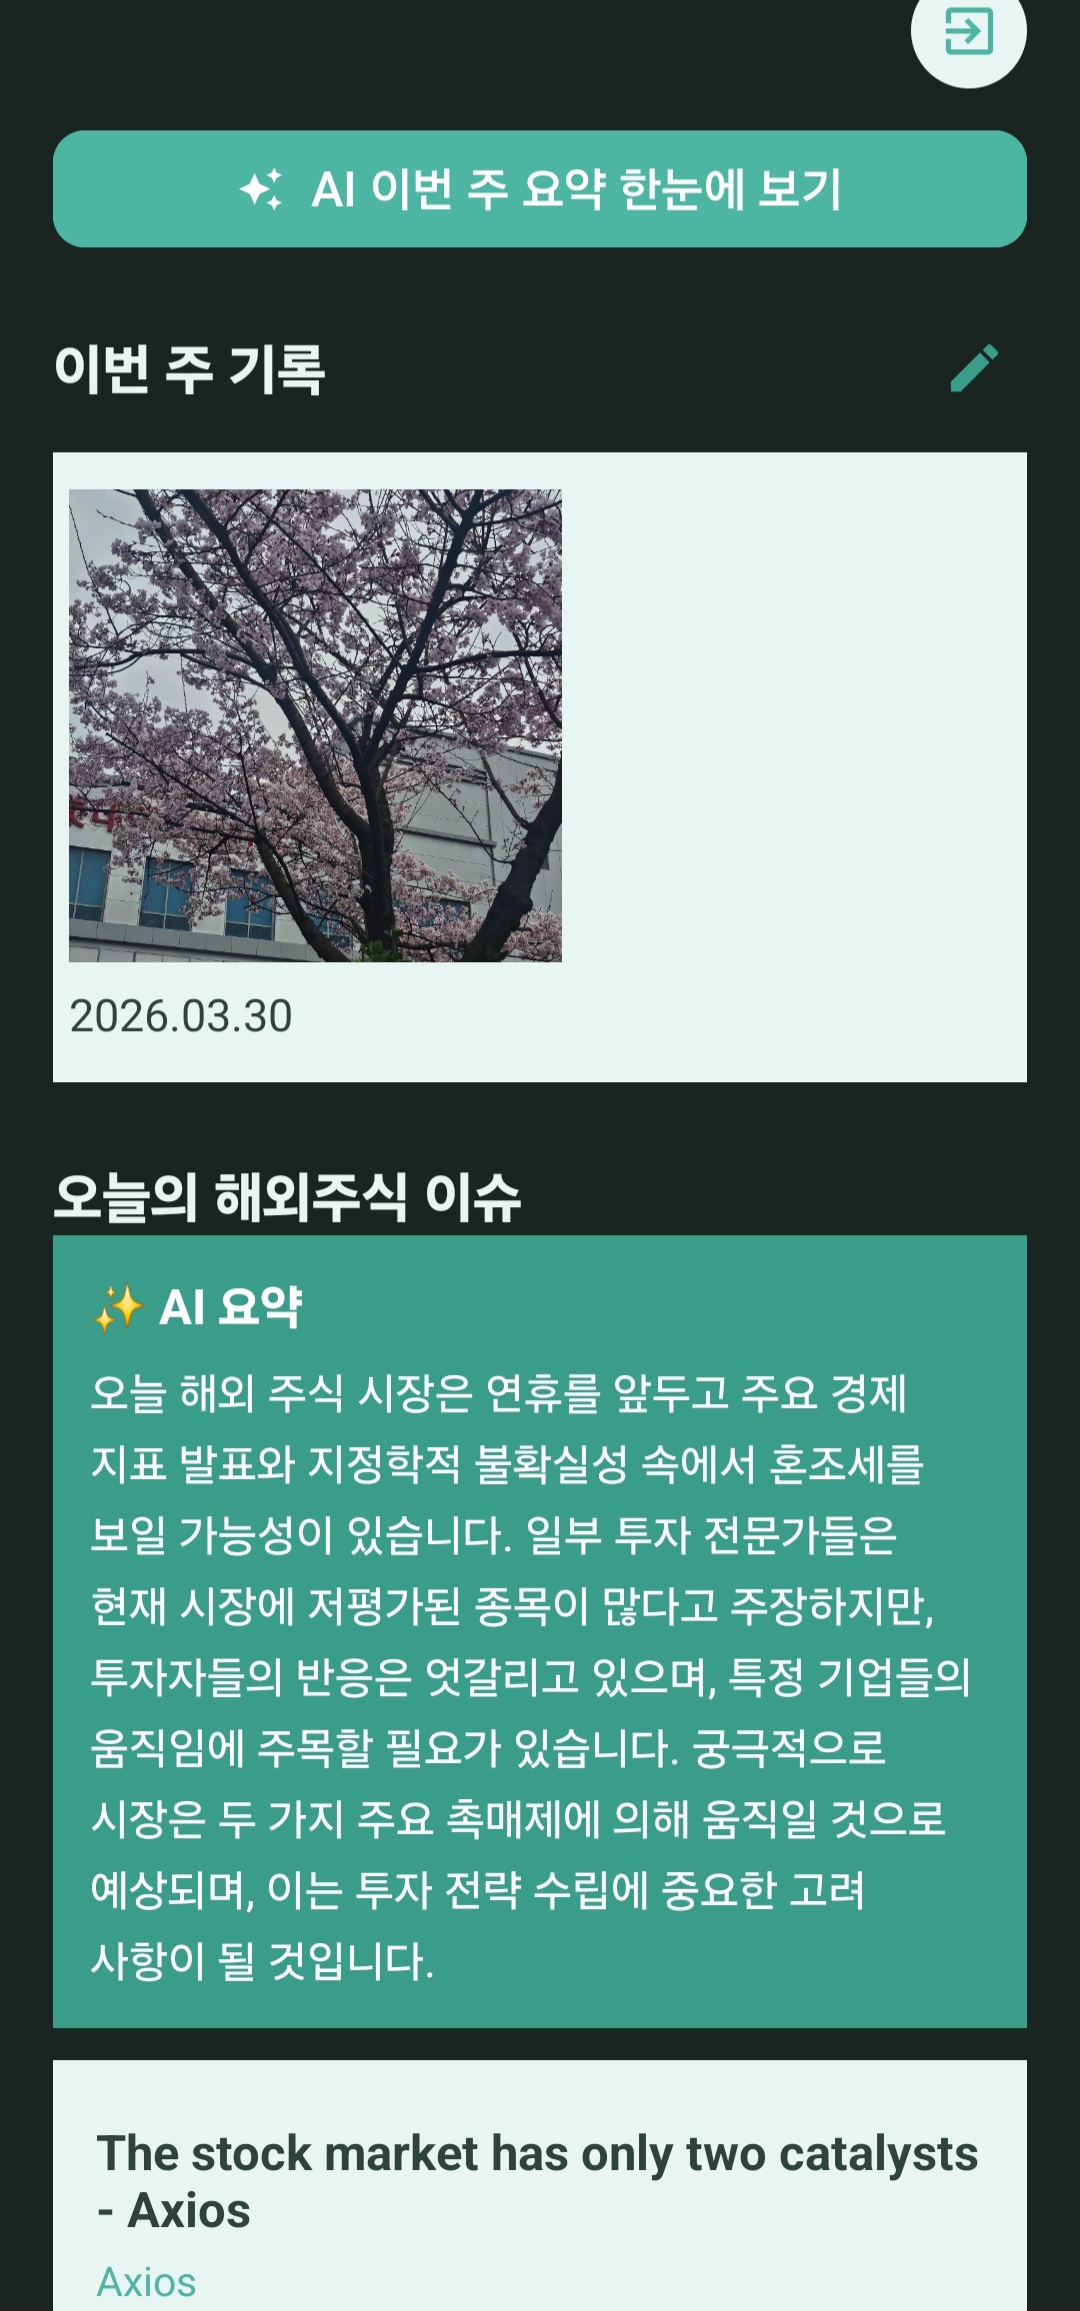
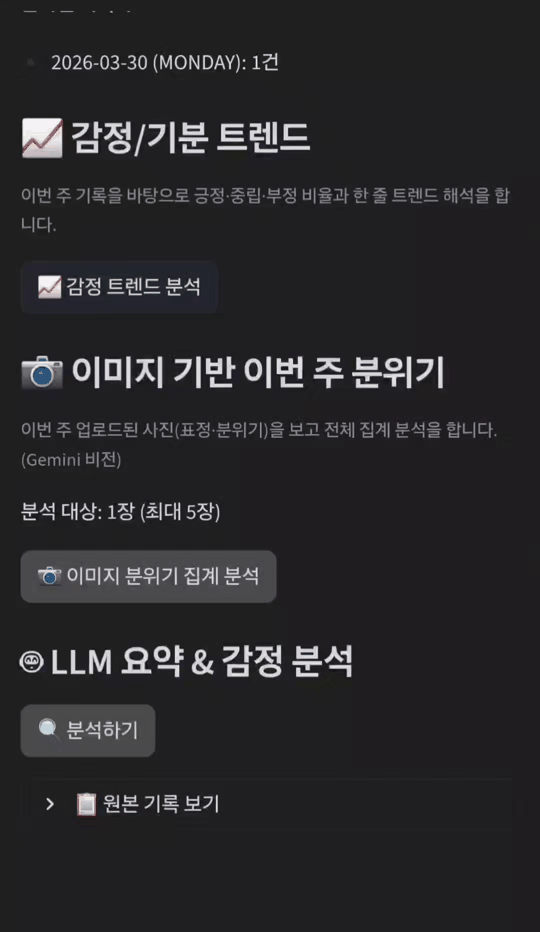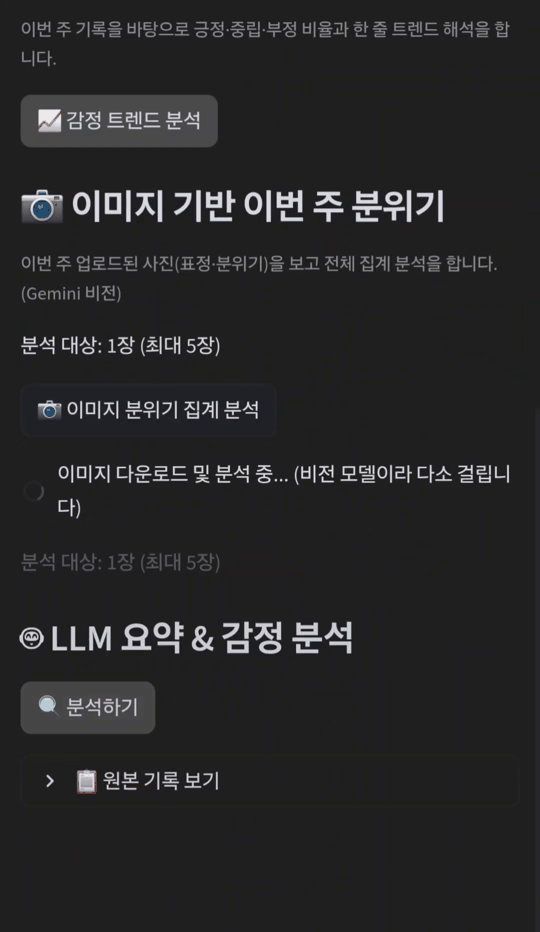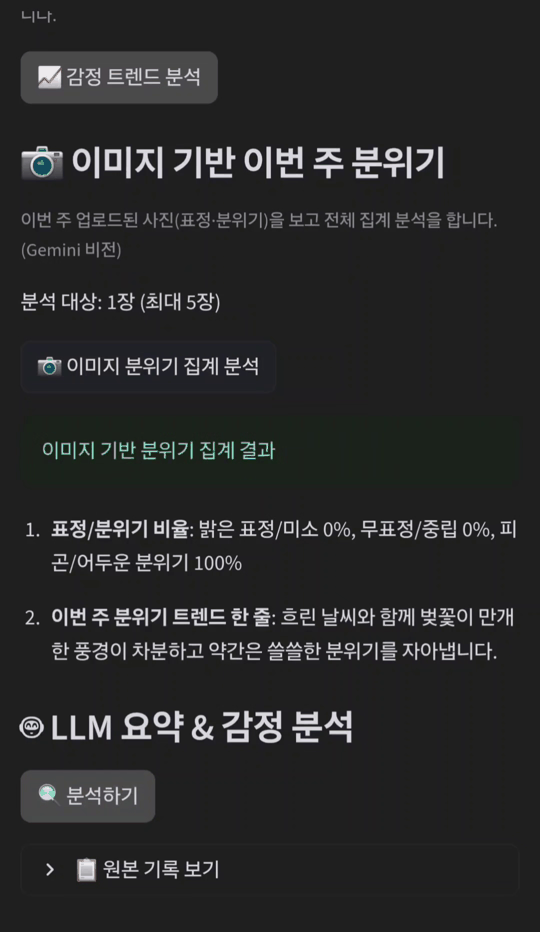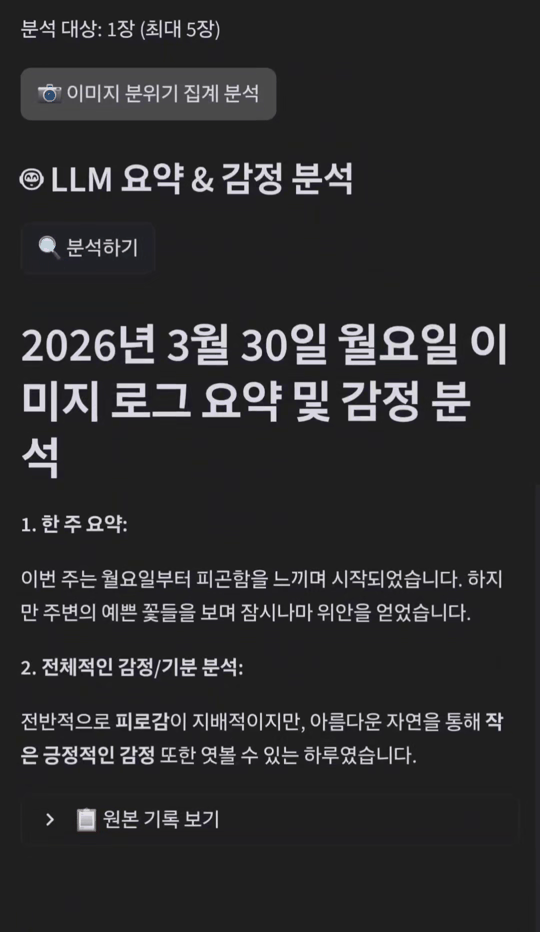
Gemini를 쓰고나서의 분석/요약이다. 아까 llama를 사용했을 때와는 분석 품질이 너무나 다르다... 깔끔!
결론
처음 이 프로젝트를 시작할 때에는,
"아 돈내기 싫으니까 무조건 로컬 LLM 해야지! 서버 배포에도 이거 써야지!"
이 생각을 했었는데,
실제로 만들어보고 테스트해보고, 배포까지 할 상황이 되어보니
LLM을 고르는 것도 단순한게 아니구나 느꼈다.
운영 환경, 사용 가능한 비용, 속도, 분석의 질 등등,,, 여러가지를 고려해야하는구나싶었다.
실제 회사에서 사용할때는 더 머리 아프겠지~? 이 생각이 젤 많이 들었던 거 같다 ㅋㅋㅋ
아 이래서 GPU가 필요하구나~ 생각도 들었고,,,
재밌긴 재미있어서
앞으로 더 연습해보며 LLM에 대해 더 자세히 공부해보고싶당