AI 이미지 생성의 다음 단계는 ‘생성’보다 ‘편집’에 가깝다
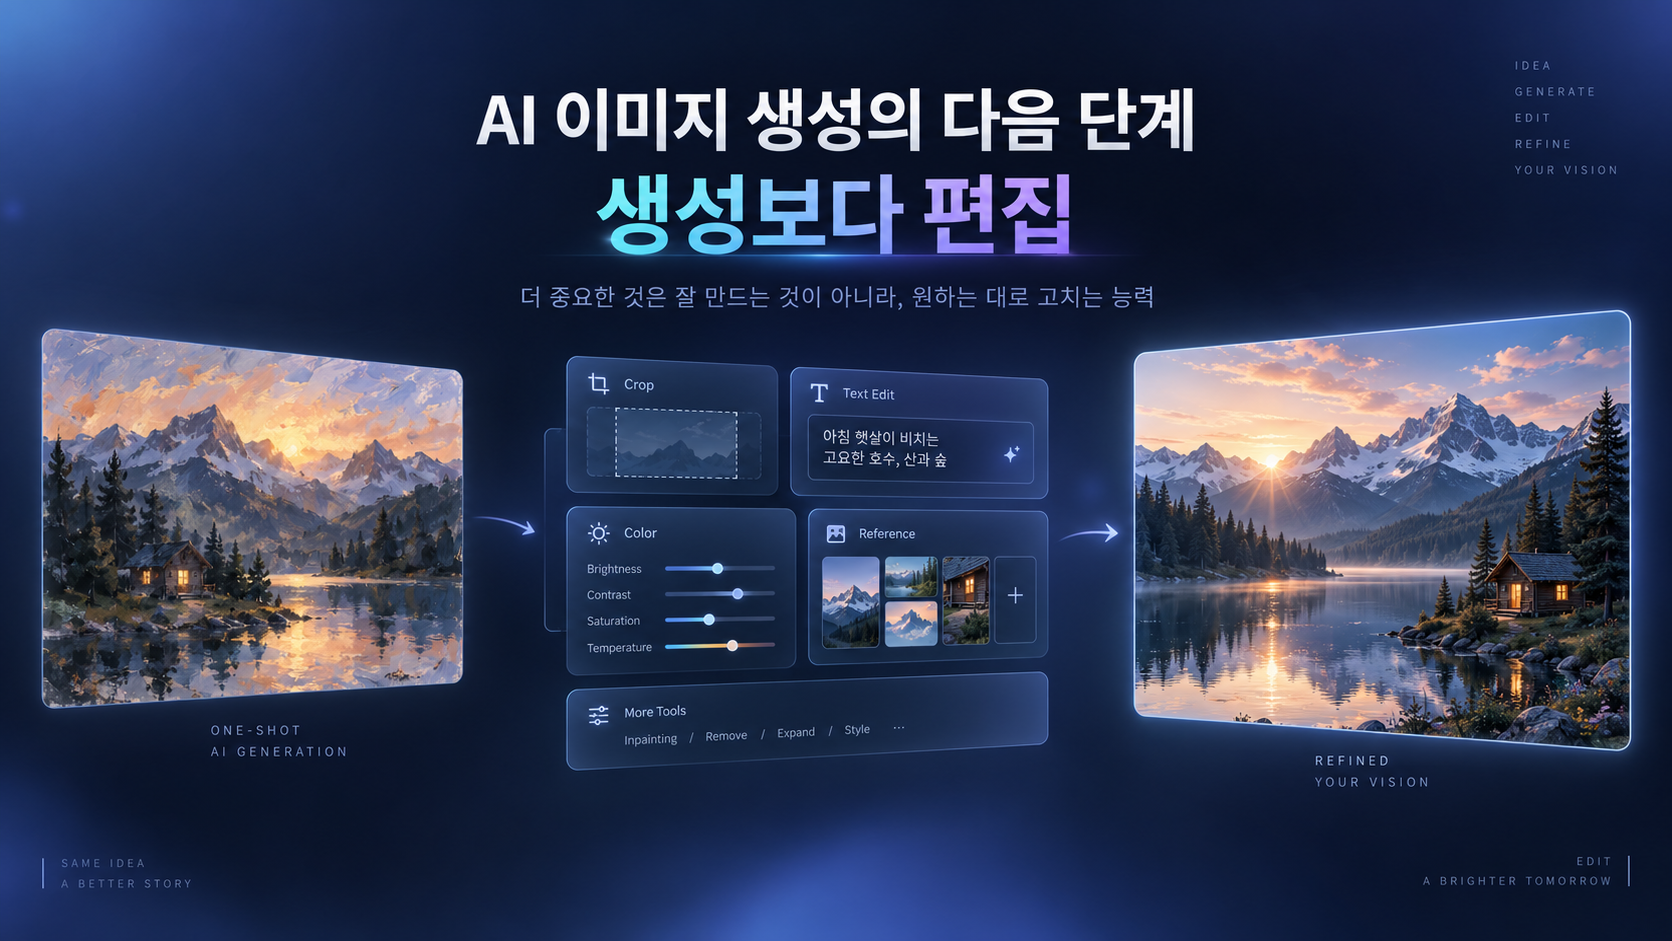
몇 년 전까지만 해도 AI 이미지 생성의 핵심은 아주 단순했습니다.
프롬프트를 입력하면 이미지를 만들어 주는 것.
좋은 결과가 나오지 않으면 프롬프트를 다시 쓰고, 또 생성하는 방식이 일반적이었습니다.
하지만 최근 이미지 모델들을 사용하다 보면 중요한 변화가 하나 보입니다.
이제 경쟁의 중심이 단순한 텍스트-투-이미지 생성 능력에서 벗어나고 있다는 점입니다.
앞으로 더 중요한 것은 다음과 같은 요청을 얼마나 자연스럽게 처리할 수 있느냐입니다.
배경만 바꿔 줘.
인물은 그대로 두고 옷 색상만 변경해 줘.
이 이미지의 구도는 유지하면서 제품만 다른 모델로 바꿔 줘.
포스터의 문구만 수정해 줘.
이런 작업들은 언뜻 보면 단순해 보이지만, 실제로는 처음부터 이미지를 새로 생성하는 것보다 더 어려운 문제일 수 있습니다.
단순 생성에서 반복 편집으로
기존 AI 이미지 생성 흐름은 보통 아래와 비슷했습니다.
프롬프트 작성
이미지 생성
마음에 드는 결과 선택
프롬프트 수정
다시 생성
이 과정의 가장 큰 문제는 매번 결과가 크게 달라진다는 점입니다.
마음에 드는 인물이 생성되어도 배경을 수정하려고 하면 얼굴이 바뀌고, 제품 이미지를 조금 수정하려고 하면 로고나 형태까지 달라지는 경우가 많습니다.
실제 작업에서는 이런 방식이 꽤 불편합니다.
사용자가 원하는 것은 새로운 이미지를 계속 생성하는 것이 아니라, 마음에 드는 결과를 기반으로 조금씩 수정해 나가는 것이기 때문입니다.
그래서 최근의 이미지 모델 경쟁은 점점 다음과 같은 방향으로 이동하고 있습니다.
기존 이미지 유지
특정 영역만 수정
인물과 제품의 일관성 유지
여러 장의 레퍼런스 이미지 활용
텍스트 수정
반복 편집 과정에서의 품질 유지
중요한 것은 ‘무엇을 바꿀지’보다 ‘무엇을 유지할지’
이미지 편집에서 어려운 문제는 단순히 사용자의 요청을 이해하는 것이 아닙니다.
오히려 더 어려운 것은 바꾸지 말아야 할 부분을 정확하게 유지하는 것입니다.
예를 들어 다음과 같은 요청을 생각해 볼 수 있습니다.
인물은 그대로 두고 배경만 야간 도시로 바꿔 줘.
좋은 이미지 모델이라면 배경만 수정해야 합니다.
하지만 실제로는 인물의 얼굴, 헤어스타일, 옷, 포즈까지 조금씩 바뀌는 경우가 있습니다.
기술적으로는 요청을 수행했지만, 실제 작업 흐름에서는 실패한 셈입니다.
이 때문에 최근에는 이미지 품질 자체보다 편집 안정성과 일관성이 더 중요한 평가 기준이 되고 있습니다.
이런 관점에서 차세대 이미지 모델들을 살펴보는 것이 흥미롭습니다. 예를 들어 GPT Image 2.5처럼 앞으로 등장할 이미지 모델에서 중요한 부분도 단순히 더 예쁜 이미지를 만드는 것이 아니라, 반복 편집 과정에서 얼마나 안정적으로 기존 이미지를 유지할 수 있는지가 될 가능성이 큽니다.
텍스트 생성은 여전히 좋은 테스트 항목이다
이미지 모델의 성능을 빠르게 확인하는 방법 중 하나는 이미지 안에 정확한 텍스트를 생성해 보게 하는 것입니다.
예를 들어 다음 문구가 들어간 포스터를 요청한다고 가정해 봅시다.
SUMMER SALE
50% OFF
THIS WEEKEND ONLY
이미지가 아무리 멋져도 글자가 하나만 틀리면 실제 광고에는 사용할 수 없습니다.
특히 다음과 같은 분야에서는 정확한 텍스트 표현이 중요합니다.
광고 배너
포스터
메뉴판
패키지 디자인
썸네일
SNS 이미지
프레젠테이션
UI 시안
과거에는 이미지 모델이 글자를 하나의 시각적 패턴처럼 처리하는 경우가 많았습니다.
하지만 실제 업무에서는 글자가 단순한 장식이 아니라 정확한 정보이기 때문에, 텍스트 렌더링 능력은 앞으로도 매우 중요한 경쟁 요소가 될 것입니다.
프롬프트보다 레퍼런스 이미지가 중요해질 수 있다
이미지 생성에서 또 하나 큰 변화는 레퍼런스 이미지의 중요성이 커지고 있다는 점입니다.
텍스트만으로 특정 이미지를 설명하는 것은 생각보다 어렵습니다.
예를 들어 특정 디자인의 재킷을 설명한다고 생각해 봅시다.
색상, 소재, 핏, 지퍼 위치, 포켓 형태, 질감 등을 모두 문장으로 설명해야 합니다.
하지만 사진 한 장을 첨부하면 훨씬 빠릅니다.
실제 디자이너들도 대부분 이런 방식으로 작업합니다.
무드보드
참고 이미지
스케치
제품 사진
스타일 예시
기존 디자인
AI 이미지 모델도 점점 같은 방향으로 발전하고 있습니다.
사용자가 모든 것을 언어로 설명하는 대신, 이미지 자체를 시각적 프롬프트로 사용할 수 있게 되는 것입니다.
여러 장의 레퍼런스 이미지가 만드는 새로운 작업 방식
한 단계 더 나아가면 여러 장의 레퍼런스 이미지를 동시에 사용하는 방식이 중요해질 수 있습니다.
예를 들어:
첫 번째 이미지: 인물
두 번째 이미지: 의상
세 번째 이미지: 배경
네 번째 이미지: 카메라 구도
다섯 번째 이미지: 조명 분위기
이렇게 각각 다른 역할을 가진 이미지를 제공하고, AI가 이를 하나의 결과로 조합하는 방식입니다.
이 경우 긴 프롬프트를 작성할 필요가 줄어듭니다.
대신 사용자는 단순히 다음과 같이 요청할 수 있습니다.
첫 번째 이미지의 인물에게 두 번째 이미지의 옷을 입히고, 세 번째 이미지의 장소에 배치해 줘.
이 방식이 안정적으로 동작한다면 AI 이미지 툴의 UX도 크게 달라질 수 있습니다.
하나의 큰 프롬프트 입력창 대신 여러 개의 이미지 슬롯이 존재할 수 있습니다.
예를 들어:
Character
Product
Background
Style
Composition
각 영역에 참고 이미지를 넣고 자연어로 관계만 설명하는 방식입니다.
이런 인터페이스는 전통적인 프롬프트 엔지니어링보다 훨씬 직관적입니다.
화려한 데모보다 중요한 것은 재현성
새로운 이미지 모델이 공개될 때마다 가장 먼저 등장하는 것은 멋진 데모 이미지입니다.
하지만 실제 개발자 입장에서 더 중요한 것은 조금 다릅니다.
같은 작업을 반복했을 때 얼마나 안정적인 결과를 내는가?
예를 들어 두 모델이 있다고 가정해 봅시다.
A 모델은 가끔 매우 놀라운 이미지를 생성하지만 좋은 결과를 얻으려면 여러 번 다시 생성해야 합니다.
B 모델은 결과가 약간 덜 화려하지만 대부분 첫 번째나 두 번째 시도에서 사용할 수 있는 이미지를 생성합니다.
실제 서비스에서는 B 모델이 더 유용할 가능성이 큽니다.
재생성이 많아질수록 다음 비용도 함께 증가합니다.
API 비용
사용자 대기 시간
서버 처리량
실패율
UI 복잡도
사용자 이탈
그래서 이미지 모델의 진짜 생산성은 단순한 화질보다 재생성 횟수를 얼마나 줄여 주는지에서 나타날 수 있습니다.
이미지 모델은 생성기에서 인터페이스로 바뀌고 있다
이 흐름을 조금 더 넓게 보면 이미지 모델에 대한 정의 자체가 달라지고 있습니다.
과거에는 이미지 생성기가 이런 역할을 했습니다.
텍스트 → 이미지
하지만 앞으로는 이런 형태에 더 가까워질 수 있습니다.
자연어 → 이미지 조작 명령
예를 들어 사용자는 다음과 같이 말할 수 있습니다.
이 부분을 지워 줘.
제품을 조금 왼쪽으로 옮겨 줘.
배경만 흐리게 만들어 줘.
같은 인물로 다른 카메라 각도를 만들어 줘.
포스터의 가격을 19달러에서 15달러로 바꿔 줘.
결국 자연어가 이미지 편집을 위한 인터페이스가 되는 것입니다.
이 관점에서 보면 AI 이미지 기술의 미래는 단순히 이미지를 얼마나 잘 생성하느냐의 문제가 아닙니다.
사용자가 원하는 시각적 결과를 얼마나 정확하게 이해하고 수정할 수 있느냐의 문제에 더 가깝습니다.
프롬프트 엔지니어링은 점점 덜 중요해질지도 모른다
초기 이미지 생성 모델에서는 복잡한 프롬프트가 상당히 중요했습니다.
예를 들어 다음과 같은 표현들이 자주 사용됐습니다.
cinematic lighting
35mm lens
volumetric atmosphere
ultra detailed
shallow depth of field
photorealistic
사용자는 모델이 원하는 결과를 만들도록 하기 위해 일종의 특별한 문법을 배워야 했습니다.
하지만 모델의 언어 이해 능력이 좋아질수록 이런 방식은 점점 줄어들 가능성이 있습니다.
이상적인 이미지 모델이라면 다음처럼 말해도 충분해야 합니다.
창가에서 촬영한 고급 제품 사진처럼 만들어 줘.
사용자가 모델에 맞춰 특별한 프롬프트를 배울 필요 없이, 모델이 사용자의 일반적인 표현을 이해하는 방향입니다.
개인적으로는 이것이 훨씬 자연스러운 발전 방향이라고 생각합니다.
앞으로 이미지 모델을 볼 때 확인하고 싶은 것
새로운 이미지 모델을 평가할 때 단순히 결과 이미지 몇 장만 보는 것은 충분하지 않습니다.
다음과 같은 반복 테스트가 더 중요합니다.
- 반복 편집
같은 이미지를 5번 이상 수정하면서 원하지 않는 변화가 얼마나 발생하는지 확인합니다.
- 텍스트 정확도
문장, 숫자, 제품명, 가격 등의 정확성을 테스트합니다.
- 레퍼런스 이미지
여러 이미지의 요소를 각각 얼마나 잘 이해하고 조합하는지 확인합니다.
- 인물 일관성
배경이나 의상만 수정했을 때 동일 인물이 유지되는지 확인합니다.
- 구도 유지
특정 오브젝트를 이동하면서 전체 레이아웃이 불필요하게 변경되지 않는지 확인합니다.
- 재현성
동일한 작업을 여러 번 수행했을 때 실제로 사용할 수 있는 결과가 얼마나 자주 나오는지 확인합니다.
이런 테스트는 데모 이미지보다 화려하지 않습니다.
하지만 실제 제품을 만들 때는 훨씬 유용합니다.
마무리
AI 이미지 생성은 이미 단순한 “그림 그려 주는 AI” 단계를 넘어가고 있습니다.
앞으로 중요한 경쟁은 단순한 화질이 아니라 다음과 같은 요소에서 발생할 가능성이 큽니다.
편집 정확도
이미지 일관성
레퍼런스 이해 능력
텍스트 정확도
반복 작업 안정성
속도
비용
실제 워크플로우와의 통합
결국 차세대 이미지 모델의 가장 큰 발전은 결과 이미지가 극적으로 더 멋져지는 것이 아닐 수도 있습니다.
오히려 사용자가 이미 만든 이미지를 훨씬 더 쉽게 제어할 수 있게 되는 것이 더 중요한 변화일 수 있습니다.
앞으로 AI 이미지 생성은 생성 기술이라기보다 점점 자연어 기반의 시각 편집 인터페이스에 가까워질 것 같습니다.
