요즘 AI에게 구현을 맡기면 테스트까지 같이 써준다.
Controller 구현을 맡기면 @WebMvcTest 기반 테스트까지 같이 만들어주고, 정상 케이스뿐 아니라 예외 케이스까지 꽤 그럴듯하게 만들어준다.
그리고 실행해 보면 전부 초록불이다.
다 짰다 와~~~ 하고 넘긴다
그런데 여기서 한 가지 문제가 생긴다
초록불은 테스트가 통과했다는 사실만 알려준다.
그 테스트가 내가 원하는 것을 실제로 검증하고 있는지는 알려주지 않는다.
직접 겪고 나니 이 둘은 생각보다 꽤 다른 문제였다.
이 글은 AI가 작성한 테스트가 멀쩡하게 통과하면서도 요구사항을 놓칠 수 있었던 사례와, 그 테스트가 코드 리뷰에서도 그대로 살아남았던 이유에 대한 이야기다.
엥 테스트 통과했잖아요
응답에서 값이 없는 필드는 아예 제외해야 하는 API가 있다고 해보자.
예를 들어 nickname이 없다면 다음처럼 나가야 한다.
{
  "id": 1
}
그래서 테스트도 자연스럽게 이렇게 작성했다.
@Test
void nickname이_없으면_응답에서_빠진다() throws Exception {
    mockMvc.perform(get("/users/1"))
            .andExpect(status().isOk())
            .andExpect(jsonPath("$.nickname").doesNotExist());
}
이름만 보면 꽤 정확해 보인다.
doesNotExist().
nickname이 존재하지 않아야 한다는 뜻처럼 읽힌다.
그런데 실제 응답이 아래처럼 나가도 테스트가 통과할 수 있다.
{
  "id": 1,
  "nickname": null
}
Spring의 doesNotExist()가 확인하는 것은 단순히 JSON Path 자체가 존재하지 않는가가 아니다.
해당 경로에 non-null 값이 존재하지 않는가를 확인한다.
즉,
"nickname": null과
// nickname 자체가 없음을 내가 기대했던 방식으로 구분해주지 않는다.
실제로 확인하는 방법은 간단하다.
DTO에 붙어 있던 다음 설정을 잠깐 제거한다.
@JsonInclude(JsonInclude.Include.NON_NULL)그러면 응답에는 다음과 같이 null인 필드가 그대로 포함된다.
{
  "id": 1,
  "nickname": null
}
그런데 기존 테스트는 여전히 초록불이었다.
내가 막으려고 했던 회귀가 실제로 발생했는데도 테스트가 통과한 것이다.
정말로 JSON Path 자체가 존재하지 않는 것을 확인하고 싶다면 Spring에는 별도의 API가 있다.
.andExpect(jsonPath("$.nickname").doesNotHaveJsonPath());이름은 비슷하지만 의미는 다르다. doesNotExist()는 non-null 값의 부재를 보고, doesNotHaveJsonPath()는 null을 포함해 경로 자체가 없는지를 본다.
이 둘의 이름이 비슷하다 보니 코드만 대충 읽었을 때는 문제를 눈치채기 쉽지 않았다.
그리고 더 중요한 건 따로 있었다.
테스트가 통과하고 있었기 때문에 의심할 이유가 없었다
테스트가 실패해야 할 때 실패하는지 보기
이 문제를 발견한 방법은 별거 아니었다.
테스트가 지키고 있다고 생각했던 동작을 일부러 없애봤다.
@JsonInclude 제거
        ↓
테스트 실행
        ↓
그런데 GREEN
이제서야 알았다.
이 테스트는 내가 생각한 동작을 검증하고 있지 않았다.
그래서 이후에는 중요한 테스트를 볼 때 가끔 반대로 확인한다.
검증하려는 동작을 일부러 깨뜨린다
            ↓
       테스트를 돌린다
            ↓
   정말로 실패하는지 확인한다
예를 들어,
@JsonInclude를 제거한다.

조건문을 반대로 바꾼다.

예외를 던지는 코드를 잠깐 지운다.

반환 값을 일부러 틀리게 만든다.
이 상태에서도 테스트가 계속 통과한다면 그 테스트는 내가 검증하려던 동작을 실제로 확인하고 있지 않은 것이다
이런 접근을 체계적으로 자동화한 것이 mutation testing이고 Java에서는 PIT 같은 도구가 대표적이다
그런데 꼭 도구부터 붙일 필요는 없다
중요한 테스트 몇 개만 손으로 망가뜨려봐도 생각보다 쉽게 잘못된 검증 조건을 찾을 수 있다.
특히 AI가 테스트까지 한 번에 만들어주는 환경에서는 이 과정이 더 중요해졌다고 느꼈다.
직접 테스트를 작성하면 보통 한 번쯤은 빨간불을 보게 된다.
테스트 작성
   ↓
  RED
   ↓
  구현
   ↓
 GREEN
그 과정에서 자연스럽게
왜 실패하지?
지금 무엇을 검증하고 있지?
를 생각하게 된다.
그런데 AI에게 구현과 테스트를 한 번에 맡기면 이 과정 자체가 생략될 수 있다.
AI에게 구현 요청
      ↓
구현 + 테스트 생성
      ↓
GREEN (야호 성공이다)
처음 본 결과가 이미 초록불이다.
그러면 그 초록불이 진짜인지 의심해볼 기회도 같이 사라진다.
그런데 리뷰 도구도 테스트는 건너뛰고 있었다
그래도 처음에는 큰 문제는 아니라고 생각했다.
AI가 만든 코드를 그대로 믿지 않으려고 별도의 코드 리뷰 도구도 붙여두고 있었기 때문이다.
내가 사용한 것은 알리바바에서 공개한 open-code-review였다.
-> 변경된 git diff를 기준으로 코드의 문제를 찾아주는 도구다.
그래서 내 머릿속에서는 대충 이런 구조라고 생각했다.
AI가 구현
   ↓
AI가 테스트
   ↓
테스트 실행
   ↓
코드 리뷰
구현에 문제가 있으면 테스트가 잡고,
테스트가 놓친 문제는 리뷰에서 한 번 더 잡아줄 거라고 생각했다.
그런데 한참 사용한 뒤 기본 설정을 확인하다가 하나를 발견했다.
테스트 파일이 기본 리뷰 대상에서 제외되어 있었다.
즉 실제 구조는 이랬다.
AI가 구현을 쓴다
        ↓
   리뷰 도구가 본다

--------------------

AI가 테스트를 쓴다
        ↓
   테스트는 실행된다
        ↓
   하지만 테스트 코드 자체는 리뷰하지 않는다
이걸 보고 앞에서 겪었던 doesNotExist() 문제가 다시 보였다.
구현을 AI가 작성했다.
테스트도 같은 AI가 작성했다.
그리고 테스트 안의 검증 조건이 요구사항을 제대로 확인하지 못했다
그런데 리뷰 도구도 테스트 파일을 보지 않았다.
결국 테스트는 AI가 만든 구현을 검증하고 있었지만,
-> 그 테스트 자체를 검증하는 층은 없었다.
이게 특히 위험하다고 느낀 이유는 구현과 테스트를 같은 에이전트가 작성할 수 있기 때문이다.
예를 들어 AI가 요구사항을 잘못 이해했다면,
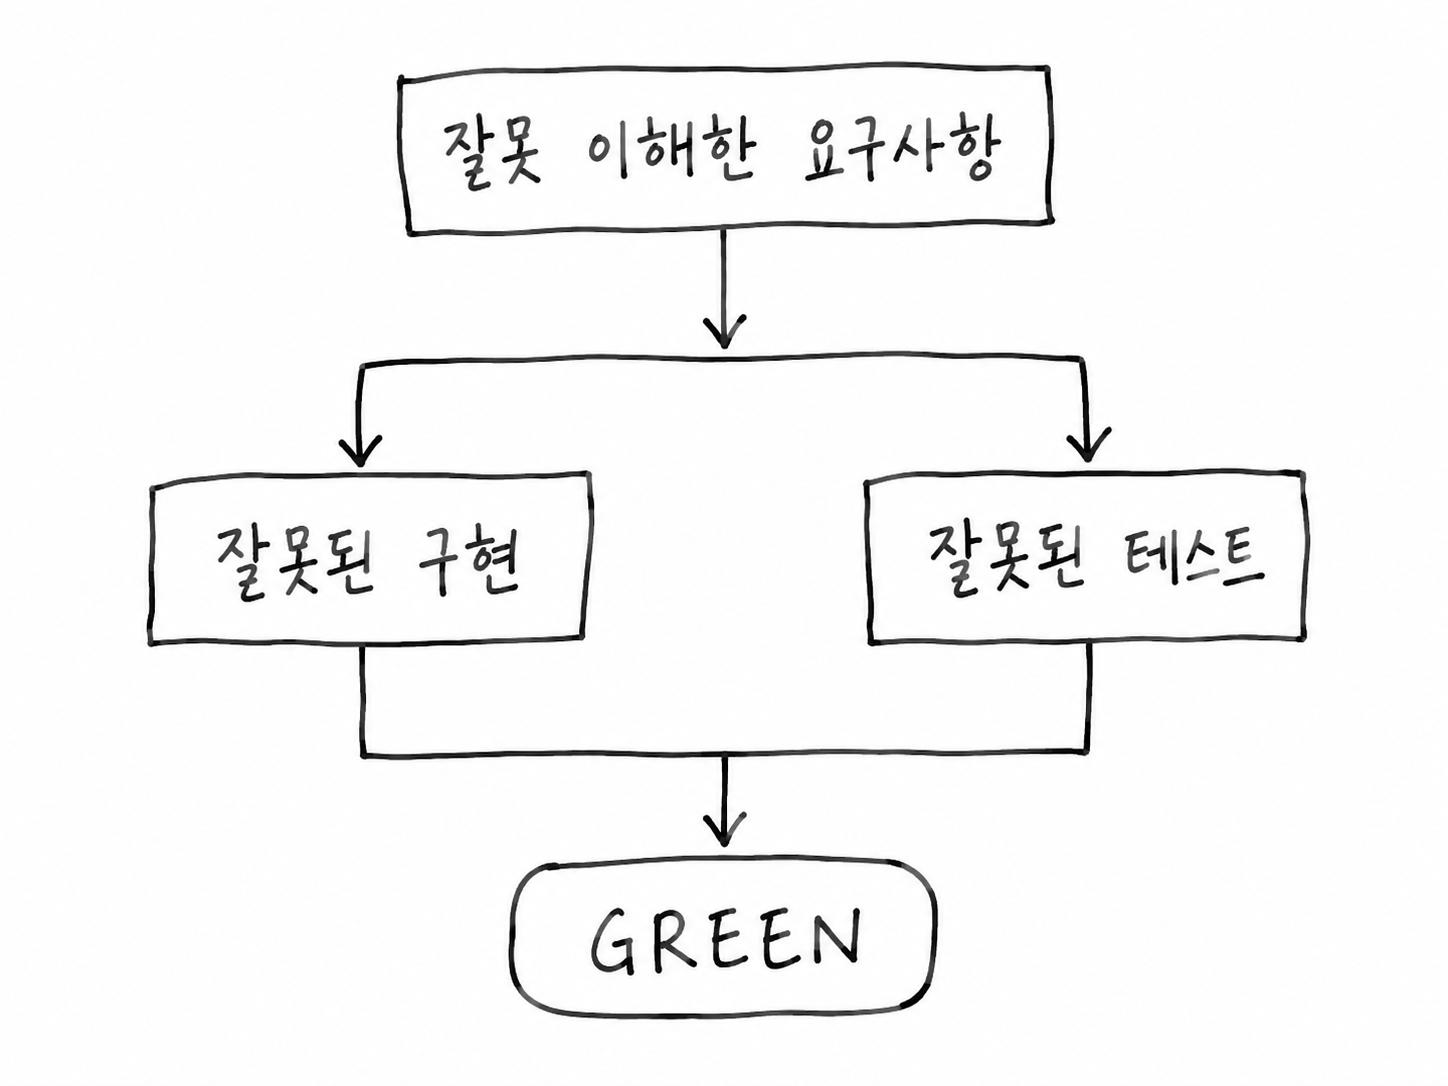
이런 상황이 가능하다.
구현과 테스트가 서로 독립적으로 틀리는 게 아니다.
같은 잘못된 가정을 공유하면서 서로를 정답이라고 확인할 수 있다.
그러면 테스트가 있다는 사실 자체가 안전장치가 되지 않는다.
마지막 리뷰는 다른 에이전트에게 맡겼다
이후에는 최종 리뷰 방식을 조금 바꿨다.
구현하던 에이전트에게 그대로
지금 작성한 코드 리뷰해줘.
라고 하는 대신, 별도의 에이전트나 별도의 세션에서 최종 변경사항을 다시 보게 했다.
그리고 구현 과정에서 오간 대화는 최대한 넘기지 않았다.
대신 리뷰에 필요한 것만 전달한다.
- 변경된 diff
- 처음 요구사항
- 필요한 경우 구현 계획
리뷰에서 보고 싶은 것도 조금 더 명확하게 적었다.
1. 변경사항이 요구사항과 다른 부분이 있는지 확인한다.

2. 테스트가 통과하더라도 실제 장애가 발생할 수 있는 경로를 찾는다.

3. 각 테스트의 assertion이 테스트 이름과 요구사항을 실제로 검증하고 있는지 확인한다.

4. 정상 케이스뿐 아니라 실패 경로가 빠진 곳을 확인한다.

5. 스타일보다 실제 버그 가능성을 우선해서 지적한다.

6. 지적할 때는 근거가 되는 file:line을 함께 제시한다.
여기서 특히 중요하게 보는 건 3번이다.
테스트가 있는가?를 보는 게 아니라,
이 assertion이 정말 이 요구사항을 증명하는가?를 보게 하는 것이다.
물론 리뷰 에이전트를 분리한다고 모든 문제가 해결되는 것은 아니다
리뷰하는 AI도 틀릴 수 있다
그래서 리뷰 결과 역시 그대로 받아들이기보다는 실제 코드와 테스트를 보고 판단해야 한다
다만 적어도 구현하면서 만들어진 가정을 그대로 들고 자기 코드를 다시 확인하는 것보다는 한 번 다른 관점에서 변경사항을 보게 만들 수 있었다.
성공을 의심해보는 습관
예전에는 테스트 결과가 이렇게 나오면 꽤 안심했다.
BUILD SUCCESSFUL

Tests: 42 passed
지금도 물론 테스트가 통과하는 것은 중요하다.
하지만 AI가 구현과 테스트를 같이 작성하는 상황에서는 초록불 하나만 보고 끝내지는 않는다.
특히 중요한 요구사항이라면 한번쯤 반대로 확인한다.
잘못된 동작을 넣었을 때 테스트가 제대로 실패하는가?
그리고 리뷰 단계에서는 구현뿐 아니라 테스트 코드도 같이 본다.
내가 지금 사용하는 흐름을 단순하게 정리하면 이 정도다.
AI 구현
  ↓
AI 테스트 작성
  ↓
테스트 실행
  ↓
중요한 동작을 일부러 깨뜨려 테스트 확인
  ↓
별도 맥락에서 구현 + 테스트 diff 리뷰
  ↓
최종 판단
구현도 AI가 만들고 테스트도 AI가 만드는 환경에서는, 당연하게도 구현뿐 아니라 테스트 자체도 검증 대상이 되어야 한다