옵션 이름 정도는 알고 씁시다
Next.js는 대략 1년에 한 번, 매년 10월쯤 메이저 버전을 올립니다. App Router가 들어온 13이 2022년 10월, 14가 2023년 10월, 15가 2024년 10월, 16이 2025년 10월이었죠. 그리고 2026년 8월에 16.3이 나오면서 cacheComponents에 이어 partialPrefetching 같은 옵션이 새로 생겼습니다.
옵션이 계속 늘어나는 건 당연합니다. Next.js를 만드는 사람들이 현업의 요구사항을 받아서 리액트를 더 빠르게 돌리고, 개발 경험을 더 좋게 만들려고 애쓴 결과니까요.
그런데 이걸 "배워두면 실력이 오르는 것"으로 접근하면 조금 곤란합니다. 새 옵션을 익힌다고 프론트엔드 실력이 올라가는 건 아니거든요. 대단한 건 그 옵션을 만든 Next.js 개발자들이지, 만들어진 산출물의 사용법을 익힌 제가 대단한 게 아닙니다. 로봇청소기 설명서를 다 읽었다고 제가 로봇청소기 전문가가 되는 건 아니잖아요.
반대로 설명서를 하나도 안 읽고 쓰는 것도 문제입니다. 자기가 쓰는 도구가 무슨 일을 하는지 아는 건 "배워두면 좋은 것"이 아니라 그냥 기본 소양에 가깝습니다. 그래서 저는 이렇게 생각합니다. 옵션을 안다고 더 나은 개발자가 되는 건 아니지만, 모르면 좀 곤란하다고요.
바빠서 미뤄뒀다면 아래 항목의 의미를 설명할 수 있는지 한 번 확인해보세요.
<Link>의prefetch는 정확히 무엇을 미리 받나요?- 라우트가 "동적 렌더링"으로 넘어가는 조건은 뭔가요?
[slug](동적 세그먼트)가 있으면 동적 렌더링인가요? cookies()를 읽는 컴포넌트를<Suspense>로 감싸면, 그 바깥은 정적으로 남나요?experimental.staleTimes의 기본값은 얼마이고, 뭘 얼마나 캐시하나요?cacheComponents: true를 켜면 뭐가 달라지나요?- 16.3의
partialPrefetching은 뭘 해결하나요?
하나라도 막힌다면, 잘 만들어진 Next.js에서 굳이 겪지 않아도 될 성능 저하를 겪고 있을 가능성이 있습니다. 특히 서버 컴포넌트 쪽에서요.
기본 소양이라는 말은, 달리 말하면 면접에서 물어봐도 이상하지 않다는 뜻이기도 합니다. 취업이나 이직을 준비 중이라면 위 목록이 그대로 예상 질문이고, 이미 일하고 있다면 옆자리 시니어가 어느 날 툭 던질 수 있는 질문이죠. 이 글을 읽고 나면 "Nextjs를 썼는데 왜 페이지 이동이 느리죠?"에 답할 수 있게 됩니다. 느린 정도가 아니라, 클릭했는데 화면이 한동안 안 바뀌는 순간이 왜 생기는지도요.
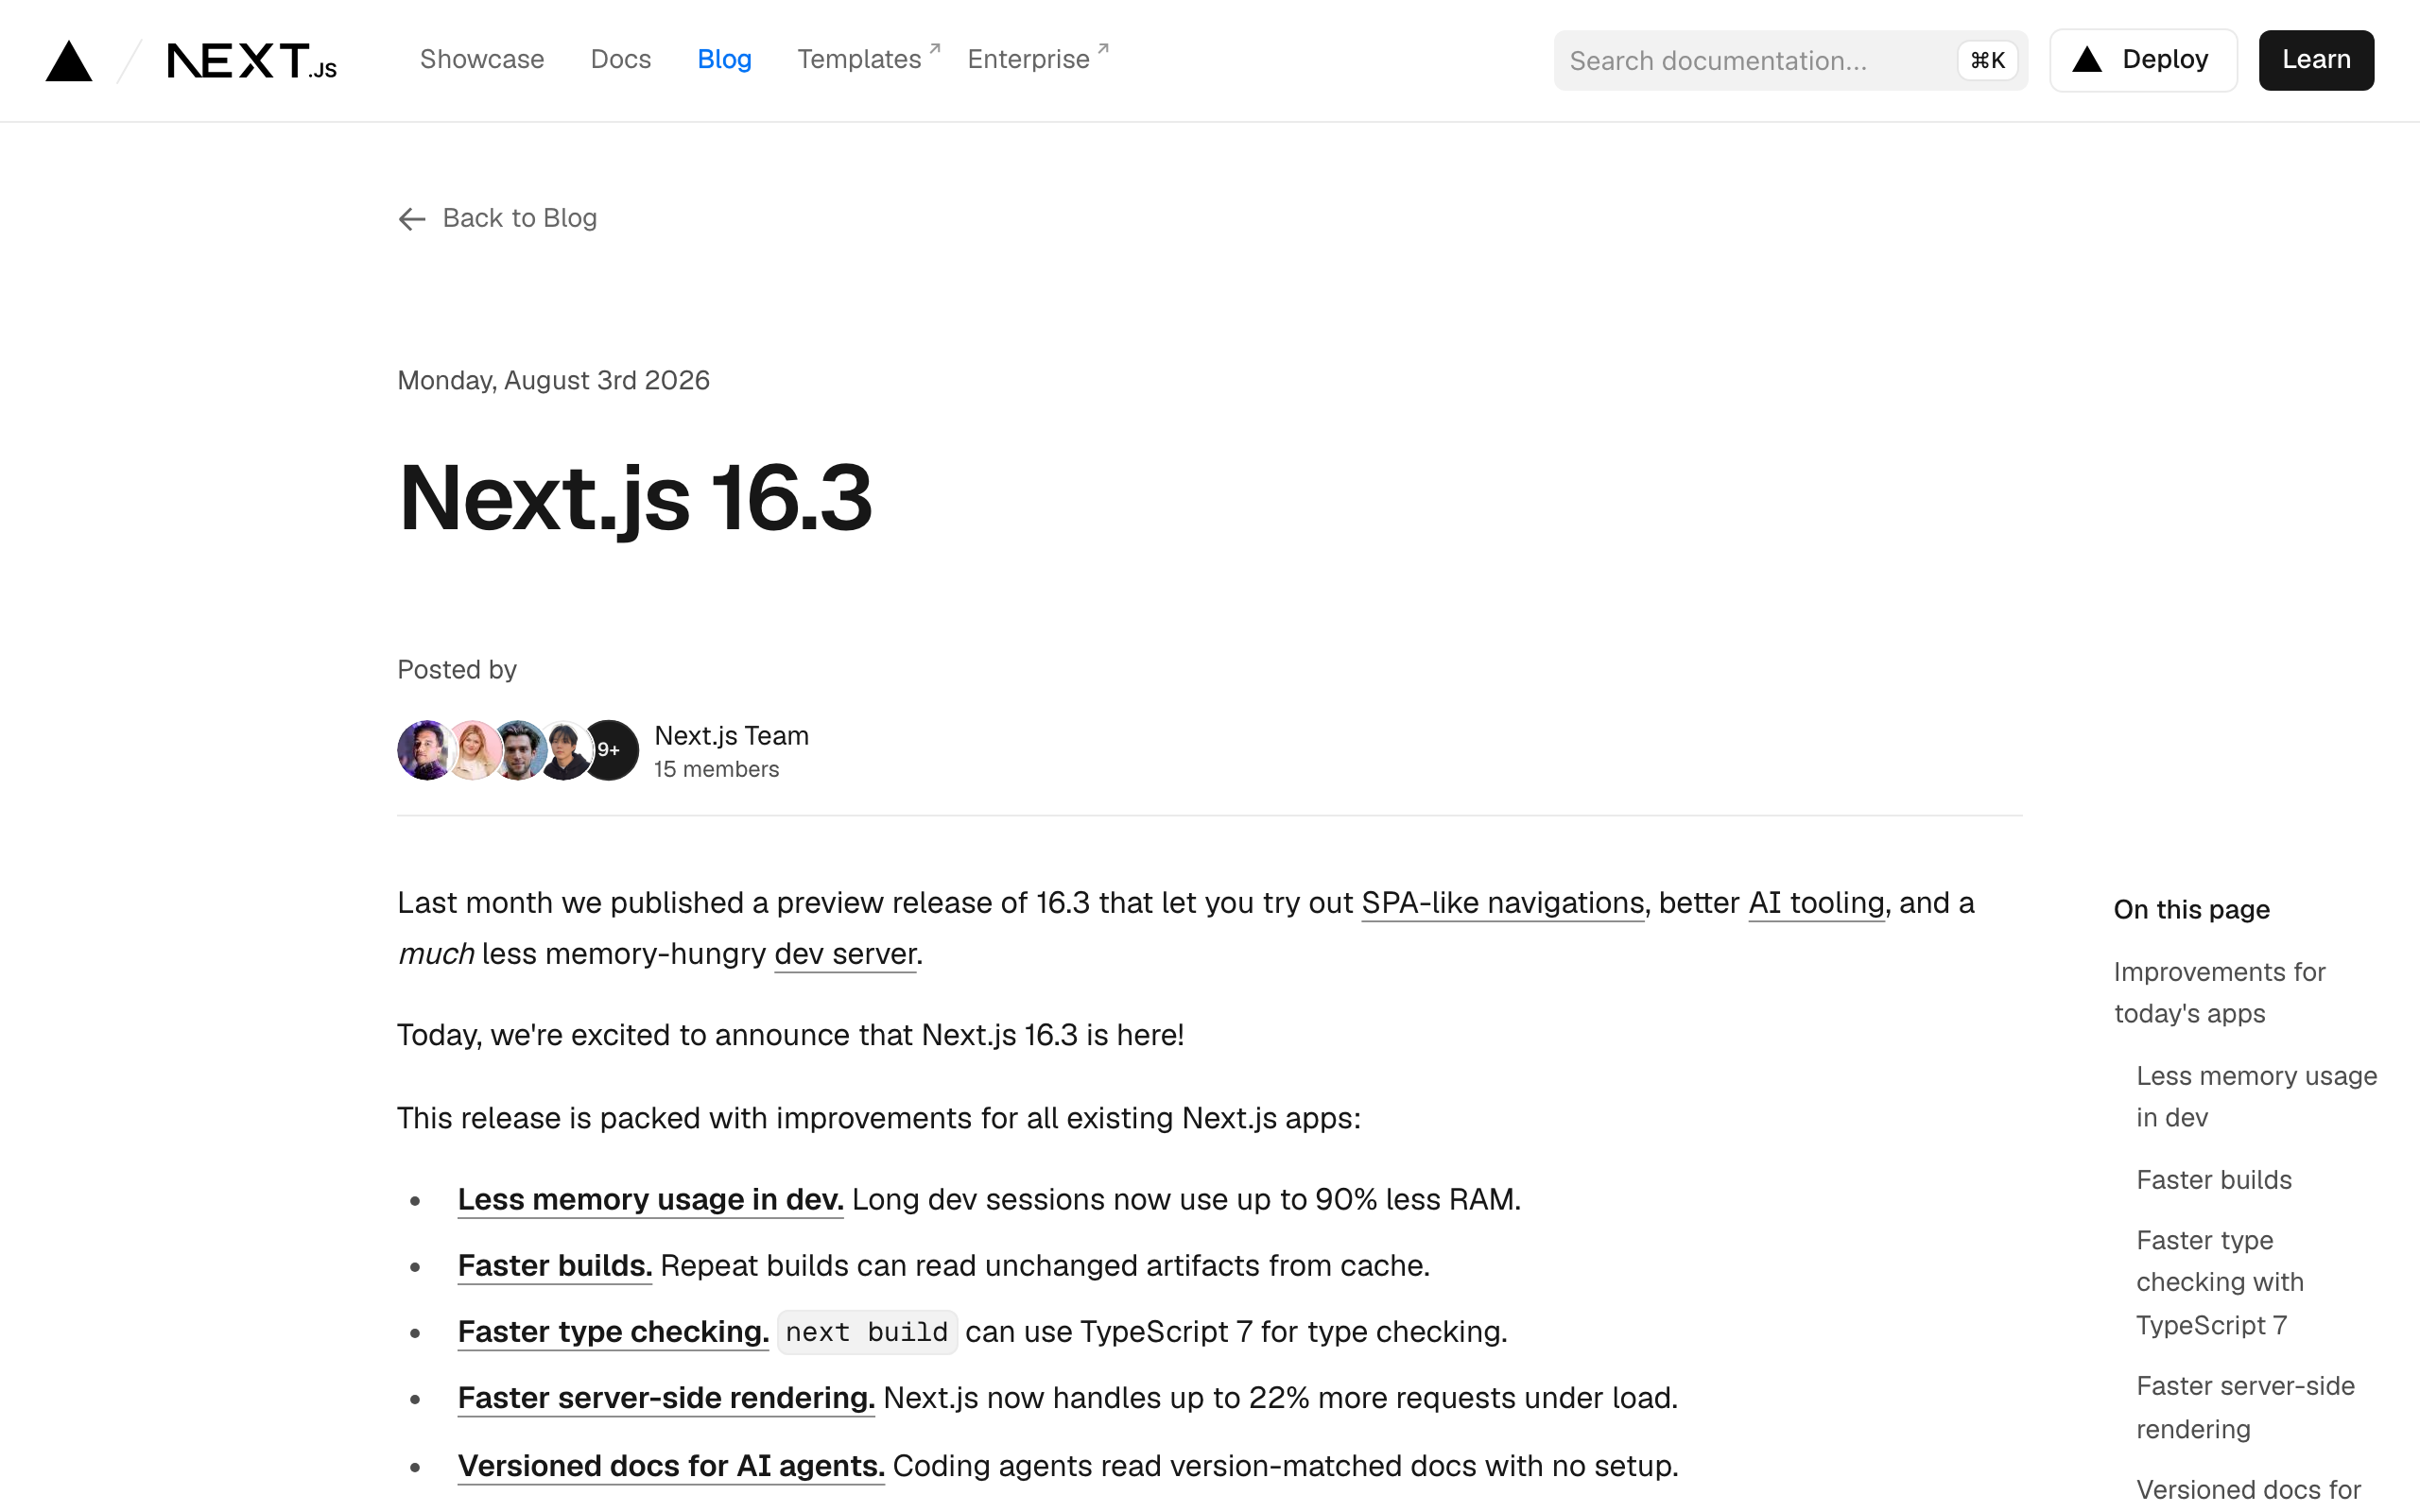
출처: Next.js 16.3 릴리스 블로그. 16.3에서 Partial Prefetching이 들어왔습니다.
본론 1. 서버 컴포넌트는 왜 나왔나
이미 아는 분은 건너뛰어도 됩니다. 다만 뒤에서 "구멍(hole)"이라는 그림을 계속 쓸 거라서, 그 그림만 한 번 봐두시면 좋겠습니다.
SPA에서 하이드레이션까지
리액트는 처음에 SPA로 유명해졌습니다. 그 전의 웹은 라우트를 옮길 때마다 서버에서 HTML을 새로 받았죠. 그때는 인터넷도 지금처럼 빠르지 않아서, 클릭할 때마다 네트워크 지연이 그대로 화면에 드러났습니다. SPA는 자바스크립트 번들을 한 번 받아두고 화면 전환을 브라우저 안에서 처리하니까 클릭 이후가 부드러웠습니다.
대신 문제가 생겼습니다. 모든 페이지의 자바스크립트를 한 번에 받으니 첫 화면이 늦게 뜹니다. 그래서 첫 HTML은 서버에서 렌더해서 내려주고(SSR), 그 다음부터는 클라이언트 번들이 가상 DOM을 그리며 화면을 바꾸는 하이브리드 방식이 자리 잡았습니다. 서버가 만든 HTML에 클라이언트 번들이 이벤트 핸들러와 상태를 붙이는 과정이 하이드레이션이고요.
첫 진입
  서버 ── HTML ──▶ 브라우저 (일단 보인다)
  서버 ── JS 번들 ──▶ 브라우저 (하이드레이션, 이제 눌린다)

이후 라우트 이동
  브라우저 안에서 가상 DOM 갱신 → 네트워크 지연 없음
여기에 네트워크 최적화가 하나 더 붙습니다. 라우트별로 번들을 쪼개서(code splitting) 지금 화면에 필요한 청크만 받게 하는 거죠. 처음에는 네트워크를 타지만, 이후 라우트 전환에는 지연이 없다는 SPA의 장점을 지키면서 첫 로딩도 줄이는 구조입니다.
그래도 남는 비용
라우트별로 쪼개도 한 라우트에 해당하는 번들 크기 자체는 줄지 않습니다. 다운로드 시간도 시간인데, 가상 DOM을 만드는 비용도 무시할 수 없습니다. 자바스크립트 객체를 생성하는 일일 뿐이라도, 60fps 기준으로 한 프레임은 16ms 남짓입니다. 마운트할 때 트리 전체를 받아서 상호작용 가능한 상태로 만들어야 하니 꽤 빡빡한 조건이죠.
그래서 나온 게 리액트 서버 컴포넌트(RSC)입니다. 리액트 팀이 2020년 12월에 RFC와 데모를 공개했고, Next.js가 2022년 10월 13 버전의 App Router(당시 베타)로 실전에 들여온 뒤 2023년 5월 13.4에서 안정화했습니다. React 자체에서는 2024년 12월 React 19에서 정식 기능이 됐습니다. 지금까지도 RSC를 가장 깊게 구현한 프레임워크는 Next.js입니다.
발상은 단순합니다. 훅도 없고 이벤트 핸들러도 없는, 그러니까 상호작용이 없는 컴포넌트는 브라우저에서 굳이 다시 그릴 필요가 없습니다. 이런 컴포넌트는 서버에서 렌더하고 그 결과값만 내려줍니다. 그러면 클라이언트 번들에서 그 컴포넌트의 코드가 빠지니 번들이 가벼워지죠.
어떤 게 서버 컴포넌트인가
여기서 하나 짚고 갈 게 있습니다. 서버 컴포넌트라고 하면 async에 await fetch가 들어간 함수를 떠올리기 쉬운데, 그건 서버 컴포넌트 중 한 가지 모양일 뿐입니다. App Router에서는 app/ 아래의 컴포넌트가 기본으로 서버 컴포넌트입니다. 파일 맨 위에 'use client'를 쓴 파일과 그 파일이 import하는 것만 Next.js가 클라이언트 컴포넌트로 취급하고요.
// app/posts/page.tsx
// async도 fetch도 없는 평범한 함수. 그래도 서버 컴포넌트입니다.
export default function PostsPage() {
  return (
    <main>
      <h1>글 목록</h1>
      <PostList />
      <LikeButton postId={1} />
    </main>
  )
}

// 데이터를 읽는 서버 컴포넌트. 흔히 떠올리는 쪽은 이 모양이죠.
async function PostList() {
  const posts = await fetch('https://api.example.com/posts').then((r) => r.json())
  return (
    <ul>
      {posts.map((p) => (
        <li key={p.id}>{p.title}</li>
      ))}
    </ul>
  )
}
// app/posts/like-button.tsx
// 이 한 줄이 있어야만 클라이언트 컴포넌트입니다.
'use client'
import { useState } from 'react'
export function LikeButton({ postId }: { postId: number }) {
const [liked, setLiked] = useState(false)
return <button onClick={() => setLiked(!liked)}>{liked ? '♥' : '♡'}</button>
}그러니까 App Router로 페이지를 하나라도 만들었다면, 의식하지 않았어도 서버 컴포넌트를 이미 쓰고 있을 가능성이 큽니다. page.tsx부터가 서버 컴포넌트니까요. 제목의 "하나라도 있다면"은 사실 거의 모든 App Router 프로젝트 이야기입니다.
그리고 이 "하나라도"는 글에서 두 번 나옵니다. 한 번은 여기, 서버 컴포넌트가 하나라도 있으면 구멍이 생긴다는 이야기. 다른 한 번은 본론 2에서, 그중 동적인 서버 컴포넌트가 하나라도 있으면 그 구멍을 미리 채울 수 없다는 이야기입니다. 실제로 페이지 이동을 느리게 만드는 쪽은 두 번째예요.
구멍(hole)이라는 그림
이제 라우트 하나를 그리려면 두 종류의 값이 필요합니다. 클라이언트 번들, 그리고 그 라우트의 RSC 값(RSC Payload)입니다. 브라우저가 가진 클라이언트 번들에는 LikeButton 같은 클라이언트 컴포넌트의 코드는 있지만, PostsPage나 PostList의 코드는 없습니다. 서버에만 있죠. 그래서 브라우저 쪽 트리에는 그 자리가 구멍으로 남고, 서버에서 받은 RSC 값으로 그 구멍을 채웁니다.
브라우저가 스스로 만들 수 있는 트리          서버가 내려주는 RSC Payload
┌──────────────────────────┐          ┌─────────────────────────┐
│ <Layout>                 │          │ 구멍 A = <Header> 결과  │
│   ○ 구멍 A ◀─────────────┼──────────│   (로고, 메뉴 마크업)   │
│   <SearchBox/>  'use client'        │                         │
│   ○ 구멍 B ◀─────────────┼──────────│ 구멍 B = <PostList> 결과│
│   <LikeButton/> 'use client'        │   (글 목록 마크업 + props)│
│ </Layout>                │          └─────────────────────────┘
└──────────────────────────┘
RSC Payload는 어떻게 생겼나
말로만 하면 감이 안 오니 실제 응답을 봅시다. 프로덕션 빌드에서 DevTools Network 탭을 열고 Fetch/XHR로 거르면 ?_rsc= 쿼리가 붙은 요청이 보입니다. 응답 타입은 text/x-component이고, 내용은 한 줄에 하나씩 번호가 붙은 JSON입니다. 위 예시 페이지의 응답을 읽기 쉽게 줄이면 이렇습니다.
1:I["./app/posts/like-button.tsx",["static/chunks/app/posts/page.js"],"LikeButton"]
2:["$","main",null,{"children":[
     ["$","h1",null,{"children":"글 목록"}],
     ["$","ul",null,{"children":[
        ["$","li","1",{"children":"첫 번째 글"}],
        ["$","li","2",{"children":"두 번째 글"}]
     ]}],
     ["$","$L1",null,{"postId":1}]
]}]2:줄이 서버가 이미 그려둔 결과입니다.["$", 태그, key, props]꼴이고,PostList가 fetch해서 만든<li>들이 마크업으로 들어 있습니다. 브라우저에는PostList의 코드도, 그 fetch 결과도 없습니다. 이 줄이 구멍을 채우는 재료입니다.1:I[...]줄은 "여기는 네가 가진 번들의LikeButton자리"라는 참조입니다. 트리 안의$L1이 이 줄을 가리키고요. 클라이언트 컴포넌트는 코드가 브라우저에 있으니 서버는 위치와 props만 알려줍니다.
정리하면 RSC Payload는 "서버가 그린 마크업 + 클라이언트 컴포넌트가 들어갈 자리와 props"입니다. 첫 진입 때는 이 값이 HTML 안에 self.__next_f.push([...]) 스크립트로 같이 실려 옵니다. HTML 소스를 열어보면 잔뜩 보이는 그게 RSC 값입니다. 라우트를 이동할 때는 위처럼 별도 요청으로 받습니다.
구멍이 비어 있으면 아예 못 그린다
그러면 여기서 질문이 하나 생깁니다. 다음 라우트로 이동할 때는요? 그 라우트의 구멍을 채울 RSC 값이 필요한데, 그건 서버에 있잖아요. 라우트를 이동할 때마다 서버에 요청하는 불상사가 생기는 게 아니냐, 이게 이 글의 핵심입니다.
답은 "그럴 수 있다"입니다. 그리고 이게 "조금 느려진다" 정도가 아닙니다. 구멍이 빈 트리는 리액트가 화면에 올릴 수 없습니다. 빈 곳이 있는데 어떻게 그리겠어요. 그래서 RSC 값이 올 때까지 리액트는 새 페이지를 한 조각도 안 그리고, 이전 화면이 그대로 남습니다.
예전 SPA처럼 전부 클라이언트 컴포넌트였다면 이 문제가 없었습니다. 번들만 있으면 자바스크립트가 새 라우트 트리를 통째로 만드니까, 클릭 즉시 화면을 바꾸고 데이터는 로딩 UI를 보여주면서 따로 받으면 됐죠. 서버 컴포넌트가 들어오면서 이제 한 페이지를 두 갈래로 그립니다. 자바스크립트가 그리는 부분과, 서버에 요청해서 받아오는 부분. 그리고 두 번째가 도착해야만 첫 번째도 화면에 올라갑니다.
전부 클라이언트 컴포넌트였다면 (SPA)
  클릭 ─▶ JS가 새 라우트 트리를 통째로 만든다 ─▶ 즉시 화면 전환
          데이터는 그 뒤에 따로 받고, 그동안은 로딩 UI
          → 네트워크 왕복 0번

RSC가 하나라도 있는 라우트 (미리 받아둔 RSC 값이 없을 때)
  클릭 ─▶ JS가 만들 수 있는 부분(클라이언트 컴포넌트)은 이미 손에 있음
       ─▶ 서버에 RSC 요청 … 왕복 … 구멍 채울 값 도착
          (이 사이엔 이전 화면 그대로)
       ─▶ 둘을 합쳐 트리 완성 ─▶ 그제야 화면 전환
          → 네트워크 왕복 1번
SPA가 없앴던 "클릭마다 서버 왕복"이 다시 생긴 셈입니다. 데이터 때문이 아니라 화면 구조 때문에요. 데이터 지연은 스켈레톤으로 가릴 수 있지만, 구조가 안 왔을 때는 스켈레톤을 그릴 자리조차 없습니다.
구멍이 백 개든 하나든 상관없습니다. 하나라도 뚫려 있으면 그 하나를 채울 RSC 값이 와야 페이지를 그립니다. 이게 첫 번째 "하나라도"입니다.
이쯤 되면 차라리 빌드할 때 모든 파일 맨 위에 'use client'를 붙여버리는 트랜스파일러를 하나 만들어서 구멍을 아예 없애는 게 낫지 않나 싶은 생각도 듭니다. 농담입니다. 반쯤은요. 그러면 서버에서 받을 게 라우트 뼈대뿐이라 미리 받아둘 수 있긴 한데, 대신 서버 컴포넌트가 줄여준 번들 크기와 서버에서 바로 데이터를 읽는 편함을 전부 돌려줘야 하니까요. Next.js의 답은 다릅니다. 구멍을 클릭 전에 미리 채워두자는 거죠.
본론 2. 이럴 거면 서버 컴포넌트 안 쓰지
첫 요청에 네트워크 지연이 있는 건 인정합니다. 그런데 그 다음부터는 SPA처럼 움직이라고 하이드레이션까지 한 거 아닌가요? 클릭할 때마다 RSC 값을 받으러 네트워크를 다시 탄다면 레전드입니다.
괜찮습니다. 정적 라우트라면요. Next.js가 이걸 막으려고 준비해둔 게 <Link>의 prefetch와 브라우저 메모리의 Client Cache입니다. 구멍을 채울 값을 클릭하기 전에 미리 받아다 놓는 거죠.
Link prefetch가 미리 받는 것
라우트별로 번들을 쪼개는 최적화는 좋습니다. 그런데 처음 가는 라우트마다 청크를 새로 받으면 그 순간 네트워크 지연이 생기고 SPA의 장점이 사라지죠. 그래서 <Link>가 화면(뷰포트)에 들어오면 Next.js는 그 링크가 가리키는 라우트의 클라이언트 번들을 미리 받아둡니다. 같은 라우트는 보통 한 번만 받고, 캐시가 만료된 뒤 마우스를 올리면 그때 다시 받습니다.
RSC 값도 마찬가지입니다. 목적지가 정적 라우트라면 RSC Payload까지 미리 받아서, 클릭하는 순간 네트워크 없이 이미 받은 값으로 구멍을 채웁니다.
1. 뷰포트에 <Link href="/posts"> 가 들어온다
     └─▶ GET /posts?_rsc=1a2b3
           요청 헤더: RSC: 1, Next-Router-Prefetch: 1
     ◀─── text/x-component  (/posts 의 RSC Payload)
           (필요한 클라이언트 번들 청크도 같이 받아둔다)

2. 받은 값을 Client Cache 에 넣어둔다

3. 클릭
     └─ Client Cache 조회 → 있음 → 구멍 채우고 즉시 화면 전환
                                    네트워크 왕복 0번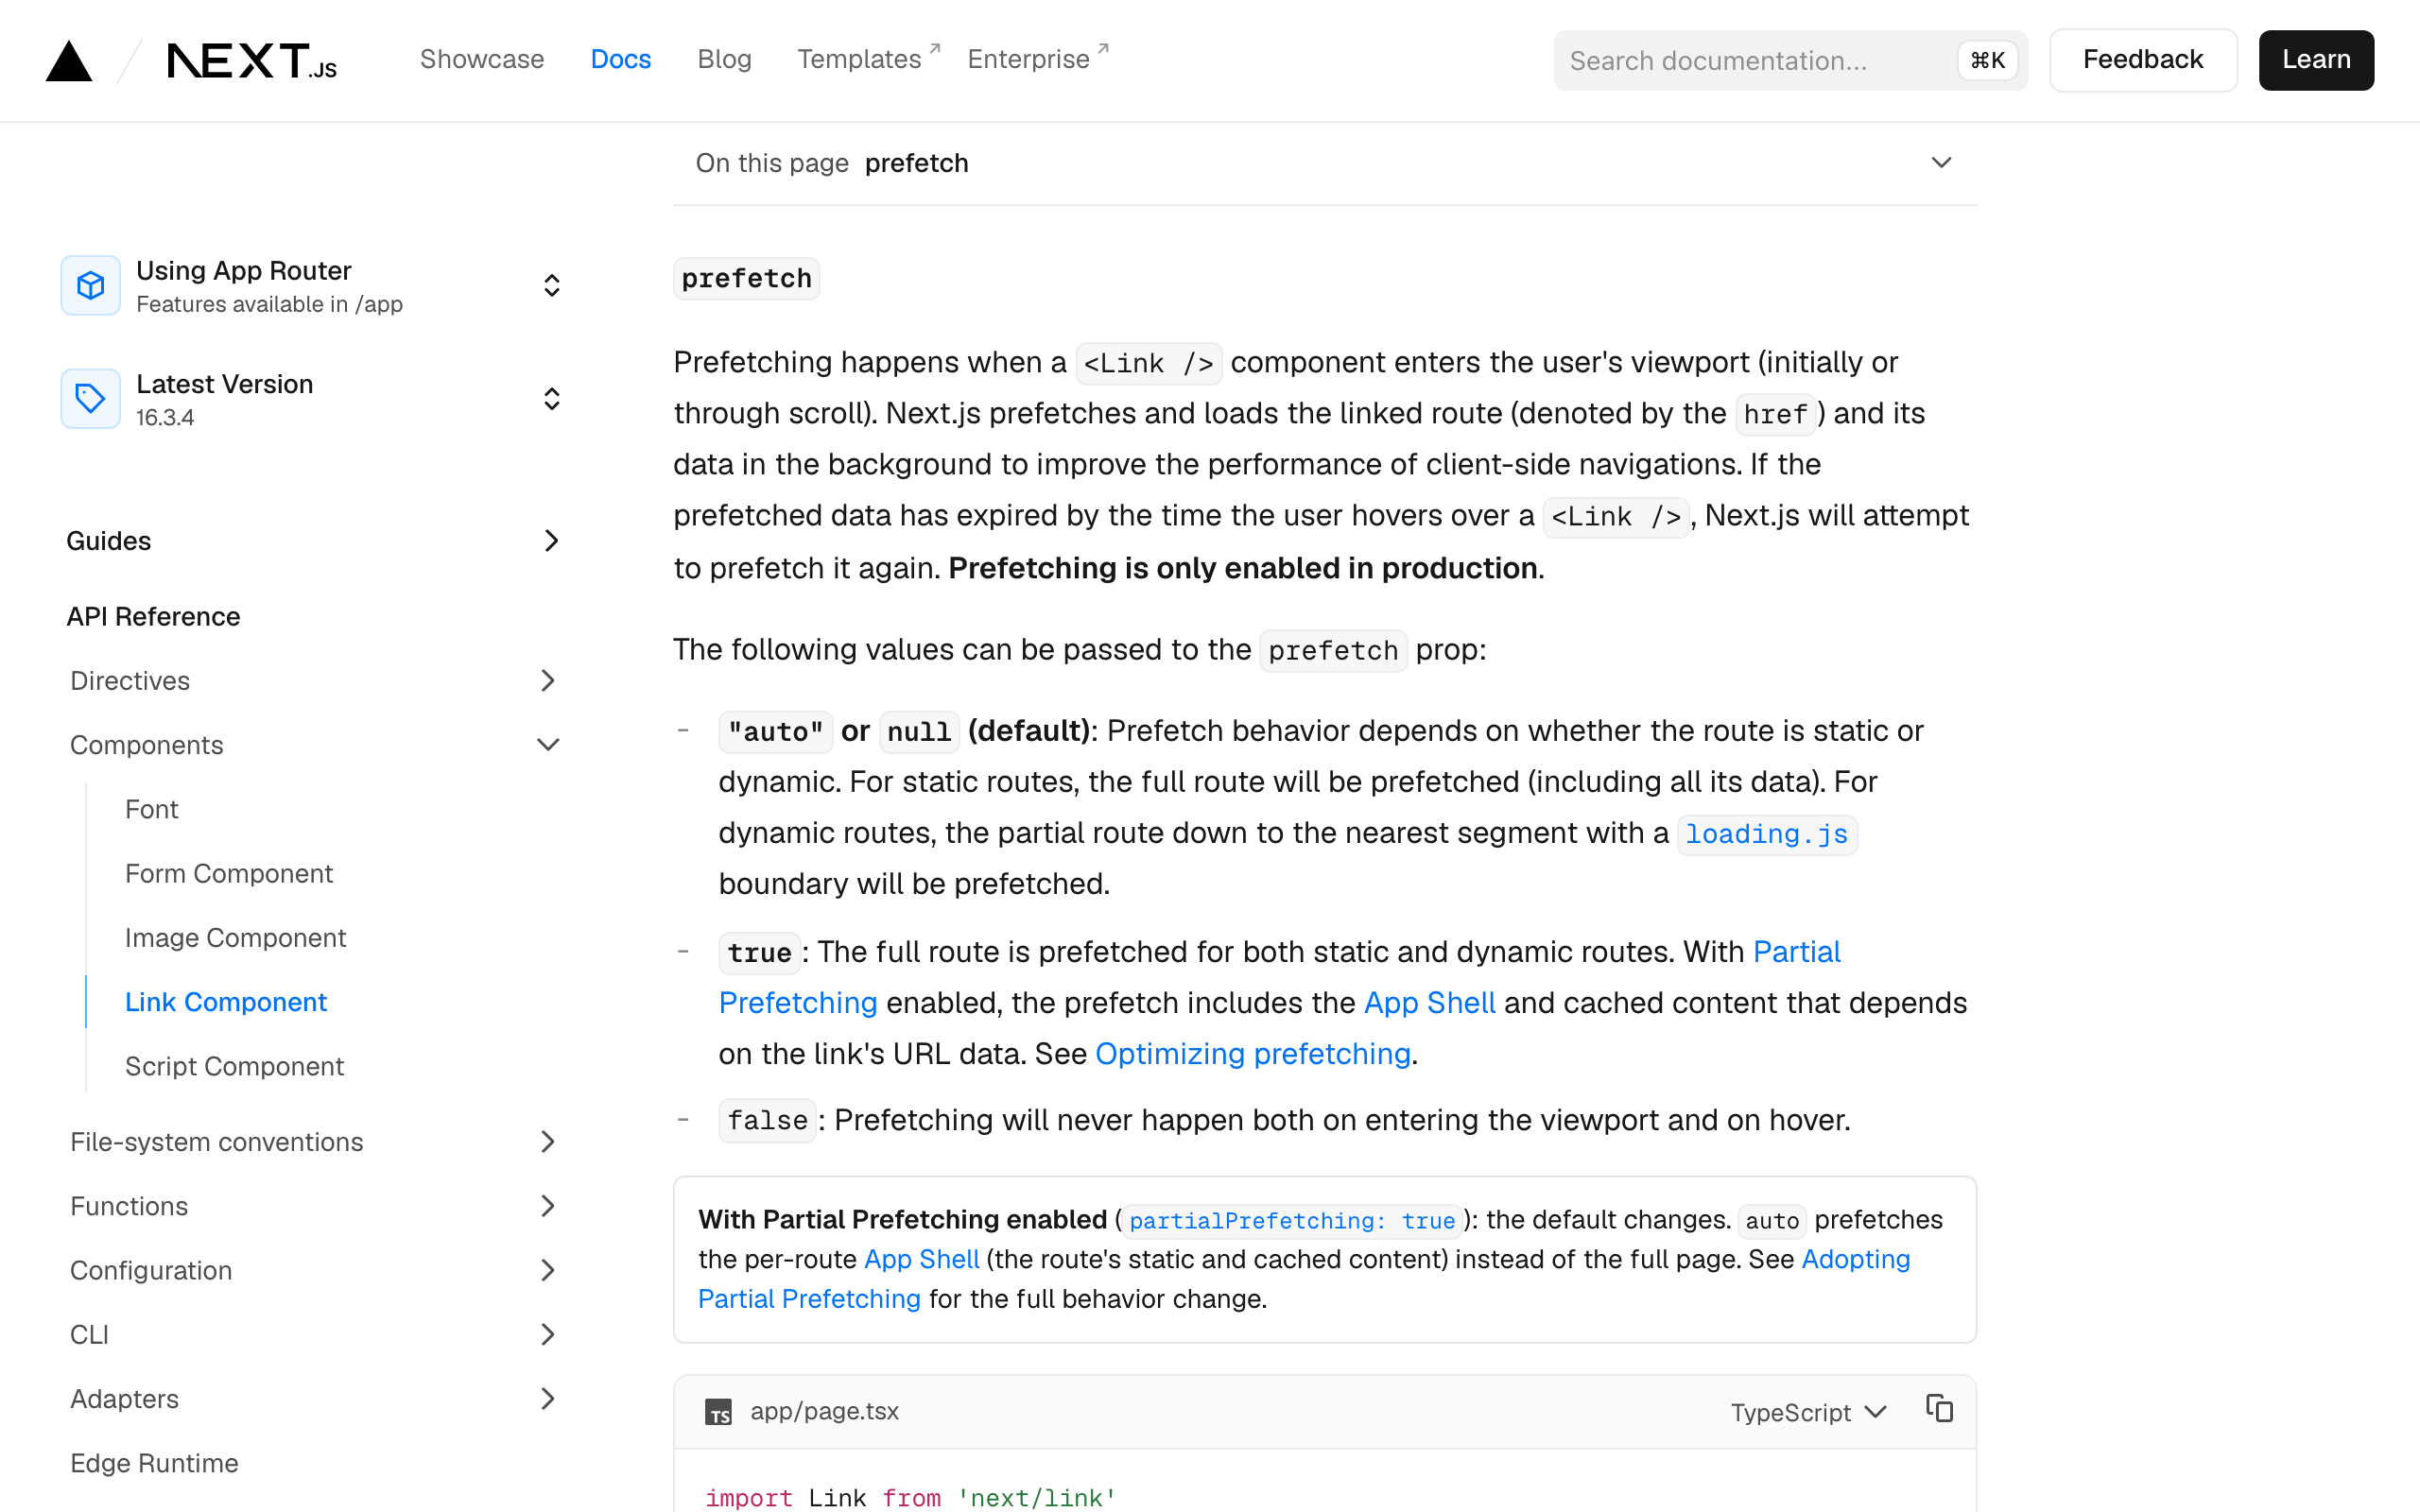
출처: Next.js <Link> 문서. 자동 prefetch는 프로덕션 빌드에서만 동작합니다.
참고로 이 자동 prefetch는 프로덕션에서만 동작합니다. next dev에서 Network 탭을 보고 "prefetch 안 되는데요?" 하면 안 됩니다.
Client Cache라는 서랍
이렇게 받아둔 RSC 값과 이미 방문한 정적 라우트의 RSC 값은 브라우저 메모리의 Client Cache(예전 문서에서는 Router Cache)에 들어갑니다. 새로고침하면 사라지는 메모리 캐시입니다. 모양을 그려보면 이렇습니다.
브라우저 메모리 Client Cache (탭 안에서만 유지, 새로고침하면 사라짐)

/          정적  [레이아웃 + 페이지 RSC]        방문해서 들어옴     5분 유효
/posts     정적  [레이아웃 + 페이지 RSC]        prefetch로 들어옴   5분 유효
/posts/1   동적  [레이아웃 + loading.js 경계]   prefetch(부분)      5분 유효
                 [페이지 본문 RSC]              ─ 안 들어옴 ─       0초 = 방문해도 안 남김
실제로는 URL 통째가 아니라 레이아웃·loading·페이지 세그먼트 단위로 쪼개서 담습니다. 그래서 /posts에서 /posts/1로 갈 때 공통 레이아웃은 다시 받지 않고 바뀌는 세그먼트만 채웁니다. 유효기간 5분과 0초가 어디서 나온 값인지는 본론 3에서 봅니다. 여기서는 표의 마지막 줄만 기억해두시면 됩니다. 동적 라우트의 페이지 본문은 이 서랍에 안 들어갑니다.
"동적"이 두 가지 뜻으로 쓰입니다
정적 라우트가 있으면 당연히 동적 라우트도 있습니다. 여기서 오해가 자주 생기는데, Next.js 문서에서 "동적"이 두 군데서 다른 뜻으로 나오기 때문입니다.
하나는 [slug], [...slug]처럼 폴더 이름을 대괄호로 감싸는 파일 규칙입니다. 문서는 이걸 동적 세그먼트(Dynamic Segment)라고 부르고, 해당 페이지 제목은 Dynamic Route Segments입니다(예전 이름은 Dynamic Routes). URL의 일부를 변수로 받는다는 뜻일 뿐, 렌더링 방식과는 상관없습니다. [slug]가 있어도 generateStaticParams로 값을 미리 알려주면 빌드 때 만들어 두는 정적 라우트입니다.
다른 하나가 동적 렌더링(Dynamic Rendering)입니다. 용어집 정의는 "빌드 때가 아니라 요청 때 렌더하는 것"이고, next build 결과에서 ○ (Static)과 ƒ (Dynamic)으로 나뉘는 게 이겁니다. 이 글에서 정적 라우트, 동적 라우트라고 하면 이쪽, 그러니까 렌더링 방식을 말합니다. <Link> 문서도 "dynamic routes"를 이 뜻으로 줄여 씁니다.
서버 컴포넌트 안에서 요청 시점에만 알 수 있는 값을 한 번이라도 읽으면 Next.js가 그 라우트 전체를 요청 때 렌더합니다. 지금 Next.js 문서는 이런 API를 Request-time APIs라고 부릅니다(14 시절 문서에서는 dynamic functions).
cookies(),headers()searchParamspropsconnection(),draftMode()fetch(url, { cache: 'no-store' })같은 캐시 없는 fetchexport const dynamic = 'force-dynamic'
중요한 건 위치입니다. 이런 호출이 트리의 최상위 레이아웃에 있든, 맨 말단의 작은 컴포넌트 하나에 있든 상관없이 Next.js는 그 라우트 전체를 동적 렌더링으로 취급합니다. cacheComponents를 켜지 않았다면 Next.js가 정적·동적을 따지는 단위는 컴포넌트가 아니라 라우트, 그러니까 주소이기 때문입니다. 한 라우트는 전부 정적이거나 전부 동적이거나 둘 중 하나고, 중간이 없습니다.
/posts/[id]
├─ layout.tsx          정적
├─ page.tsx            정적
│   ├─ <PostHeader>    정적
│   ├─ <PostBody>      정적
│   └─ <LikeCount>     cookies() 읽음  ← 이거 하나 때문에
└─ 결과: 라우트 전체가 동적 렌더링
이게 두 번째 "하나라도"입니다. 동적인 서버 컴포넌트가 하나라도 있으면, 나머지가 전부 정적이어도 라우트 전체가 동적으로 넘어갑니다.
동적 라우트가 되면 벌어지는 일
왜 라우트 단위로 셈하는지, 그래서 뭘 잃는지는 서버 쪽에서 보면 이해하기 쉽습니다. 서버가 주소(key)마다 RSC 응답을 하나씩 들고 있다고 그려봅시다. key는 쿼리스트링까지 포함한 주소입니다. 앞의 Client Cache 서랍이 브라우저 쪽 그림이었다면, 이건 서버 쪽 그림입니다.
주소(key)     렌더링                  RSC 응답을 언제 만드나          미리 받기         Client Cache
/             정적                    빌드 때 한 번, 모두에게 같은 값   전체 O            5분 보관
/posts        정적                    빌드 때 한 번, 모두에게 같은 값   전체 O            5분 보관
/posts/1      동적 (cookies() 하나)   요청이 와야 그때 만듦            loading.js까지만  0초 = 안 남김
                                      → 요청 전에는 응답이 없다        본문은 X          다음에 또 왕복
정적 라우트의 RSC 응답은 빌드 때 만들어 두고 누가 요청해도 같은 값을 줍니다. 그러니 미리 받아도, 받은 걸 저장해 뒀다 다시 써도 안전합니다. 동적 라우트는 요청이 와야 만들 수 있습니다. cookies()를 읽는다는 건 누가 요청했는지 봐야 한다는 뜻이니까요. 요청 전에는 응답이 없으니 미리 받을 것도 없고, 한 번 받은 값도 다음 요청 때 같으리란 보장이 없으니 저장하지 않습니다. 그리고 이 판단을 컴포넌트가 아니라 주소 단위로 하기 때문에, 말단의 cookies() 하나가 주소 전체의 응답을 "요청 전에는 없는 것"으로 만듭니다.
동적 라우트는 그래서 두 가지를 잃습니다.
첫째, 기본 <Link> prefetch 대상에서 대부분 빠집니다. 정확히는 공통 레이아웃과 loading.js 경계까지만 부분적으로 받고, 페이지 본문의 RSC 값은 미리 받지 않습니다.
둘째, Client Cache에도 남지 않습니다. experimental.staleTimes의 기본값이 동적 라우트는 0초이기 때문입니다. 14.2에서는 30초였는데 15에서 0초로 바뀌었습니다. 한 번 방문했더라도 다시 가면 또 받습니다.
구멍 그림으로 돌아가면, 동적 라우트는 클릭하는 순간 페이지 구멍이 비어 있습니다. 미리 받아둔 것도 없고, 지난번 받은 것도 안 남겼으니까요. 그래서 이 페이지로 이동할 때마다 RSC 값을 네트워크에서 새로 받고, 받기 전까지는 화면을 한 픽셀도 바꾸지 않습니다. 화면에 필요한 데이터를 클라이언트에서 따로 페칭하고 있더라도요. 데이터가 아니라 트리 자체가 없어서 못 그리는 거니까요.
클릭 ──▶ RSC 요청 ──▶ (네트워크 왕복) ──▶ 응답 ──▶ 트리 갱신 ──▶ 화면 변경
         └─────── 이 사이에 화면은 그대로 멈춰 있음 ───────┘
                  (loading.js 가 없으면 로딩 표시조차 없음)
사용자 입장에서 이건 "느리다"가 아니라 "눌렀는데 아무 일도 안 일어난다"입니다. 그래서 한 번 더 누르고, 그 사이 응답이 와서 두 번 이동하는 일도 생기더라고요. 호스팅이 서울 리전이 아니라면 이 왕복만으로 300ms를 넘기기도 합니다. 저는 한때 Cloudflare에 올렸었는데, 한국 트래픽이 LA나 홍콩으로 붙는 경우가 있어서 이 지연이 그대로 체감됐습니다.
"저희는 Suspense 쓰는데요?"
그러면 cookies()를 읽는 <LikeCount>만 <Suspense>로 감싸면 어떨까요. 바깥의 PostHeader와 PostBody는 정적으로 남을 것 같잖아요.
안 남습니다. cacheComponents 없이는 Suspense가 렌더링 방식을 바꾸지 못합니다. 라우트는 여전히 동적이고, Suspense 바깥의 정적인 컴포넌트도 빌드 때 만들어 두지 않고 요청이 올 때마다 다시 그립니다. Next.js의 Cache Components 문서도 Suspense 안에서 cookies()를 읽는 예제를 두고, 예전 렌더링 모델에서는 이게 라우트 전체를 동적 렌더링으로 만들었다고 적어두었습니다.
[cacheComponents 없이] /posts/[id]
├─ page.tsx                정적인데도 요청 때 렌더
│   ├─ <PostHeader>        정적인데도 요청 때 렌더
│   ├─ <PostBody>          정적인데도 요청 때 렌더
│   └─ <Suspense>
│        └─ <LikeCount>    cookies() 읽음
└─ 결과: Suspense로 감쌌어도 라우트 전체가 동적 렌더링
Suspense가 해주는 건 응답을 어디서 끊어 보낼지 정하는 일입니다. 서버는 Suspense 바깥을 먼저 그려서 첫 조각으로 흘려보내고, 안쪽은 데이터가 오는 대로 뒤에 붙입니다. 그래서 서버 응답 자체는 빠를 수 있어요. 그래도 그 첫 조각은 빌드 때 만들어 둔 게 아니라 요청이 와야 만들어지는 값이라서, 브라우저는 클릭한 뒤 그걸 받으러 무조건 한 번 서버에 갔다 와야 합니다. fallback도 그 응답 안에 들어 있으니 스켈레톤조차 그 전에는 못 그리고요.
[cacheComponents 없이, 동적 라우트]

클릭
  │
  ├─ RSC 요청 전송
  │     … 네트워크 왕복 (이 동안 이전 화면 그대로) …
  ├─ 응답 첫 조각 도착  → Suspense 바깥(PostHeader, PostBody)과 fallback 표시
  │     … 데이터 대기 …
  └─ 나머지 조각 도착   → LikeCount로 교체
바깥 부분이 정적이라 서버에서 0ms 만에 그릴 수 있어도, 브라우저는 그걸 받으러 한 번 갔다 와야 합니다. loading.js를 두면 그 경계까지는 미리 받아두니 스켈레톤이 바로 뜨지만, 페이지 안쪽에 직접 둔 <Suspense>는 그렇지 않습니다. Suspense가 데이터 대기 시간을 가려주는 건 맞지만, 라우트 이동의 첫 네트워크 왕복은 못 가립니다. 페이지 이동에 지연이 생기는 구간이 바로 여기입니다.
본론 3. 그럼 어떡하냐 — cacheComponents를 켭시다
라우트 단위 캐시의 한계
먼저 기본값부터 봅시다. 브라우저 Client Cache가 RSC 값을 얼마나 재사용할지는 experimental.staleTimes로 정합니다.
// next.config.ts
const nextConfig = {
  experimental: {
    staleTimes: {
      dynamic: 0,    // 기본값: 동적 라우트는 캐시하지 않음
      static: 300,   // 기본값: 정적 라우트는 5분
    },
  },
}
export default nextConfig
출처: Next.js staleTimes 문서. 아직 experimental 표시가 붙어 있습니다.
메모리 캐시이고, 셈은 라우트 단위입니다. 그리고 앞서 봤듯이 라우트 안에 Request-time API를 쓰는 서버 컴포넌트가 하나라도 있으면 Next.js는 그 라우트의 RSC 응답 뭉치 전체를 동적 렌더링으로 분류합니다.
솔직히 억울합니다. 하나의 라우트 안에서도 정적인 부분(Suspense fallback, Request-time API를 안 쓰는 서버 컴포넌트)과 동적인 부분을 따로 구분해주면 좋겠잖아요. 정적인 부분만이라도 prefetch와 캐시 대상이 되면, 페이지를 이동할 때 네트워크 요청 없이 보여줄 수 있는 것부터 바로 보여주고, Suspense 안의 자식은 그 뒤에 채우면 되니까요.
Partial Prerendering, 그리고 Cache Components
이 요구를 받아들인 게 Partial Prerendering(PPR)입니다. Next.js 14(2023년 10월)에서 실험 기능으로 처음 소개됐고, 발상은 이렇습니다. 라우트를 통째로 정적/동적으로 나누지 말고, Suspense 경계를 기준으로 바깥은 정적 셸, 안쪽은 동적 구멍으로 나누자는 겁니다.
Next.js 16 기준으로 PPR을 쓰려면 experimental.ppr 대신 cacheComponents를 켭니다. 이 옵션 하나가 PPR 동작과 'use cache' 지시어를 함께 활성화합니다.
// next.config.ts
const nextConfig = {
  cacheComponents: true,
}
export default nextConfig
출처: Next.js Cache Components 문서
켜면 세밀한 구분이 가능해집니다. 정적·동적을 따지는 단위가 라우트에서 Suspense 경계로 내려오거든요. 앞에서 본 코드 그대로, 말단 자식이 cookies()를 읽더라도 그 자식을 <Suspense>로 감싸두면, 바깥 껍데기는 정적 셸이 됩니다. 정적 셸은 prefetch 대상이고 Client Cache에도 남습니다. 클릭하면 셸과 fallback을 즉시 그리고, 동적인 부분만 서버에서 스트리밍으로 채웁니다.
[cacheComponents 켠 뒤, 같은 라우트]

뷰포트에 Link 등장
  └─ 정적 셸(레이아웃 + 페이지 껍데기 + Suspense fallback) prefetch → Client Cache

클릭
  ├─ 즉시: 캐시된 셸 + 스켈레톤 표시   ← 네트워크 왕복 없음
  ├─ 동시에: 동적 구멍만 RSC 요청
  └─ 응답 도착: 구멍만 교체
말단 자식 하나 때문에 페이지 전체가 네트워크 지연에 묶이던 문제가 여기서 풀립니다. 다만 대가가 있습니다. Cache Components를 켜면 Next.js가 비동기 작업을 암묵적으로 캐시하지 않기 때문에, 데이터를 읽는 컴포넌트마다 <Suspense>로 감싸거나 'use cache'를 붙이거나, 아니면 이 라우트는 기다리겠다고 명시하는 셋 중 하나를 고르게 됩니다. 안 고르면 빌드가 "Uncached data outside of Suspense" 같은 에러를 내면서 경계를 정하라고 요구합니다.
번외: Activity 때문에 생기는 버그
Cache Components를 켜면 한 가지가 더 따라옵니다. Next.js가 최근에 떠난 화면을 곧바로 unmount하지 않고 React <Activity>로 숨깁니다. DOM에 display: none을 주고 state와 실제 DOM 노드를 남겨두는 거죠. 돌아왔을 때 다시 그리는 비용을 줄이려는 목적입니다.
문제는 리소스를 재활용한다는 점입니다. DOM이 남아 있으니 <video>가 안 꺼질 수도 있고, 화면을 떠났다고 가정하고 짠 코드가 어긋날 수 있습니다. Effect는 cleanup되지만 DOM 자체가 계속 동작하는 요소는 따로 챙겨야 합니다. Next.js는 최근 화면을 최대 3개까지 이렇게 숨겨두고, 그보다 오래된 건 버립니다.
제 경험을 말씀드리면, 16.2 시절에 Cloudflare(OpenNext)에서 이 옵션을 켰다가 껐다가를 반복했습니다. 커밋 로그를 보니 하루에 켜고, 끄고, 다시 켜고, 다시 끈 날도 있더라고요. 미들웨어 비호환, 인증 세션 읽는 레이아웃의 Suspense 경계, Activity 전환이 어색한 문제가 차례로 튀어나왔습니다. 그때는 끄고 넘어갔고, 호스팅을 옮긴 뒤에야 다시 켜서 지금까지 쓰고 있습니다. 참고로 OpenNext 저장소에는 지금도 cacheComponents를 켜면 Suspense 안의 동적 콘텐츠가 스트리밍되지 않는다는 이슈가 열려 있습니다. 옵션 하나 켜는 일이 아니라는 뜻입니다.
16.3의 partialPrefetching
PPR로 셸과 구멍을 나눴는데도 아쉬운 부분이 남습니다. 라우트 캐시가 URL 별이라서 /posts/1, /posts/2가 같은 /posts/[id] 셸을 쓰는데도 각각 따로 prefetch하고 따로 캐시했거든요. 목록에 카드가 30개 있으면 같은 셸을 30번 받는 셈입니다.
16.3에서 추가된 partialPrefetching이 이걸 바꿉니다. 같은 라우트 패턴이 공유하는 부분을 App Shell로 인식해서 라우트당 한 번만 받고, 링크마다 다른 부분만 따로 다룹니다. 캐시 히트가 훨씬 쉬워집니다.
// next.config.ts (16.3)
const nextConfig = {
  cacheComponents: true,
  partialPrefetching: true,
}
export default nextConfig
16.2까지 16.3 partialPrefetching
/posts/1 셸 + 구멍 ─ 캐시 1 /posts/[id] App Shell ─ 캐시 1개
/posts/2 셸 + 구멍 ─ 캐시 2 ├─ /posts/1 구멍
/posts/3 셸 + 구멍 ─ 캐시 3 ├─ /posts/2 구멍
└─ /posts/3 구멍App Shell을 크게 만들려면 params를 페이지 맨 위에서 await하지 말고, 그 값이 필요한 자식 컴포넌트에서 읽는 편이 좋습니다. 위에서 읽으면 그 아래 트리 전체가 특정 URL에 묶여서 셸에서 빠집니다.
어렵죠. 저도 어렵습니다. 하지만 이걸 켜고 안 켜고의 차이가 목록에서 상세로 들어갈 때의 첫 반응 속도로 그대로 드러납니다.
여기까지 왔으면 Serwist로 한 발 더
정적 셸과 클라이언트 번들은 배포할 때만 바뀝니다. 그러면 브라우저 메모리에만 두지 말고 서비스 워커로 아예 디스크에 캐시해버리면 어떨까요. 새로고침해도, 탭을 닫았다 열어도 남으니까요.
Serwist는 Google의 Workbox 개발이 뜸해지면서 나온 포크입니다. @serwist/next 플러그인이 Next.js 빌드 산출물을 precache 목록으로 만들어주고, 런타임 캐싱 규칙은 sw.ts 한 파일에 선언합니다.
// next.config.ts
import withSerwistInit from '@serwist/next'

const withSerwist = withSerwistInit({
  swSrc: 'app/sw.ts',
  swDest: 'public/sw.js',
})

export default withSerwist({ /* 나머지 Next 설정 */ })
여기서 재밌는 부분이 있습니다. Cache Components를 켜면 Next.js가 정적 RSC 응답과 동적 RSC 응답을 헤더로 구분해줍니다. 이 구분을 서비스 워커에서 그대로 읽으면 됩니다. 제가 운영하는 서비스의 sw.ts에서 핵심만 뽑으면 이렇습니다.
// app/sw.ts (핵심만 발췌)
import { CacheFirst, NetworkFirst, Serwist, type SerwistPlugin } from 'serwist'

const STATIC_RSC_STALE_SECONDS = 365 * 24 * 60 * 60

// 정적 RSC만 골라서 캐시에 넣는다.
const cacheStaticRscResponse: SerwistPlugin = {
  async cacheWillUpdate({ request, response }) {
    if (response.status !== 200) return null
    if (!(response.headers.get('content-type') ?? '').startsWith('text/x-component')) return null

    // Cache Components의 라우트 트리 prefetch는 배포에 고정된 정적 셸이다.
    if (request.headers.get('next-router-segment-prefetch') === '/_tree') return response

    // Next.js가 응답에 붙여주는 stale time으로 정적/동적을 판별한다.
    const staleSeconds = Number(response.headers.get('x-nextjs-stale-time'))
    return staleSeconds >= STATIC_RSC_STALE_SECONDS ? response : null
  },
}

// 요청마다 달라지는 _rsc 쿼리는 캐시 키에서 뺀다.
const normalizeRscCacheKey: SerwistPlugin = {
  async cacheKeyWillBeUsed({ request }) {
    const url = new URL(request.url)
    url.searchParams.delete('_rsc')
    return new Request(url, request)
  },
}

const serwist = new Serwist({
  runtimeCaching: [
    // 클라이언트 번들·CSS·폰트: 배포 때만 바뀌니 CacheFirst
    {
      matcher: ({ url }) => url.pathname.startsWith('/_next/static/'),
      handler: new CacheFirst({ cacheName: 'assets' }),
    },
    // prefetch로 받는 RSC: 정적인 것만 플러그인이 걸러서 CacheFirst
    {
      matcher: ({ request }) =>
        request.headers.get('rsc') === '1' && request.headers.has('next-router-prefetch'),
      handler: new CacheFirst({
        cacheName: 'static-rsc',
        plugins: [normalizeRscCacheKey, cacheStaticRscResponse],
      }),
    },
    // 그 외 RSC(동적): 네트워크 우선, 실패 시 캐시
    {
      matcher: ({ request }) => request.headers.get('rsc') === '1',
      handler: new NetworkFirst({ cacheName: 'dynamic-rsc', networkTimeoutSeconds: 4 }),
    },
  ],
})

serwist.addEventListeners()
RSC 요청에는 rsc: 1 헤더가 붙고, prefetch 요청에는 next-router-prefetch 헤더가 붙습니다. 응답에는 x-nextjs-stale-time 헤더로 이 조각을 얼마나 재사용해도 되는지가 실려 옵니다. 이 값이 배포 수명만큼 길면 정적 셸이고, 그러면 CacheFirst로 디스크에 넣어도 안전합니다. next.config.ts의 staleTimes.static을 같은 값으로 맞춰두면 브라우저 메모리 캐시와 서비스 워커 캐시의 경계가 일치합니다.
배포 ID가 바뀌면 이전 캐시를 통째로 지우는 로직은 따로 필요합니다. 그건 activate 이벤트에서 캐시 이름에 버전을 넣어 비교하면 됩니다.
본론 4. 변태 같은 프론트엔드가 되어봅시다
여기부터는 Next.js 옵션보다 화면 설계 이야기에 가깝습니다.
라우트 이동은 대부분 목록에서 상세로
라우트 이동이 언제 일어나는지 생각해보면, 최상위 라우트 사이를 오가는 일은 생각보다 적습니다. 웹이면 헤더 메뉴, 앱이면 하단 탭 정도죠. 대부분의 이동은 목록에서 상세로 들어가는 겁니다. 피드에서 글로, 상품 목록에서 상품으로.
상세 화면은 왜 다 받을 때까지 기다리나
상세 화면은 값을 다 받을 때까지 suspend합니다. Suspense로 fallback을 보여주더라도, HTTP 응답 자체는 모든 값을 받아서 그릴 때까지 끝내지 않는 스트리밍 방식입니다(응답이 청크 단위로 어떻게 열려 있는지는 3편에서 봅니다). 이유는 봇입니다. 검색 봇이 빈 화면만 읽고 "값이 없네" 하고 넘어가지 않도록, 응답을 열어둔 채 화면 중간에만 로딩을 보여주고 봇은 완성된 HTML을 끝까지 받아가게 합니다.
새로고침이나 검색 유입처럼 처음 들어오는 사람에게는 이게 맞습니다.
그런데 사람은 목록을 거쳐서 온다
목록에는 이미 썸네일, 제목, 요약 같은 정보가 있습니다. 상세로 갈 때 이 정보를 먼저 보여주고, 목록에 없던 본문이나 댓글만 추가로 불러오면 전체 로딩 화면보다 훨씬 낫지 않을까요. 대신 새로고침하면 목록 정보가 메모리에 없으니 그때는 전체 로딩으로 그리고요.
정리하면 요구사항이 이렇습니다.
- 처음 들어오면(직접 진입, 새로고침, 봇): 서버에서 풀 정보를 스트리밍 SSR로 내려준다.
- 목록에서 들어오면: 목록의 요약을 즉시 보여주고, 나머지만 클라이언트에서 지연 로딩한다.
같은 URL인데 들어온 경로에 따라 다르게 동작하라는, 꽤 까다로운 요구사항입니다.
인터셉팅 라우트로 해결
Next.js의 Intercepting Routes가 정확히 이 구분을 해줍니다. 앱 안에서 소프트 내비게이션으로 이동할 때는 (.) 폴더의 페이지가 잡히고, 직접 진입이나 새로고침에는 원래 페이지가 뜹니다.
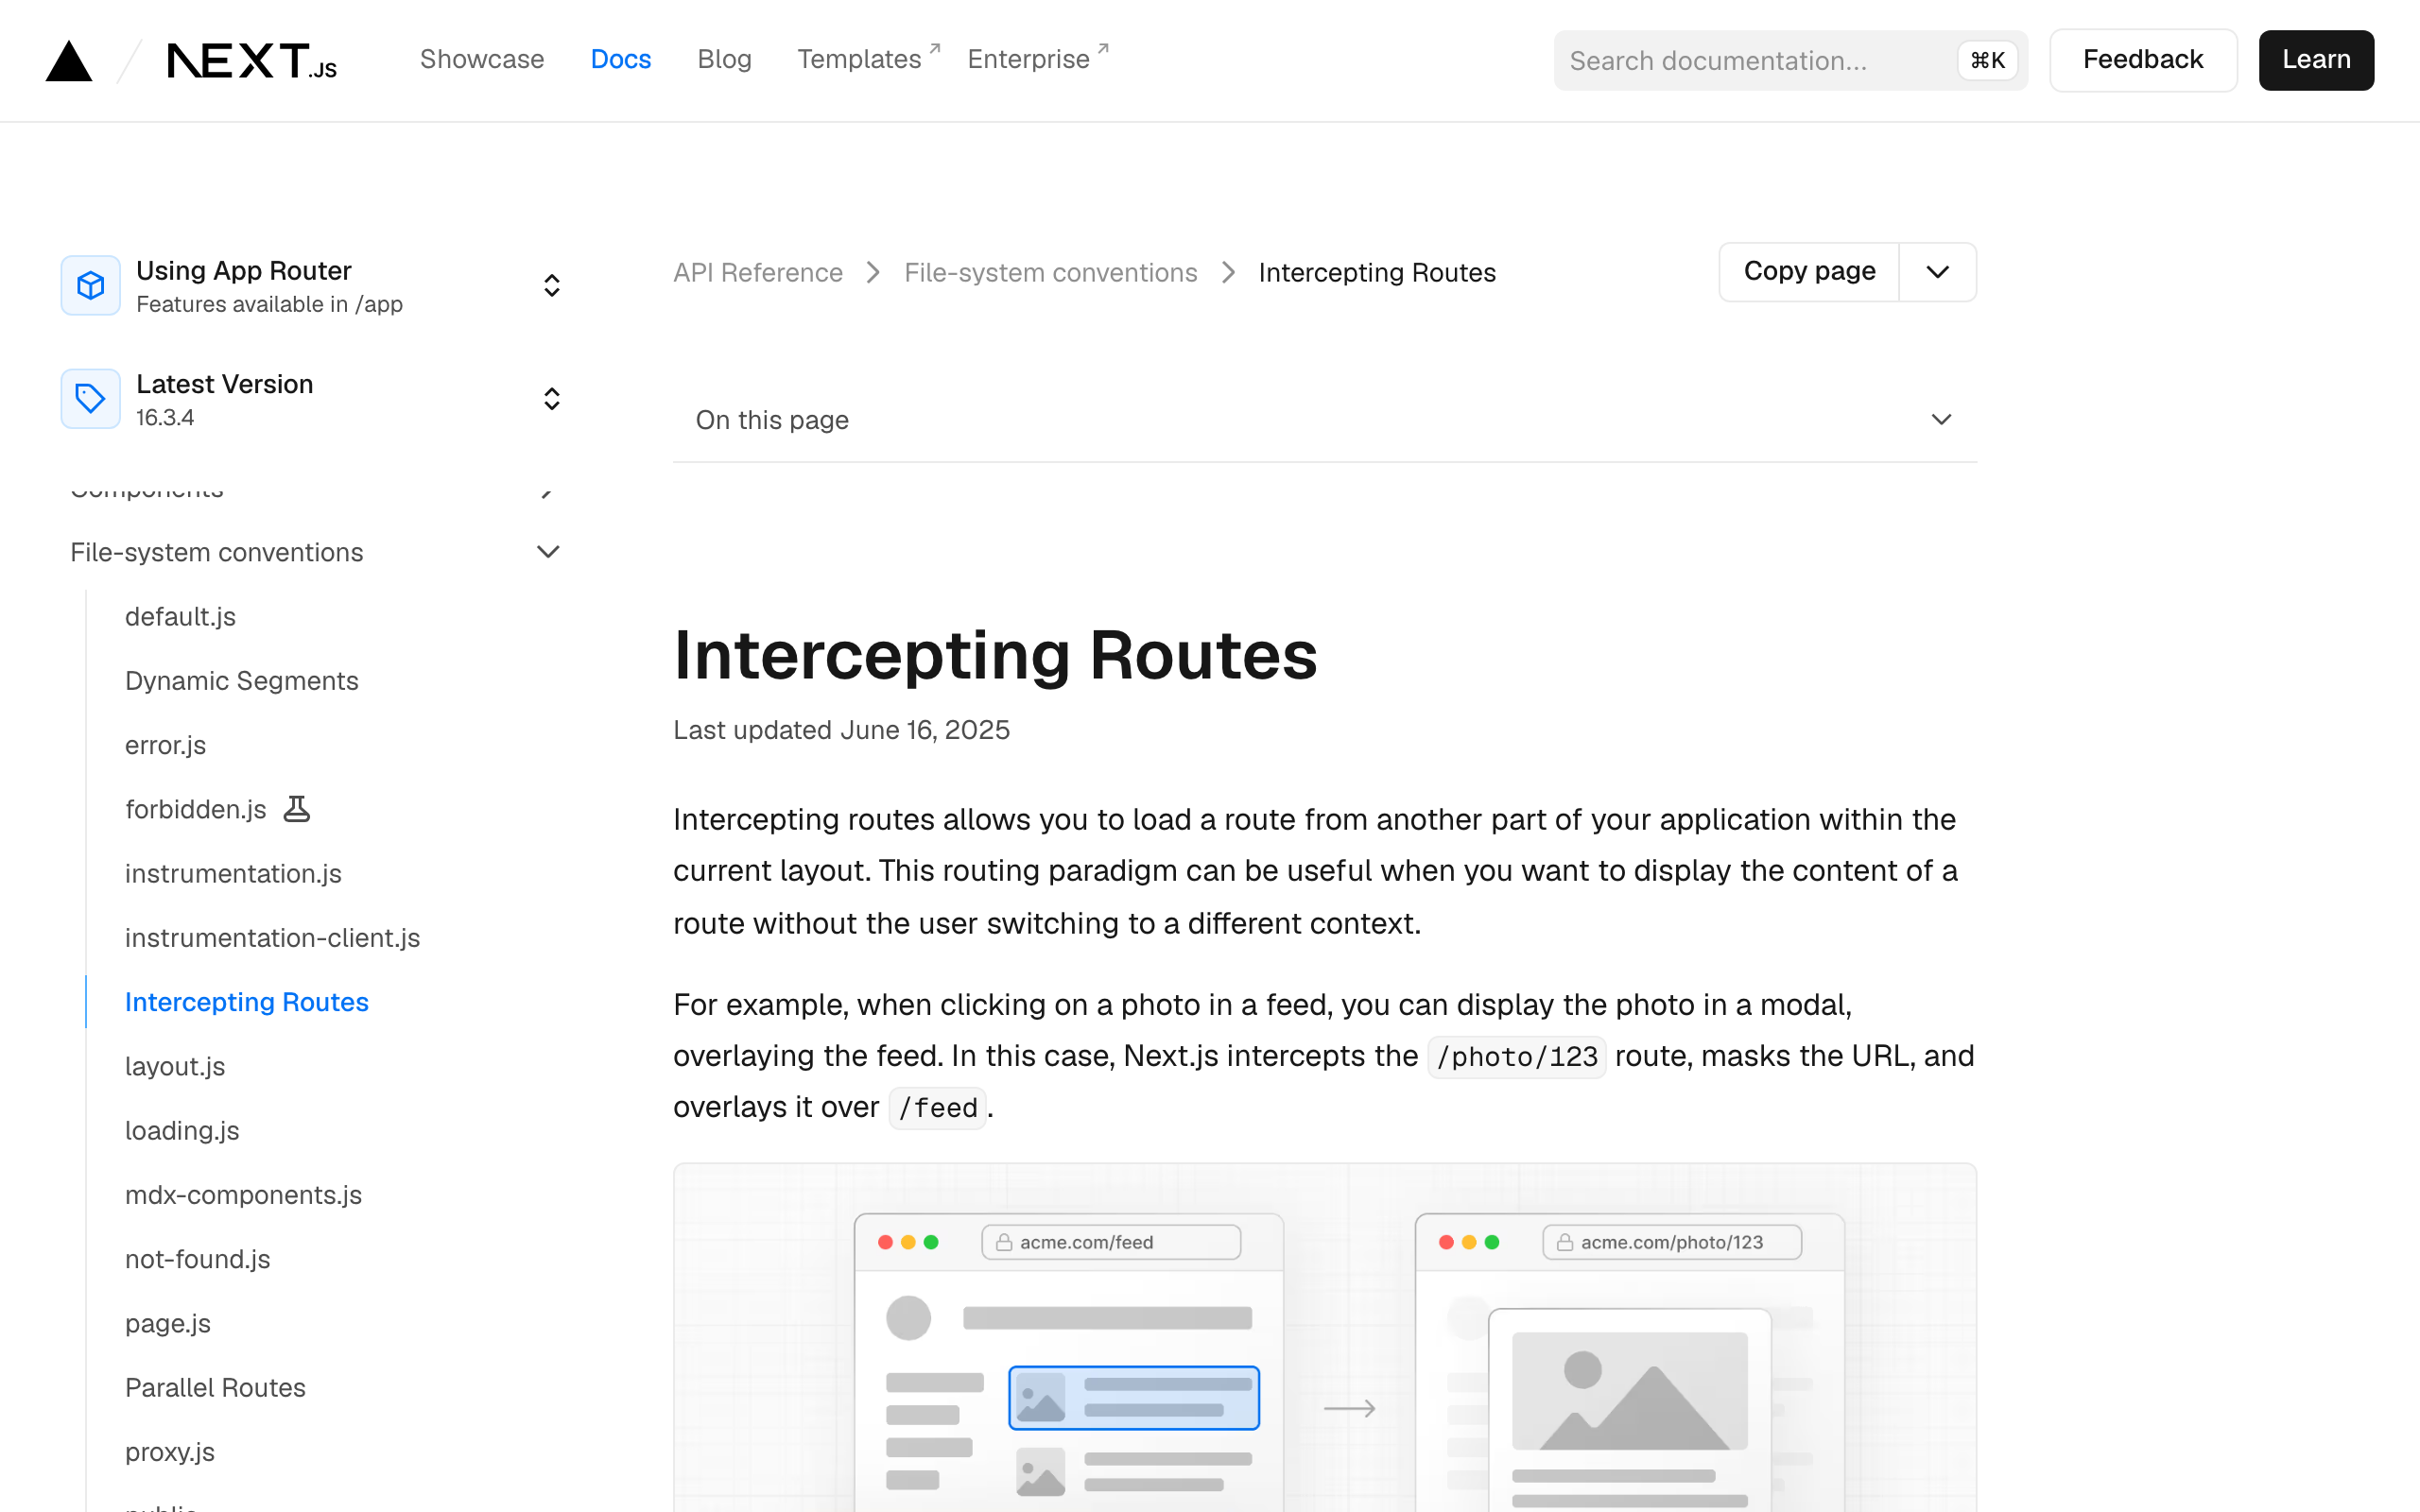
출처: Next.js Intercepting Routes 문서
제가 운영하는 서비스의 쇼케이스 상세는 이런 구조입니다.
app/(app)/
├─ (.)showcase/[id]/page.tsx     ← 앱 안에서 이동할 때 (인터셉트)
│     메타데이터 없음, 서버 조회 없음
│     목록 store에서 요약을 꺼내 즉시 렌더 → 본문만 클라이언트 로딩
│
└─ /showcase/[id]/page.tsx   ← 직접 진입·새로고침·봇
      generateMetadata로 OG·canonical
      Suspense 안에서 서버 조회 → 풀 상세 스트리밍
인터셉트 쪽 페이지는 이렇게 단순합니다.
// app/(app)/(.)showcase/[id]/page.tsx
export default function InterceptedShowcaseDetail() {
  return (
    <DetailScreen fallback="/showcase">
      <InterceptedShowcaseDetailSection />
    </DetailScreen>
  )
}
// 인터셉트 섹션 (클라이언트 컴포넌트)
'use client'
export function ShowcaseInterceptedDetailSection() {
const { id } = useParams<{ id: string }>()
return <ShowcaseDetailPageSection id={id} />
}정식 페이지는 서버에서 메타데이터를 만들고 Suspense 안에서 데이터를 읽습니다.
// app/(app)/(detail)/showcase/[id]/page.tsx
export async function generateMetadata({ params }) {
  const { id } = await params
  const show = await projectShowcase.findCacheable(id)
  return buildMetadata({ title: show.title, ... })
}

export default function Page({ params }) {
  return (
    <DetailScreen fallback="/showcase">
      <Suspense fallback={<ShowcaseDetailContentFallback />}>
        <ShowcaseDetailLoader params={params} />
      </Suspense>
    </DetailScreen>
  )
}
상태 쪽 흐름은 라이브러리마다 다르니 그림으로만 정리하겠습니다.
목록에서 클릭 (인터셉트 라우트)
  store.showcases 에 같은 id 요약이 있나?
    ├─ 있음 → seed로 삼아 헤더·썸네일·작성자 즉시 렌더
    │          본문만 스켈레톤 → 상세 API 응답 오면 본문 교체
    └─ 없음 → 전체 스켈레톤 → 상세 API 응답 오면 전체 렌더

직접 진입 (정식 라우트)
  서버가 Suspense 안에서 풀 상세 조회 → 스트리밍 SSR
  봇은 완성된 HTML을 받고, 사람은 fallback 뒤에 본문을 본다
인터셉트 라우트에서 서버 조회를 아예 하지 않는 게 포인트입니다. 서버 조회가 있으면 그 응답을 기다리느라 이동이 막히니까요. 목록의 요약이 곧 첫 화면이고, 부족한 부분만 클라이언트가 채웁니다.
결론: Next.js 사랑합니다
여기까지 읽으셨으면 처음의 체크리스트로 돌아가봐도 좋겠습니다. prefetch가 무엇을 받는지, 라우트가 언제 동적 렌더링으로 넘어가는지, staleTimes와 cacheComponents와 partialPrefetching이 각각 어떤 시간을 줄이는지가 하나의 흐름으로 이어졌으면 합니다.
한 줄로 줄이면 이렇습니다. RSC가 하나라도 있는 라우트에는 구멍이 생기고, 그 구멍을 클릭 전에 채워두느냐가 페이지 이동 속도를 정합니다. 그리고 cacheComponents를 켜지 않았다면, 동적인 서버 컴포넌트가 하나라도 있는 순간 Suspense로 감쌌더라도 그 라우트 전체를 클릭 전에 채울 수 없습니다.
Next.js는 요긴하게 잘 쓰고 있습니다. 이 글의 내용은 전부 제가 운영하는 컴윗에 그대로 적용돼 있고요. 컴윗은 클로드코드나 코덱스만 있으면 호스팅, DB, 파일 저장, 로그인, 도메인까지 나머지 인프라를 다 갖춰둔 서비스입니다. 자칭 "한국의 Vercel"인데, 인프라만 주는 게 아니라 프로젝트를 만들 때 기술 스택까지 정해서 줍니다. 여기 나온 cacheComponents, partialPrefetching, Serwist, 인터셉팅 라우트 구조가 템플릿에 처음부터 들어가 있습니다.
컴윗이 신경 쓰는 건 견고성입니다. 코드가 커져도 에이전트가 일관된 산출물을 내도록 자체 라이브러리와 린트 규칙으로 가이드를 깔아뒀습니다. 하네스 엔지니어링이 실제 서비스에서 어떻게 생겼는지 궁금하시면 한 번 살펴봐 주세요.
참고 자료
- Next.js 16.3
- Next.js: Ensuring instant navigations
- Next.js: Prefetching
- Next.js: Glossary — Dynamic rendering
- Next.js: Dynamic Route Segments
- Next.js: Adopting Partial Prefetching
- Next.js:
<Link>prefetch - Next.js:
staleTimes - Next.js: Cache Components · Caching and Revalidating (Previous Model)
- Next.js: How Next.js preserves UI state with Activity
- Next.js: Intercepting Routes
- React: Introducing Zero-Bundle-Size React Server Components (2020-12)
- React 19
- React:
<Activity> - Serwist · Serwist: Next.js 시작하기
- OpenNext Cloudflare: cacheComponents 이슈 #1225
- Next.js: CDN caching (RSC 요청 헤더)
- web.dev: RAIL 모델 (16ms 프레임 예산)
- 스크린샷: 각 공식 문서 페이지, 2026-09-06 캡처