Suspense를 아시나요
리액트 Suspense를 아시나요? "로딩 상태를 선언적으로 보여주는 컴포넌트"라고 답했다면 절반만 맞습니다. 면접에서 이렇게 답하면 아마 다음 질문이 따라올 겁니다. "그럼 서버에서 스트리밍할 때 Suspense는 무슨 일을 하나요?" 그 절반만 알고 쓰면 Suspense를 겹칠수록 페이지가 느려지고, 왜 느려지는지 설명하지 못합니다.
2편에서 잠깐 언급한 나머지 절반부터 짚고 가겠습니다. 스트리밍 SSR에서 Suspense는 HTTP 응답을 어디서 나눌지 정하는 경계입니다. 응답을 끝내는 경계가 아닙니다.
fallback을 보냈다고 응답이 끝나는 게 아니다
흔한 오해가 이겁니다. "Suspense가 걸리면 서버가 로딩 화면이 담긴 HTML을 200으로 보내고 응답을 끝낸다. 그러니 봇은 로딩 화면만 본다." 그렇지 않습니다.
Next.js 서버는 페이지를 청크 단위로 흘려보냅니다(chunked transfer encoding). Suspense 안의 컴포넌트가 데이터를 기다리면 서버는 fallback이 담긴 첫 청크를 보내고, 응답 본문을 열어둔 채 기다립니다. 데이터가 준비되면 같은 응답 안에 완성된 HTML과 <template> 자리를 교체하는 인라인 스크립트를 이어서 보냅니다. 마지막 경계가 풀리고 나서야 길이 0인 종료 청크를 보내고, 그때 응답이 끝납니다.
React 문서의 renderToPipeableStream 설명이 그대로입니다.
React will send the HTML for the loading fallback (
PostsGlimmer) first, and then, whenPostsfinishes loading its data, React will send the remaining HTML along with an inline<script>tag that replaces the loading fallback with that HTML.
같은 문서에 콜백이 두 개 있습니다. onShellReady는 셸(fallback 포함)이 준비됐을 때 불리고, onAllReady는 "셸과 추가 콘텐츠를 포함한 모든 렌더링이 끝났을 때" 불립니다. 그리고 크롤러에는 onShellReady 대신 onAllReady에서 응답을 시작하라고 안내합니다. 스트림이 셸에서 끝나는 게 아니라 모든 콘텐츠까지 이어진다는 뜻이죠. 스트림을 중간에 끊는 방법은 abort()를 직접 부르는 것뿐이고, 그때는 남은 fallback을 그대로 HTML로 내보냅니다.
Next.js Streaming 가이드에 실측 예시가 있습니다. Suspense 경계가 두 개인 페이지를 스크립트로 읽으면 이렇게 옵니다.
HTTP 응답 하나 (Transfer-Encoding: chunked)

chunk 0 (+0ms)     셸: <head>, CSS, 내비, 스켈레톤,
                   <template id="B:0"> <template id="B:1"> 자리표시자
                   ← 상태 코드 200과 헤더는 여기서 이미 나갔다
chunk 1 (+170ms)   하이드레이션용 RSC payload (self.__next_f.push)
chunk 2 (+1000ms)  <div hidden id="S:0"> 날씨 위젯 </div> + B:0 교체 스크립트
chunk 3 (+3000ms)  <div hidden id="S:1"> 대시보드 </div> + B:1 교체 스크립트
0\r\n\r\n          종료 청크. 이제야 응답이 끝난다
상태 코드는 첫 청크와 함께 나갑니다. 그래서 스트리밍 도중에 notFound()를 만나도 404로 못 바꾸고 <meta name="robots" content="noindex">를 심는 겁니다. 하지만 응답 본문은 3초 뒤까지 열려 있습니다. HTTP 클라이언트는 종료 청크가 올 때까지 본문을 읽으니, 응답을 끝까지 읽는 봇은 자연히 완성된 HTML을 받습니다.
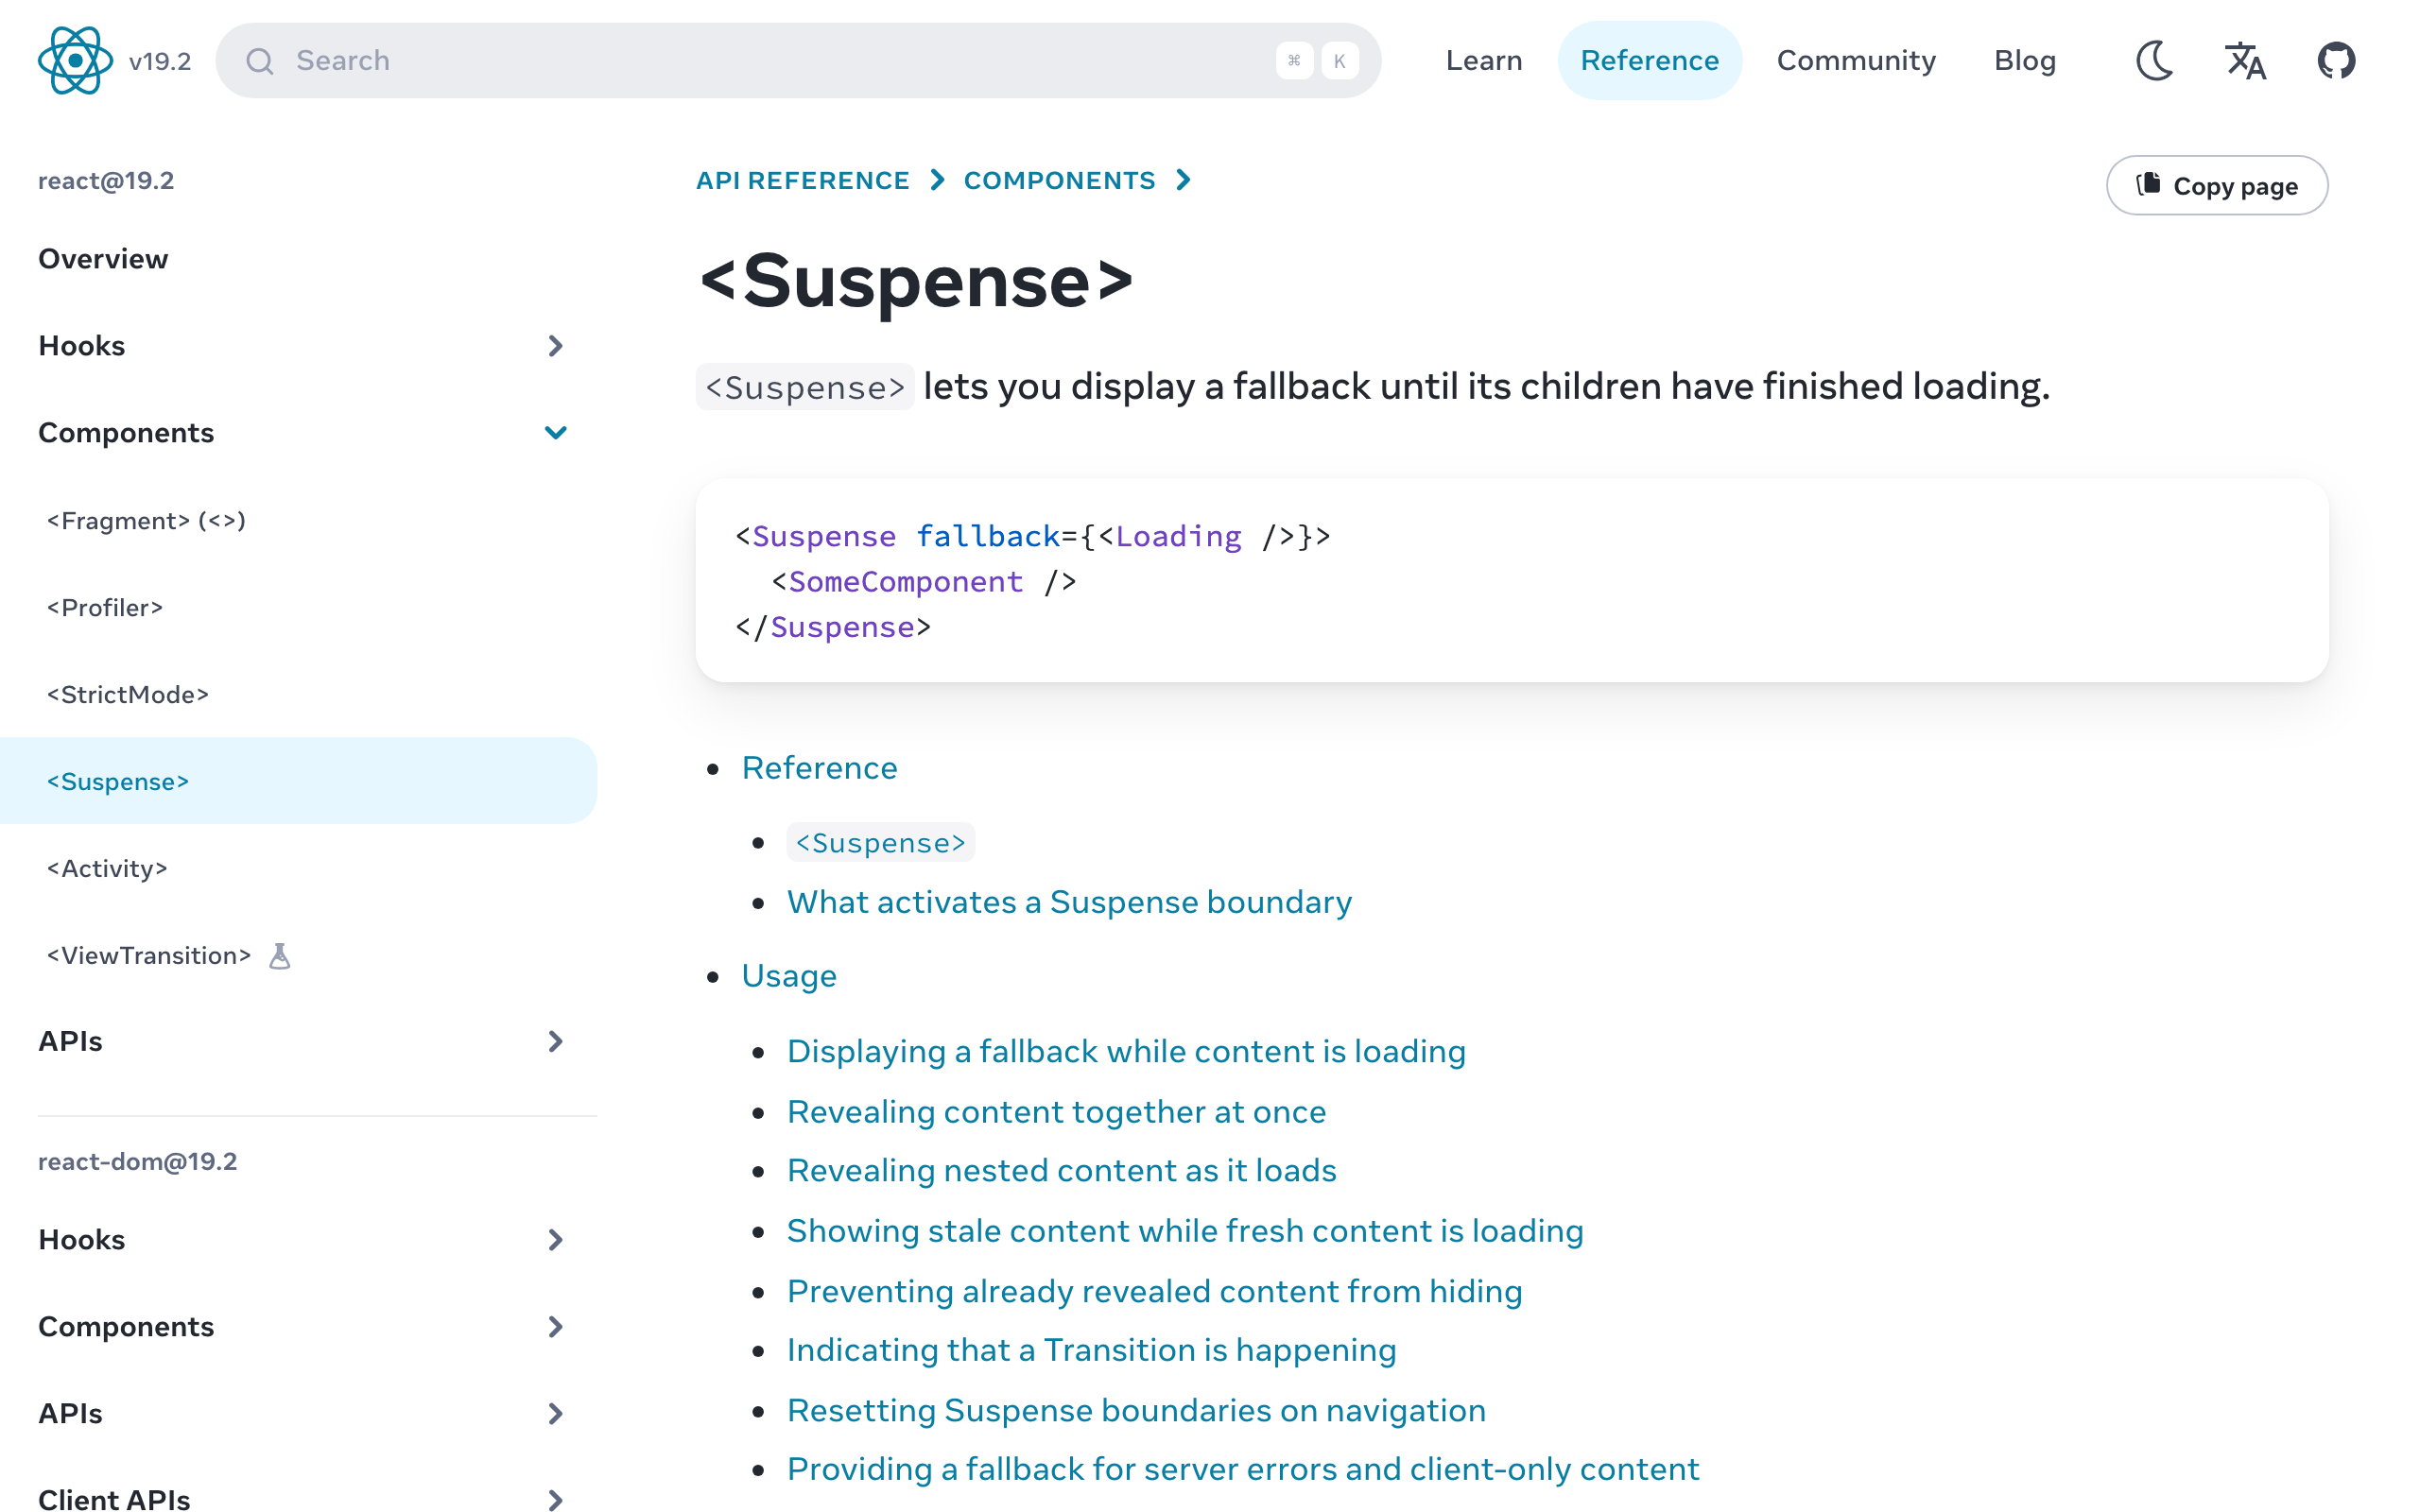
출처: React: <Suspense>. "React sends the shell with the fallback first, then streams in each boundary's HTML and swaps out its fallback as that content arrives."
useQuery는 응답이 로딩 상태로 끝난다
반대로 useQuery처럼 마운트 이후에 클라이언트에서 페칭하면, 서버는 로딩 상태의 HTML을 만들고 곧바로 종료 청크를 보냅니다. 이번엔 응답이 정말로 끝난 겁니다. 데이터는 봇이 JavaScript를 실행해야 나오고, 구글은 이런 페이지를 렌더링 큐에 넣었다가 나중에 헤드리스 크롬으로 돌립니다. 몇 초일 수도 있고 더 오래 걸릴 수도 있다고 공식 문서에 적혀 있습니다.
Suspense + 서버 페칭                    useQuery (클라이언트 페칭)

200 + 셸(fallback)                      200 + 셸(로딩 상태)
… 응답 열림, 데이터 대기 …              0\r\n\r\n  ← 응답 끝
콘텐츠 청크 + 교체 스크립트             봇: JS 실행 → 렌더링 큐 → 나중에 데이터
0\r\n\r\n  ← 응답 끝
봇: 응답 끝까지 읽으면 완성된 HTML
사용자 눈에는 같은 로딩 화면이지만 봇에게는 다릅니다.
정리하면 Suspense는 사용자에게는 로딩 화면을 먼저 주고, 응답은 데이터가 풀릴 때까지 열어두는 경계입니다. 그런데 이 경계를 잘못 두면 속도 문제가 생깁니다. 이 글을 읽고 나면 "Suspense를 중첩했는데 왜 더 느려졌나요?"에 답할 수 있게 됩니다.
본론 1. Suspense 워터폴과 React.cache
자식은 부모가 풀려야 시작한다
Suspense 안의 컴포넌트가 데이터를 페칭하고, 그 자식도 또 데이터를 페칭한다고 해봅시다.
// app/posts/[id]/page.tsx
export default function Page({ params }) {
  return (
    <Suspense fallback={<PostSkeleton />}>
      <Post params={params} />
    </Suspense>
  )
}

async function Post({ params }) {
  const { id } = await params
  const post = await getPost(id)          // 요청 1
  return (
    <article>
      <h1>{post.title}</h1>
      <Suspense fallback={<CommentsSkeleton />}>
        <Comments postId={post.id} />     {/* 여기 렌더는 post가 온 뒤에 시작 */}
      </Suspense>
    </article>
  )
}

async function Comments({ postId }) {
  const comments = await getComments(postId)   // 요청 2: 요청 1이 끝나야 시작
  return <ul>{comments.map(...)}</ul>
}Comments는 Post가 렌더를 마쳐야 트리에 등장합니다. 그러니까 getComments는 getPost가 끝나기 전에는 시작조차 못 합니다. 이걸 워터폴이라고 부릅니다.
워터폴

getPost      ████████████ 300ms
getComments               ████████████ 300ms
                                       ▲ 총 600ms
Next.js 문서는 이걸 순차 페칭(sequential data fetching)이라고 부르고, "요청은 fetch를 호출하는 순간 시작된다"는 점을 이용해서 병렬로 바꾸라고 합니다. Promise.all로 묶는 방법은 잘 알려져 있죠. 그런데 위 예시는 Promise.all로 묶기 애매합니다. 댓글은 Comments 컴포넌트가 소유하는 데이터이고, 부모가 그걸 받아서 props로 내려주기 시작하면 컴포넌트 구조가 데이터 구조에 끌려갑니다.
부모에서 미리 부르고, 자식에서 꺼내 쓴다
해결 방법은 부모에서 await 없이 미리 호출해두는 겁니다. 그러면 요청은 부모 렌더 시점에 시작되고, 자식이 렌더될 때는 이미 진행 중인 Promise를 가져다 씁니다. 이게 되려면 같은 인자로 부른 함수가 같은 Promise를 돌려줘야 하는데, 그 역할을 React.cache가 합니다.
import { cache } from 'react'

// 같은 요청 안에서 같은 인자로 부르면 같은 Promise를 돌려준다
const getPost = cache(async (id: string) => db.post.find(id))
const getComments = cache(async (postId: string) => db.comment.findByPost(postId))

async function Post({ params }) {
  const { id } = await params
  void getComments(id)                 // 미리 시작만 해둔다. await 하지 않는다.
  const post = await getPost(id)
  return (
    <article>
      <h1>{post.title}</h1>
      <Suspense fallback={<CommentsSkeleton />}>
        <Comments postId={post.id} />
      </Suspense>
    </article>
  )
}

async function Comments({ postId }) {
  const comments = await getComments(postId)   // 이미 진행 중인 Promise를 그대로 받는다
  return <ul>{comments.map(...)}</ul>
}
React.cache로 미리 호출
getPost ████████████ 300ms
getComments ████████████ 300ms
▲ 총 300ms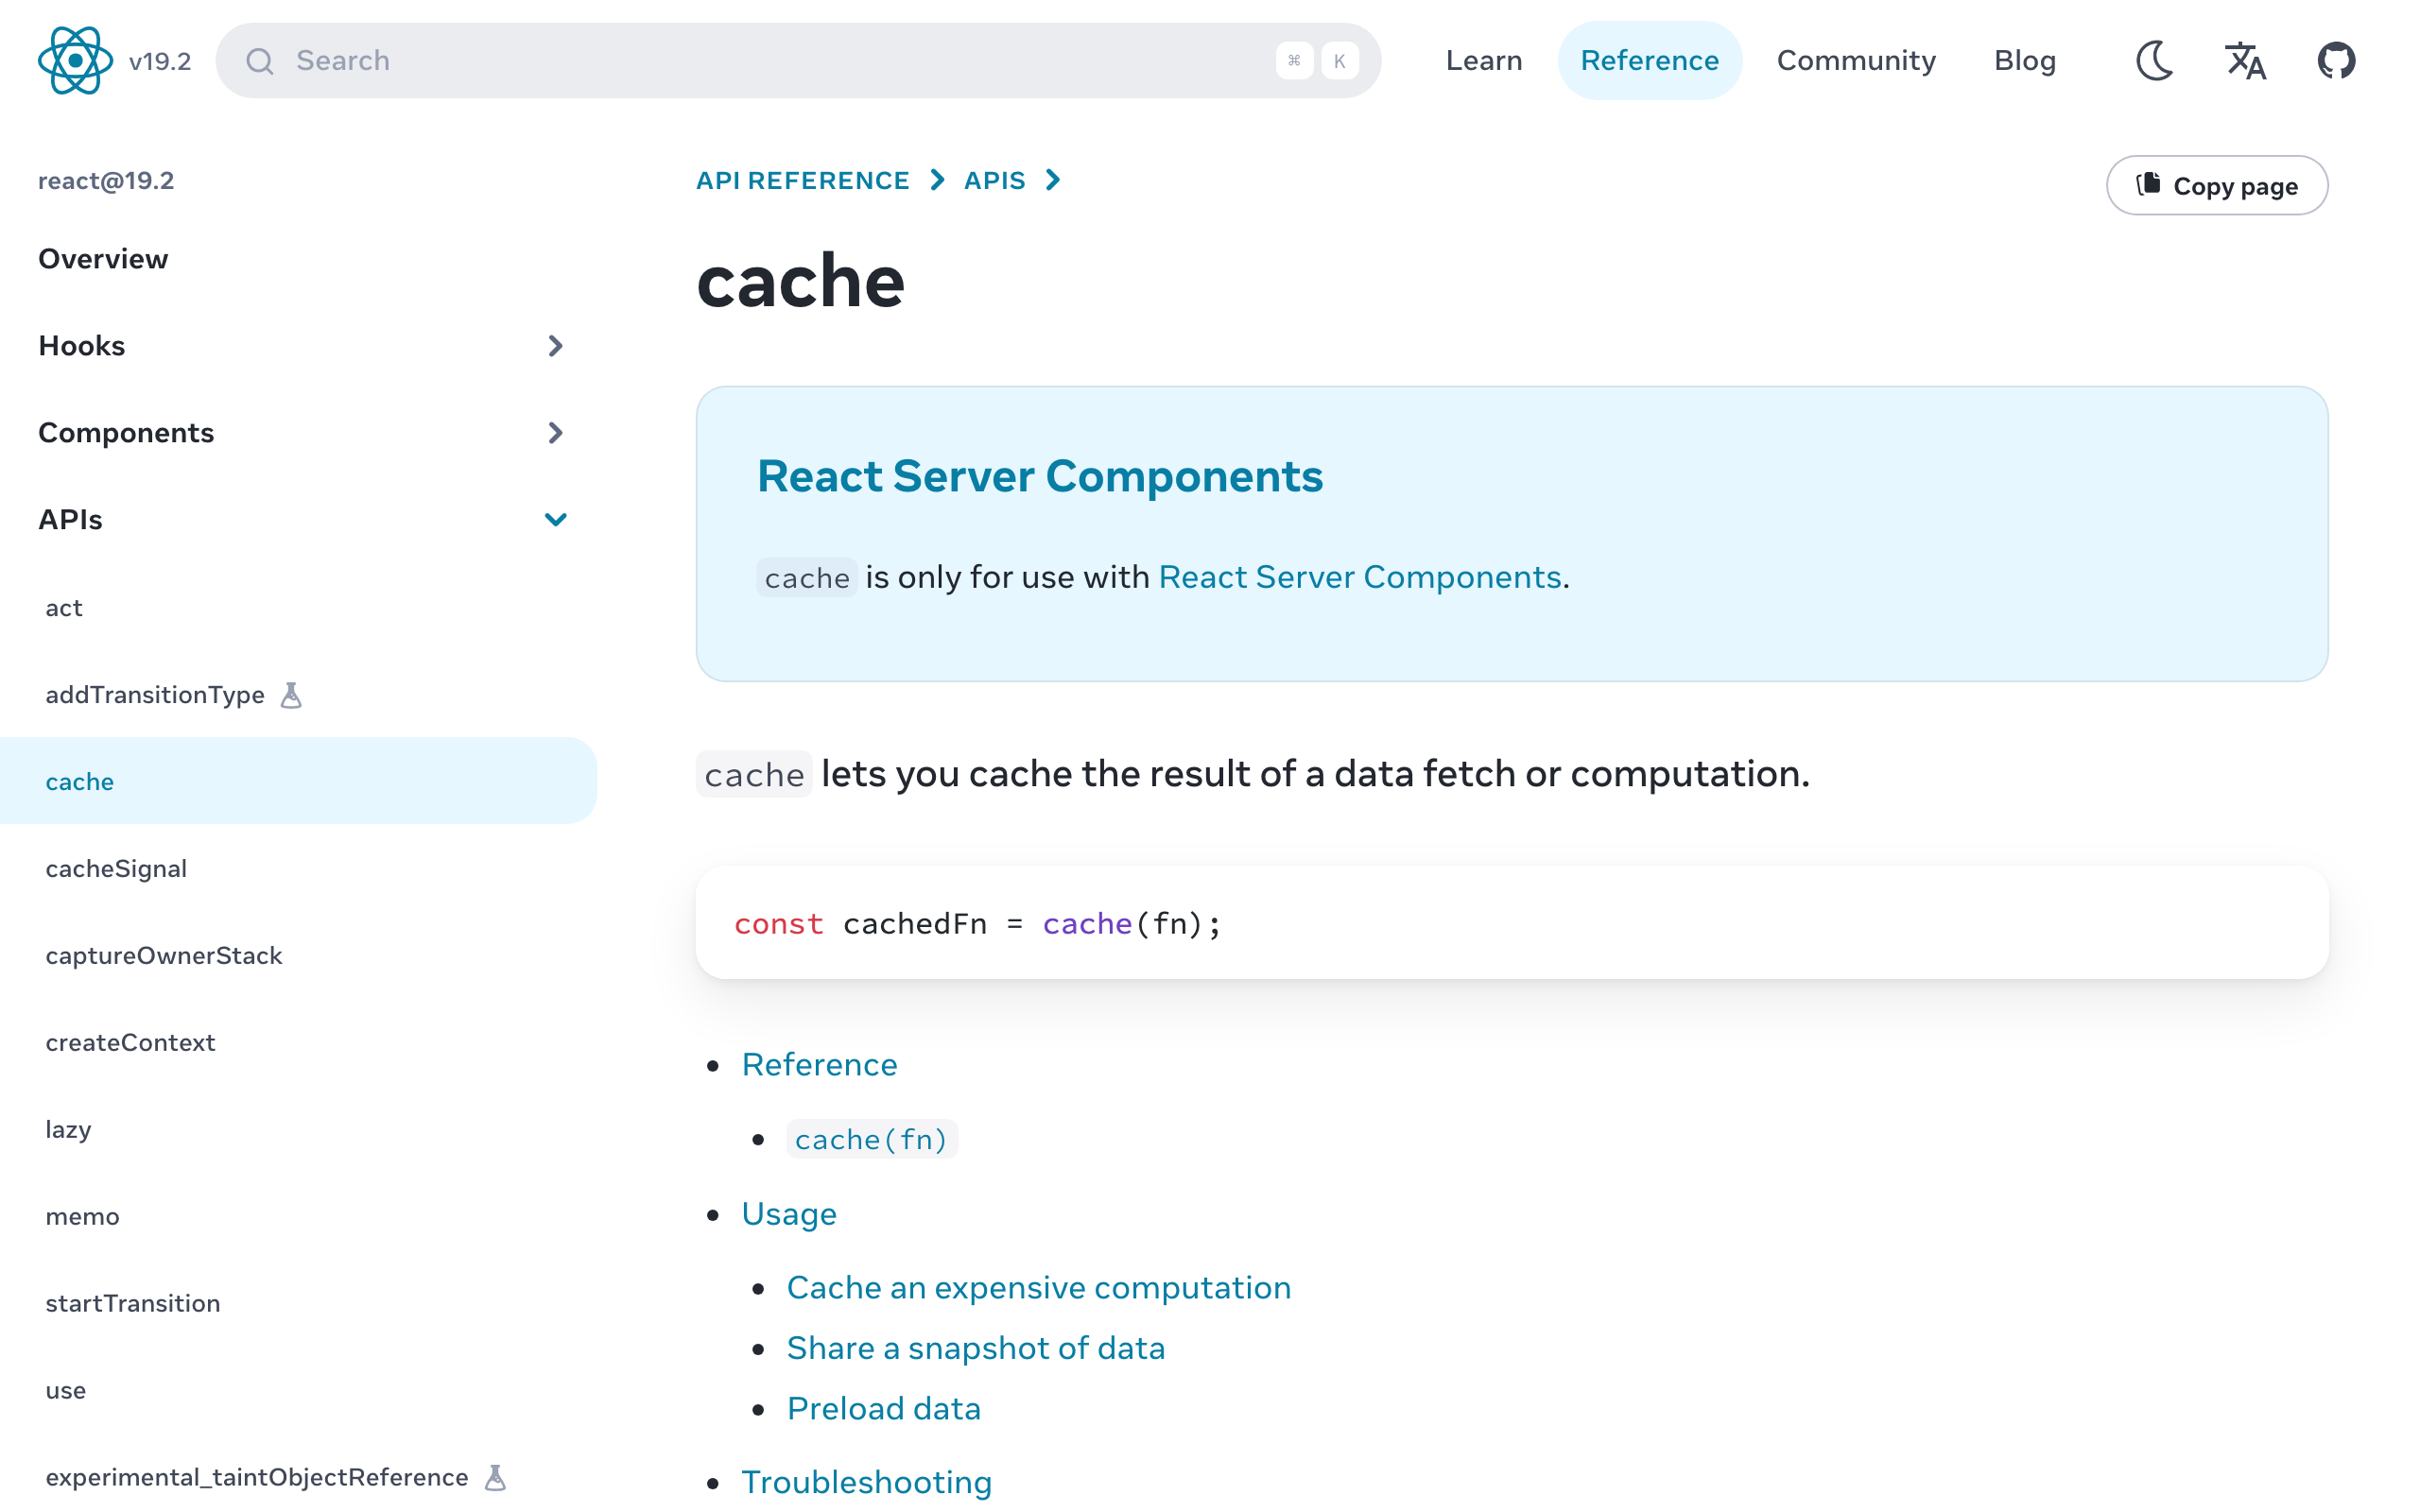
출처: React: cache. 문서의 "Preload data" 예제가 정확히 이 패턴입니다.
Next.js 문서에는 이걸 preload 함수로 정리한 패턴이 있습니다.
// lib/post.ts
import { cache } from 'react'
import 'server-only'

export const getPost = cache(async (id: string) => db.post.find(id))

export const preload = (id: string) => {
  void getPost(id)
}React.cache를 쓸 때 알아둘 점이 세 가지 있습니다.
- 서버 컴포넌트 전용입니다. 클라이언트에서는 동작하지 않습니다.
- 요청마다 캐시가 초기화됩니다. 요청 사이에 값을 공유하지 않으니 사용자 데이터가 섞일 걱정은 없습니다.
cache()를 호출할 때마다 별도의 캐시가 생깁니다. 같은 함수를 두 번cache()로 감싸면 서로 캐시를 공유하지 않습니다. 모듈 최상위에서 한 번만 감싸세요.
참고로 fetch는 Next.js가 알아서 메모이제이션합니다. 같은 URL과 옵션으로 GET 요청을 한 렌더 패스 안에서 여러 번 하면 한 번만 나갑니다. React.cache가 필요한 건 ORM이나 DB 클라이언트처럼 fetch를 안 거치는 경우입니다.
본론 2. TanStack Query와 HydrationBoundary
리소스를 props로만 넘기지 않는다면
Suspense 이야기가 나온 김에 TanStack의 Suspense Query 이야기를 해보겠습니다. 실무에서 리소스를 매번 props로 내려주진 않습니다. 대개 QueryClient 같은 글로벌 캐시에 넣고, 필요한 컴포넌트가 키로 꺼내 쓰죠. 그러면 서버에서 페칭한 값을 리렌더링 없이 클라이언트의 글로벌 캐시에 넣어줘야 합니다.
TanStack Query의 공식 패턴은 HydrationBoundary입니다.
// app/get-query-client.ts
import { QueryClient, environmentManager } from '@tanstack/react-query'

function makeQueryClient() {
  return new QueryClient({ defaultOptions: { queries: { staleTime: 60 * 1000 } } })
}

let browserQueryClient: QueryClient | undefined
export function getQueryClient() {
  if (environmentManager.isServer()) return makeQueryClient()   // 서버: 요청마다 새로
  return (browserQueryClient ??= makeQueryClient())             // 브라우저: 하나만
}
// app/posts/page.tsx (서버 컴포넌트)
import { dehydrate, HydrationBoundary } from '@tanstack/react-query'
import { getQueryClient } from './get-query-client'
import Posts from './posts'
export default function PostsPage() {
const queryClient = getQueryClient()
void queryClient.prefetchQuery({ queryKey: ['posts'], queryFn: getPosts }) // await 없이
return (
<HydrationBoundary state={dehydrate(queryClient)}>
<Posts />
</HydrationBoundary>
)
}// app/posts/posts.tsx (클라이언트 컴포넌트)
'use client'
import { useSuspenseQuery } from '@tanstack/react-query'
export default function Posts() {
const { data } = useSuspenseQuery({ queryKey: ['posts'], queryFn: getPosts })
return <ul>{data.map(...)}</ul>
}
출처: TanStack Query: Advanced Server Rendering. 최신 문서는 prefetchQuery 대신 통합 API인 queryClient.query()를 씁니다.
왜 굳이 컴포넌트인가
여기서 이상한 점이 하나 있습니다. HydrationBoundary는 UI를 그리지 않습니다. 그냥 캐시에 값을 넣는 일만 하는데, 왜 컴포넌트로 값을 받아야 할까요. 더 나은 방법이 없을까요.
답은 RSC의 구조에 있습니다. 1편의 구멍(hole) 그림을 다시 떠올려보세요. 서버 컴포넌트가 렌더한 결과는 RSC Payload로 직렬화되어 HTML 안에 실려 옵니다. 그리고 서버 컴포넌트에서 클라이언트 컴포넌트로 값을 넘기는 유일한 통로가 props입니다. 그 props도 RSC Payload에 같이 직렬화되죠.
서버                                    HTML에 실리는 RSC Payload
┌─────────────────────────┐             ┌──────────────────────────────┐
│ <PostsPage>  (서버)     │             │ 구멍: <HydrationBoundary      │
│   prefetchQuery(...)    │  ───────▶   │         state={ queries: [   │
│   <HydrationBoundary    │             │           { key: ['posts'],  │
│      state={dehydrate}> │             │             data: [...] } ] }│
│     <Posts/>  (클라)    │             │       >                       │
└─────────────────────────┘             └──────────────────────────────┘
                                                      │
브라우저                                              ▼
  HydrationBoundary 렌더 중 → hydrate(queryClient, state)
  → <Posts>의 useSuspenseQuery가 캐시에서 바로 읽음
그래서 클라이언트 컴포넌트인 HydrationBoundary가 props로 dehydrate된 상태를 받고, 렌더 단계에서 캐시에 넣습니다. useEffect가 아니라 렌더 중에 하는 이유는 자식 <Posts>가 렌더되기 전에 캐시를 채워둬야 하기 때문입니다. 소스 코드 주석에도 "hydration은 자식이 렌더되기 전에 일어나야 한다"고 적혀 있습니다.
안 하면 어떻게 되나
이 과정을 빼먹으면 두 가지 중 하나가 생깁니다.
서버에서 prefetch 없이 useSuspenseQuery만 쓴 경우

서버   : useSuspenseQuery → 서버에서 페칭 → 완성된 HTML 렌더
클라   : 캐시가 비어 있음 → useSuspenseQuery가 다시 suspend → fallback 렌더
결과   : 서버 HTML(콘텐츠) ≠ 클라 첫 렌더(fallback) → 하이드레이션 불일치 에러
         그리고 같은 데이터를 서버와 클라이언트가 한 번씩, 두 번 요청
TanStack 문서도 같은 경고를 합니다. useSuspenseQuery를 쓰면서 prefetch를 빼먹으면 "데이터가 서버에서 페칭되지만 클라이언트로 hydrate되지 않아 다시 페칭하고, 마크업 하이드레이션 불일치가 생긴다"고요. 그래서 서버 컴포넌트에서 prefetch하고 HydrationBoundary로 넘기는 구조가 나온 겁니다.
본론 3. 호출처가 두 군데가 되는 문제
소유권이 갈라진다
그런데 이 패턴에는 찜찜한 부분이 있습니다. 원래 useSuspenseQuery만 쓰면 리소스가 필요한 컴포넌트가 소유권을 갖고 직접 요청합니다. 렌더 중에 호출하고, Promise면 throw해서 Suspense에 걸리게 하면 되니까요.
그런데 하이드레이션 때문에 부모 서버 컴포넌트에서 같은 키로 한 번 더 호출하게 됩니다. API 호출처가 두 군데가 되는 거죠. 키 하나라도 어긋나면 서버에서 넣은 캐시를 클라이언트가 못 찾고, 위에서 본 이중 요청과 불일치가 그대로 재현됩니다. 부모에서 키를 넣어주는 과정이 없으면 망하는 구조입니다.
experimental: prefetch 없이 스트리밍 하이드레이션
TanStack이 이 문제를 풀려고 실험적으로 내놓은 게 @tanstack/react-query-next-experimental의 ReactQueryStreamedHydration입니다. 서버 컴포넌트에서 prefetch를 하지 않고, 클라이언트 컴포넌트에서 useSuspenseQuery만 호출해도 서버에서 페칭한 결과가 Suspense 경계가 풀릴 때마다 클라이언트로 스트리밍됩니다.
// app/providers.tsx
'use client'
import { QueryClientProvider } from '@tanstack/react-query'
import { ReactQueryStreamedHydration } from '@tanstack/react-query-next-experimental'
import { getQueryClient } from './get-query-client'

export function Providers({ children }) {
  const queryClient = getQueryClient()
  return (
    <QueryClientProvider client={queryClient}>
      <ReactQueryStreamedHydration>{children}</ReactQueryStreamedHydration>
    </QueryClientProvider>
  )
}
// 어디서든, prefetch 없이
'use client'
export function Posts() {
const { data } = useSuspenseQuery({ queryKey: ['posts'], queryFn: getPosts })
return <ul>{data.map(...)}</ul>
}원리: CSS-in-JS용 훅을 데이터 동기화에 쓴다
이게 된다는 건 서버에서 페칭한 값을 클라이언트에 동기화하는 코드가 어딘가 있다는 뜻입니다. 소스를 열어보면 Next.js의 useServerInsertedHTML 훅을 씁니다.
useServerInsertedHTML은 원래 CSS-in-JS를 위해 만든 훅입니다. styled-components 같은 라이브러리가 스트리밍 도중 각 청크에서 생성된 스타일을 그 청크에 끼워 넣을 수 있도록, Suspense 경계가 풀려서 청크를 내보낼 때마다 콜백을 불러줍니다. 문서상 위치도 CSS-in-JS 가이드에만 있습니다.
출처: Next.js: CSS-in-JS. useServerInsertedHTML은 이 페이지에만 나옵니다.
TanStack은 이 훅을 스타일 대신 쿼리 캐시 동기화에 씁니다.
// @tanstack/react-query-next-experimental/src/HydrationStreamProvider.tsx (발췌)
import { useServerInsertedHTML } from 'next/navigation'

const id = `__RQ${React.useId()}`

// 서버: Suspense 경계가 풀릴 때마다 호출된다
useServerInsertedHTML(() => {
  stream.push(...(props.onFlush?.() ?? []))   // 이번 청크에서 추가·갱신된 쿼리만 dehydrate
  if (!stream.length) return null

  const serialized = stream.map((e) => JSON.stringify(e)).join(',')
  stream.length = 0

  return (
    <script
      dangerouslySetInnerHTML={{
        __html:
          `window[${idJSON}] = window[${idJSON}] || [];` +
          `window[${idJSON}].push(${htmlEscapeJsonString(serialized)});`,
      }}
    />
  )
})

// 브라우저: 첫 렌더 중에 window 배열을 읽어 hydrate하고, push를 hydrate 함수로 바꿔친다
if (!environmentManager.isServer()) {
  const win = window as any
  if (!win[id]?.initialized) {
    const onEntries = (...entries) => props.onEntries(entries.map(deserialize))
    onEntries(...(win[id] ?? []))
    win[id] = { initialized: true, push: onEntries }
  }
}
// ReactQueryStreamedHydration.tsx (발췌)
// 서버: 렌더 중 캐시에 added/updated 된 쿼리 해시를 추적
queryClient.getQueryCache().subscribe((event) => {
if (event.type === 'added' || event.type === 'updated') trackedKeys.add(event.query.queryHash)
})
// onFlush: 추적된 쿼리만 dehydrate해서 청크에 실어 보낸다
// onEntries: 브라우저에서 hydrate(queryClient, state)흐름을 그리면 이렇습니다.
서버 (스트리밍 SSR)                                브라우저

chunk 0  셸 + fallback                            첫 렌더 중 window.__RQ… 읽어 hydrate
         <script>window.__RQ.push([...])</script>   (아직 비어 있을 수도)

 Suspense 경계 A 풀림 ─ useServerInsertedHTML 호출
chunk 1  A의 HTML + 교체 스크립트                 window.__RQ.push(...) 가 곧 hydrate()
         <script>window.__RQ.push([쿼리 A])</script>   → 캐시에 A 들어감
                                                  → 하이드레이션 시 useSuspenseQuery가 캐시 히트

 Suspense 경계 B 풀림
chunk 2  B의 HTML + <script>push([쿼리 B])</script>
이 구조에서는 서버 컴포넌트가 prefetch할 필요가 없습니다. 클라이언트 컴포넌트가 렌더 중에 요청하고, 그 결과가 청크에 실려 오고, 브라우저는 하이드레이션 전에 캐시를 채웁니다. 호출처가 한 군데로 돌아옵니다.
주의할 점
문서에 적힌 주의사항 두 개는 알아둬야 합니다.
useSuspenseQuery를 Suspense 없이 쓰면 페칭이 끝날 때까지 HTML 응답이 시작되지 않아 TTFB가 나빠집니다. 경계를 꼭 두세요.- 이 방식은 첫 페이지 로드의 워터폴만 평평하게 만듭니다. 클라이언트 내비게이션에서는 서버 컴포넌트가 없으니 원래의 깊은 워터폴이 그대로 남습니다. 문서는 이 경우가
getServerSideProps시절보다 나쁠 수도 있다고까지 적어뒀습니다.
그러니까 만능은 아닙니다. 다만 "왜 HydrationBoundary가 컴포넌트여야 하는가"와 "그걸 어떻게 우회했는가"를 이해하면, RSC에서 서버 값이 클라이언트로 건너가는 통로가 무엇인지 분명해집니다.
번외로, TanStack Query 메인테이너 중에 한국 개발자가 있습니다. 그중 한분은 제가 있는 커리어 다이빙 클럽이라는 개발자 모임에서도 뵐 수 있습니다. 궁금한 게 있으면 한국어로 물어볼 수 있는 메인테이너가 있다는 건 꽤 든든한 일입니다.
결론
Suspense는 로딩 화면을 그리는 도구이면서, 스트리밍 SSR에서 응답을 어디서 끊을지 정하는 경계이기도 합니다. 그 경계 안에서 자식이 또 페칭하면 워터폴이 생기고, React.cache로 부모에서 미리 호출하면 풀립니다. 서버에서 받은 값을 클라이언트 캐시에 넣으려면 props가 유일한 통로라 HydrationBoundary 같은 컴포넌트가 필요하고, 그걸 우회하려고 CSS-in-JS용 훅까지 끌어다 쓴다는 것까지가 이번 글이었습니다.
제가 운영하는 컴윗에서는 이 흐름을 템플릿 단계에서 정해뒀습니다. 어떤 데이터가 서버 컴포넌트 소유이고 어떤 데이터가 클라이언트 캐시 소유인지, 목록에서 상세로 갈 때 뭘 시드로 쓰는지 같은 규칙을 코드와 린트로 고정해서, 에이전트가 화면을 늘려도 워터폴이 새로 생기지 않게 했습니다. 컴윗은 클로드코드나 코덱스만 있으면 호스팅, DB, 파일 저장, 로그인, 도메인까지 나머지 인프라를 갖춰둔 서비스인데, 이런 하네스가 실제로 어떻게 생겼는지 궁금하시면 한 번 살펴봐 주세요.
세 편에 걸쳐 RSC와 prefetch, 서버 액션, Suspense를 봤습니다. 공통점은 하나입니다. Next.js가 뭘 언제 어디로 보내는지 알면, 느린 이유도 보이고 고칠 방법도 보입니다. 다음에는 프론트 속도의 한계가 어디까지인지, 로컬 DB 퍼스트 이야기를 해볼까 합니다.
참고 자료
- React:
<Suspense> - React:
renderToPipeableStream— Waiting for all content to load for crawlers - React:
renderToReadableStream—allReady - React 18 WG: New Suspense SSR Architecture
- MDN: Transfer-Encoding chunked
- React:
cache - React:
use - Next.js: Streaming — Bots and crawlers · Verifying that streaming works
- Next.js:
loading.js— SEO - Next.js:
generateMetadata— Streaming metadata - Next.js: Fetching Data
- Next.js: CSS-in-JS (
useServerInsertedHTML) - Google Search Central: JavaScript SEO basics
- TanStack Query: Advanced Server Rendering
- TanStack Query: HydrationBoundary
- TanStack Query 소스:
HydrationStreamProvider.tsx·ReactQueryStreamedHydration.tsx - TanStack maintainers · manudeli · sukvvon
- 스크린샷: 각 공식 문서 페이지, 2026-09-06 캡처