pgvector 실습 정리 - 거리 함수와 HNSW 인덱스
0. 환경 설정
로컬 PostgreSQL(Windows, 18.1)에 pgvector를 설치하려고 했으나, 소스 빌드에 Visual Studio Build Tools(cl, nmake)가 필요한데 없었음. 새로 설치하기엔 용량/시간이 부담스러워서 Docker로 우회.
docker run -d --name pgvector-demo -e POSTGRES_PASSWORD=secret -p 5433:5432 pgvector/pgvector:pg17- 기존 로컬 Postgres 18은 전혀 건드리지 않음
- 완전히 별개의 컨테이너에 pgvector가 이미 설치된 Postgres 17을 새로 띄운 것
- pgAdmin에서
localhost:5433으로 새 서버 등록해서 연결
확장 활성화
CREATE EXTENSION IF NOT EXISTS vector;

SELECT * FROM pg_extension WHERE extname = 'vector';| extname | extversion |
|---|---|
| vector | 0.8.6 |
1. 벡터 테이블 만들고 데이터 넣기
CREATE TABLE items (
  id BIGSERIAL PRIMARY KEY,
  name TEXT NOT NULL,
  embedding VECTOR(3)
);

INSERT INTO items (name, embedding) VALUES
  ('사과',  '[1, 0, 0]'),
  ('배',    '[0.9, 0.1, 0]'),
  ('바나나', '[0.1, 0.9, 0]'),
  ('당근',  '[0, 0.1, 0.9]');
2. 거리 함수 3종 비교 (L2 / 내적 / 코사인)
pgvector가 지원하는 거리 연산자:
<->: L2(유클리드) 거리 — 두 점 사이의 실제 직선거리. 방향과 크기 둘 다 반영<#>: 내적(Inner Product) — 방향이 얼마나 같은지 + 크기가 얼마나 큰지를 동시에 봄.크기가 서로 같은지가 아니라|A|×|B|×cos(θ)라서 크기가 결과에 곱으로 반영됨. 그래서 벡터가 정규화(길이=1)되어 있지 않으면 유사도 검색 용도로는 안 맞음. 정규화만 되어있으면 코사인이랑 순위가 같아짐<=>: 코사인 거리 — 방향만 봄. 크기는 완전히 무시.1 - cos(θ)
코사인 거리로 '사과'와 가장 비슷한 항목 찾기
SELECT name, embedding <=> '[1, 0, 0]' AS distance
FROM items
ORDER BY embedding <=> '[1, 0, 0]'
LIMIT 3;| name | distance |
|---|---|
| 사과 | 0 |
| 배 | 0.0061 |
| 바나나 | 0.8896 |
셋 다 같이 비교
SELECT
  name,
  embedding <-> '[1, 0, 0]' AS l2_distance,
  embedding <#> '[1, 0, 0]' AS neg_inner_product,
  embedding <=> '[1, 0, 0]' AS cosine_distance
FROM items
ORDER BY embedding <=> '[1, 0, 0]';| name | L2 (<->) | -내적 (<#>) | 코사인 (<=>) |
|---|---|---|---|
| 사과 | 0 | -1 | 0 |
| 배 | 0.1414 | -0.9 | 0.0061 |
| 바나나 | 1.2728 | -0.1 | 0.8896 |
| 당근 | 1.3491 | ~0 | 1 |
3개 다 순위가 똑같이 나옴. 이 예제 벡터들의 크기가 다 비슷(≈1)해서 그런 것. 크기가 크게 다르면 코사인 vs L2/내적 순위가 갈릴 수 있음.
속도 순서: 내적 > 코사인 > L2 (제곱·루트 연산 없어서 내적이 이론상 제일 빠름). 근데 이 차이는 실무에서 체감될 정도는 아니고, 병목은 거리 함수 자체가 아니라 인덱스 탐색 쪽.
내가 쓴 선택: OpenAI 임베딩은 코사인 거리 기준으로 최적화되어 있어서 코사인 채택. (참고로 OpenAI 임베딩은 이미 정규화되어 나오기 때문에, 내적으로 바꿔도 결과는 같고 속도만 이득 볼 여지는 있음)
3. 인덱스가 왜 필요한가 - Seq Scan의 한계
인덱스 없이 조회하면:
EXPLAIN ANALYZE
SELECT name FROM items
ORDER BY embedding <=> '[1, 0, 0]'
LIMIT 3;
Limit (cost=30.59..30.60 rows=3 width=40) (actual time=0.077..0.078 rows=3 loops=1)
-> Sort (cost=30.59..32.62 rows=810 width=40) (actual time=0.075..0.076 rows=3 loops=1)
Sort Key: ((embedding <=> '[1,0,0]'::vector))
Sort Method: quicksort Memory: 25kB
-> Seq Scan on items (cost=0.00..20.12 rows=810 width=40) (actual time=0.063..0.065 rows=4 loops=1)
Planning Time: 0.239 ms
Execution Time: 0.103 msSeq Scan = 테이블 전체를 순차적으로 다 훑은 것. 지금은 4개뿐이라 0.1ms지만, 데이터가 늘어나면 이게 병목이 됨.
4. HNSW 인덱스
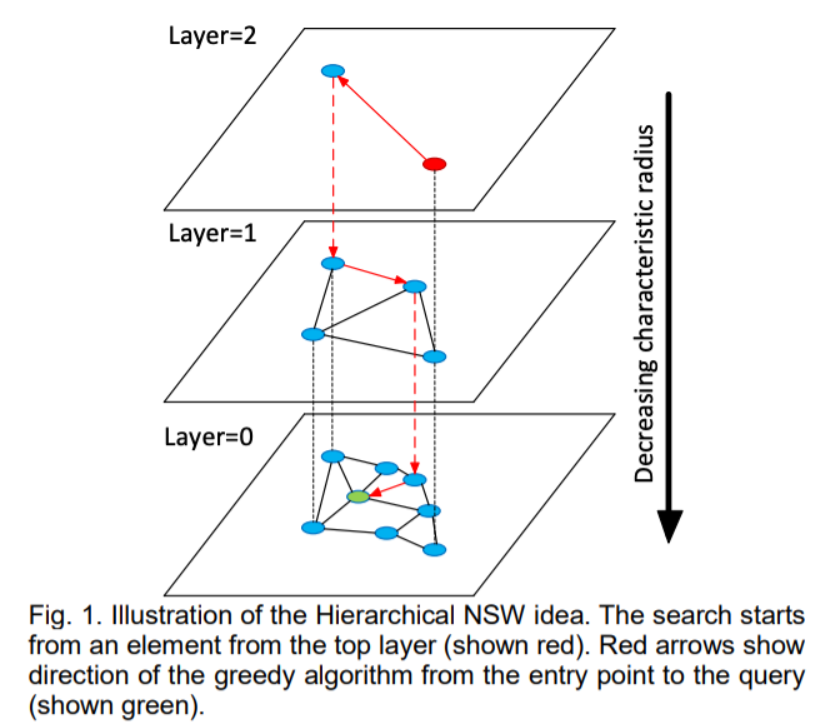
4-1. 뭔지
Hierarchical Navigable Small World
- 여러 층으로 된 그래프를 만들어서, 상위층에서 방향을 잡고 아래층으로 내려오면서 점점 정밀하게 좁혀나감
- 처음엔 대강, 뒤로 갈수록 촘촘하게
검색 과정
1. 맨 위층 진입
2. 해당 층에서 그리디 탐색. 현재 노드의 이웃들 중 쿼리 벡터와 더 가까운 노드가 있으면 이동(양옆으로 이동). 더 가까운 이웃이 없으면 멈춤
3. 그 위치 그대로 아래층으로 넘김
4. 아래층에서 다시 그리디 탐색 반복
삽입 과정
벡터가 몇 층까지 올라갈지는 삽입 시점에 랜덤하게 결정됨.
4-2. B-Tree랑 뭐가 다른가
| B-Tree | HNSW | |
|---|---|---|
| 대상 | 1차원 정렬 가능한 값 | 다차원 벡터 (전순서 없음) |
| 구조 | 정렬 기준으로 균등 분기하는 트리 | 노드를 잇는 그래프 (트리 아님) |
| 탐색 | 크다/작다로 절반씩 배제 | 이웃이 더 가까운지로 그리디 이동 |
| 정확도 | 100% 정확 | 근사치 |
| "레벨/층"의 의미 | 값의 범위를 좁혀가는 단계 | 연결의 밀도(고속도로 vs 골목길) 차이일 뿐, 값의 순서와 무관 |
4-3. 의문: "정렬 안 된 걸 위→아래로 내려가는 게 의미 있나?"
핵심을 찌른 질문이었음. 결론부터 말하면 레이어는 정렬된 계층이 아니라 "같은 그래프의 다른 밀도 버전"임.
- 같은 벡터(노드)가 여러 층에 동시에 존재함 (좌표 안 바뀜)
- 위층에서 하는 일 = "정렬 좁히기"가 아니라 그냥 그리디 탐색으로 로컬 미니멈까지 이동하는 것
- 그 로컬 미니멈 좌표를 그대로 한 층 아래로 넘기고, 아래층(더 촘촘한 그래프)에서 다시 미세조정
즉 "내려간다"는 게 순서 개념이 아니라, 같은 위치에서 참고하는 지도만 더 촘촘한 걸로 바꿔가는 것. 위층은 노드가 적어서 한 번의 이동으로 멀리 점프 가능(고속도로), 아래층은 촘촘해서 미세 조정(골목길). 이걸로 총 이동 횟수(홉 수)를 줄이는 게 목적 — 스킵 리스트(Skip List)가 O(log N)을 만드는 원리랑 동일.
풀스캔 안 하고 굳이 층을 나누는 이유도 이거임. 한 층짜리 그래프만 타도 풀스캔보다는 빠르지만, 노드가 많으면 시작점에서 목적지까지 거쳐야 할 홉 수가 많아짐. 성긴 위층에서 큰 걸음으로 먼저 근처까지 가면 총 홉 수가 훨씬 줄어듦.
4-4. Local Minimum 문제
제기한 문제 상황: 맨 위층 진입 노드가 사실 "뒤에서 세 번째로 먼 벡터"이고, 그 아래층에서 양옆 이웃들이 전부 그 노드보다도 더 멀다면? → 그리디는 거기서 멈춰버리고, 진짜 가까운 벡터를 영영 못 찾음.
이건 순수 그리디(제일 가까운 이웃 1개만 보고 이동)를 쓰면 실제로 생기는 문제가 맞음. HNSW는 두 가지 보완책으로 이걸 완화함.
보완책 1 — 크기 ef짜리 후보 목록(우선순위 큐)을 유지
- 현재까지 찾은 가장 가까운
ef개 노드를 후보 목록에 넣어둠 - 그중 아직 이웃 탐색 안 한 노드 중 제일 가까운 걸 골라서 그 이웃들을 전부 검사
- 검사한 이웃 중 후보 목록보다 가까운 게 있으면 추가 (넘치면 제일 먼 거 버림)
- 더 이상 개선 없을 때까지 반복
→ "지금 서 있는 노드"만 보고 판단 안 하고, 여러 갈래를 동시에 들고 다니면서 막다른 길이어도 다른 갈래로 계속 파고들 수 있음.
보완책 2 — 그래프를 만들 때부터 다양한 방향의 이웃을 고름
- 그냥 "가장 가까운 M개"로만 연결하면 특정 방향으로만 그래프가 뻗어서 막다른 길이 많이 생김
- 그래서 "가깝지만 서로 다른 방향"의 이웃들을 우선 선택하는 규칙을 씀 (지름길 역할)
→ 이 두 가지로 확률을 크게 낮추지만 100% 보장은 안 됨. 그래서 HNSW가 "근사(Approximate)" 인덱스인 것.
4-5. 파라미터
| 파라미터 | 시점 | 의미 | 크면 | 작으면 |
|---|---|---|---|---|
m | 인덱스 생성 | 노드당 최대 이웃 수 (기본 16) | 정확도↑, 메모리↑ | 메모리 절약, local minimum 취약 |
ef_construction | 인덱스 생성 | 이웃 M개를 고를 때 비교할 후보 수 (기본 64) | 인덱스 품질↑, 생성 시간↑ | 생성 빠름, 품질↓ |
ef_search | 검색 시 | 그리디 탐색 중 유지하는 후보 수 (기본 40) | 정확도↑(recall↑), 느려짐 | 빠름, 놓칠 확률↑ |
SET hnsw.ef_search = 100; -- 세션 단위로 조절 가능단점
대규모 데이터에는 메모리 비용이 엄청나다고함.
동적 삭제가 어려움. 그래프에서 특정 노드를 삭제하면 연결된 링크들이 끊어져 크래프가 파편화될 위험이 있음. 이를 복구하기 위해 주변 노드들을 재연결하는 비용이 큼. 하지만 게시글 삭제는 그렇게 빈번하지 않기에 ㄱㅊ
5. 실습 — 옵티마이저가 인덱스를 언제 타는가
5-1. 인덱스 생성
CREATE INDEX ON items
USING hnsw (embedding vector_cosine_ops);
5-2. 4개 행 — 여전히 Seq Scan
EXPLAIN ANALYZE
SELECT name FROM items
ORDER BY embedding <=> '[1, 0, 0]'
LIMIT 3;
-> Seq Scan on items (cost=0.00..1.05 rows=4 width=40) (actual time=0.041..0.043 rows=4 loops=1)
Execution Time: 0.080 ms데이터가 너무 적어서 옵티마이저가 "인덱스 타는 것보다 그냥 다 훑는 게 싸다"고 판단.
5-3. 1,000개, 10,000개 — 아직도 Seq Scan
데이터를 늘려도(1천 개, 1만 개) 여전히 Seq Scan. row 수가 아직 충분치 않다는 뜻.
INSERT INTO items (name, embedding)
SELECT 'item_' || i, ARRAY[random(), random(), random()]::vector
FROM generate_series(1, 1000) AS i;| 행 수 | 3차원 기준 스캔 방식 |
|---|---|
| 4개 | Seq Scan |
| 1,004개 | Seq Scan |
| 10,000개 | Seq Scan |
5-4. 10만 개 — 드디어 Index Scan 등장
INSERT INTO items (name, embedding)
SELECT 'item_' || i, ARRAY[random(), random(), random()]::vector
FROM generate_series(1, 100000) AS i;
EXPLAIN ANALYZE
SELECT name FROM items
ORDER BY embedding <=> '[1, 0, 0]'
LIMIT 3;Limit (cost=112.10..112.72 rows=3 width=18) (actual time=0.543..0.547 rows=3 loops=1)
-> Index Scan using items_embedding_idx on items (cost=112.10..21088.08 rows=101004 width=18) (actual time=0.541..0.544 rows=3 loops=1)
Order By: (embedding <=> '[1,0,0]'::vector)
Execution Time: 0.588 msIndex Scan using items_embedding_idx 등장.
5-5. 강제로 Seq Scan 시켜서 직접 비교
SET enable_indexscan = off;
EXPLAIN ANALYZE
SELECT name FROM items
ORDER BY embedding <=> '[1, 0, 0]'
LIMIT 3;
SET enable_indexscan = on;-> Seq Scan on items (cost=0.00..2104.55 rows=101004 width=18) (actual time=0.018..21.724 rows=101004 loops=1)
Execution Time: 41.322 ms결과 비교 (3차원, 10만 행)
| 방식 | Execution Time |
|---|---|
| Seq Scan | 41.3 ms |
| HNSW Index Scan | 0.588 ms |
약 70배 차이.
6. 차원을 늘리면 어떻게 달라지나 — 1536차원 실험
OpenAI text-embedding-3-small이 1536차원이라 이 규모로 실제 실험.
CREATE TABLE items_1536 (
  id BIGSERIAL PRIMARY KEY,
  name TEXT,
  embedding VECTOR(1536)
);

INSERT INTO items_1536 (name, embedding)
SELECT
  'item_' || i,
  (SELECT array_agg(random()) FROM generate_series(1, 1536))::vector
FROM generate_series(1, 10000) AS i;

CREATE INDEX ON items_1536 USING hnsw (embedding vector_cosine_ops);

ANALYZE items_1536;
6-1. 그런데 여전히 Seq Scan
같은 1만 개 행인데도(3차원일 땐 이 규모에서 Seq Scan 나온 것과 같음) 여전히 Seq Scan.
->  Seq Scan on items_1536  (cost=0.00..209.00 rows=10000 width=17) (actual time=0.243..160.112 rows=10000 loops=1)
Execution Time: 164.662 ms
차원별 Seq Scan 속도 비교 (1만 행 기준)
| 차원 | Execution Time |
|---|---|
| 3차원 | 5.5 ms |
| 1536차원 | 164.7 ms |
같은 행 수인데 차원이 커지니 거리 계산 자체가 무거워져서 약 30배 차이. → 차원이 클수록 같은 행 수에서도 Seq Scan이 훨씬 불리해짐을 확인.
6-2. 강제로 Index Scan 시켜서 비교
SET enable_seqscan = off;

EXPLAIN ANALYZE
SELECT name FROM items_1536
ORDER BY embedding <=> '[...1536차원 벡터...]'
LIMIT 3;

SET enable_seqscan = on;
-> Index Scan using items_1536_embedding_idx on items_1536 (cost=10000000088.10..10000037872.00 rows=10000 width=17) (actual time=1.183..1.200 rows=3 loops=1)
Order By: (embedding <=> '[...]'::vector)
Planning Time: 0.413 ms
JIT:
Functions: 5
Timing: ... Inlining 170.228 ms, Optimization 287.415 ms, Emission 142.291 ms, Total 603.745 ms
Execution Time: 1062.026 ms진짜 스캔 시간 vs 전체 Execution Time
| 구간 | 시간 |
|---|---|
Index Scan 실제 스캔 (actual time) | 1.2 ms |
| 전체 Execution Time | 1062 ms |
전체 시간이 크게 나온 건 인덱스 문제가 아니라 JIT 컴파일 오버헤드(약 600ms) 때문. 진짜 봐야 할 숫자는 Index Scan 노드의 actual time = 1.2ms.
정리 (1536차원, 1만 행)
| 방식 | 진짜 스캔 시간 |
|---|---|
| Seq Scan | ~160 ms |
| HNSW Index Scan | ~1.2 ms |
약 133배 차이. 3차원 실험(70배)보다 차이가 더 크게 벌어짐 → 차원이 클수록 인덱스의 이득이 더 커진다는 뜻.
7. 왜 옵티마이저가 스스로 인덱스를 안 탔나?
7-1. Cost 추정 문제
EXPLAIN 결과의 cost를 보면:
Index Scan: cost=10000000088.10..10000037872.00
Seq Scan  : cost=0.00..209.00
HNSW 인덱스 스캔에는 10000000000이라는 거대한 고정 startup cost가 붙어 있음. 이건 그래프 진입점까지 가는 오버헤드를 실제보다 훨씬 크게 잡아둔 pgvector HNSW의 cost 모델 특성. 옵티마이저는 이 견적만 보고 "시작부터 이게 더 비싸다"고 판단해서 Seq Scan을 고름 — 실제로는 견적이 틀린 것(실제 실행하면 인덱스가 압도적으로 빠름).
즉, 데이터 양이 아니라 옵티마이저의 cost 추정 자체가 부정확해서 생기는 문제. 실무 대응은 enable_seqscan = off 세션 설정, ef_search/probes 튜닝, 통계 재조정 등.
7-2. JIT란?
Just-In-Time Compilation. Postgres는 원래 실행 계획을 "해석(interpret)" 방식으로 돎 — 매 행마다 연산자 찾고 타입 체크하고 실행. PostgreSQL 11부터, 특정 조건에서 표현식 계산 부분을 그 자리에서 기계어로 직접 컴파일해서 반복 계산을 빠르게 만드는 기능이 생김. 이게 JIT.
- 목적: 반복되는 계산을 빠르게. 100만 행에 대해 매번 "연산자 찾기→타입 체크→실행"을 반복하는 대신, 표현식을 한 번 네이티브 함수로 컴파일해두고 그 함수를 100만 번 호출
- 근데 우리 경우엔 역효과: 실제 스캔되는 행이 딱 3개(LIMIT 3)라서, 컴파일 투자(≈600ms) 대비 실행 이득이 전혀 없었음. 벡터 리터럴이 워낙 커서(1536개 숫자) 표현식이 복잡하다고 오판해 JIT를 켠 것으로 보임
- 즉 "1062ms"는 인덱스 성능과 무관한 환경적 잡음이고, 진짜 인덱스 스캔 성능은
1.2ms
8. ef_search 실습 - 후보 목록 크기
ef_search는 그리디 탐색 중 유지하는 후보 목록(우선순위 큐)의 크기. 이 값이 실제로 검색 품질에 어떤 영향을 주는지 직접 확인해봄.
8-1. 먼저 인덱스 없이(Seq Scan) — 기준값
SET hnsw.ef_search = 1;

EXPLAIN ANALYZE
SELECT name FROM items_1536
ORDER BY embedding <=> '[1536차원 벡터]'
LIMIT 10;
-> Seq Scan on items_1536 (cost=0.00..209.00 rows=10000 width=17) (actual time=0.563..432.460 rows=10000 loops=1)
Execution Time: 440.846 msef_search는 HNSW 인덱스를 탈 때만 적용되는 파라미터라서, Seq Scan 상태에서는 아무 의미가 없음. Seq Scan은 항상 정확하게 10개를 다 찾아냄(당연히 전체를 다 보니까). 이 결과는 그냥 비교 기준일 뿐.
8-2. 강제로 Index Scan 태워서 ef_search=1 적용
SET enable_seqscan = off;
SET hnsw.ef_search = 1;

EXPLAIN ANALYZE
SELECT name FROM items_1536
ORDER BY embedding <=> '[같은 벡터]'
LIMIT 10;
Limit (cost=10000000084.80..10000000122.59 rows=10 width=17) (actual time=125.572..125.574 rows=1 loops=1)
-> Index Scan using items_1536_embedding_idx on items_1536 (cost=10000000084.80..10000037872.00 rows=10000 width=17) (actual time=0.721..0.722 rows=1 loops=1)
Order By: (embedding <=> '[...]'::vector)LIMIT 10을 걸었는데 rows=1밖에 못 찾음.
이게 핵심 결과임. ef_search=1이면 후보 목록에 딱 1개만 담을 수 있으니, 그리디 탐색이 후보 하나 찾자마자 "더 이상 볼 자리가 없다"고 판단하고 바로 멈춰버린 것. 나머지 9개는 그래프의 다른 영역에 분명히 있었을 텐데, 탐색 범위 자체가 너무 좁아서 아예 못 감. 이게 바로 이론으로만 알고 있던 local minimum / recall 저하 문제가 숫자로 재현된 장면.
8-3. ef_search를 200으로 올리면
SET hnsw.ef_search = 200;

EXPLAIN ANALYZE
SELECT name FROM items_1536
ORDER BY embedding <=> '[같은 벡터]'
LIMIT 10;

SET enable_seqscan = on;
Limit (cost=10000000098.28..10000000136.06 rows=10 width=17) (actual time=72.346..72.415 rows=10 loops=1)
-> Index Scan using items_1536_embedding_idx on items_1536 (cost=10000000098.28..10000037872.00 rows=10000 width=17) (actual time=0.700..0.767 rows=10 loops=1)
Order By: (embedding <=> '[...]'::vector)이번엔 rows=10으로 요청한 만큼 정상 반환됨.
8-4. 정리
| ef_search | Index Scan이 실제 찾은 행 수 (rows=) | Index Scan 자체 소요 시간 (actual time) |
|---|---|---|
| 1 | 1개 (LIMIT 10인데 미달) | 0.72ms |
| 200 | 10개 (정상) | 0.70~0.77ms |
시간은 둘이 거의 차이 없는데(둘 다 워낙 빠른 인덱스라), 정확도(찾은 개수)는 극명하게 갈림. ef_search가 너무 작으면 빠른 대신 요청한 개수도 못 채울 만큼 품질이 무너질 수 있다는 걸 확인.
참고: 위 결과들의
Execution Time(125ms, 72ms)은 JIT 컴파일 오버헤드가 섞여서 부풀려진 값. 진짜 봐야 할 숫자는Index Scan노드의actual time(0.7ms대, 둘 다 비슷)과rows=값의 차이.
실무 규칙: ef_search는 항상 LIMIT 값보다 여유 있게 커야 함. 위 실험이 정확히 그 규칙을 어긴 경우(LIMIT 10 vs ef_search 1)를 보여준 것.
IVFFlat (Inverted File Index - 역색인)
벡터 공간을 미리 N개의 클러스터로 나눠놓고, 검색할 때 쿼리와 가까운 클러스터 몇 개만 뒤지는 방식. HNSW가 그래프를 걸어가며 찾는 거였다면, IVFFlat은 덩어리(클러스터) 단위로 수색 범위를 좁히는 방식.
K-means로 lists개 클러스터를 미리 만들어두고, 검색 시 쿼리와 가까운 클러스터 probes개만 골라서 그 안에서 브루트포스로 거리 계산.
HNSW vs IVFFlat
| HNSW | IVFFlat | |
|---|---|---|
| 원리 | 다층 그래프를 그리디하게 탐색 | 클러스터링 후 가까운 클러스터만 뒤짐 |
| 정확도(recall) | 더 높음 | 상대적으로 낮음 |
| 검색 속도 | 더 빠름 | 상대적으로 느림 |
| 인덱스 생성 속도 | 느림 (그래프 구축 비용 큼) | 빠름 |
| 메모리 사용량 | 큼 | 작음 |
| 데이터 삽입 순서 | 상관없음, 언제든 삽입 가능 | 클러스터가 데이터 분포 기준으로 미리 학습되어야 해서, 데이터 다 넣고 나서 인덱스 만드는 게 이상적 (분포가 크게 바뀌면 재구축 필요) |
| 파라미터 | m, ef_construction, ef_search | lists, probes |
정확도와 속도 둘 다 HNSW가 우위라 유사도 검색엔 HNSW가 적합. 반대로 메모리가 빠듯하거나 데이터가 거의 안 바뀌는 정적 데이터셋이라면 IVFFlat 고려.
HNSW는 빠른 쿼리 성능에 최적화되어 있으며 인메모리 그래프 구조를 사용하여 더 많은 메모리가 필요함. IVFFlat은 메모리 사용량이 적고 학습 단계를 통해 벡터를 클러스터로 구성하지만 성능은 데이터셋 및 워크로드에 따라 달라질 수 있음.
워크로드 : 실제 운영 환경에서 시스템에 걸리는 부하의 패턴/성격을 말함.
추가 OpenAI 임베딩 비용
100자 글 하나에 0.0001$
1만개 게시글 : 1$
검색이 10만개 들어오더라도 1$ 미만.
충~분~