1. 카프카란?
카프카는 여러 시스템 사이에서 데이터(메시지)를 비동기로 주고받게 해주는 메시지 중계 시스템임.
A 서버가 이벤트를 카프카에 던지면, B, C 서버가 각자 원하는 시점에 그걸 받아가는 구조임.
핵심은 Producer와 Consumer가 서로를 직접 알 필요가 없다는 것. 둘 다 카프카만 바라보고 통신하기 때문에 시스템 간 결합도가 낮아짐 (느슨한 결합).
2. Producer / Consumer
- Producer: 카프카에 메시지를 만들어서 보내는 쪽
- Consumer: 카프카에서 메시지를 꺼내가는 쪽
Java 코드로 보면 이런 형태임.
// Producer
Properties props = new Properties();
props.put("bootstrap.servers", "localhost:9092");
props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");
props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");

KafkaProducer<String, String> producer = new KafkaProducer<>(props);
ProducerRecord<String, String> record =
    new ProducerRecord<>("order-topic", "user123", "주문 발생!");
producer.send(record);
producer.close();
// Consumer
Properties props = new Properties();
props.put("bootstrap.servers", "localhost:9092");
props.put("group.id", "delivery-group");
props.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");
props.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");
KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props);
consumer.subscribe(List.of("order-topic"));
while (true) {
ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
for (ConsumerRecord<String, String> r : records) {
System.out.println("받은 메시지: " + r.value());
}
}
Consumer는 while(true) 무한루프 안에서 poll()을 계속 호출하는 구조임. 즉, Consumer 하나당 이 루프를 담당할 스레드가 하나 필요함. Consumer 3개를 띄우면 스레드도 3개 필요한 셈.
3. Topic
메시지를 아무데나 던지지 않고 "주제별 우편함"에 넣음. 이 우편함이 Topic임.
Topic 이름은 그냥 문자열이라 자유롭게 정할 수 있음 (order-topic이든 ooorder-topic이든 상관없음, 카프카 입장에선 그냥 이름표일 뿐). 단, Producer가 쓰는 이름과 Consumer가 구독하는 이름이 정확히 일치해야 서로 통함.
Topic 존재 여부 같은 메타데이터는 Broker(클러스터) 내부에 저장됨.
4. Partition
Topic 하나를 여러 조각으로 쪼갠 게 Partition임. 쪼개는 이유는 병렬 처리 때문.
order-topic이 Partition 3개면 메시지가 p0, p1, p2로 분산 저장됨. Consumer 여러 개가 각자 다른 Partition을 동시에 읽을 수 있어서 처리 속도가 올라감.
같은 key로 보낸 메시지는 항상 같은 Partition에 들어감. 카프카가 key를 해시 계산해서 어느 Partition에 넣을지 정하는데, 같은 key는 항상 같은 계산 결과가 나오기 때문임.
new ProducerRecord<>("order-topic", "user123", "주문A");
new ProducerRecord<>("order-topic", "user123", "주문B");
// 위 두 메시지는 key가 같아서 무조건 같은 Partition에 들어감
왜 이게 중요하냐면, 같은 Partition 안에서는 메시지 순서가 보장됨. 카프카는 여러 Partition에 병렬로 쓰고 읽다 보니 전체 순서 보장은 애초에 포기하고, 대신 "같은 key끼리의 순서"만 보장하는 현실적인 타협을 함.
5. Consumer Group
같은 역할(기능)을 하는 Consumer들의 묶음임 (group.id로 묶임).
- 같은 그룹 안 Consumer들: Partition을 나눠서 가져감 (분업, 처리량 증가, 중복 처리 방지)
- 다른 그룹 Consumer들: 같은 Topic을 각자 독립적으로 처음부터 끝까지 다 읽음
하나의 Topic에 그룹은 여러 개 붙을 수 있음. 예를 들어 order-topic 하나에 "배송그룹", "통계그룹", "알림그룹"이 각자 따로 붙어서 전체 메시지를 독립적으로 다 읽어갈 수 있음.
같은 그룹 안에서는 Partition 하나에 Consumer 1개만 붙을 수 있음. Consumer가 Partition보다 많으면 남는 Consumer는 놀게 됨. "기능"은 컨슈머 개별 단위가 아니라 그룹 단위임 - 같은 그룹 안의 Consumer들은 다 같은 코드를 실행하는 복제 인스턴스일 뿐임.
6. Broker & Kafka 클러스터
Broker는 카프카 서버 한 대를 말함. Kafka(클러스터)는 실체가 있는 하나의 프로그램이 아니라, Broker 여러 대가 서로 통신하면서 하나처럼 작동하는 그룹을 부르는 개념적 단위임.
Kafka 클러스터
├── Broker 1
├── Broker 2
├── Broker 3 (컨트롤러 역할 겸임)
Broker를 여러 대 쓰는 이유는 두 가지임.
- 분산 저장: Partition들을 여러 Broker에 나눠 저장해서 부하 분산
- 장애 대비: Replication으로 복제해두면 Broker 하나 죽어도 서비스 유지
한 Broker에 같은 Topic의 Partition이 다 몰리면 안 됨. 그 Broker가 죽으면 Topic 전체가 통째로 죽어버리기 때문. 그래서 카프카는 같은 Topic의 Partition들을 최대한 다른 Broker에 흩어서 배치함.
Controller는 Broker들 중 하나(또는 몇 개)가 맡는 역할로, 클러스터 메타데이터(어떤 Topic/Partition이 어디 있는지, ISR 목록, 리더가 누군지)를 관리함. 예전엔 Zookeeper라는 별도 프로그램이 이 역할을 했지만, 최신 버전은 Broker 자체가 컨트롤러 역할까지 하는 KRaft 방식으로 바뀜.
7. Replication & ISR
Replication: 같은 Partition 데이터를 다른 Broker에도 복사해두는 것.
p0: broker1(원본/리더), broker2(복제본), broker3(복제본)원본(리더) 있는 Broker가 죽으면, 복제본 있는 Broker가 새 리더 역할을 이어받음.
ISR(In-Sync Replica): 복제본들 중에서 데이터가 최신이고 정상 동작 중인 것만 모은 그룹임. 리더 Broker가 각 팔로워(follower)로부터 주기적으로 "따라잡았다"는 응답을 받아서, 일정 시간(replica.lag.time.max.ms, 기본 10초) 안에 응답이 없으면 그 팔로워를 ISR에서 제외함.
원본이 죽었을 때 새 리더는 반드시 ISR 안에 있는 복제본 중에서 뽑힘 (뒤처진 복제본은 데이터 유실 위험이 있어서 후보에서 제외됨).
8. Offset & Commit
Offset: Consumer가 Partition에서 어디까지 읽었는지 기록하는 위치 번호 (책갈피 개념).
Consumer가 직접 들고 있는 게 아니라, 카프카 내부의 __consumer_offsets라는 특수 Topic에 저장됨.
배송그룹 - order-topic-p0 - offset: 15
배송그룹 - order-topic-p1 - offset: 22
통계그룹 - order-topic-p0 - offset: 8
Commit: Consumer가 "여기까지 처리 완료했다"고 카프카에 offset을 보고하는 행위임. poll로 "읽는 것"과 commit으로 "완료 보고하는 것"은 별개임.
- 자동 커밋(
enable.auto.commit=true): 일정 주기(기본 5초)마다 알아서 commit. 편하지만, 처리 도중 죽으면 처리 안 된 메시지가 이미 읽은 걸로 처리돼서 유실 가능 - 수동 커밋(
enable.auto.commit=false): 처리 로직 끝난 후 직접 commit. 번거롭지만 안전해서 실무에서 주로 씀
ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
for (var r : records) {
    처리로직(r);
}
consumer.commitSync(); // 처리 다 끝난 후 직접 commit
9. 메시지 전달 보장 (Delivery Guarantee)
- At-most-once: 최대 한 번 처리. 유실 가능하지만 중복은 없음
- At-least-once: 최소 한 번 처리. 중복 가능하지만 유실은 없음 (실무 기본값)
- Exactly-once: 정확히 한 번 처리. 이상적이지만 구현이 복잡함
결제, 재고 차감처럼 중복되면 절대 안 되는 로직은 At-least-once를 쓰되 멱등성(Idempotency) 처리로 방어함.
if (이미_처리된_orderId_인가(orderId)) {
    return; // 중복이니까 스킵
}
결제처리();
처리완료_기록(orderId);
10. Rebalancing
Consumer Group 안에서 Consumer가 추가되거나 죽으면 Partition 담당을 다시 나누는 과정임.
리밸런싱 도중엔 그룹 전체가 잠깐 멈춤(Stop-the-world). 문제는 이게 불필요하게 자주 일어날 때임. Consumer가 heartbeat(살아있다는 신호)를 제때 못 보내면 카프카가 "죽었다"고 오해해서 리밸런싱을 발동시킴.
heartbeat가 늦어지는 대표적인 원인은 poll() 루프 안에서 처리 로직이 너무 오래 걸리는 경우임. 그래서 무거운 작업(DB 저장, API 호출)은 별도 스레드풀에 위임해서 poll 루프 자체는 가볍게 유지함.
ExecutorService executorService = Executors.newFixedThreadPool(5);

while (true) {
    var records = consumer.poll(Duration.ofMillis(100));
    for (var r : records) {
        executorService.submit(() -> 처리로직(r)); // 다른 스레드에 위임
    }
    consumer.commitSync();
}
스레드가 분리되면 보통 DB 커넥션도 스레드별로 따로 잡기 때문에, 각 메시지 처리가 서로 독립적인 트랜잭션으로 진행됨.
11. acks & min.insync.replicas
acks: Producer가 메시지 저장을 얼마나 철저히 확인하고 넘어갈지 정하는 옵션.
- acks=0: 확인 안 함. 제일 빠르지만 Broker가 못 받아도 모름 (유실 위험 큼)
- acks=1: 리더 Broker가 저장한 것만 확인. 리더가 저장 직후 죽고 복제 전이면 유실 가능
- acks=all(-1): ISR에 있는 모든 복제본이 저장 완료할 때까지 기다림. 제일 안전하지만 느림
min.insync.replicas: acks=all과 짝꿍 개념. ISR 안에 최소 몇 대가 살아있어야 쓰기를 허용할지 정하는 안전장치. 예를 들어 min.insync.replicas=2인데 ISR에 살아있는 Broker가 1대뿐이면 Producer가 쓰기 시도해도 에러가 나서 아예 못 씀 - 위험한 상태로 쓰느니 차라리 막는 방식.
전체 구조 한눈에 보기
[Producer 1]         [Producer 2]
      \                   /
       v                 v
  ┌───────────────────────────────────────────┐
  │              Kafka 클러스터                  │
  │  ┌───────────┐  ┌───────────┐  ┌───────────┐│
  │  │ Broker 1  │  │ Broker 2  │  │ Broker 3  ││
  │  │ p0 (리더) │  │ p1 (리더) │  │ p2 (리더) ││
  │  │ p1 (복제) │  │ p2 (복제) │  │ p0 (복제) ││
  │  │ ISR: O    │  │ ISR: O    │  │ ISR: O    ││
  │  └───────────┘  └───────────┘  └───────────┘│
  └───────────────────────────────────────────┘
         /            |             \
        v             v              v
 ┌─────────────────────────┐   ┌─────────────────┐
 │   배송그룹 (Group A)      │   │ 통계그룹 (Group B)│
 │  C1:p0   C2:p1   C3:p2   │   │   C1: p0,p1,p2   │
 │  각자 offset 관리          │   │   혼자 다 담당      │
└─────────────────────────┘ └─────────────────┘- Producer들이 Topic에 메시지를 씀 (key 있으면 같은 key는 같은 Partition으로)
- Broker 3대가 Partition을 리더/복제본으로 나눠 저장 (ISR로 복제 상태 관리)
- 배송그룹은 Consumer 3개가 Partition을 나눠서 분업 처리
- 통계그룹은 배송그룹과 무관하게 독립적으로 전체 Partition을 다 읽음
- 모든 Consumer는 처리 후 offset을
__consumer_offsets에 commit해서 진행 상황을 기록함
기본 실습
이론만 보니까 계속 뜬구름 잡는 느낌이라, EC2에 올려둔 카프카를 완전히 초기화하고 처음부터 해봤음. 터미널에서 직접 쳐보니 이론에서 흐릿했던 게 명확해짐.
환경은 EC2 위에 도커로 브로커 1대(apache/kafka:3.9.0)만 띄운 상태임.
1. 토픽 만들기
빈 브로커에서 시작해서 토픽을 하나 만들었음.
docker exec keeping-kafka /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 \
--create --topic test.hello --partitions 3 --replication-factor 1| 부분 | 뜻 |
|---|---|
docker exec keeping-kafka | 어느 컨테이너에서 실행할지 (Docker 층) |
/opt/kafka/bin/kafka-topics.sh | 카프카가 기본 제공하는 관리 스크립트 |
--bootstrap-server localhost:9092 | 어느 브로커에 요청할지 (Kafka 층) |
--create | 무엇을 할지 (동사) |
--partitions 3 | 줄 3개 |
--replication-factor 1 | 사본 없음 |
--bootstrap-server를 오해하고 있었음
"저 주소에서 명령을 실행한다"인 줄 알았는데 아니었음. 요청을 보낼 상대임.
1. 스크립트는 컨테이너 안에서 실행된다        ← 여기서 돈다
2. 스크립트가 localhost:9092 에 TCP 연결      ← 여기로 전화 건다
3. "test.hello 만들어줘" 요청을 보낸다
4. 브로커가 실제로 만든다                     ← 진짜 일하는 건 브로커
5. 응답 받아서 "Created topic" 출력
MySQL로 바꿔 생각하면 똑같음.
mysql            -h 서버주소             -e "CREATE TABLE ..."
kafka-topics.sh  --bootstrap-server ...  --create ...
                 ^^^^^^^^^^^^^^^^^^^^^^
                 = -h 와 같은 자리
mysql -e "CREATE TABLE"을 친다고 CLI가 테이블을 만드는 게 아님. 서버한테 요청하는 거고 만드는 건 서버임.
즉 kafka-topics.sh는 브로커가 아니라 클라이언트임. 우리 앱의 Producer/Consumer와 똑같은 방식으로 브로커에 붙음. 특권 같은 거 없음.
실행하니 경고가 떴음
WARNING: Due to limitations in metric names, topics with a period ('.')
or underscore ('_') could collide.
Created topic test.hello.
왜 뜨냐면 — Prometheus 지표 이름에는 .을 못 쓰기 때문임. 자동으로 _로 바뀜.
order.topic.v1   →   order_topic_v1
order_topic_v1   →   order_topic_v1
     ^^^ 원래 다른 토픽인데     ^^^ 똑같아짐
두 토픽의 숫자가 하나로 합쳐져서 구분이 안 됨. .만 쓰거나 _만 쓰거나 하나로 통일해야 함.
2. --describe로 토픽 들여다보기
docker exec keeping-kafka /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 --describe --topic test.hello
Topic: test.hello TopicId: dzJdmv9JSzGoDx_vnr0nSA PartitionCount: 3 ReplicationFactor: 1
Configs: min.insync.replicas=1,segment.bytes=268435456
Topic: test.hello Partition: 0 Leader: 1 Replicas: 1 Isr: 1
Topic: test.hello Partition: 1 Leader: 1 Replicas: 1 Isr: 1
Topic: test.hello Partition: 2 Leader: 1 Replicas: 1 Isr: 1첫 줄은 토픽 전체 요약임.
| 뜻 | |
|---|---|
TopicId | 카프카가 붙인 고유 ID. 같은 이름으로 지웠다 다시 만들면 ID가 바뀜 (다른 토픽 취급) |
PartitionCount: 3 | 우리가 준 값 |
min.insync.replicas=1 | 브로커 설정이 여기 박힌 것 |
나머지 3줄은 파티션 하나씩임.
| 뜻 | |
|---|---|
Leader: 1 | 1번 브로커가 이 파티션의 대표. 쓰기·읽기가 여기로 감 |
Replicas: 1 | 사본을 놓기로 한 브로커 목록 (계획) |
Isr: 1 | 실제로 최신 상태인 사본 목록 (현실) |
Replicas와 Isr의 차이
지금은 둘 다 1이라 차이가 안 보이는데, 브로커 3대라면 이렇게 됨.
정상일 때
Partition: 0    Leader: 1    Replicas: 1,2,3    Isr: 1,2,3

브로커 3이 죽으면
Partition: 0    Leader: 1    Replicas: 1,2,3    Isr: 1,2
^^^^^^^ 계획은 그대로 ^^^ 살아있는 건 둘min.insync.replicas는 Isr 개수를 봄. 그래서 이론에서 본 "위험한 상태로 쓰느니 차라리 막는다"가 여기서 판정됨.
3. RF를 3으로 주면 어떻게 되나
브로커가 1대인데 일부러 RF=3으로 만들어봤음.
docker exec keeping-kafka /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 \
  --create --topic test.fail --partitions 3 --replication-factor 3
Error while executing topic command : Unable to replicate the partition 3 time(s):
The target replication factor of 3 cannot be reached because only 1 broker(s) are registered.처음엔 RF를 "파티션당 브로커 3개를 부여"로 이해했는데 아니었음. 파티션 하나의 데이터를 3벌 복사해서 서로 다른 브로커에 흩어 놓는 것임.
브로커 1대일 때 RF=3을 시도하면
          브로커1
파티션0    사본, 사본, 사본  ← 같은 디스크에 3벌
이러면 의미가 없음. 복제의 목적은 "브로커가 죽어도 살아남기" 인데, 같은 브로커에 놓으면 목적이 사라짐. 그래서 카프카가 아예 거부함.
규칙: RF ≤ 브로커 수파티션은 토픽 소속, 배치는 브로커
여기서 헷갈렸던 게 정리됐음. 파티션 0,1,2는 브로커 수와 무관하게 항상 똑같음. 달라지는 건 "어디에 놓이느냐"뿐임.
| 파티션 구성 | 배치 | |
|---|---|---|
| 브로커 1대 | 0, 1, 2 | 전부 브로커1에 |
| 브로커 3대 (RF=1) | 0, 1, 2 | 브로커1→0, 브로커2→1, 브로커3→2 |
| 브로커 3대 (RF=3) | 0, 1, 2 | 셋 다 각 브로커에 사본으로 |
표로 보면 명확함.
              브로커1        브로커2        브로커3
파티션0        사본 ★        사본          사본        ← 가로 = 같은 파티션의 사본들
파티션1        사본          사본 ★        사본
파티션2        사본          사본          사본 ★
              ↑
              세로 = 이 브로커가 보관 중인 것들
가로로 읽으면 "파티션 0은 3대에 흩어져 있다" (토픽 관점)
세로로 읽으면 "브로커1은 파티션 0,1,2를 하나씩 갖고 있다" (브로커 관점)
둘 다 맞음. 같은 표를 다른 방향으로 읽는 것뿐임.
파티션의 소속(이름)  →  토픽    ("test.hello의 0번")    ← 절대 안 바뀜
파티션의 위치(저장)  →  브로커  ("브로커2에 있음")       ← 옮겨질 수 있음
4. 메시지 보내고 받기
터미널 2개를 띄웠음.
창 A — 컨슈머
docker exec -it keeping-kafka /opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 --topic test.hello --from-beginning
실행하면 아무것도 안 나오고 멈춤. 처음엔 고장난 줄 알았는데 정상임. 메시지를 기다리는 중임. 이론에서 본 while(true) { poll() } 루프가 이렇게 생겼음.
창 B — 프로듀서
docker exec -it keeping-kafka /opt/kafka/bin/kafka-console-producer.sh \
  --bootstrap-server localhost:9092 --topic test.hello
> 프롬프트가 뜨고, 아무거나 치고 Enter를 누르면 창 A에 바로 나타남. Enter 한 번 = 메시지 하나임.
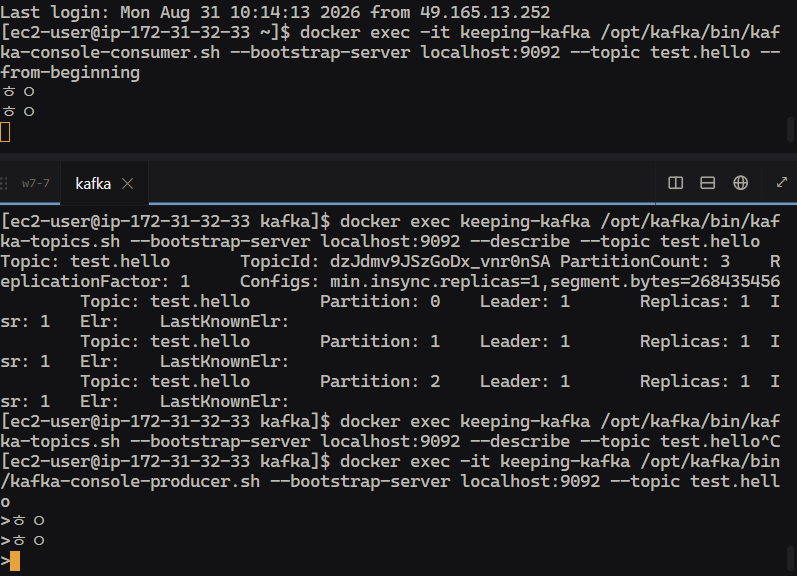
창B 프로듀서 → 브로커가 파티션 하나 골라 저장 → 창A 컨슈머가 읽어감어느 파티션에 갔는지 보기
컨슈머에 옵션을 붙이면 파티션 번호까지 보여줌.
docker exec -it keeping-kafka /opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 --topic test.hello --from-beginning \
  --property print.partition=true \
  --property print.key=true \
  --property print.offset=true \
  --property key.separator=" | "
Partition:1 | Offset:0 | null | ㅎㅇ
Partition:1 | Offset:1 | null | 안녕
Partition:1 | Offset:2 | null | 두번째
Partition:1 | Offset:3 | null | 세번째키가 없는데 왜 계속 파티션 1이지?
이론에서는 "키가 없으면 라운드로빈"이라고 배웠는데 전부 1번으로만 갔음. 찾아보니 요즘 카프카(3.3+)는 sticky(끈적이) 방식을 씀.
파티션 하나를 골라서 → 그 파티션에 batch.size(기본 16KB)가 쌓일 때까지 계속 거기로
                    → 그 다음 다른 파티션으로
메시지가 "ㅎㅇ" 같은 몇 바이트라 16KB를 채우려면 한참 걸림. 그래서 계속 1번에만 감. 옛날 카프카는 진짜 라운드로빈이었는데 네트워크 효율 때문에 뭉쳐 보내도록 바뀐 것임.
5. 키를 주면 파티션이 정해진다
프로듀서를 키 모드로 다시 띄웠음.
docker exec -it keeping-kafka /opt/kafka/bin/kafka-console-producer.sh \
  --bootstrap-server localhost:9092 --topic test.hello \
  --property parse.key=true --property key.separator=:
이제 키:값 형식으로 침.
>42:첫번째결제
>77:다른고객
>12:또다른고객
>10:근데 왜 파티션이 같지?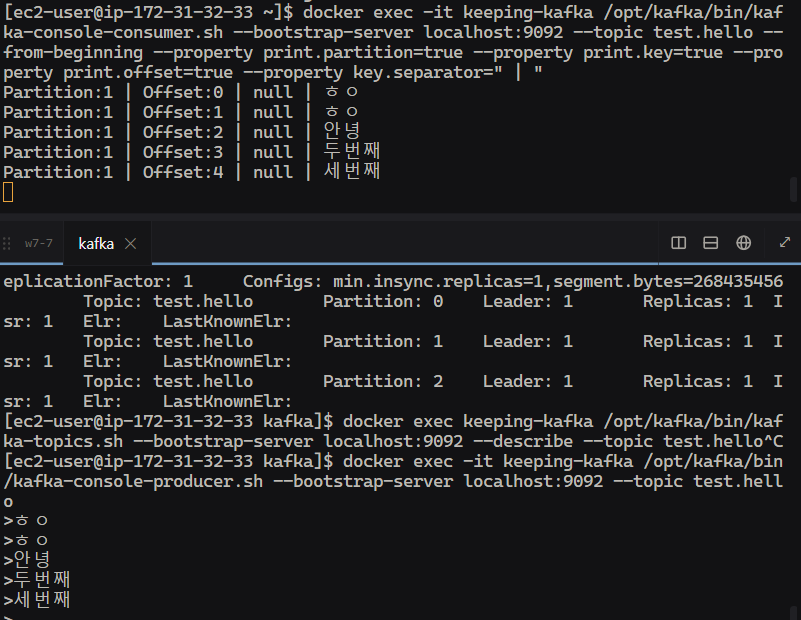
Partition:1 | Offset:5 | 42 | 첫번째결제
Partition:1 | Offset:6 | 77 | 다른고객
Partition:1 | Offset:8 | 12 | 또다른고객
Partition:1 | Offset:9 | 10 | 근데 왜 파티션이 같지?
키를 다르게 줬는데 또 전부 파티션 1임. 이상해서 카프카가 쓰는 해시 함수(murmur2)를 직접 구현해서 계산해봤음.
키 42  →  파티션 1
키 77  →  파티션 1
키 12  →  파티션 1
키 10  →  파티션 1
우연이었음. 하필 고른 4개가 전부 1로 떨어졌음. 확률 1/81짜리를 뽑은 거였음.
갈라지는 키를 계산해서 다시 해봤음
| 파티션 | 키 |
|---|---|
| 0 | 1, 5, 7, 8, 11 |
| 1 | 4, 6, 10, 12, 13 |
| 2 | 2, 3, 9, 16, 29 |
>1:파티션0으로가야함
>2:파티션2로가야함
>3:파티션2로가야함
>4:파티션1로가야함
Partition:0 | Offset:0 | 1 | ...
Partition:2 | Offset:0 | 2 | ...
Partition:2 | Offset:1 | 3 | ...
Partition:1 | Offset:10 | 4 | ...계산과 정확히 일치했음.
key % 3이 아니라 hash(key) % 3임
이것도 오해하고 있었음. 실제 수식은 이럼.
파티션 = ( murmur2(키의 바이트) & 0x7fffffff ) % 파티션수계산 과정을 찍어보면 이럼.
키 "1"   바이트 [49]      murmur2 = 2301521807  →  양수화 154038159   %3 = 0
키 "2"   바이트 [50]      murmur2 =  648968168  →  양수화 648968168   %3 = 2
키 "3"   바이트 [51]      murmur2 = 3146801791  →  양수화 999318143   %3 = 2
키 "4"   바이트 [52]      murmur2 = 1514888353  →  양수화 1514888353  %3 = 1
키 "42"  바이트 [52,50]   murmur2 =  417700972  →  양수화 417700972   %3 = 1
왜 그냥 나누지 않냐면 두 가지 이유가 있음.
첫째, 키가 숫자가 아닐 수 있음. "user-abc-123", UUID, "seoul-store-01" 같은 걸 어떻게 % 3 하나. 키는 숫자가 아니라 그냥 바이트 덩어리임. "42"도 숫자 42가 아니라 문자 '4','2' = 바이트 [52, 50] 임.
둘째, 그냥 나누면 쏠림. userId가 전부 짝수라거나 ID를 100 단위로 발급한다면 규칙적으로 편향됨. 해시는 입력이 규칙적이어도 결과를 골고루 흩뜨림. 그게 존재 이유임.
같은 키를 반복해서 보내보면
>1:첫번째
>1:두번째
>1:세번째
Partition:0 | Offset:2 | 1 | 첫번째
Partition:0 | Offset:3 | 1 | 두번째
Partition:0 | Offset:4 | 1 | 세번째전부 같은 파티션, offset만 올라감. 해시는 같은 입력에 항상 같은 값을 내니까 당연한 결과임. 이론에서 본 "같은 key는 같은 Partition"이 이렇게 확인됨.
6. offset은 파티션마다 독립적임
여기서 하나 정리됨. offset은 키와 무관함.
키       →  어느 파티션에 갈지만 정한다
파티션   →  들어온 순서대로 offset을 붙인다   ← 키 안 봄
실제 출력이 증거임.
Partition:1 | Offset:0  | null      ┐
Partition:1 | Offset:1  | null      │ 키가 전부 다른데
Partition:1 | Offset:4  | null      │ (null, null, 42, 77, 4)
Partition:1 | Offset:5  | 42        │
Partition:1 | Offset:6  | 77        │ 같은 파티션이라
Partition:1 | Offset:10 | 4         ┘ offset은 그냥 순서대로 올라감
파티션은 "줄"이고, offset은 "그 줄에서 몇 번째"일 뿐임. 누가 왔는지는 안 따짐.
파티션 0:  [offset 0] [offset 1] [offset 2] ...
파티션 1:  [offset 0] [offset 1] ...
파티션 2:  [offset 0] [offset 1] [offset 2] ...
           ↑ 각자 0부터 독립적으로 센다
정확히 말하면 이렇게 됨.
같은 키     →  같은 파티션에 간다       (키의 역할)
같은 파티션 →  offset 순서대로 쌓인다   (파티션의 역할)
─────────────────────────────────────
결과: 같은 키끼리는 순서가 보장된다
둘이 합쳐져서 순서 보장이 나오는 거지, 키가 offset을 정하는 게 아님.
7. 컨슈머 그룹과 LAG
지금까지 쓴 컨슈머는 이름 없는 임시 그룹이라 오프셋이 안 남음. 이름을 줬음.
docker exec -it keeping-kafka /opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 --topic test.hello \
  --group demo-group \
  --property print.partition=true --property print.offset=true --property print.key=true
--group demo-group 하나만 추가됐음.
--from-beginning을 빼니 기존 메시지가 안 나왔음
새 그룹이라 오프셋 기록이 없는데, 콘솔 컨슈머의 기본값이 latest(지금부터) 였음.
earliest  →  맨 처음부터 읽어라
latest    →  지금 이후 새 것만 읽어라   ← 콘솔 컨슈머 기본값
8. 하이라이트 — 컨슈머를 죽여놓고 메시지를 보내봤음
이게 오늘의 핵심이었음.
1) 컨슈머를 껐음 (Ctrl+C)
2) 프로듀서로 4개를 보냈음
>1:죽은동안1
>1:죽은동안2
>1:죽은동안3
>1:죽은동안4
에러 없이 >만 계속 떴음. 브로커는 잘 받았음. 컨슈머가 없는 건 브로커가 신경 안 씀.
3) LAG을 확인했음
docker exec keeping-kafka /opt/kafka/bin/kafka-consumer-groups.sh \
  --bootstrap-server localhost:9092 --describe --group demo-group
Consumer group 'demo-group' has no active members.
GROUP TOPIC PARTITION CURRENT-OFFSET LOG-END-OFFSET LAG
demo-group test.hello 2 3 3 0
demo-group test.hello 0 6 10 4 ← 4개 밀림
demo-group test.hello 1 11 11 0
| 칸 | 뜻 |
|---|---|
CURRENT-OFFSET | 컨슈머가 어디까지 읽었나 (책갈피 위치) |
LOG-END-OFFSET | 브로커에 어디까지 쌓였나 |
LAG | 둘의 차이 = 아직 안 읽은 개수 |
키를 1로만 보냈으니 전부 파티션 0으로 갔고, 거기만 LAG 4임.
has no active members — 컨슈머는 죽었는데 메시지는 멀쩡히 브로커에 있음.
4) 컨슈머를 다시 켰음
Partition:0 | Offset:6 | 1 | 죽은동안1
Partition:0 | Offset:7 | 1 | 죽은동안2
Partition:0 | Offset:8 | 1 | 죽은동안3
Partition:0 | Offset:9 | 1 | 죽은동안4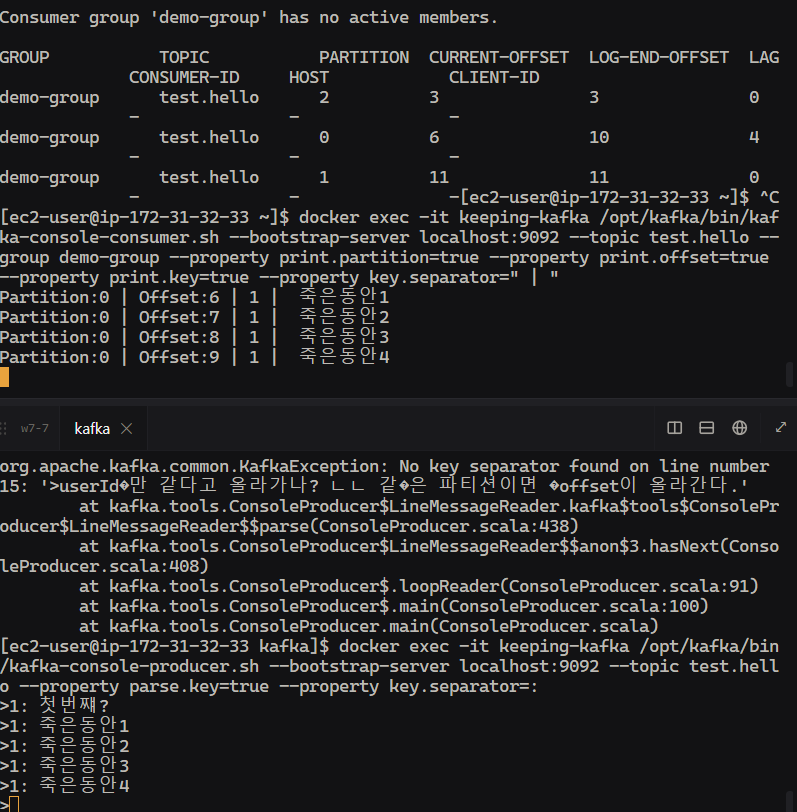
하나도 안 사라졌음. 책갈피(offset 6)부터 이어서 읽었음.
5) LAG이 0으로 돌아왔음
demo-group   test.hello   0          10              10              0
                                     ^^ OffSet이 따라잡음!
이게 왜 중요하냐면
같은 상황을 HTTP로 했다면 이렇게 됐을 것임.
A서버 → B서버 HTTP POST → B서버 죽어있음 → 타임아웃 → 서킷 열림
                                          → log.warn → 끝
                                          4건 전부 소멸
Kafka는 속도 차이를 "지연"으로 바꾸고, HTTP는 속도 차이를 "유실"로 바꿈. 이 한 문장이 오늘 실습의 결론임.
컨슈머가 없어도 오프셋 기록이 브로커에 남아 있다는 게 핵심임.
컨슈머   = 실행 중인 프로세스     ← 껐다 켰다 하는 것
오프셋   = 브로커 디스크의 기록   ← 계속 남아 있는 것
도서관으로 생각하면 이해가 쉬움. 책을 읽다가 집에 갔음. 사람은 없지만 책갈피는 책에 꽂혀 있음. 내일 다시 와서 책갈피 자리부터 읽으면 됨.
컨슈머 = 사람 / 오프셋 = 책갈피 / 브로커 = 도서관LAG으로 상태를 읽는 법
| LAG | 뜻 |
|---|---|
| 0 | 실시간으로 잘 따라가는 중 |
| 일정하게 유지 | 생산 속도 = 소비 속도. 밀린 채로 균형 |
| 계속 오름 | 컨슈머가 못 따라간다 |
| 갑자기 큼 | 컨슈머가 죽어 있었다 |
9. 오늘 정리된 것
이론으로 볼 땐 흐릿했는데 직접 해보니 명확해진 것들임.
| 이론으로 볼 때 | 직접 해보니 | |
|---|---|---|
--bootstrap-server | 실행할 곳인 줄 | 요청 보낼 상대. MySQL의 -h와 같음 |
kafka-topics.sh | 카프카의 일부 | 클라이언트임. 브로커와 별개 프로그램 |
| RF | 복제 개수 | 서로 다른 브로커에 놓아야 의미 있음. RF ≤ 브로커 수 |
| 파티션 | 토픽을 쪼갠 것 | 소속은 토픽, 배치는 브로커. 두 축임 |
| 키 → 파티션 | key % 파티션수 | murmur2(키바이트) % 파티션수 |
| 키 없을 때 | 라운드로빈 | sticky. 16KB 찰 때까지 한 파티션에 몰림 |
| offset | 메시지 번호 | 파티션마다 독립. 키와 무관 |
| 컨슈머 그룹 | 컨슈머 묶음 | 오프셋이 저장되는 단위. 컨슈머가 죽어도 기록은 남음 |
| LAG | 밀린 정도 | LOG-END-OFFSET − CURRENT-OFFSET |