해당 코드에서 이상한 점 찾기
DROP DATABASE IF EXISTS practice_ax;
CREATE DATABASE practice_ax DEFAULT CHARACTER SET utf8mb4;
USE practice_ax;
DROP TABLE IF EXISTS users;
CREATE TABLE users (
user_id VARCHAR(10) PRIMARY KEY,
nameVARCHAR(50),
dept VARCHAR(20),
joined_date DATE,
phone VARCHAR(20)
);
INSERT INTO users (user_id,name, dept, joined_date, phone) VALUES
('U001', '직원1', '개발', '2019-03-12', '010-1111-0001'),
('U002', '직원2', '기획팀', '2021-07-25', '010-1111-0002'),
('U003', '직원3 ', 'dev', NULL, '010-1111-0003'),
('U004', '직원4', '기획', '2015-11-02', '010-1111-0004'),
('U005', '직원5', 'Dev', '2024-05-19', NULL),
('U006', '직원6', NULL, '2020-09-30', '010-1111-0006'),
('U007', '직원7', '개발', '2012-01-15', '010-1111-0007'),
('U008', '직원8', 'planning', '2023-12-08', '010-1111-0008'),
('U009', '직원9', '개발팀', NULL, '010-1111-0009'),
('U010', '직원10', '기획', '2018-06-21', '010-1111-0010'),
('U011', '직원11', 'DEV ', '2017-04-17', '010-1111-0011'),
('U012', '직원12', '기획팀', '2026-02-14', '010-1111-0012');
DROP TABLE IF EXISTS sessions;
CREATE TABLE sessions (
session_id VARCHAR(10) PRIMARY KEY,
user_id VARCHAR(10),
started_at DATETIME,
ended_at DATETIME,
channel VARCHAR(20)tgrfh
);
INSERT INTO sessions (session_id, user_id, started_at, ended_at, channel) VALUES
('S001', 'U001', '2026-08-24 09:10:00', '2026-08-24 09:25:00', '웹'),
('S002', 'U002', '2026-08-24 10:05:00', NULL, '슬랙'),
('S003', 'U003', '2026-08-25 14:20:00', '2026-08-25 14:02:00', '웹'), # 시간역행
('S004', 'U004', '2026-08-26 11:00:00', '2026-08-26 11:40:00', '앱'),
('S005', 'U001', '2026-08-27 16:30:00', '2026-08-27 16:38:00', '웹'),
('S006', 'U007', '2026-08-27 09:00:00', '2026-08-27 13:30:00', '웹'),
('S007', 'U008', '2026-08-28 15:10:00', '2026-08-28 15:18:00', '슬랙'),
('S008', 'U011', '2026-08-31 10:20:00', NULL, '앱'),
('S009', 'U004', '2026-08-31 13:45:00', '2026-08-31 13:55:00', '웹'),
('S010', 'U012', '2026-09-01 09:30:00', '2026-09-01 09:42:00', '웹');
DROP TABLE IF EXISTS chat_logs;
CREATE TABLE chat_logs (
log_id VARCHAR(10) PRIMARY KEY,
user_id VARCHAR(10),
model_name VARCHAR(30),
question VARCHAR(100),
latency_ms INT,
status VARCHAR(10),
created_at DATETIME
);
INSERT INTO chat_logs (log_id, user_id, model_name, question, latency_ms, status, created_at) VALUES
('Q001', 'U001', 'claude-sonnet', '연차 이월 규정 알려줘', 950, 'ok', '2026-08-24 09:11:00'),
('Q002', 'U001', 'Claude-Sonnet', '재택근무 신청 어떻게 해?', 1400, 'ok', '2026-08-24 09:15:00'),
('Q003', 'U002', 'claude-sonnet', '법인카드 한도가 얼마야?', 2100, 'ok', '2026-08-24 10:06:00'),
('Q004', 'U002', 'claude-sonnet', '법인카드 한도가 얼마야?', 2100, 'ok', '2026-08-24 10:06:00'),
('Q005', 'U004', 'claude-sonnet', '출장비 정산 기한 알려줘', 650, 'ok', '2026-08-26 11:05:00'),
('Q006', 'U007', 'claude-sonnet', '보안 교육 이수 기준이 뭐야?', -50, 'ok', '2026-08-27 09:05:00'), # 레이턴시 시간이 -?
('Q007', 'U007', 'claude-sonnet', '사내 VPN 설정 방법 알려줘', 999999, 'ok', '2026-08-27 09:20:00'),
('Q008', 'U001', 'gpt-4o', '경조사 지원금 규정 알려줘', 1100, 'ok', '2026-08-27 16:31:00'),
('Q009', 'U004', 'GPT-4o', '명함 신청 절차가 어떻게 돼?', 1250, 'ok', '2026-08-31 13:47:00'),
('Q010', 'U008', 'gpt-4o ', '회의실 예약 방법 알려줘', 990, 'ok', '2026-08-28 15:11:00'),
('Q011', 'U011', 'claude-sonnet', '퇴직금 중간정산 조건 알려줘', NULL, 'ok', '2026-08-31 10:22:00'),
('Q012', 'U012', 'claude-sonnet', '수습기간 평가 기준이 뭐야?', 880, 'ok', '2026-09-01 09:31:00'),
('Q013', 'U004', 'CLAUDE-SONNET ', '야근 식대 한도 알려줘', 1300, NULL, '2026-08-31 13:50:00'),
('Q014', 'U002', 'gpt-4o', '자기계발비 사용처 알려줘', 1420, 'ok', '2026-08-24 10:15:00');
SELECT COUNT() AS users_cnt FROM users; -- 12
SELECT COUNT() AS sessions_cnt FROM sessions; -- 10
SELECT COUNT() AS logs_cnt FROM chat_logs; -- 14
select
from users;
select
from sessions;
select
from chat_logs;
해당 코드에서 이상한 점을 찾는 문제가 나왔다. 내가 생각하기에는 어디가 이상한지 작성하는 것이였는데
1)
('S003', 'U003', '2026-08-25 14:20:00', '2026-08-25 14:02:00', '웹'),
- 시간역행
2)
('Q006', 'U007', 'claude-sonnet', '보안 교육 이수 기준이 뭐야?', -50, 'ok', '2026-08-27 09:05:00'),
- 레이턴시 시간이 마이너스
3)
대소문자 통일화 안됨 (Ex : Dev, dev DEV) / 한글와 영어 혼용 ( Ex : 개발, dev) / 한글 명칭 통일화 안됨 ( Ex : 개발, 개발팀)
4)
('Q003', 'U002', 'claude-sonnet', '법인카드 한도가 얼마야?', 2100, 'ok', '2026-08-24 10:06:00'),
('Q004', 'U002', 'claude-sonnet', '법인카드 한도가 얼마야?', 2100, 'ok', '2026-08-24 10:06:00'),
- 같은 목록이 2번 동일한 시간에 작성되어있음
5)
('Q011', 'U011', 'claude-sonnet', '퇴직금 중간정산 조건 알려줘', NULL, 'ok', '2026-08-31 10:22:00'),
- status가 ok인데 latency_ms가 null
('Q011', 'U011', 'claude-sonnet', '퇴직금 중간정산 조건 알려줘', NULL, 'ok', '2026-08-31 10:22:00'),- status가 null인데 latency_ms에 시간이 찍혀있음.
6)
('S002', 'U002', '2026-08-24 10:05:00', NULL, '슬랙'),
('S008', 'U011', '2026-08-31 10:20:00', NULL, '앱'),
- 세션 2개가 끝나지 않고있음
나는 이렇게 작성했다.
이게 문법적으로 맞는 코드인가?를 고민해보고 하나하나 확인해봤는데 문법적인걸 따져보기전에 3번처럼 왜 대소문자 통일, 한영통일 등을 안했지? 라던지 6번처럼 세션이 시작은 했는데 끝나지 않았음 등 기초적으로 이상한점이 몇몇개 보였다.
-
Dirty point
-
도메인 지식에서 나온 지적
latency_ms는 음수면 안됨
데이터 누락
시간의 전후 > 시작 종료가 맞아야함
부서명 - 한/영 이슈
중복데이터 -
설계차원에서 나온 지적
not null
테이블명 id 규칙 (id는 숫자만)
타입의 크기 -> 과하게 큼 (name varchar(50)같은거)
연계키의 누락 -> session과 chat_log의 연관이 없었다
index
unsigned
default > 시간에 대해서
-
-
내가 생각하지 못했던것 / 놓친것 / 그냥 넘긴것
-
1)
위 코드에선 user_id를 'U001'과 같이 작성해놨는데 이걸 굳이 쓸 이유가 없이 번호로만 붙여도 되는 것이였다. 나는 그냥 u001이구나 하면서 넘겼는데 계속 사원이 입,퇴사를 하게된다면 이걸 일일히 수정해야한다는 문제점이 있다. 그래서 user_id를 varchar(10)에서 int(10)으로 바꿔,숫자만 들어가게 해준다.
그리고 id는 음수가 나오면 안되니 unsigned를 붙여주고 null값이 나와도 안되니 not null, 중복값이 존재해서도 안되느 primary key, 알아서 증가하게끔 auto_increment를 붙여준다.
user_id varchar(10) primary key # 수정 전
user_id int(10) unsigned not null primary key auto_increment # 수정 후
2)
데이터 입력에 종종 공백이 존재함.
================================================================
문제풀이
위 데이터베이스를 기반으로 푸는 문제
문제 1. users에서 입사일(joined_date)이 비어 있는 직원이 몇 명인가? (힌트: COUNT(*) vs COUNT(컬럼))
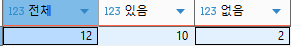
select count() as '전체', count(joined_date) as '있음', count()-count(joined_date) as'없음'
from users;
이건 강사님의 풀이이다. users 테이블의 모든걸 count하는걸 전체라는 이름을 사용하고 joined_date를 count하는 코드를 있음이라고 한 후에
(*)전체 - (joined_date)있음 = null 값이다.
select count(*)
from users
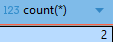
where joined_date is null;
이건 내가 풀었던 방식이다. users 테이블 전체를 불러온 뒤에 joined_date 값이 null인 값만 출력한다.
문제 2. chat_logs에서 같은 유저·같은 질문·같은 시각에 2번 이상 들어간 로그를 찾아보자. (힌트: GROUP BY + HAVING)
select
from chat_logs;
select
from chat_logs
group by user_id,question,created_at
having count(*) >= 2;
group by user_id,question,created_at을 작성해서 user_id,question,created_at 이걸 그룹으로 묶어주고 같은 값이 2개 이상인 값만 추려낸다.

문제 3. chat_logs.latency_ms 중 0보다 작거나 60000(1분)을 넘는 값을 찾아보자. 왜 문제일까? 그리고 sessions에도 논리적으로 말이 안 되는 행이 하나 있다. 찾아보자
select
from chat_logs;
select
from chat_logs
where latency_ms < 0 or latency_ms > 60000;
- 위부터 첫번째 줄이라고 했을때 첫,두번째 줄은 단순 테이블을 확인하기 위한 코드이고 그 밑 세버째줄부터가 문제풀이의 줄이다. where문을 사용해서 latency_ms가 0보다 작거나 60000보다 큰 조건을 걸어주고 맞는 값을 구한다.

select *
from sessions
where ended_at < started_at;
- ended_at < started_at이라는 조건을 줘서 시작 시간이 끝나는 시간보다 느린 값을 찾아낸다.

문제 4. users.dept(개발/dev/Dev/개발팀/DEV, 기획/기획팀/planning, NULL)를 개발/기획/미상 셋으로 통일해보자. (힌트: CASE + LOWER + TRIM)
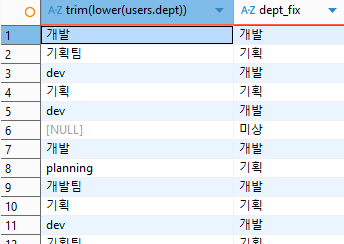
select trim(lower(users.dept)),
case
when dept = '개발' then '개발'
when dept = 'dev' then '개발'
when dept = '개발팀' then '개발'
when dept = '기획' then '기획'
when dept = '기획팀' then '기획'
when dept = 'planning' then '기획'
else '미상'
end as dept_fix
from users;
내가 풀었던 방식인데 밑에 코드에 비해서 길고 비슷한 구간이 반복된다는 문제점이 있다.
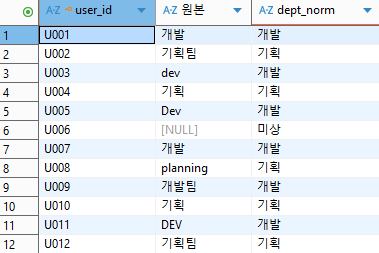
select user_id, dept as '원본',
case
when lower(trim(dept)) in ('dev','개발','개발팀') then '개발'
when lower(trim(dept)) in ('planning','기획','기획팀') then '기획'
else '미상'
end as dept_norm
from users;
user_id,dept를 '원본'이라는 이름으로 지정해주고, dept의 데이터들을 lower을 사용해서 다 소문자로 만들어주고 trim을 사용해서 데이터 사이의 공백을 없애준다.
그리고 dev,개발,개발팀을 개발이라는 이름으로 바꿔주고, planning,기획,기획팀은 기획이라는 이름으로 바꿔준다.
이 두가지에 적용되지 않는 null값은 미상이라고 표시되게 바꾼다 이렇게 바꾸고 출력된 테이블의 이름을 dept_norm이라고 설정한다.
문제 5. chat_logs.model_name을 정리해 실제 모델이 몇 종인지 확인해보자. (힌트: TRIM, LOWER, DISTINCT)
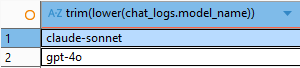
select trim(lower(chat_logs.model_name))
from chat_logs
group by model_name;
chat_logs.model_name을 lower을 사용해서 소문자로 만들어준 다음에, trim을 사용해서 공백 제거 이후 model_name으로 합친다.
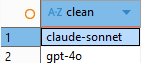
select distinct lower(trim(model_name)) as clean from chat_logs;
앞에 distinct를 붙여서 중복값을 제거한다.
문제 6. 부서가 NULL이면 '미상', status가 NULL이면 'unknown'으로 채우자. (힌트: COALESCE)
select
from users;
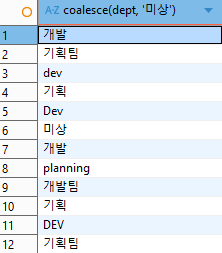
select coalesce(dept, '미상')
from users;
select
from chat_logs;
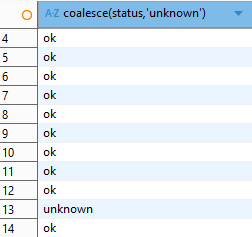
select coalesce(status,'unknown')
from chat_logs;
coalesce(dept,'미상')을 사용해서 dept에 있는 null값을 미상이라는 값으로 바꿔주고 coalesce(status, 'unknown')를 사용해서 status에 있는 null 값을 unknown으로 바꿔준다.
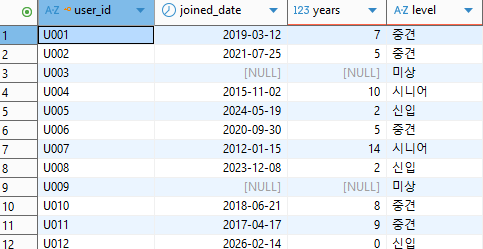
#문제 7. 입사일로 근속연수를 구하고 신입(3년미만)/중견(3~9년)/시니어(10년이상)으로 분류하자. 입사일이 없으면 '미상'. (힌트: TIMESTAMPDIFF(YEAR, ...))
select user_id,joined_date,
timestampdiff(year,joined_date, curdate()) as years,
case
when joined_date is null then '미상'
when timestampdiff(year,joined_date,curdate()) < 3 then '신입'
when timestampdiff(year,joined_date,curdate()) < 10 then '중견'
else '시니어'
end as level
from users;
timestampdiff(year,joined_date, curdate()) as years 에서 timestampdiff는 두 날짜 또는 시간 사이의 차이를 지정한 단위(연,월,일,시,분,초 등)로 계산하는 함수이다. curdate()는 오늘의 날짜를 출력한다.
timestampdiff(year,joined_date, curdate()) 이 코드는 joined_date의 년도와 오늘의 년도를 출력하겠다는 의미이다.
timestampdiff(year,joined_date,curdate()) < 3 then '신입'
은 joined_date와 curdate()의 year 차가 3년 미만이면 신입,
10년 미만이면 중견 나머지는 시니어로 출력한다.
#문제 8. 세션 대화 시간(분)을 구해보자. 아직 안 끝난 세션은 어떻게 처리할까? (힌트: TIMESTAMPDIFF(MINUTE, ...))
select session_id, timestampdiff(minute, started_at,ended_at) as dur_min
from sessions
where ended_at is not null;
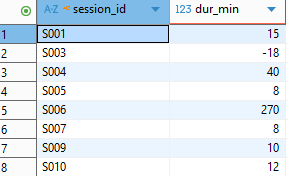
timestampdiff(minute, started_at,ended_at)에서 started_at와 ended_at의 분만 추출해서 dur_min이라는 이름을 붙이고,
그중 ended_at에서 not null만을 추출한다.
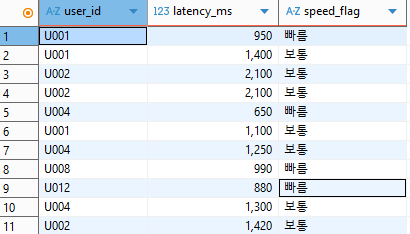
#문제 9. 응답시간에 빠름(1000ms미만)/보통/느림(3000ms이상) 플래그를 붙여보자. 단, 이상치는 빼고.
select user_id,latency_ms,
case
when latency_ms < 1000 then '빠름'
when latency_ms >= 3000 then '느림'
else '보통'
end as speed_flag
from chat_logs
where latency_ms between 0 and 60000;
latency_ms가 1000 미만이면 보통 3000 이상이면 느림 둘 다 해당 안되면 느림을 출력한다. 하지만 이 값의 제한은 0에서 60000이다.
#문제 10. 직원 이름·부서(정제본)·근속연수 + 세션 정보(채널·시작·종료·대화시간)를 합쳐 분석용 표를 만들어보자. 세션 없는 직원도 남아야 한다. (힌트: 어떤 JOIN?)
select *,
case
when lower(trim(dept)) in ('dev','개발','개발팀') then '개발'
when lower(trim(dept)) in ('planning','기획','기획팀') then '기획'
else '미상'
end as dept_norm,
timestampdiff(year,joined_date, curdate()) as years,
s.channel,s.started_at,s.ended_at,
timestampdiff(minute, started_at,ended_at) as dur_min
from users as u
left join sessions as s
on u.user_id = s.user_id
order by u.user_id;
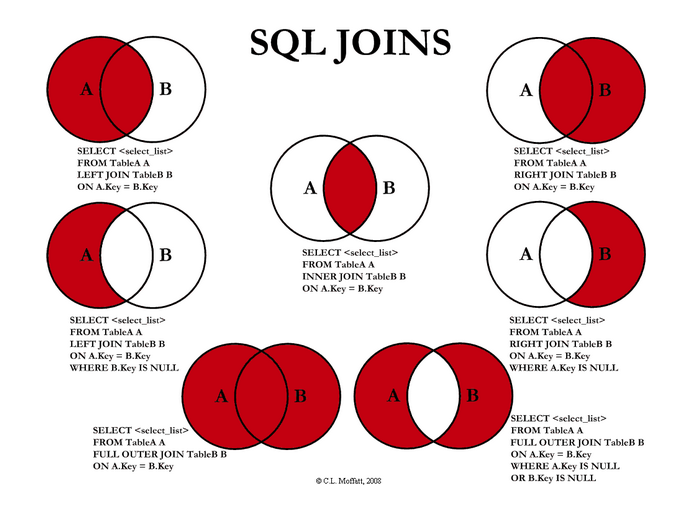
left join은 사진에서 보다시피 A의 값과 A값과 겹치는 B의 값을 합치는 결과를 출력한다. 사진을 보면 user_id가 똑같은것들이 붙어있는것을 알 수 있다.
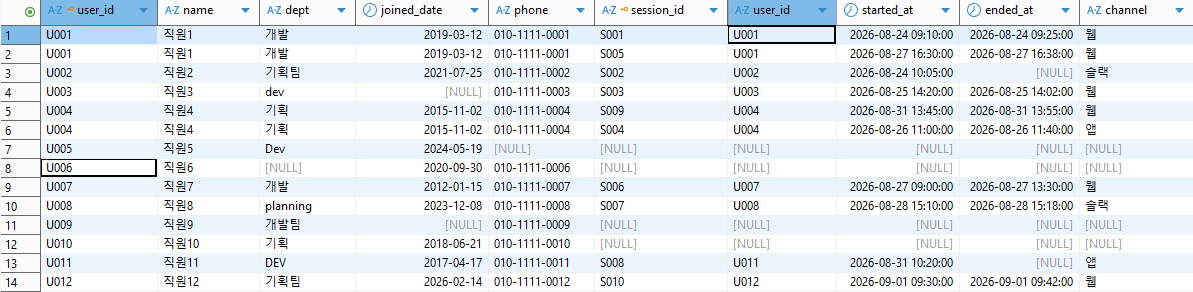
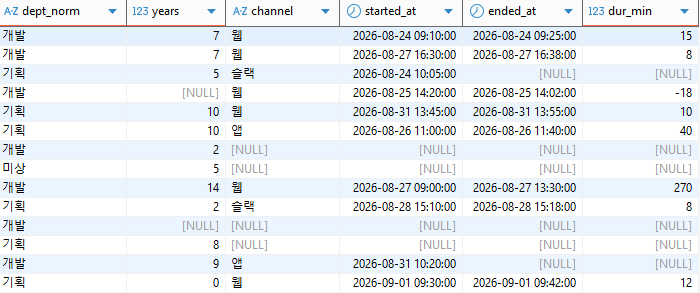
두번째 사진이 첫번째 사진 오른쪽으로 붙는다.
#문제 11. 부서(정제본)별·채널별 세션 건수를 요약해보자. (힌트: GROUP BY)
select case
when lower(trim(dept)) in ('dev','개발','개발팀') then '개발'
when lower(trim(dept)) in ('planning','기획','기획팀') then '기획'
else '미상'
end as dept_norm,
s.channel,count(*)
from users as u
join sessions as s
on u.user_id = s.user_id
group by 1,2;
group by 1,2는 첫번째와 두번째 컬럼으로 엮는다는 뜻이다, 그래서 dept_norm과 channel이 나오는 것이다.
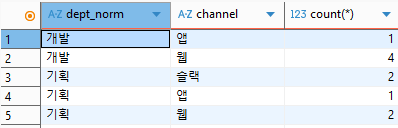
이를 통해 배운점 - 설계를 올바르게 해야 이상한 데이터가 입력되는걸 조금은 예방할 수 있다.
case - end를 사용해봤는데 마치 파이썬에서 배웠던 while문이나 if문 안에 또 다른 코드들을 집어넣는 느낌이 들어서 마냥 낯설게 느껴지지만은 않았다. 하지만 다른 명령어를 쓰기도 하고 그와에 따른 조합이 달라져서 아직 연습을 좀 해야할거 같다
CTAS(Create Table As Select)
DB에서 select문의 조회 결과를 바탕으로 새로운 테이블을 생성하는 SQL 구문이다.
