도전 1. 로컬 환경 구축
아나콘다 프롬프트에서 새 conda 환경 만들기
필요한 라이브러리 설치
- VS Code에서 .py 파일로 작업 환경 잡기 - 성공
VS code + 아나콘다를 사용하려고 찾다보니
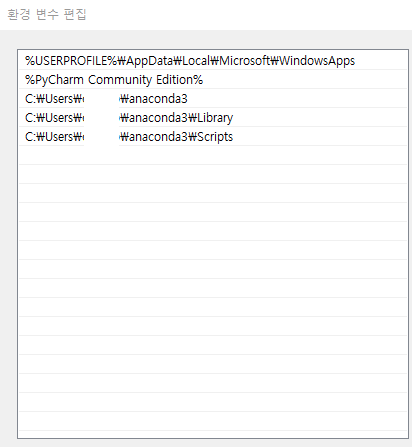
이런식으로 환경변수를 설정해줘야했다.
- .env 파일에 API 키 저장, python-dotenv로 불러오기 - 성공
.env 파일 내부에 OPENAI_API_KEY = '내 API 키'를 넣기
import os
from dotenv import load_dotenv
load_dotenv()
print(os.getenv('OPENAI_API_KEY'))
터미널에서 LLM API 한 번 호출해보기
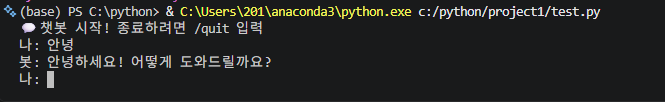
체크포인트 1 : 내 PC 터미널에서 API 호출 성공
도전 2. 문서 하나 잡고 RAG 만들기
문서를 하나 고른다
예) 우리 학교 학사규정, 근로기준법, 주택임대차보호법, 관심 있는 회사 규정 등
PDF가 다루기 편합니다
텍스트 추출 -> 정제 -> 청킹
내 문서에 맞는 청킹 기준을 직접 정해보세요 (조항 단위? 글자 수? 문단?)
임베딩 후 Chroma에 저장
PersistentClient 사용 -> 한 번 만든 임베딩은 디스크에 저장해두고 재사용
질문 -> 검색 -> 답변 흐름 완성
답변 끝에 근거(조항 번호, 페이지 등)가 나오도록
문서에 없는 내용은 "문서에서 확인되지 않습니다"라고 답하도록
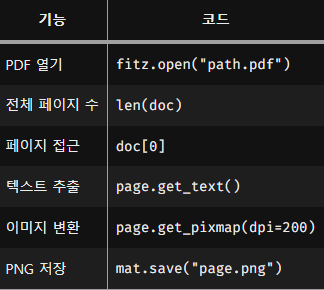
- 파이썬 PyMuPDF(fitz)
-> 파이썬에서 Pdf를 처리하기 위한 라이브러리로 Pdf 파일의 생성,수정,추출,텍스트 검색,이미지추출 등 다양한 작업을 수행할 수 있다. 불러올때는 PyMuPDF가 아닌 fitz로 불러온다(import fitz)
import os
import fitz
pdf_path = r"C:\Users\201\Downloads\도로교통법.pdf"
print("exists:", os.path.exists(pdf_path))
doc = fitz.open(pdf_path)
print("pages:", doc.page_count)
해당 코드를 사용하여 pdf 페이지 세기
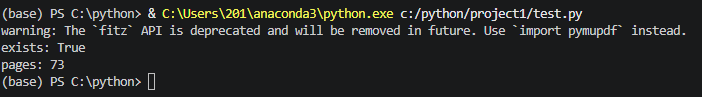
결과값 pages : 73이 나온걸 확인할 수 있다.
import fitz # PyMuPDF
doc = fitz.open(r"C:\Users\201\Downloads\도로교통법.pdf") # PDF 열기
for page in doc:
text = page.get_text()
print(text)
doc.close()
텍스트를 출력하는 코드이다.
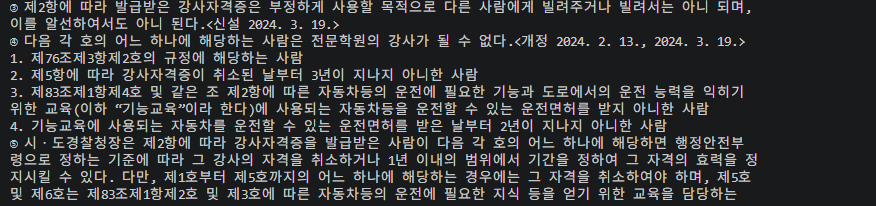
이런식으로 텍스트들이 잘 나온다.
import fitz # PyMuPDF
doc = fitz.open(r"C:\Users\201\Downloads\도로교통법.pdf") # PDF 열기
for page in doc:
text = page.get_text()
print(len(text))
doc.close()
print(len(text)를 했더니
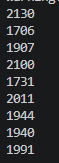
페이지마다의 텍스트 수를 표시해준다.
import fitz # PyMuPDF
import re
def extract_pdf_text(pdf_path):
doc = fitz.open(pdf_path)
full_text = ""
for page in doc:
text = page.get_text()
full_text += text + "\n"
return full_text
def clean_text(text):# PDF에서 흔한 깨짐/공백 정리 text = text.replace("\r", "\n") text = text.replace("\xa0", " ") text = re.sub(r"\n{3,}", "\n\n", text) text = re.sub(r"[ \t]+", " ", text) text = re.sub(r"\n +", "\n", text) text = re.sub(r" +\n", "\n", text) return text.strip()def chunk_text(text, chunk_size=500, overlap=50):
if not text:
return []
chunks = []
start = 0
while start < len(text):
end = min(start + chunk_size, len(text))
chunks.append(text[start:end])
if end == len(text):
break
start += chunk_size - overlap
return chunks
def pipeline(pdf_path, chunk_size=500, overlap=50):
raw_text = extract_pdf_text(pdf_path)
cleaned_text = clean_text(raw_text)
chunks = chunk_text(cleaned_text, chunk_size=chunk_size, overlap=overlap)
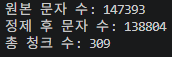
print(f"원본 문자 수: {len(raw_text)}")
print(f"정제 후 문자 수: {len(cleaned_text)}")
print(f"총 청크 수: {len(chunks)}")
for i, chunk in enumerate(chunks[:5]):
print(f"\n--- Chunk {i+1} ---")
print(chunk[:300])
print("...")
return cleaned_text, chunks
if name == "main":
pdf_path = r"C:\Users\201\Downloads\도로교통법.pdf"
cleaned_text, chunks = pipeline(pdf_path, chunk_size=500, overlap=50)
해당 자료들을 기반으로 한 챗봇
import os
import sys
from dotenv import load_dotenv
from openai import OpenAI
import chromadb
load_dotenv()
api_key = os.getenv("OPENAI_API_KEY")
if not api_key:
raise ValueError("OPENAI_API_KEY가 없습니다. .env 파일을 확인하세요.")
client = OpenAI(api_key=api_key)
DB_PATH = "./chroma_db"
COLLECTION_NAME = "pdf_chunks"
def embed_texts(texts):
response = client.embeddings.create(
model="text-embedding-3-small",
input=texts
)
return [item.embedding for item in response.data]
def get_collection(collection_name=COLLECTION_NAME):
chroma_client = chromadb.PersistentClient(path=DB_PATH)
try:
return chroma_client.get_collection(name=collection_name)
except Exception:
raise RuntimeError(
f"'{collection_name}' 컬렉션이 없습니다. 먼저 PDF를 ChromaDB에 저장하세요."
)
def search_law_context(question: str, collection_name=COLLECTION_NAME, n_results=5):
collection = get_collection(collection_name)
question_embedding = embed_texts([question])[0]
results = collection.query(
query_embeddings=[question_embedding],
n_results=n_results,
include=["documents", "metadatas", "distances"]
)
docs = results.get("documents", [[]])[0]
metas = results.get("metadatas", [[]])[0]
if not docs:
return []
context_parts = []
for i, doc in enumerate(docs):
context_parts.append(f"[출처 {i + 1}] {doc}")
return context_parts, metas
def answer_only_from_context(question: str, collection_name=COLLECTION_NAME, n_results=5):
context_parts, metas = search_law_context(question, collection_name, n_results)
if not context_parts:
return "해당 문서에 근거가 없습니다. 법률 문서에 있는 내용만 답할 수 있습니다."
context = "\n\n".join(context_parts)
system_prompt = """
당신은 법률 문서 기반 답변 도우미입니다.
아래 문맥만 사용해서 답하세요.
문맥에 없는 정보는 절대 추측하지 마세요.
문맥에 근거가 없으면 "문서에 근거가 없습니다."라고 답하세요.
답변은 간결하고, 한국어로 하세요.
가능한 경우 관련 조항, 근거 문구, 요점을 함께 말하세요.
"""
response = client.chat.completions.create(
model="gpt-4o-mini",
messages=[
{"role": "system", "content": system_prompt},
{
"role": "user",
"content": f"""
질문:
{question}
문맥:
{context}
"""
}
],
temperature=0.1,
max_tokens=800
)
return response.choices[0].message.content.strip()
def chat_loop():
print("법률 문서 챗봇 시작. 종료하려면 'quit' 입력")
while True:
q = input("\n질문: ").strip()
if q.lower() in ("quit", "q", "종료"):
print("챗봇 종료")
break
answer = answer_only_from_context(q)
print("\n답변:")
print(answer)
if name == "main":
chat_loop()
Github copilot을 사용함
관련 있는 질문

관련 없는 질문
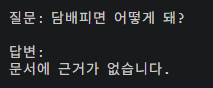
다만 법률 문서를 기반으로 하다보니 조금만 질문이 이상해지거나 간단해지면 바로 문서에 근거가 없다고 나온다.
이 코드를 짜면서 가장 애먹었던건 어떻게 구현을 할 것인가 와 계속되는 No module named였던거같다.
체크포인트 2 : 터미널에서 질문하면 근거가 붙은 답이 나온다
도전 3. AI로 화면 입히기
Streamlit으로 채팅 화면 만들기
AI에게 도전 2 코드를 주고 화면을 붙여달라고 요청해보세요
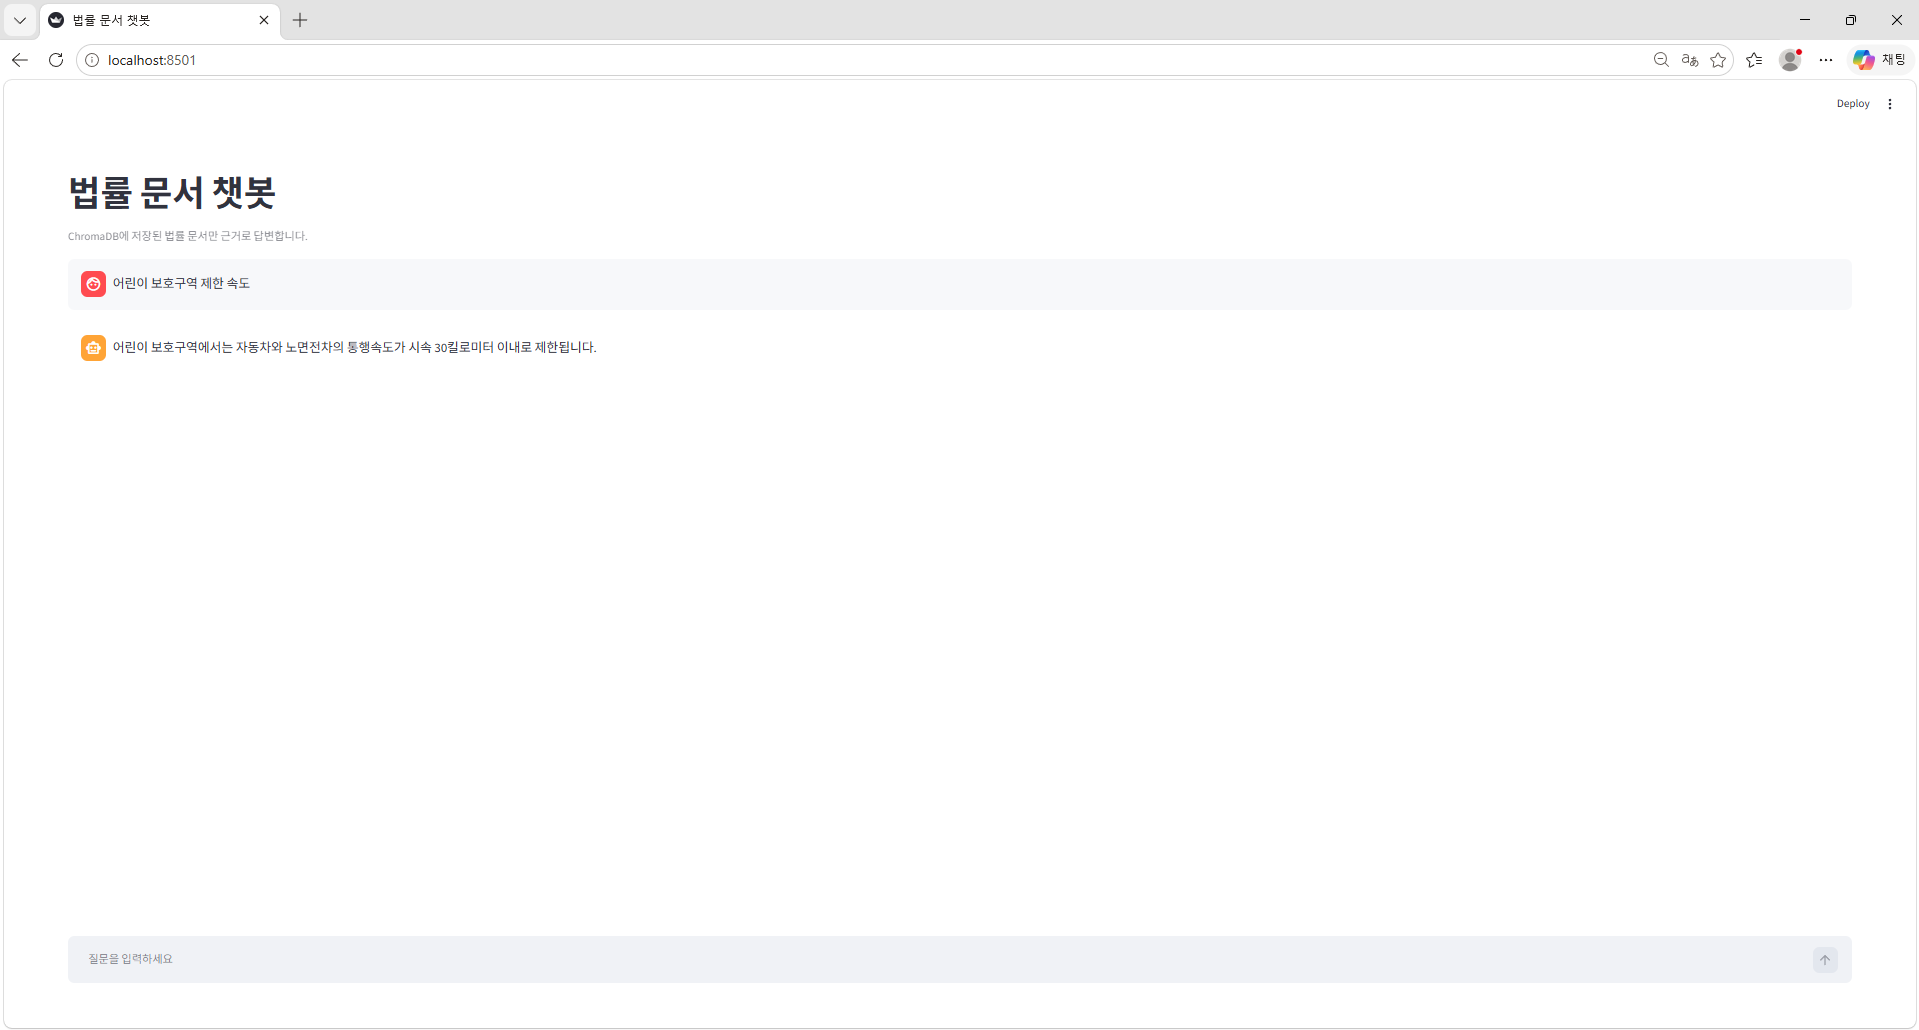
브라우저 localhost에서 질문하고 답변 받기
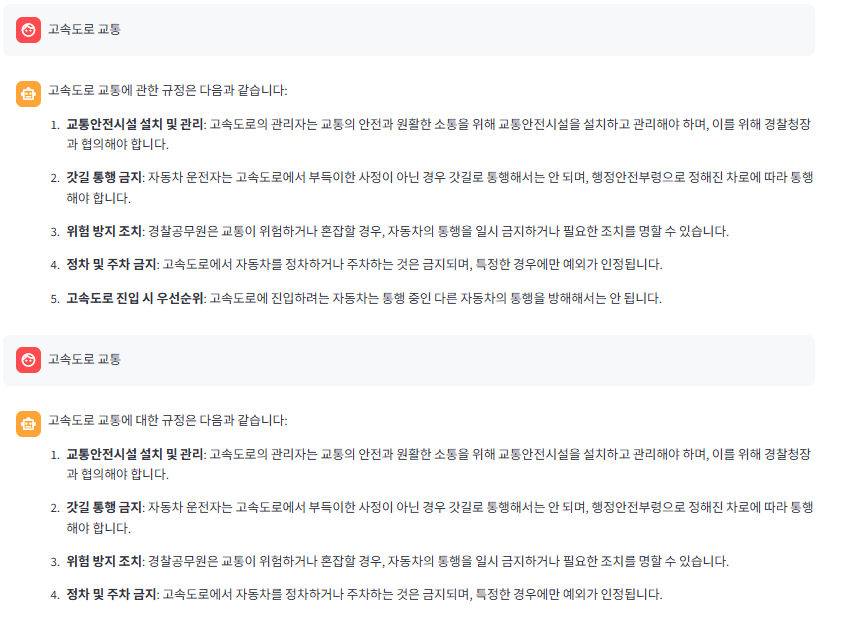
같은 질문을 던졌는데 답이 다르게 나오는 이슈가 있다.
-> 이것에 관련해 찾아보니 AI는 답변을 그때그때 정해서 내놓는것이 아닌 확률적 생성 방식이기때문에 답변의 내용이 조금씩 달라질 수 있다
화면이 느리거나 이상하면 왜 그런지 먼저 의심해보기
힌트 : Streamlit은 버튼을 누를 때마다 무엇을 다시 실행할까?
체크포인트 3 : 브라우저에서 질문하고 답과 근거를 본다
추가 과제
대화 이력 유지 (ROOT 6강 멀티턴 활용)
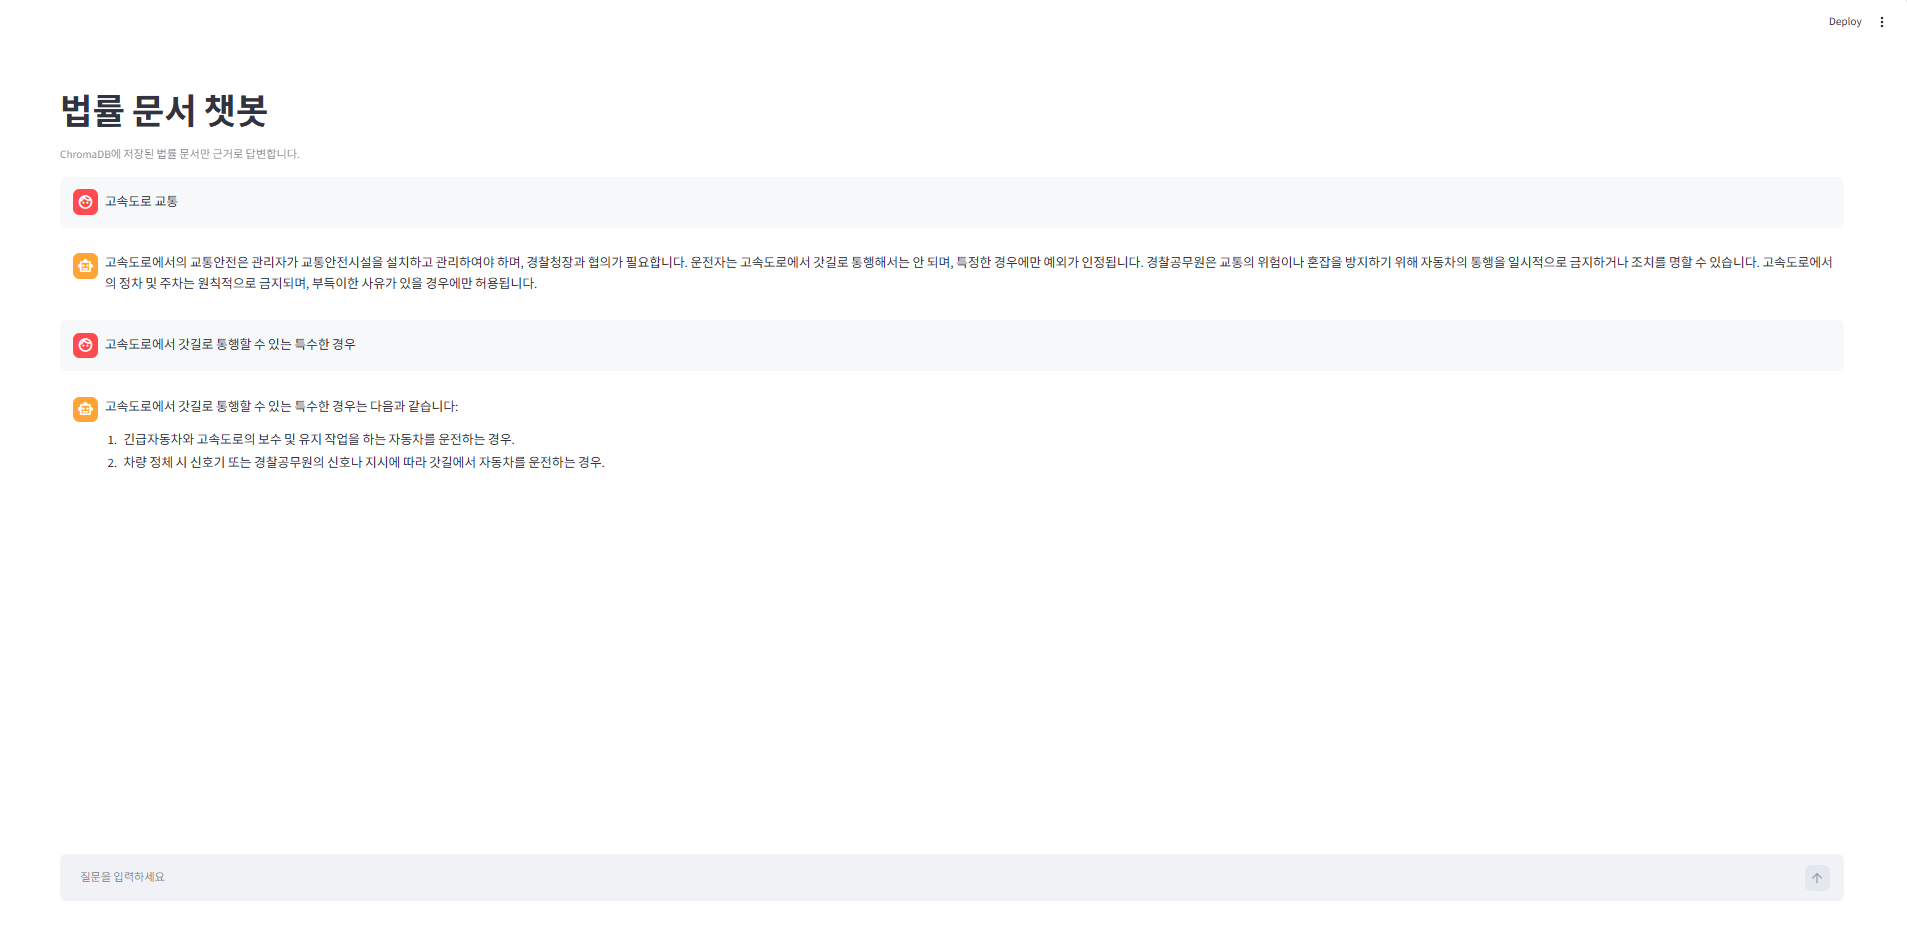
청킹 전략 2개를 화면에서 바꿔가며 결과 비교
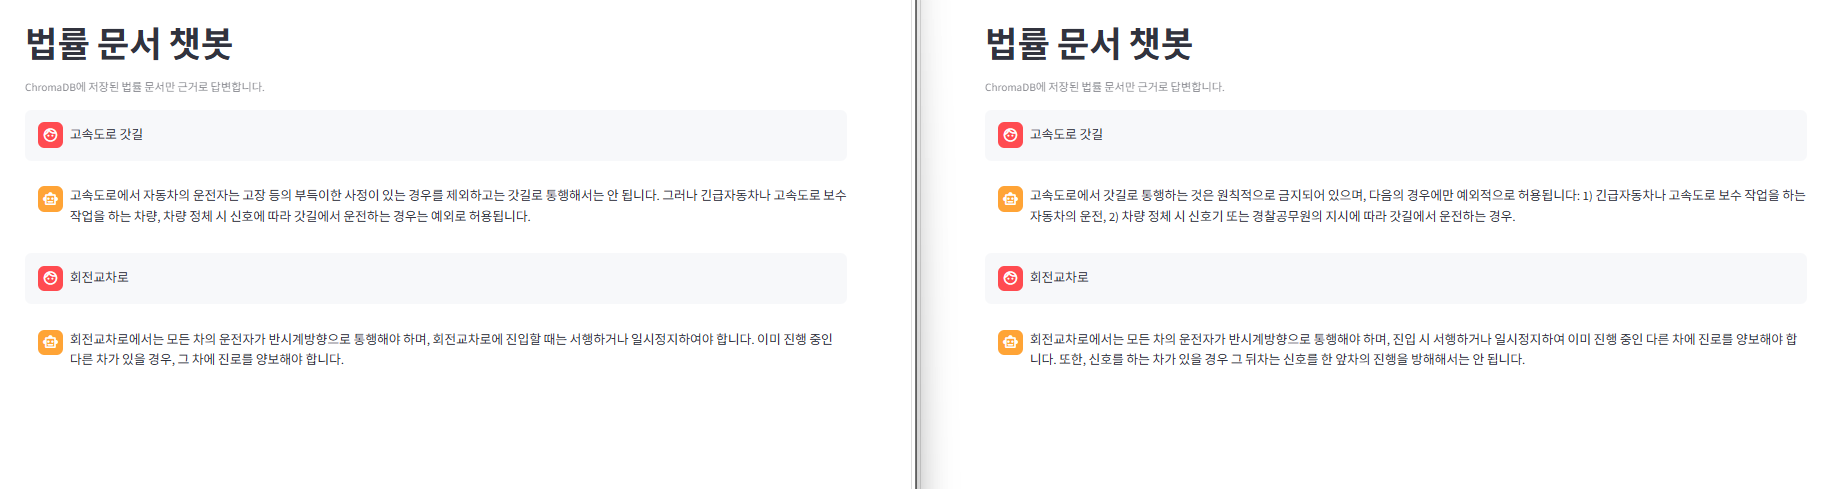
왼쪽은 청크단위를 1000으로 쪼갰을 때이고 오른쪽은 800으로 쪼갰을 때이다.
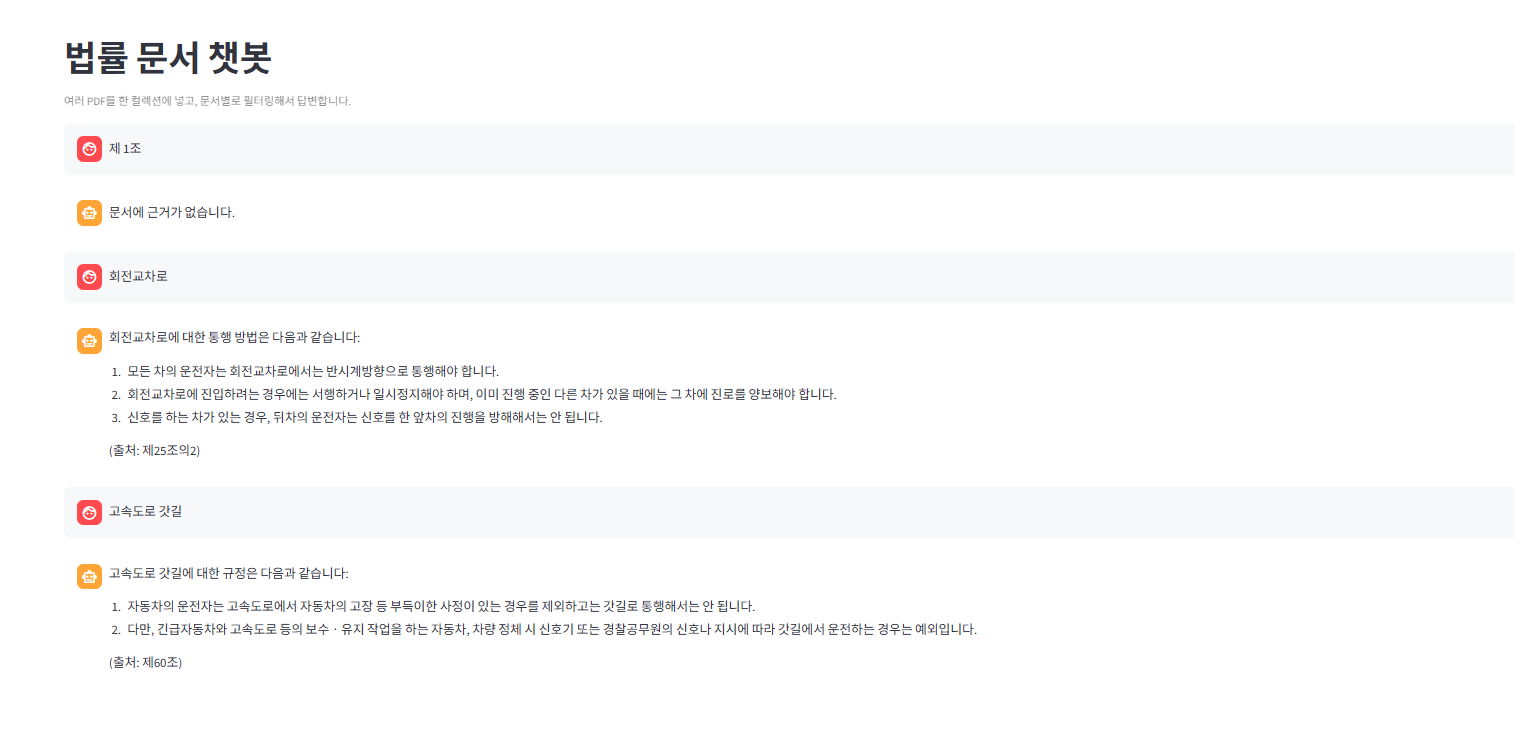
조항 단위로 끊었을 때
여러 문서를 넣고 문서별로 필터링해서 검색
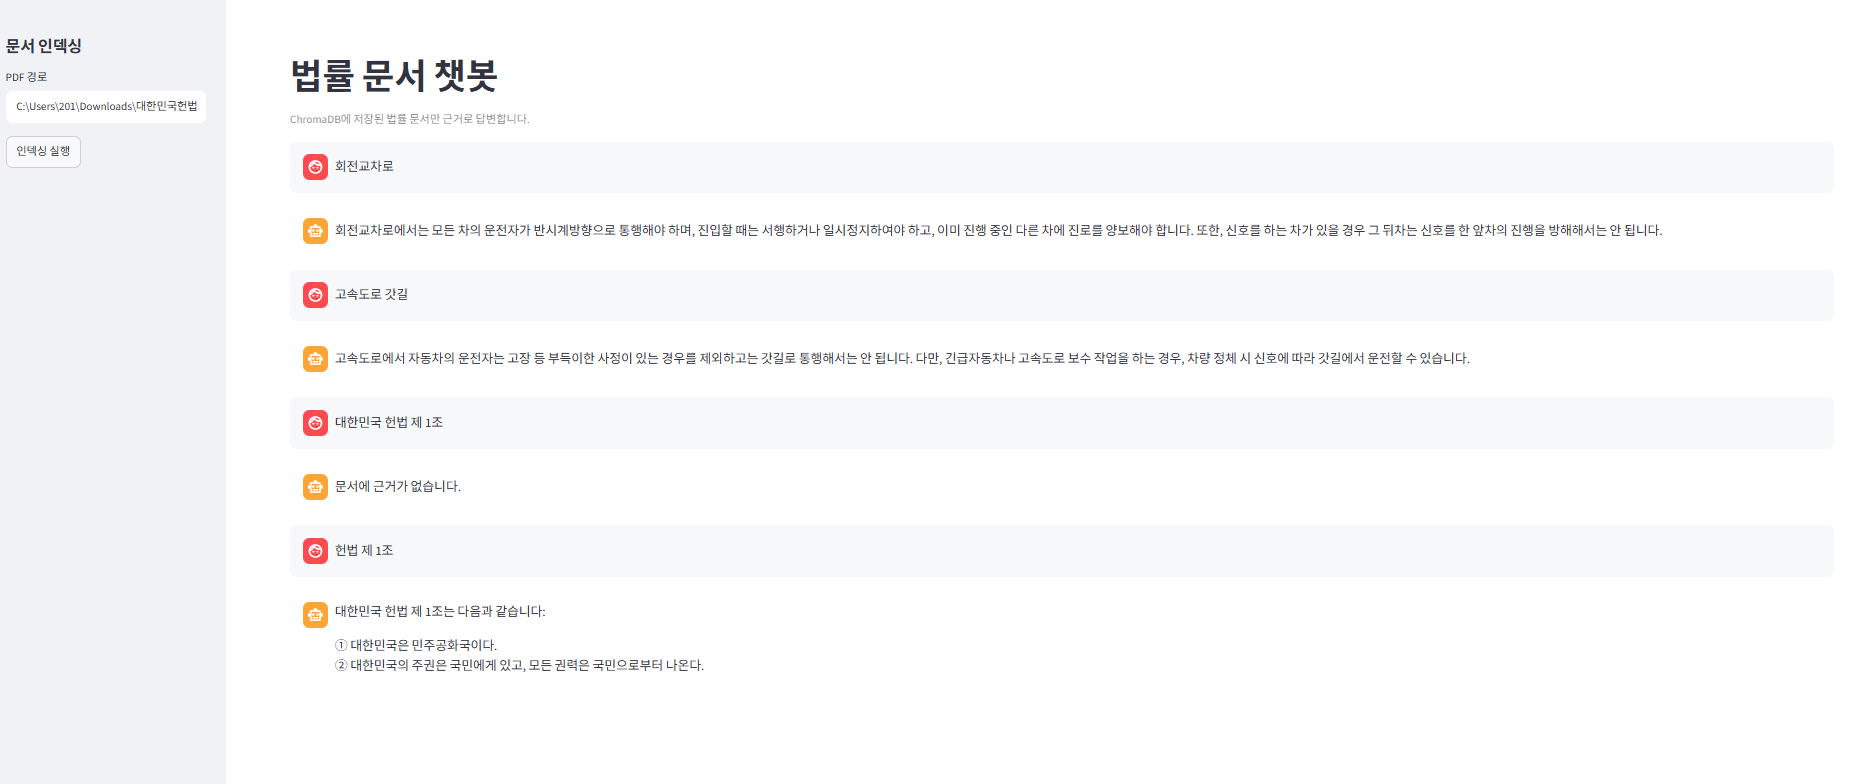
버전 1) 여러 문서를 넣을순 없지만 문서 위치를 왼쪽 인덱싱 칸에 넣어주고 인덱싱을 하면 새로운 문서를 불러올 수 있다. 그에 따라 해당 문서에 관련된 내용을 추출해 낼 수 있다.
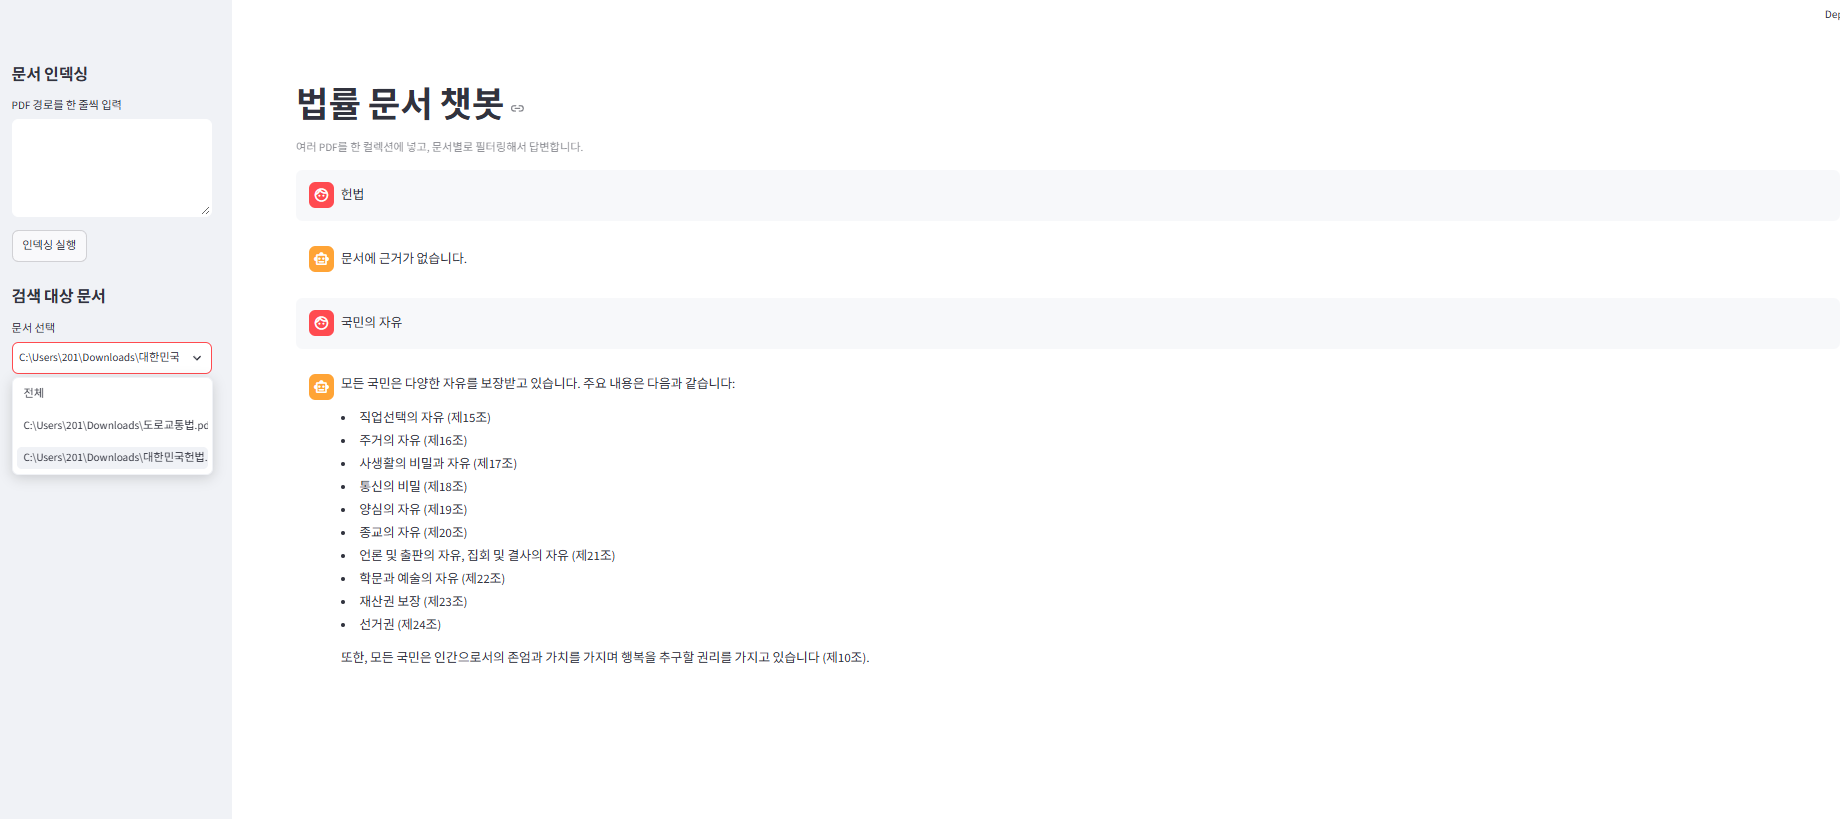
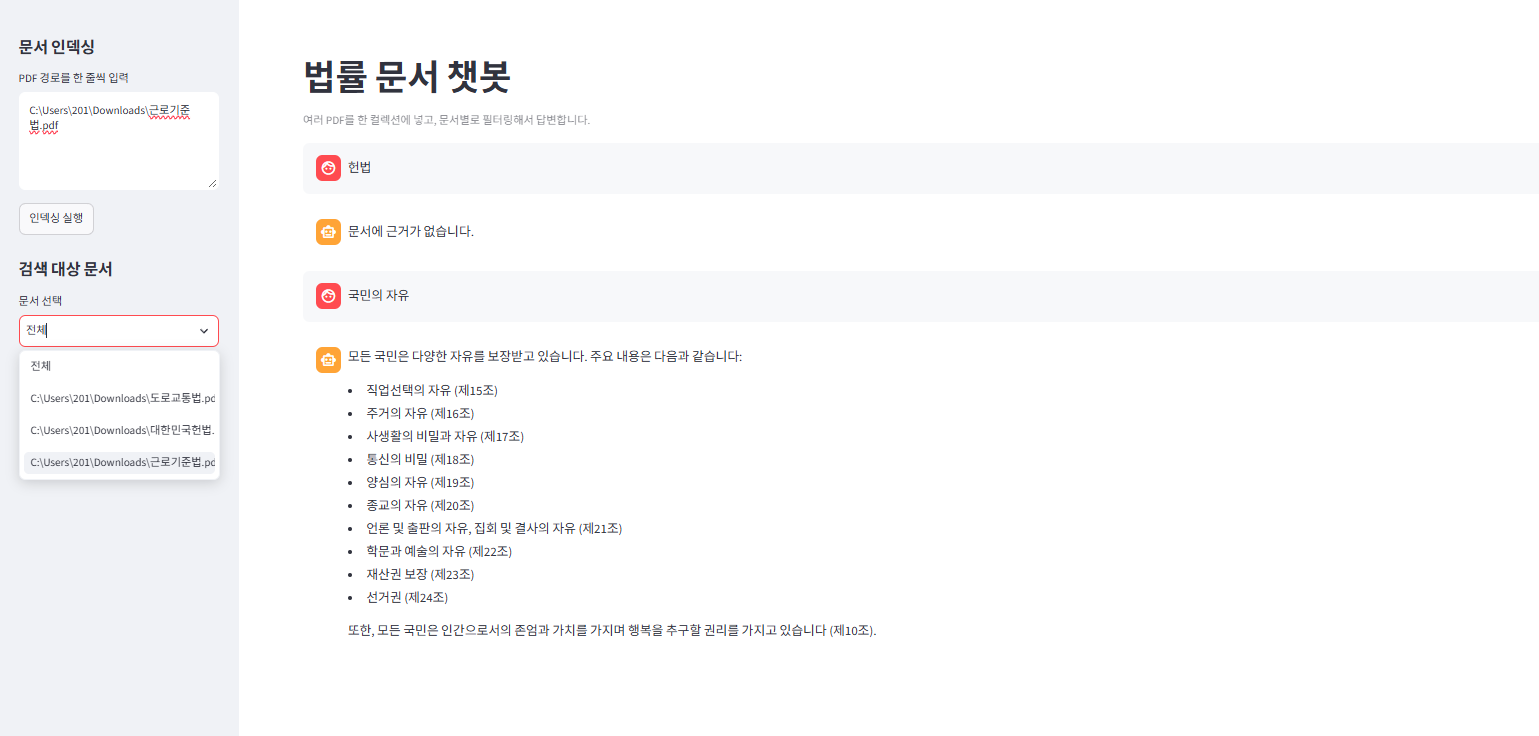
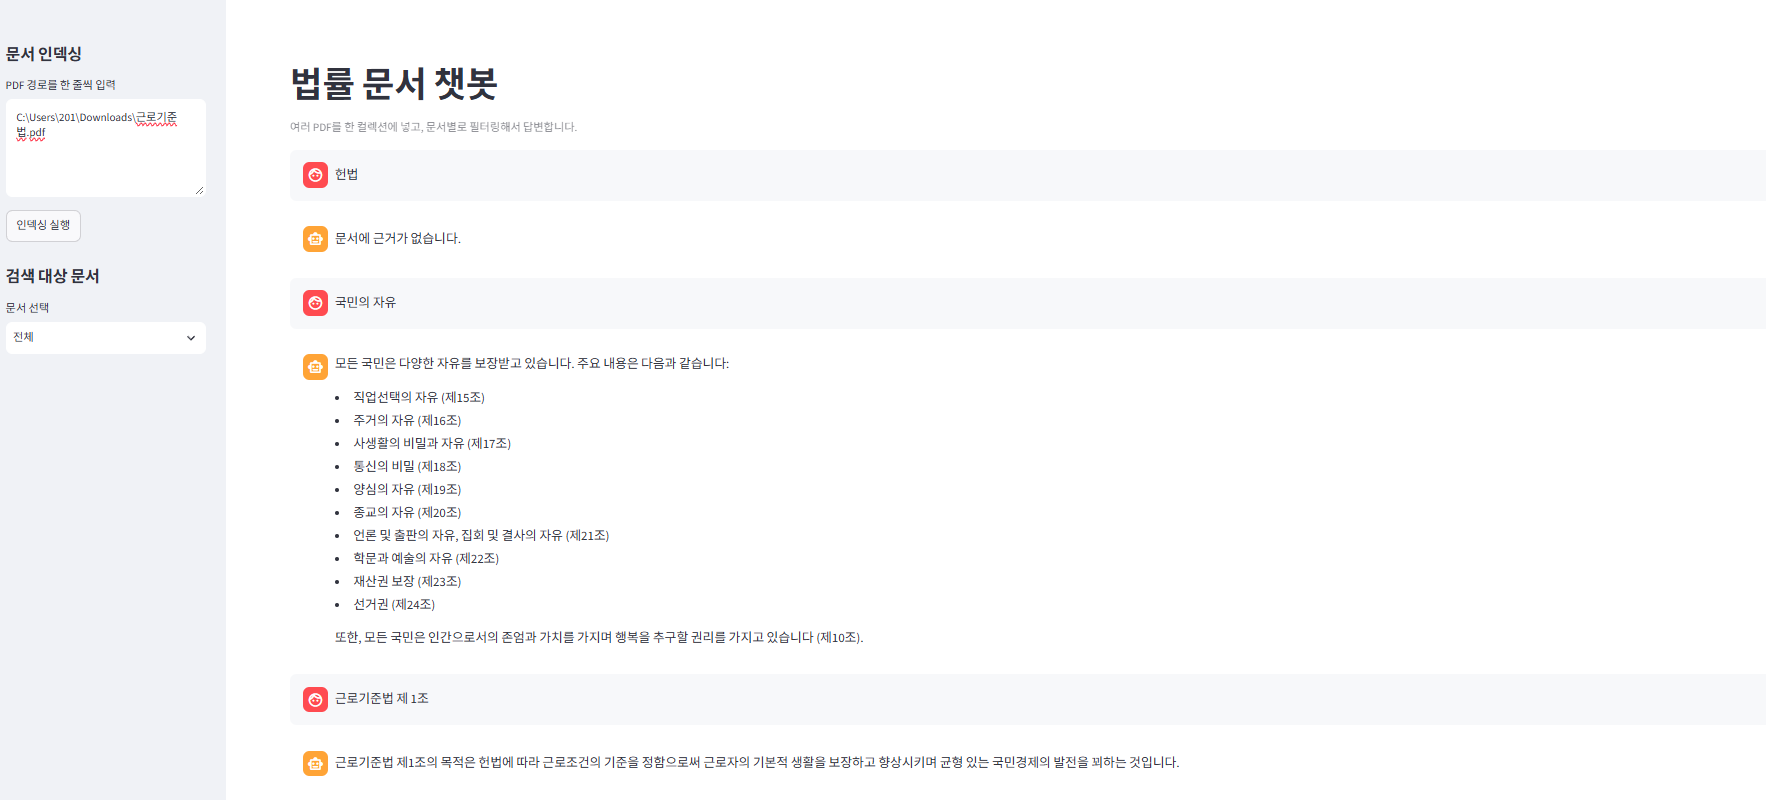
버전 2) 사진처럼 새로운 파일을 넣어두고 인덱싱 후 새로운 파일을 선택하여 검색할 수 있는 기능 구현
