개요
우리 모두는 알고리즘을 사용하고 있다. 아마 나를 비롯한 많은 사람이 좋은 알고리즘을 만들기 위해 고민하고 있을 것이다.
개발에 있어서 알고리즘의 효율성이 무척 중요한데, 이를 결정하는 요인은 알고리즘 수행에 필요한 단계 수이다.
수행 단계 수가 적다는 말은 연산이 빠르다는 말과 같고 이는 곧 효율성 , 성능에 영향을 미친다. 연산의 속도 측정은 시간 복잡도 측정으로도 알려져있다.
◼ 원소가 N개일 때 선형 검색은 몇 단계가 필요할까?
선형 검색은 배열의 인덱스 0부터 찾고자하는 값이 나올 때까지 차례로 검색을 하는 것을 뜻한다. 선형 검색의 효율성을 말할 때 효과적인 방법은 배열에 N개의 원소가 있을 때 선형 검색에 N단계가 필요하다고 표현하는 것이다. 그러나 이 방법은 다소 표현 범위가 넓다.
컴퓨터 전문가들은 시간 복잡도를 쉽게 소통할 목적으로 알고리즘의 효율성을 일관된 언어로 설명하기 위해 수학적 개념을 차용했다. 이러한 개념을 형식화한 표현을 빅 오 표기법이라 부르며, 빅 오 표기법을 사용해 주어진 알고리즘의 효율성을 쉽게 분류하고 이해시킬 수 있다. ( - 제이 웬 그로우 , 누구나 자료구조와 알고리즘 )
선형 검색을 빅 오 표기법으로 표현하면 이렇다. O(N)
O(N)은 알고리즘에 N단계가 필요하다는 뜻이다.
최악의 케이스를 생각해보자. 만약 배열에 26개의 원소가 있다면 선형 검색에 26단계가 필요할 것이고, 원소가 100개 있다면 선형 검색에 100단계가 필요할 것이다.
배열의 원소가 늘어날 때마다 단계 수가 증가한다. 다시 말해 알고리즘에 N단계가 필요하다.
이렇듯 빅 오는 데이터가 늘어날 때 알고리즘의 성능이 어떻게 바뀌는지를 뜻하고 있다.
(빅 오 표기법은 주어진 알고리즘의 최선과 최악의 시나리오를 효과적으로 설명하긴 하지만, 별도로 명시하지 않는 한 빅 오 표기법은 일반적으로 최악의 시나리오를 의미한다는 것을 알아야 한다.)
◼ 이번에는 이진 검색으로 살펴보자.
이진 검색 알고리즘은 선형검색과 이진검색 게시물에서 볼 수 있다.
빅 오는 이진 검색의 시간 복잡도를 다음과 같이 설명한다.
O(logN)
O(log N)은 데이터가 두 배로 증가할 때마다 한 단계씩 늘어나는 알고리즘을 설명한다.
로그란 무엇일까?
로그는 지수와 역의 관계이다.
2³은 2 X 2 X 2로써 값은 8이다.
log₂8 은 2³의 역이다. 즉, 2를 몇 번 곱해야 8을 얻을 수 있는지를 뜻한다.
마찬가지로 2의 6승은 2 X 2 X 2 X 2 X 2 X 2 = 64
2를 여섯 번 곱해야 64가 나오므로 log₂64 = 6이다.
다른 방법으로 이를 이해해보자. 64를 1이 될 때까지 반으로 나눈다.
64 / 2 / 2 / 2 / 2 / 2 / 2 = 1
2가 6개이므로 log₂64 = 6이다.
이는 이진 검색의 동작 방식과 동일하다.
이를 정리하면 O(logN)은 원소가 하나가 될 때까지 계속해서 반으로 줄이는 만큼의 단계가 걸린다.
| 원소 개수(N) | O(N) | O(log N) |
|---|---|---|
| 8 | 8 | 3 |
| 16 | 16 | 4 |
| 32 | 32 | 5 |
| 64 | 64 | 6 |
| 128 | 128 | 7 |
| 256 | 256 | 8 |
| 512 | 512 | 10 |
| 1024 | 1024 | 10 |
O(N) 알고리즘에는 데이터 원소 수만큼의 단계가 필요한데, O(logN) 알고리즘에는 데이터 원소가 두배로 늘어날 때마다 딱 한 단계만 더 필요하다.
표를 보면 효율성에 엄청나게 차이가 있음을 확인할 수 있다.
💡 빅 오 표기법을 안다면, 어떤 알고리즘이든 비교할 수 있는 기준( 방법 )이 생긴 것이라고 볼 수 있다. 이를 이용해서 실제 쓰이는 알고리즘을 분석해서 다양한 자료 구조와 알고리즘 중 더 빠르게 하고 부하를 줄일 수 있는 방법을 고를 수 있다.
◼ 상수 무시
버블 정렬과 선택 정렬을 예로 들어보자. 버블 정렬과 선택 정렬에 대한 내용은 각각 버블 정렬과 효율성 , 선택 정렬과 효율성 게시물에서 볼 수 있다.
최악의 케이스에서 선택 정렬은 버블 정렬보다 두 배 더 빠르다. 하지만 빅 오 표기법에서는 선택 정렬과 버블 정렬을 똑같은 방식으로 설명한다.
버블 정렬은 약 N² 만큼 단계가 걸린다. 하지만 선택 정렬은 약 N² / 2 정도 걸린다고 볼 수 있다. 하지만 이들을 빅 오 표기법으로 나타내면 둘 다 O(N²)이다. 왜그럴까?
이는 빅 오의 규칙 때문이다. 빅 오 표기법은 상수를 무시한다.
몇 가지 예시를 더 살펴보자.
N / 3 단계가 걸리는 알고리즘이 있다. 이를 O(N)으로 표현한다.
N² + 10 단계가 결리는 알고리즘이 있다. 이는 10을 버리고 O(N²)으로 표현한다.
4 X N단계가 걸리는 알고리즘이 있다. 이는 4를 버리고 O(N)으로 표현한다.
N보다 4배가 느리든 50배가 느리든 빅 오는 O(N)으로 표기한다. 이를 보면 빅 오 표기법은 쓸모없다고 생각할 지도 모른다.
이렇게 표현하는 이유는 빅 오는 카테고리에 속한 알고리즘만 고려하기 때문이다. O(N)과 O(N²)은 별개의 카테고리로 분류한다는 뜻이다.
N² 알고리즘과 4N 알고리즘이 있다. 이때 데이터가 계속해서 커진다고 생각해보자. 엄청나게 말이다.
밑의 이미지는 알고리즘의 상승 곡선이다. 당장에야 N²과 4N의 간격 차이가 얼마나지 않지만 데이터가 엄청나게 커진 상태라면? 그 간격 차이가 느껴지지 않는가?
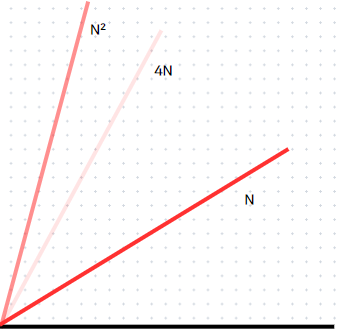
그래서 빅 오에서는 효율성을 비교할 때 카테고리로 분류한다.
여기서 또 한가지 중요한 점은 만약 두 알고리즘을 비교할 때, 서로 다른 카테고리라면 빅 오 표기가 아주 좋은 도구이지만, 같은 카테고리라면 어떤 알고리즘이 더 빠른지 분석해야한다.
◼ 만약 최선 , 평균적인 경우가 잦다면?
삽입 정렬과 선택 정렬의 차이로 알아보자. 삽입 정렬은 삽입 정렬과 효율성 게시물에서 볼 수 있다.
최악의 경우에선 삽입 정렬은 N² + 2N - 2이다.
빅 오는 다른 차항과 상수를 제거한다. 따라서 삽입 정렬의 최악의 경우의 시간 복잡도는 O(N²)이다.
언뜻 봤을 때 버블 정렬 , 선택 정렬 , 삽입 정렬 모두 O(N²)이다. 하지만 실제로 분석했을 때 선택 정렬은 N² / 2만큼 걸리고 삽입 정렬은 N² + 2N - 2가 걸린다.
삽입 정렬은 버블 정렬만큼 느리다고 할 수 있다. 그렇다면 선택 정렬이 셋 중 가장 좋은 정렬일까?
이때 중요한 점이 하나 있다. 만약, 주어진 배열이 평균 , 최선 , 최악의 케이스가 전부 다르다면 어떤 정렬 알고리즘을 선택하는 것이 좋을까?
단순 정렬인 버블 정렬 , 선택 정렬과 비교해보자.
| 최선 | 평균 | 최악 | |
|---|---|---|---|
| 선택 정렬 | N² / 2 | N² / 2 | N² / 2 |
| 삽입 정렬 | N | N² / 2 | N² |
삽입 정렬은 평균 케이스에서 비교는 절반을 수행한다. 따라서 이동또한 절반을 수행한다.
하지만 선택 정렬은 평균 , 최선 , 최악 모두 N² / 2 단계가 수행된다. 이는 선택 정렬에서는 정렬이 이미 되었는지 판단할 수 있는 매커니즘이 없기 때문이다.
버블 정렬에서는 boolean타입 변수로 정렬이 되었는지 안되었는지 판단할 수 있었고, 삽입 정렬에서는 정렬마다 시작 인덱스의 왼쪽 값이 임시변수보다 크다면 해당 정렬을 일찍 종료시킬 수 있었다.
결론은 이렇다. 만약 주어진 배열이 최선의 경우와 가깝다면 삽입 정렬이 좋다. 반대로 최악의 경우와 가깝다면 선택 정렬이 더 빠르다.
참고 자료
누구나 자료구조와 알고리즘