Database & SQL 기초
1. 데이터베이스
데이터베이스(Database)란?
여러 사람이 사용하기 위해 데이터를 체계적으로 저장하고 관리하는 데이터의 모음이다.
데이터베이스에서는 데이터를 생성하고 조회하는 것뿐만 아니라 수정하거나 삭제하는 등의 작업을 수행할 수 있다.
이를 CRUD라고 한다.
| 기능 | 의미 | 설명 |
|---|---|---|
| Create | 생성 | 새로운 데이터를 추가한다. |
| Read | 조회 | 저장된 데이터를 조회한다. |
| Update | 수정 | 기존 데이터를 수정한다. |
| Delete | 삭제 | 기존 데이터를 삭제한다. |
관계형 데이터베이스
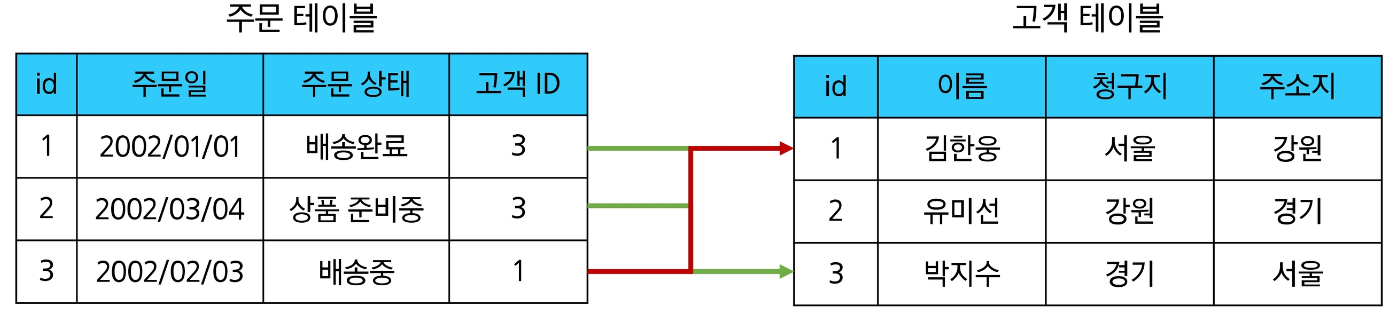
데이터를 테이블 형태로 저장하고, 여러 테이블 간의 관계를 통해 데이터를 관리하는 데이터베이스이다.
관계형 데이터베이스는 데이터를 행(Row)과 열(Column)로 이루어진 테이블에 저장한다.
또한 PK(Primary Key)와 FK(Foreign Key) 등의 키를 이용하여 여러 테이블을 서로 연결할 수 있다.
관계(Relationship)
여러 테이블 간의 논리적인 연결을 의미한다.
테이블 간에 관계를 설정하면 서로 다른 테이블의 데이터를 조합하여 다양한 정보를 조회할 수 있다.
예를 들어 다음과 같은 데이터를 조회할 수 있다.
- 특정 날짜에 구매한 모든 고객 조회
- 지난달 배송이 지연된 고객 조회
관계형 데이터베이스 주요 용어
| 용어 | 설명 | 예시 |
|---|---|---|
| 테이블 (Table) | 데이터를 기록하고 저장하는 곳 | 학생 테이블, 회원 테이블 |
| 필드 (Field) | 데이터의 속성을 나타내는 열(Column) | 이름, 나이, 학번 |
| 레코드 (Record) | 하나의 구체적인 데이터로, 행(Row)에 해당 | 001, 김철수, 20 |
| 데이터베이스 (Database) | 여러 테이블의 집합 | 학교 데이터베이스 |
| 기본 키 (Primary Key, PK) | 각 레코드를 고유하게 식별할 수 있는 값 | 학생의 학번 |
| 외래 키 (Foreign Key, FK) | 다른 테이블의 키를 참조하여 테이블 간의 관계를 만드는 데 사용하는 키 | 수강 테이블의 학번 → 학생 테이블의 학번 |
2. DBMS와 RDBMS
DBMS (Database Management System)
데이터베이스를 관리하기 위한 소프트웨어이다.
DBMS는 데이터베이스와 사용자 사이에서 인터페이스 역할을 한다.
이를 통해 사용자는 데이터를 구성하거나 수정하고, 데이터베이스를 모니터링하거나 백업 및 복구할 수 있다.
RDBMS (Relational Database Management System)
관계형 데이터베이스를 관리하는 소프트웨어이다.
대표적인 RDBMS에는 다음과 같은 것들이 있다.
SQLiteMySQLPostgreSQLOracle Database
3. SQL
SQL (Structured Query Language)
관계형 데이터베이스에서 데이터를 정의, 조회, 조작, 제어하기 위해 사용하는 언어이다.
SQL을 작성할 때 다음과 같은 특징이 있다.
- SQL 키워드는 대소문자를 구분하지 않는다.
- 하지만 SQL 키워드는 대문자로 작성하는 것을 권장한다.
- 각 SQL Statement의 끝에는 세미콜론(
;)을 작성한다.
SQL Statements
SQL을 구성하는 가장 기본적인 코드 블록이다.
SQL Statement는 수행 목적에 따라 크게 4가지 유형으로 구분할 수 있다.
| 유형 | 역할 | 주요 SQL 키워드 |
|---|---|---|
| DDL (Data Definition Language) | 데이터의 기본 구조 및 형식 변경 | CREATE, DROP, ALTER |
| DQL (Data Query Language) | 데이터 검색 | SELECT |
| DML (Data Manipulation Language) | 데이터 추가, 수정, 삭제 | INSERT, UPDATE, DELETE |
| DCL (Data Control Language) | 데이터 및 작업에 대한 사용자 권한 제어 | COMMIT, ROLLBACK, GRANT, REVOKE |
4. Querying Data
데이터베이스에 저장된 데이터를 조회하기 위해 SELECT Statement를 사용한다.
SELECT
테이블에서 데이터를 조회한다.
기본 구조는 다음과 같다.
SELECT
    column_name
FROM
table_name;SELECT: 조회하려는 필드를 지정한다.FROM: 데이터를 조회할 테이블을 지정한다.
모든 필드를 조회하려면 *을 사용할 수 있다.
SELECT
    *
FROM
    employees;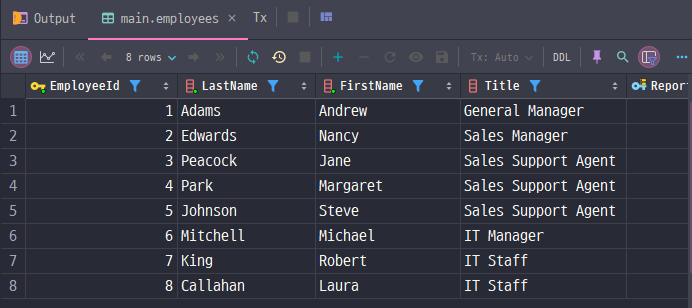
ORDER BY
조회한 결과를 특정 필드를 기준으로 정렬한다.
ASC: 오름차순 정렬 (기본값)DESC: 내림차순 정렬
SELECT
    FirstName
FROM
    employees
ORDER BY
FirstName;ASC가 기본값이므로 위 코드는 FirstName을 기준으로 오름차순 정렬한다.
SELECT
    FirstName
FROM
    employees
ORDER BY
FirstName DESC;DESC를 사용하면 내림차순으로 정렬한다.
정렬할 데이터에 NULL 값이 존재하는 경우 오름차순 정렬에서는 NULL이 가장 먼저 출력된다.
SELECT문의 실행 순서
작성 순서와 실제 실행 순서는 다르다.
FROM → SELECT → ORDER BYFROM: 데이터를 가져올 테이블을 결정한다.SELECT: 조회할 필드를 선택한다.ORDER BY: 조회 결과를 정렬한다.
5. Filtering Data
필요한 데이터만 조회하기 위해 조회 결과를 필터링한다.
DISTINCT
조회 결과에서 중복된 레코드를 제거한다.
DISTINCT는 SELECT 키워드 뒤에 작성한다.
SELECT DISTINCT
    Country
FROM
    customers;
WHERE
특정 조건을 만족하는 데이터만 조회한다.
WHERE은 FROM 뒤에 작성한다.
SELECT
    LastName,
    FirstName,
    City
FROM
    customers
WHERE
    City = 'Prague';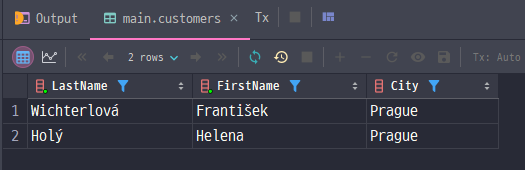
NULL 값을 비교할 때는 =이 아니라 IS를 사용한다.
WHERE column_name IS NULL;비교 연산자
조건을 만들 때 다양한 비교 연산자를 사용할 수 있다.
=>=<=!=ISLIKEINBETWEEN
논리 연산자
여러 조건을 조합할 때 사용한다.
ANDORNOT
LIMIT
조회할 레코드의 개수를 제한한다.
예를 들어 용량(Bytes)이 큰 음악 7개만 조회한다면 다음과 같이 작성할 수 있다.
SELECT
    *
FROM
    tracks
ORDER BY
    Bytes DESC
LIMIT 7;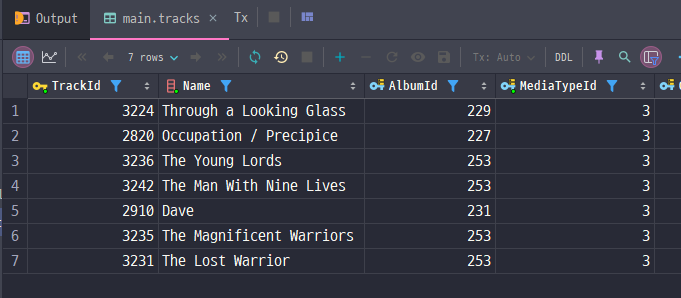
6. Grouping Data
GROUP BY
특정 필드를 기준으로 레코드를 그룹화하여 요약된 결과를 생성한다.
주로 COUNT(), SUM(), AVG() 등의 집계 함수와 함께 사용한다.
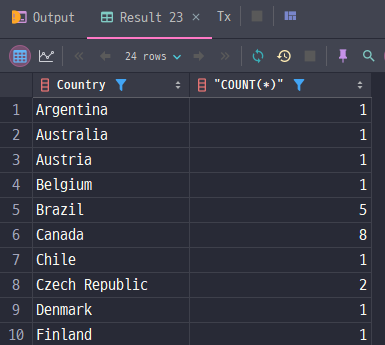
SELECT
    Country,
    COUNT(*)
FROM
    customers
GROUP BY
    Country;
위 코드는 고객을 국가별로 그룹화한 뒤 각 국가에 몇 명의 고객이 있는지 계산한다.
핵심 정리
데이터베이스 관련 개념의 관계를 간단하게 정리하면 다음과 같다.
Database
   ↓
관계형 데이터베이스
   ↓
RDBMS
   ↓
SQL
   ↓
SQL Statement
   ├── DDL : 데이터 정의
   ├── DQL : 데이터 조회
   ├── DML : 데이터 조작
   └── DCL : 데이터 제어
데이터 조회에서 자주 사용하는 SQL 키워드는 다음과 같다.
SELECT      → 데이터 조회
DISTINCT    → 중복 제거
WHERE       → 조건 설정
ORDER BY    → 정렬
LIMIT       → 조회 개수 제한
GROUP BY    → 그룹화