데이터 모델은 구조, 연산, 제약으로 구성됨. 구조와 제약은 전 장인 5장에서 살펴보았고, 이 장에서는 연산 위주로 기술.
관계 데이터 연산은 크게
- 관계 대수 (Relational Algebra)와
- 관계 해석으로 나뉨.
이 장에서는 주로 관계 대수에 대해 다룸.
1. 관계 대수: 릴레이션의 연산
관계 대수의 폐쇄성
- Relation <관계대수> Relation = Relation; 관계 대수 연산의 두 항은 관계 (Relation)이며, 연산의 결과 또한 관계이다.
관계 대수의 종류
- 일반 집합 연산자
- 합집합
- 교집합
- 차집합
- Cartesian Product
- 순수 관계 연산자
-SELECT
-PROJECT
-JOIN
-DIVIDE
2. 일반 집합 연산자
1. 합집합:
- Set에서의 합집합과 유사.
- 연산되는 두 릴레이션의 차수 (Degree)가 같아야 함; 속성의 갯수와 종류가 같아야 함.
- 합집합 연산의 두 릴레이션에서 중복된 투플은 연산 결과에 한번만 표시.
- 차수 (Degree)가 보존됨
- 라고 했을 때,
- (교환 법칙; Commutative)
- (결합 법칙; Associative)
2. 교집합:
- Set에서의 교집합과 유사
- 연산되는 두 릴레이션의 차수 (Degree)가 같아야 함; 속성의 갯수와 종류가 같아야 함.
- and
- (교환 법칙; Commutative)
- (결합 법칙; Associative)
3. 차집합:
- Set에서의 차집합과 유사
- 연산되는 두 릴레이션의 차수 (Degree)가 같아야 함; 속성의 갯수와 종류가 같아야 함.
- 교환적, 결합적 특징 없음; 연산 순서에 따라 결과가 달라짐
4. Cartesian Product (카테시안 곱):
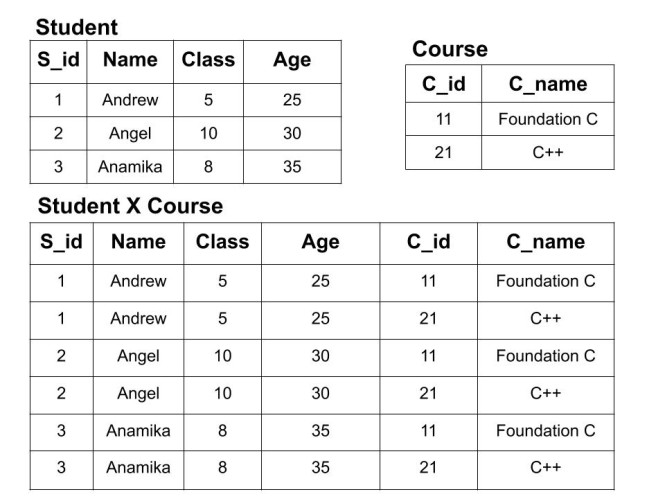
<카테시안 곱의 예시>
- Set에서의 Cartesian Product와 유사.
- 연산되는 두 릴레이션의 차수 (Degree)가 같을 필요가 없음.
- 첫번째 릴레이션의 각 튜플에 두번째 릴레이션의 모든 튜플을 각각 붙여서 새로운 튜플을 만듦.
- (Attribute의 갯수 더해짐)
- (Tuple의 갯수 서로 곱해짐)
- 교환, 결합 가능.
3. 순수 관계 연산자
1. SELECT: , where is a Predicate
- ex) => Rank가 Gold인 Customer를 고르시오
2. PROJECT:
- ex) => Customer 테이블에서 Name, Rank 속성만 보여줘라.
3. JOIN:
- ⋈ => 동등 조인 (Equi Join)
- => 세타 조인 (Theta Join), =연산
- => 자연 조인 (
PK로JOIN함), 중복 속성 1번만 나타냄.
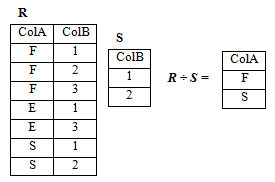
4. DIVIDE:
<DIVIDE Operation의 예시>
5. SEMI-JOIN:
- 릴레이션 B의 조인 속성 추출 -> 릴레이션 A에 자연 조인
- 비용이 적음
- 교환적 특성 없음에 유의: 순서 상관 있음!
6. OUTER-JOIN:
LEFT_OUTER_JOIN= 왼쪽 릴레이션의 모든 튜플을 포함시키고, 조인을 시도, 속성값이 없다면 NULL 처리.RIGHT_OUTER_JOIN=LEFT_OUTER_JOIN의 반대, Symbol은FULL_OUTER_JOIN:
NUS Computer Science