✅ 인메모리 저장소의 필요성
관계형 데이터 베이스의 주 목적은 데이터의 영속성(파일시스템에 저장)
하지만 때때로 일시적으로 저장하고, 빈번하게 수정이 필요한 작업이 있을 수 있음. ex) 로그인 정보, 장바구니 등
이런 상황에서 파일시스템에 데이터를 저장하는 것 대신 메모리에 일시적으로 저장하는 것이 속도가 더 빠름.
✅ Redis
-
In-Memory
In-Memory 데이터베이스로 key-value store로 데이터를 저장하는 데이터베이스.
RAM에 데이터를 저장하기 때문에, 복잡한 입출력 과정이 필요하지 않음.
빠르게 동작하는 대신, 데이터가 사라질 수 있음.
상황에 따라 자주 변경 되는 데이터 ex) 세션, 장바구니, 조회수 등을 저장하는데 사용 -
NoSQL
Redis는 문자열, 리스트, 집합, hash 등 다양한 형태의 데이터를 저장하며, 데이터를 얻기 위해 SQL을 사용하지 않음.
- .데이터의 크기 증가
- 비정형 데이터 증가(대상에 따라 컬럼이 각자 다른 데이터가 많아졌다.)
- 관계형DB는 일관성 유지 → 확장성, 유연성이 떨어짐
데이터가 많아지고 비정형 데이터가 증가함에 따라 일관성을 포기하고 대신 확정성, 유연성을 높이는 NoSQL 데이터베이스의 관심이 증가
✅ Redis 타입
String
- GET, SET
SET user:email alex@example.com
GET user:email
SET <key> <value>: key에 value 문자열 데이터를 저장GET <key>: key에 저장된 문자열 반환
- INCR, DECR
정수가 문자열로 저장된 경우
SET user:count 1
INCR user:count
DECR user:count
INCR key:key에 저장된 데이터를 1 증가DECR key:key에 저장된 데이터를 1 감소
조회가 일어날때 마다 INCR ex) 유튜브 조회수
- MSET, MGET
MSET user:name alex user:email alex@example.com
MGET user:name user:email
MSET key value [key value …]:key value의 형태로 주어진 인자들을 각key에value를 저장MGET key [key]: 주어진 모든key에 해당하는 데이터를 반환.
단순 문자열이지만, 문자열은 결국 바이트 배열.
그래서 이미지, 음성, 영상, 파일, 또는 이메일 본문 등도 보관이 가능.
비교적 큰 사이즈의 데이터를 주고받아야 하는 상황에서 Key만 전달해서 데이터가 어디에 있는지를 전달하는 방식으로 활용 가능.
List
Redis 내부에서 Linked List형태로 데이터 저장.
Linked List이기 때문에, 중간의 데이터 보다는 양끝의 데이터, 즉 스택 또는 큐 처럼 사용 가능.
Java의 Map<String, List<String>>의 형태로 사용한다고 생각하면 됩니다.
- LPUSH, RPUSH, LPOP, RPOP
LPUSH user:list alex  # [alex]
LPUSH user:list brad  # [brad, alex]
RPUSH user:list chad  # [brad, alex, chad]
RPUSH user:list dave  # [brad, alex, chad, dave]

LPOP user:list        # brad
RPOP user:list        # chad
LPUSH key value:key의 리스트 첫번째에value를 저장RPUSH key value:key의 리스트 마지막에value를 저장LPOP key:key의 리스트 첫번째 값을 반환 및 제거RPOP key:key의 리스트 마지막 값을 반환 및 제거
- LLEN, LRANGE
LLEN user:list
LRANGE user:list 0 3
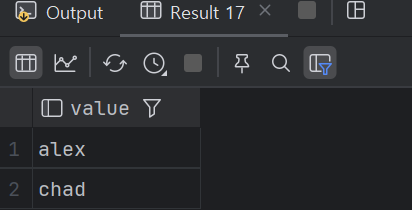
LLEN은 없는 Key를 대상으로 하면 0이 되지만, 다른 자료형을 저장한 Key를 대상으로 하면 오류가 발생.
LRANGE의 경우 시작을 0으로 생각하고,
end가 실제 길이를 벗어나도 오류가 발생하진 않음start>end일 경우 빈 결과가 반환.- 음수의 경우 리스트의 뒤에서부터 데이터를 가져옴.
List의 경우 소셜 네트워크에서 많이 사용하는 자료형으로 대표적으로 X (구 트위터)가 List를 바탕으로 Timeline을 구성했다고 합니다.
SET
- SADD, SREM, SMEMBERS, SISMEMBER, SCARD
문자열의 집합. 중복이 없고, 순서가 존재하지 않음.
SADD user:java alex  # [alex]
SADD user:java brad  # [alex, brad]
SADD user:java chad  # [alex, brad, chad]
SREM user:java alex  # [brad, chad]

SMEMBERS user:java        # [alex, brad, chad]
SISMEMBER user:java brad  # true
SISMEMBER user:java dave  # false
SADD key value:key에 저장된 집합에value를 추가SREM key value:key에 저장된 집합의value를 제거SMEMBERS key:key에 저장된 집합의 모든 원소를 반환SISMEMBER key value:key에 저장된 집합에value가 존재하는지 반환SCARD key:key에 저장된 집합의 크기를 반환
중복을 허용하지 않으며, 어떤 데이터의 존재 여부를 확인하는 SISMEMBER 같은 경우 O(1)의 시간복잡도를 가지고 있습니다.
그래서 중복 없는 방문 수(URL을 키로 만들고 사용자 ID를 넣어준다.),
인증 토큰 블랙리스트 등을 구현할때 활용.
- SINTER, SUNION, SINTERCARD
복수의 집합이 있다면, 교집합, 합집합 등의 기능을 제공. 결과 집합 자체를 반환하기도, 결과 집합의 크기를 반환하기도 함.
# 다른 Set에 추가한 뒤,
SADD user:python alex
SADD user:python dave

SINTER user:java user:python        # [alex]
SUNION user:java user:python        # [alex, brad, chad, dave]
SINTERCARD 2 user:java user:python  # 1
SINTER key1 key2:key1과key2에 저장된 집합들의 교집합의 원소들을 반환SUNION key1 key2:key1과key2에 저장된 집합들의 합집합의 원소들을 반환SINTERCARD number key1 [key2 ...]:number개의key에 저장된 집합들의 교집합의 크기를 반환
Hash
Field - Value 쌍으로 이뤄진 자료형.
즉, Redis 전체가 Map 이라면 Hash는 Map<String, Map<String, String>>의 형식이라고 생각할 수 있음.
- HSET, HGET, HMGET, HGETALL, HKEYS, HLEN
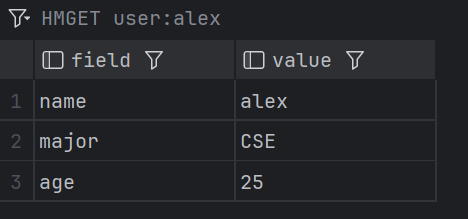
HSET user:alex name alex age 25
HSET user:alex major CSE

HGET user:alex name
HGET user:alex age

HMGET user:alex age major
HGETALL user:alex

HKEYS user:alex
HLEN user:alex
HSET key field value [field value]:key의 Hash에field에value를 넣는다. 한번에 여러field-value쌍을 넣어줄 수 있다.HGET key field:key에 저장된 Hash의field에 저장된value를 반환. 없는field의 경우null.HMGET key field [field]:key에 저장된 Hash에서 복수의field에 저장된value를 반환.HGETALL key:key에 저장된 Hash에 저장된field-value를 전부 반환.HKEYS key:key에 저장된 Hash에 저장된field를 전부 반환HLEN key:key에 저장된 Hash에 저장된field의 갯수를 반환
Sorted Set
정렬된 집합입니다. 기본적으로 Set과 동일하게, 유일한 값들만 유지하지만 여기에 더해 각 값들에 score라고하는 실수를 함께 보관.
그리고 데이터를 가져올 때, score를 바탕으로 정렬하여 값들을 가져올 수 있음.
- ZADD, ZINCRBY, ZRANK, ZRANGE, ZREVRANK, ZREVRANGE
ZADD user:ranks 10 alex
ZADD user:ranks 9 brad 11 chad
ZADD user:ranks 8 dave

ZINCRBY user:ranks 2 alex

ZRANK user:ranks alex
ZRANGE user:ranks 0 3

ZREVRANK user:ranks alex
ZREVRANGE user:ranks 0 3
ZADD key score member [score member ...]:key의 Sorted Set에score를 점수로 가진member를 추가, 이미 있는member의 경우 새로운score를 설정ZRANK key member:key의 Sorted Set의member의 순위를 오름차순 기준으로 0에서 부터 세서 반환ZRANGE key start stop:key의 Sorted Set의member들을start부터stop순위까지 오름차순 기준으로 반환ZREVRANK key member:key의 Sorted Set의member의 순위를 내림차순 기준으로 0에서 부터 세서 반환ZREVRANGE key start stop:key의 Sorted Set의member들을start부터stop순위까지 내림차순 기준으로 반환ZINCRBY key increment member:key의 Sorted Set의member의score를increment만큼 증가 (음수를 전달하면 감소)
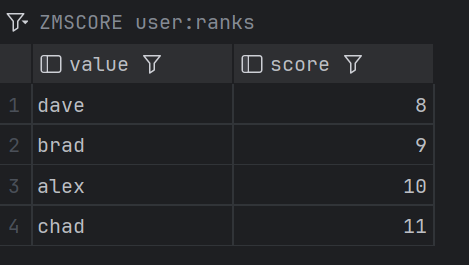
대표적으로 리더보드(순위표)나 Rate Limiter(점수에 타임 스탬프 저장), 즉 순위와 관련된 기능을 만드는데 사용.
그 외 공용 명령
그 외 자료형과 상관없이 사용할 수 있는 명령들이 있습니다. 이 중 대표적으로 많이 사용하는 건, Key를 제거하기 위한 DEL, 만료시각 설정을 위한 EXPIRE 등이 있습니다.
- DEL, EXPIRE, EXPIRETIME
SET somekey "to be deleted"
DEL somekey

SET expirekey "to be expired"
EXPIRE expirekey 5
EXPIRETIME expirekey
DEL key:key(와 저장된 데이터)를 제거EXPIRE key seconds:key의 TTL(유효시각)을seconds로 설정,seconds초가 지나면key제거EXPIRETIME key:key가 만료되는 시각을 Unix Timestamp로 반환
저장된 모든 Key를 확인하고 싶다면 KEYS *,
모든 Key를 제거하고 싶다면 FLUSHDB를 사용
