서론
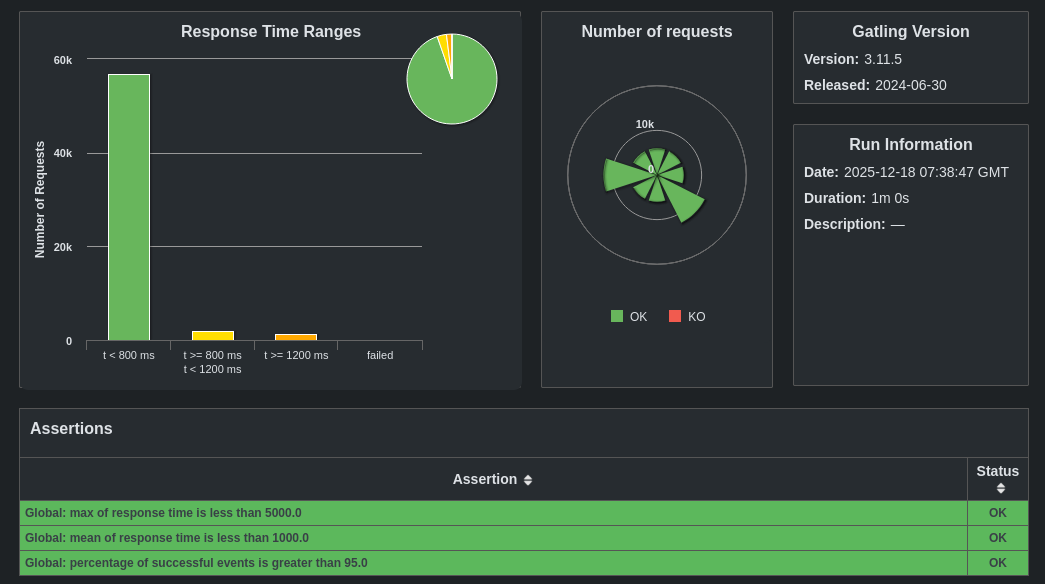
- ElasticSearch를 사용하여 조회 하는 부분의 api를 테스트했을 때 평균 1.2초 최대 7.1초라는 매우 느린 속도가 관찰되었습니다.
- 현재 상황에서 병목지점이 있음을 예상하고 최적화를 진행했습니다.
1차 해결
- Tomcat의 쓰레드 풀의 개수를 확장
  tomcat:
    threads:
      max: 300        # 최대 스레드 수
      min-spare: 50   # 최소 대기 스레드
    accept-count: 100 # 큐 대기 요청 수
결과
- 전체적인 요청의 50th pct 부분의 응답 속도는 향상했습니다. (986ms -> 381ms)
- 하지만 max가 여전히 7초대로 병목은 여전히 존재한다고 생각했습니다.
결과 해설
- tomcat의 쓰레드 풀 확장으로 대기를 지속적으로 하지 않고 처리할 수 있어서 전체적인 응답 속도 증가**(약2.6배)
- 응답 속도는 증가 했지만 대규모 쓰레드로 인한 메모리 오버헤드 우려
- 결론적으로 병목을 해결하지 못함
ElasticSearch 부분 커넥션, 쓰레드 풀의 병목??
- 이부분에서 ElasticSearch의 커넥션 또는 내부 쓰레드 풀의 병목을 예상하였습니다.
시도
ElasticSearchConfig확인
.setRequestConfigCallback(requestConfigBuilder ->
            requestConfigBuilder
           .setConnectTimeout(10000)
           .setSocketTimeout(60000)
)
.setHttpClientConfigCallback(httpClientBuilder ->
             httpClientBuilder
            .setMaxConnTotal(100)  // 최대 연결 수
            .setMaxConnPerRoute(100)  // 라우트당 최대 연결 수
)
.build();-
이부분은 Connection 수가 100으로 문제가 없었습니다.
-
ElasticSearch 내부의 쓰레드 풀 확인
kkm06100@kkm06100-550XED:~/frontend$ curl -X GET "http://localhost:9200/_cat/thread_pool/search?v"
node_name    name   active queue rejected
e2feb59eb8f1 search 0 0 0- 이부분도 역시 문제가 없었습니다.
2차 해결
- ElasticSearch에서 content에 edge-ngram인덱싱 제거
자동완성에 적합한 edge-ngram 방식을 content 같은 대용량 필드에 불필요하게 적용하고 있어 토큰 수가 폭발적으로 증가 하고, 검색 시에도 그 넓은 역색인을 탐색해야하므로 성능저하가 발생했습니다. 이를 제거 했고, 검색 중 불필요한 연산을 줄여 성능을 향상시켰습니다.
- 게시물 검색 시 content 필드 제외
게시물 content 필드는 5000자가 넘는 대용량 데이터입니다. 검색 결과 20개를 반환할 때 content를 포함하면 ES가 각 문서의 _source에서 해당 필드를 읽고 반환하는 I/O 비용과 네트워크 전송량이 모두 증가합니다. 검색 목적상 content 전문은 불필요하므로 이를 제외해 성능을 향상시켰습니다.
결과
- 전체 요청의 평균 응답시간이 1202ms -> 137ms로 총 8.8배 향상 했습니다.
- 50th pct의 응답 속도 14ms로 캐시 없이 매우 빠른 조회를 했습니다.
개선여지
-
50th pct는 14인데에 반해 max는 3초 가까이 되는 모습을 볼 수 있습니다.
-
또한 응답시간의 표준 편차는 308ms로 매우 높습니다.
-
로컬에서 별도의 격리없이 부하테스트와 애플리케이션 가동을 동시에 해서 결과에 대한 신뢰성이 떨어집니다.
배운점
ElasticSearch
- ElasticSearch에서 인덱싱을 컨텐츠같이 큰 필드에다 두 개 씩 넣는 것은 시스템을 느리게 하고 병목지점이 될 수 있다는 것을 알았습니다.
tomcat
- 톰캣의 블로킹 IO구조와 제한된 스레드에서 발생하는 블로킹이 응답시간에 주는 영향을 알았습니다.
- 스레드 수를 cpu코어 수 보다 훨씬 높히는 것은 컨텍스트 스위칭 때문에 성능이 저하된다고 들었는데 요청이 정말 많은 경우에는 오히려 응답률을 높힐 수 있다는 사실을 알게되었습니다.
- tomcat 최대 쓰레드 수 조정을 통해 평소 관심없었던 js의 논블로킹 모델을 찾아보게 되었고 이를 통해 동기, 비동기 처리의 장단점을 학습했습니다.
문제 해결 태도
- 전체 에러의 60% ~ 90%는 휴먼 에러라는 글을 본적이 있는데 이번에 최적화를 하면서 제가 잘못 설계한 부분을 알게 되었습니다.
- 단일 조회를 할때는 정말 빠르게 결과가 나와서 병목을 눈치채지 못했는데 부하테스트를 함으로써 잠재적인 문제를 해결하는 방법을 배웠습니다.
P.S
- 최적화의 결과를 위주로 설명하다보니 기술에 대한 설명을 하지 않은 부분이 많은데 이 부분은 따로 블로그를 통해 작성하도록 하겠습니다!(tomcat, edge-ngram 인덱싱 등)
- 부하테스트는 정확한 성능을 관측하기 위해서 서버에서 별도의 캐시 없이 똑같은 조건에서 실행했습니다. (60초 동안 60000 요청, 단일 노드)
- 잘못된 정보, 기록이 있다면 얼마든지 지적해주세요.
